Rendimiento, memoria y números en JavaScript (jsc)
Curso de JavaScript 6: IDs mayores que 2^53, BigInt 53 veces más lento, la trampa de += (2 vs 564 ms), arreglos con huecos, JIT y Map vs WeakMap.
Serie: curso de JavaScript 6/6 (avanzado). Esta clase es para ti si ya pones JavaScript en producción y te topaste con un ID equivocado que llegó de una API, una página que se volvió lenta a medida que crecían los datos o una memoria que no paraba de subir. Es el tipo de bug que aparece en tu primer trabajo en una fintech o un e-commerce, o en el dashboard que le entregaste a un cliente como freelancer y que meses después "se puso lento". Al terminar vas a saber dónde deja de ser exacto un número de JavaScript y qué hacer al respecto, qué patrones de strings, arreglos y objetos son rápidos o lentos y por qué, cómo el compilador JIT cambia los tiempos y cómo distinguir una caché de una fuga de memoria.
Los consejos de rendimiento para JavaScript están llenos de folclore ("nunca uses += con strings", "siempre reserva el tamaño de los arreglos") que fue cierto para un motor en un año concreto. La única defensa es medir en el motor al que apuntas. Medimos todo lo que sigue en un solo motor, JavaScriptCore, el que está dentro de Safari y de todos los navegadores de iOS, con entradas fijas, semillas fijas y ejecuciones repetidas, y decimos qué resultados probablemente se trasladan a V8 (Chrome, Node.js) y cuáles no.
Entorno: JavaScriptCore de macOS 26.6.2 (versión del framework 21624.5.1.11.3) mediante su consola jsc, Mac con Apple Silicon (M1 Pro). No se ejecutaron Node.js, Deno ni navegadores. Los tiempos usan performance.now(), que en este jsc avanzaba en pasos de 20 µs, así que nunca reportamos una medición individual por debajo de unos 0.1 ms; damos medianas de 5 a 21 ejecuciones, y la mayoría de las pruebas corrieron varias veces en procesos nuevos. fullGC() y gcHeapSize() son helpers exclusivos de jsc. El alias de la clase 1: alias jsc=/System/Library/Frameworks/JavaScriptCore.framework/Versions/Current/Helpers/jsc.
Números: dónde un double deja de ser exacto
JavaScript tiene un único tipo de número ordinario, un valor de punto flotante IEEE 754 de 64 bits ("double"). Tiene 53 bits de precisión, así que los enteros son exactos solo hasta 2^53 − 1. Las fracciones como 0.1 nunca son exactas (lo explicamos a fondo en por qué 0.1 + 0.2 no da 0.3). Este archivo muestra todos los bordes con los que te vas a topar en la práctica:
// numbers.js — where a double stops being exact
print(Number.MAX_SAFE_INTEGER, 2 ** 53 === 2 ** 53 + 1, Number.isSafeInteger(2 ** 53));
print(9007199254740993, 9007199254740993 === 9007199254740992);
const row = JSON.parse('{"id": 9007199254740993, "idStr": "9007199254740993"}');
print(row.id, row.idStr, BigInt(row.idStr));
print(0.1 + 0.2, 0.1 + 0.2 === 0.3, Math.abs(0.1 + 0.2 - 0.3) < Number.EPSILON);
print((1.005).toFixed(2), (1.005).toPrecision(20), Math.round(1.005 * 100) / 100);
print(parseInt(0.0000005), String(0.0000005), parseInt("08"), parseInt("1e3"), Number("1e3"));
print(Number.MAX_VALUE * 2, -1 / 0, 0 / 0, Object.is(-0, 0), -0 === 0);
print([0.1, 0.2, 0.3].reduce((a, b) => a + b), Math.sumPrecise([0.1, 0.2, 0.3]));
// money: integers of the smallest unit
const pricesYen = [1980, 2480, 980]; const taxRate = 10;
print(pricesYen.reduce((a, b) => a + b) * (100 + taxRate) / 100);
const cents = [1999, 2999, 99]; print((cents.reduce((a, b) => a + b) / 100).toFixed(2));
$ jsc numbers.js
9007199254740991 true false
9007199254740992 true
9007199254740992 9007199254740993 9007199254740993
0.30000000000000004 false true
1.00 1.0049999999999998934 1
5 5e-7 8 1 1000
Infinity -Infinity NaN false true
0.6000000000000001 0.6
5984
50.97
Línea por línea, las trampas:
- 2^53 y 2^53 + 1 son el mismo número. El literal
9007199254740993ya se convierte en...992al parsear el código fuente. JSON.parsepierde los IDs grandes sin avisar. Elidnumérico volvió como...992; el stringidStrsobrevivió. Las víctimas habituales son los IDs de generadores tipo snowflake (como los de Twitter) y las claves primarias de 64 bits de una base de datos.toFixedno redondea 1.005 hacia arriba, porque 1.005 en realidad es 1.00499999999999989... El redondeo de dinero tiene que hacerse con enteros.parseIntrecibe un string.parseInt(0.0000005)es 5, porque el número primero se convierte en"5e-7". Para números usaMath.trunc.Math.sumPrecise(un agregado muy reciente; comprobado solo en este jsc) suma una lista sin redondeos intermedios:0.6en vez de0.6000000000000001.- El dinero como enteros de la unidad más chica (yenes, centavos) se mantiene exacto: 5984 y "50.97". Más detalles en cálculos de dinero con centavos enteros.
Error común 1: IDs de 64 bits que llegan en JSON
Lo que se suele escribir: const user = await res.json(); fetch("/users/" + user.id), cuando el servidor envía un ID entero de 64 bits.
Qué pasa en realidad: los IDs por encima de 9,007,199,254,740,991 se redondean al double representable más cercano, así que pides (¡o actualizas!) otro registro, y nada lanza un error.
Solución: la mejor está en el servidor: envía esos IDs como strings JSON. Si no puedes cambiar el servidor, los motores más nuevos permiten que un reviver de JSON.parse vea el texto fuente original, y JSON.rawJSON escribe un número de vuelta sin pérdida:
// bigids.js — keep 64-bit IDs exact when parsing and writing JSON
const text = '{"id": 9007199254740993, "price": 1980}';
print("plain parse:", JSON.parse(text).id);
// 1) reviver with source text (newer API: check your target runtimes)
const row = JSON.parse(text, (key, value, ctx) => key === "id" ? BigInt(ctx.source) : value);
print("reviver:", row.id, typeof row.id, row.price);
// 2) write it back as a bare JSON number without losing digits
print("stringify:", JSON.stringify(row, (k, v) => typeof v === "bigint" ? JSON.rawJSON(v.toString()) : v));
$ jsc bigids.js
plain parse: 9007199254740992
reviver: 9007199254740993 bigint 1980
stringify: {"id":9007199254740993,"price":1980}
Las dos APIs funcionaron en este jsc; navegadores y versiones de Node más viejos no las tienen (no ejecutado aquí), así que compruébalo antes de depender de ellas. El mismo problema existe en otros lenguajes que convierten los números JSON en doubles; mira el artículo de PHP sobre los tipos numéricos en JSON (en inglés) y desbordamiento de enteros y límites seguros.
BigInt: exacto, estricto y unas 53 veces más lento
BigInt (ES2020) es un entero de cualquier tamaño, que se escribe con el sufijo n. Se niega a mezclarse con Number en silencio, lo cual es bueno, y vale la pena reconocer sus errores:
// bigint.js — exact big integers, and the errors you will meet
const big = 2n ** 64n;
print(big, typeof big, 7n / 2n, -7n / 2n, 10n ** 30n);
try { print(1n + 1); } catch (e) { print(e); }
try { print(Math.max(1n, 2n)); } catch (e) { print(e); }
try { JSON.stringify({ id: 1n }); } catch (e) { print(e); }
print(JSON.stringify({ id: 1n }, (k, v) => typeof v === "bigint" ? v.toString() : v));
print(1n == 1, 1n === 1, 2n > 1, Number(2n ** 60n), BigInt.asUintN(8, 257n));
try { BigInt(1.5); } catch (e) { print(e); }
try { new BigInt(1); } catch (e) { print(e); }
const h = new BigInt64Array(2); h[0] = 2n ** 63n - 1n; h[1] = h[0] + 1n; print(h[0], h[1]);
$ jsc bigint.js
18446744073709551616 bigint 3 -3 1000000000000000000000000000000
TypeError: Invalid mix of BigInt and other type in addition.
TypeError: Conversion from 'BigInt' to 'number' is not allowed.
TypeError: JSON.stringify cannot serialize BigInt.
{"id":"1"}
true false true 1152921504606847000 1
RangeError: Not an integer
TypeError: function is not a constructor (evaluating 'new BigInt(1)')
9223372036854775807 -9223372036854775808
La división de BigInt trunca hacia cero (-7n / 2n es -3n). Las funciones de Math no aceptan BigInt, JSON.stringify lo rechaza y un elemento de BigInt64Array da la vuelta en 2^63 como un int64_t de C. Volver a convertirlo con Number() pierde precisión otra vez (...847000).
El costo, medido con el mismo bucle escrito de las dos formas (7 ejecuciones por proceso, 3 procesos):
// bigint_speed.js — sum of i*i for i < 1,000,000 as Number and as BigInt
const N = 1_000_000;
function numSum() { let s = 0; for (let i = 0; i < N; i++) s += i * i; return s; }
function bigSum() { let s = 0n; for (let i = 0n; i < 1_000_000n; i++) s += i * i; return s; }
for (const [name, fn] of [["Number", numSum], ["BigInt", bigSum]]) {
  const ts = []; let r;
  for (let k = 0; k < 7; k++) { const t = performance.now(); r = fn(); ts.push(performance.now() - t); }
  ts.sort((a, b) => a - b);
  print(`${name}: median ${ts[3].toFixed(2)} ms  result=${r}  exact=${BigInt(r) === 333332833333500000n}`);
}
$ jsc bigint_speed.js
Number: median 0.94 ms  result=333332833333127550  exact=false
BigInt: median 49.86 ms  result=333332833333500000  exact=true
Medianas sobre tres procesos: Number 0.94 ms, BigInt 49.86 ms, unas 53 veces más lento. Y mira el resultado de Number: es incorrecto, sin aviso, porque la suma pasó de 2^53 a mitad de camino. La velocidad solo importa cuando la respuesta es correcta.
Strings: += está bien, hasta que lees mientras construyes
El consejo clásico es "nunca construyas strings con +=, usa un arreglo y join". Construimos un CSV de 200,000 filas (3,446,270 caracteres) de cuatro formas, 7 repeticiones por proceso, cada estrategia en su propio proceso, dos rondas:
// strings.js — build a 200,000-line CSV four ways (each strategy in its own process)
// usage: jsc strings.js -- plus | join | template | concat
const N = 200_000;
const row = (i) => i + "," + (i * 7 % 1000) + ",item" + (i % 97) + "\n";
const strategies = {
  plus()     { let s = ""; for (let i = 0; i < N; i++) s += row(i); return s; },
  join()     { const a = []; for (let i = 0; i < N; i++) a.push(row(i)); return a.join(""); },
  template() { let s = ""; for (let i = 0; i < N; i++) s = `${s}${i},${i * 7 % 1000},item${i % 97}\n`; return s; },
  concat()   { let s = ""; for (let i = 0; i < N; i++) s = s.concat(row(i)); return s; },
};
const name = arguments[0], fn = strategies[name];
const times = [];
let len = 0, check = 0;
for (let rep = 0; rep < 7; rep++) {
  const t = performance.now();
  const s = fn();
  check = s.charCodeAt(s.length >> 1);      // touch the middle: forces a flat string
  times.push(performance.now() - t); len = s.length;
}
const sorted = [...times].sort((a, b) => a - b);
print(`${name.padEnd(8)} len=${len} first=${times[0].toFixed(1)}ms median=${sorted[3].toFixed(1)}ms min=${sorted[0].toFixed(1)}ms`);
$ for v in plus join template concat; do jsc strings.js -- $v; done
plus     len=3446270 first=19.7ms median=13.8ms min=12.6ms
join     len=3446270 first=16.0ms median=15.6ms min=14.5ms
template len=3446270 first=14.1ms median=12.0ms min=10.7ms
concat   len=3446270 first=15.7ms median=13.7ms min=12.4ms
La segunda ronda dio medianas de 13.5, 15.2, 11.4 y 13.7 ms. Las cuatro están a menos de un 30% de distancia entre sí, y += no fue la más lenta. La razón es que JavaScriptCore (igual que V8) representa a + b como una rope (cuerda): un nodo pequeño que apunta a las dos mitades, sin copiar. La copia ocurre una sola vez, cuando alguien necesita los caracteres (aplanado o flattening).
Eso también te dice cómo volver lento a +=: leer dentro del string en cada iteración, lo que obliga a aplanarlo (una copia completa) cada vez:
// strings2.js — += is fine, until you read the string while it grows
const row = (i) => i + "," + (i * 7 % 1000) + ",item" + (i % 97) + "\n";
function plusOnly(N)  { let s = ""; for (let i = 0; i < N; i++) s += row(i); return s.charCodeAt(s.length >> 1); }
function plusPeek(N)  { let s = ""; let c = 0; for (let i = 0; i < N; i++) { s += row(i); c += s.charCodeAt(s.length >> 1); } return c; }
function joinPeek(N)  { const a = []; let c = 0; for (let i = 0; i < N; i++) { a.push(row(i)); c += a[a.length >> 1].charCodeAt(0); } return a.join("").length + c; }
for (const N of [5_000, 10_000, 20_000, 40_000]) {
  const r = {};
  for (const [name, fn] of [["plusOnly", plusOnly], ["plusPeek", plusPeek], ["joinPeek", joinPeek]]) {
    const ts = []; for (let k = 0; k < 5; k++) { const t = performance.now(); fn(N); ts.push(performance.now() - t); }
    ts.sort((a, b) => a - b); r[name] = ts[2].toFixed(1);
  }
  print(`N=${String(N).padStart(6)}  += only ${r.plusOnly.padStart(6)} ms   += and read middle ${r.plusPeek.padStart(7)} ms   array + read ${r.joinPeek.padStart(5)} ms`);
}
$ jsc strings2.js
N=  5000  += only    0.5 ms   += and read middle    14.3 ms   array + read   0.4 ms
N= 10000  += only    0.7 ms   += and read middle    46.3 ms   array + read   0.7 ms
N= 20000  += only    1.7 ms   += and read middle   123.0 ms   array + read   1.5 ms
N= 40000  += only    2.3 ms   += and read middle   629.7 ms   array + read   4.3 ms
Duplicar N multiplicó más o menos por cuatro el tiempo de la columna del medio: cuadrático. En tres procesos, N = 40,000 dio 629.7, 513.4 y 563.7 ms para "+= y leer" contra 2.2 a 2.3 ms para "+= solo".
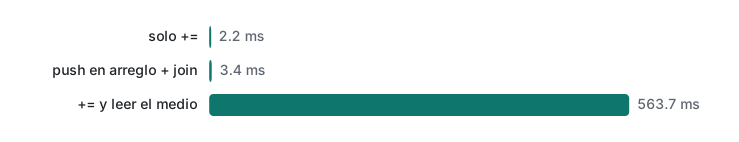
En código real, la "lectura" suele esconderse en una comprobación inocente. Cambiamos el charCodeAt por cuatro comprobaciones comunes, N = 40,000, mediana de 5, dos procesos:
$ jsc strings3.js     # s += row(i); then one check per iteration
length    5.9 ms
endsWith  511.9 ms
lastChar  504.3 ms
includes  605.3 ms
El segundo proceso dio 1.5, 486.7, 476.4 y 587.0 ms. s.length se guarda en la rope y sigue siendo barato; s.endsWith(","), s[s.length - 1] y s.includes(...) necesitan los caracteres y fuerzan una copia completa cada vez. Si tienes que inspeccionar mientras construyes, guarda las piezas en un arreglo e inspecciona la última pieza.
Arreglos: huecos, tipos mezclados y typed arrays
Los huecos (índices que faltan) no son undefined, y los métodos los tratan de forma inconsistente:
// holes.js — holes are not undefined
const a = new Array(3);
print(a.length, a, 0 in a, a.map(() => 1), Array.from(a, () => 1));
const b = [1, , 3];
print(b.indexOf(undefined), b.includes(undefined), Object.keys(b));
b.forEach((v, i) => print("forEach visits", i));
const u8 = new Uint8Array([250, 255]); u8[0] += 10; u8[1] = 256;
const c8 = new Uint8ClampedArray([250]); c8[0] += 10;
print(u8, c8, new Int8Array([200]));
const f32 = new Float32Array([0.1]); print(f32[0], f32[0] === 0.1);
try { new Float64Array(-1); } catch (e) { print(e); }
const t = new Int32Array(4); t.push?.(1); print(typeof t.push, t.length);
$ jsc holes.js
3 ,, false ,, 1,1,1
-1 true 0,2
forEach visits 0
forEach visits 2
4,0 255 -56
0.10000000149011612 false
RangeError: length cannot be negative
undefined 4
new Array(3).map(...) devolvió huecos otra vez, porque map se salta los huecos; Array.from no. indexOf dice que no hay ningún undefined mientras que includes dice que sí. Los typed arrays tienen largo y tipo fijos y dan la vuelta en silencio (260 se volvió 4, 256 se volvió 0, 200 se volvió -56 en un Int8Array), y un Float32Array guarda 0.1 con menos precisión que un número normal.
¿Importa el tipo interno del arreglo para la velocidad? Llenamos 1,000,000 de doubles con un generador de semilla fija de cinco formas y los sumamos 11 veces (tres rondas de procesos nuevos; bytes de heap según gcHeapSize() después de fullGC()):
// arrays.js — same 1,000,000 doubles, different containers (fixed LCG seed)
// usage: jsc arrays.js -- push | prealloc | holey | mixed | f64
const N = 1_000_000;
let seed = 12345; const rnd = () => (seed = (seed * 1103515245 + 12345) % 2147483648) / 2147483648;
const kind = arguments[0];
fullGC(); const before = gcHeapSize();
let a;
if (kind === "push")      { a = []; for (let i = 0; i < N; i++) a.push(rnd()); }
if (kind === "prealloc")  { a = new Array(N); for (let i = 0; i < N; i++) a[i] = rnd(); }
if (kind === "holey")     { a = []; for (let i = 0; i < N; i++) a.push(rnd()); delete a[N >> 1]; }
if (kind === "mixed")     { a = []; for (let i = 0; i < N; i++) a.push(rnd()); a[N >> 1] = "x"; }
if (kind === "f64")       { a = new Float64Array(N); for (let i = 0; i < N; i++) a[i] = rnd(); }
fullGC(); const bytes = gcHeapSize() - before;
function sum(arr) { let s = 0; for (let i = 0; i < arr.length; i++) { const v = arr[i]; if (typeof v === "number") s += v; } return s; }
const ts = []; let s = 0;
for (let r = 0; r < 11; r++) { const t = performance.now(); s = sum(a); ts.push(performance.now() - t); }
const first = ts[0]; ts.sort((x, y) => x - y);
print(`${kind.padEnd(8)} heap=${(bytes / N).toFixed(1)} B/elem  sum first=${first.toFixed(2)}ms median=${ts[5].toFixed(2)}ms  s=${s.toFixed(3)}`);
$ for k in push prealloc holey mixed f64; do jsc arrays.js -- $k; done
push     heap=11.9 B/elem  sum first=2.24ms median=0.94ms  s=495272.410
prealloc heap=8.1 B/elem  sum first=2.32ms median=0.94ms  s=495272.410
holey    heap=11.9 B/elem  sum first=3.60ms median=3.56ms  s=495272.275
mixed    heap=11.9 B/elem  sum first=3.88ms median=3.58ms  s=495272.275
f64      heap=8.1 B/elem  sum first=3.12ms median=0.94ms  s=495272.410
| Arreglo | Heap por elemento | Suma de 1M (mediana de 3 rondas) |
|---|---|---|
push de 1M doubles |
11.9 B | 0.94 ms |
new Array(N) y luego llenar cada índice |
8.1 B | 0.94 ms |
push, luego delete de un elemento |
11.9 B | 3.58 ms |
push, luego un elemento string |
11.9 B | 3.58 ms |
Float64Array |
8.1 B | 0.94 ms |
Un solo delete o un solo string entre un millón de números volvió cada suma posterior unas 3.8 veces más lenta: el motor pasó todo el arreglo a un tipo de almacenamiento más general y ahora el bucle tiene que comprobar cada elemento. push usó unos 3.8 bytes más por elemento que la reserva previa porque el almacenamiento interno crece con capacidad de sobra. Reservar con new Array(N) funcionó bien aquí porque llenamos todos los índices antes de leer; en V8 se sabe que new Array(N) empieza como un tipo con huecos para siempre (no ejecutado aquí), así que Array.from({length: N}, fn) o push son la opción portable. Un Float64Array dio la misma velocidad y el tamaño más chico, sin ninguna forma de volverse con huecos o mezclado; por eso el código numérico (audio, imágenes, ML) usa typed arrays.
Objetos: una forma es más rápida que dieciséis
Los motores les dan a los objetos con las mismas claves en el mismo orden una forma (shape) oculta compartida (JavaScriptCore la llama Structure; V8, Map o hidden class). Un punto del código que lee una propiedad y solo ve una forma es rápido; uno que ve muchas tiene que buscar. Construimos 1,000,000 de objetos que tienen todos x, más claves extra que crean 1, 2, 4, 8 o 16 formas distintas, y sumamos x 21 veces:
// shapes.js — same property read, objects built with 1, 4 or 16 different key orders
// usage: jsc shapes.js -- <number of shapes>
const SHAPES = Number(arguments[0]), N = 1_000_000;
const keys = ["a","b","c","d","e"];
function make(i) {                 // all objects have x; extra keys added in an order that depends on i % SHAPES
  const o = {}; const k = i % SHAPES;
  for (let j = 0; j < 4; j++) if (k & (1 << j)) o[keys[j]] = j;
  o.x = i % 10; return o;
}
const objs = Array.from({ length: N }, (_, i) => make(i));
function sumX(arr) { let s = 0; for (let i = 0; i < arr.length; i++) s += arr[i].x; return s; }
const ts = []; let s = 0;
for (let r = 0; r < 21; r++) { const t = performance.now(); s = sumX(objs); ts.push(performance.now() - t); }
ts.sort((a, b) => a - b);
print(`shapes=${String(SHAPES).padStart(2)}  median=${ts[10].toFixed(2)} ms per 1,000,000 reads  s=${s}`);
$ for n in 1 2 4 8 16; do jsc shapes.js -- $n; done
shapes= 1  median=1.02 ms per 1,000,000 reads  s=4500000
shapes= 2  median=1.12 ms per 1,000,000 reads  s=4500000
shapes= 4  median=1.54 ms per 1,000,000 reads  s=4500000
shapes= 8  median=2.90 ms per 1,000,000 reads  s=4500000
shapes=16  median=3.04 ms per 1,000,000 reads  s=4500000
Medianas sobre tres rondas: 1.02, 1.12, 1.54, 2.90 y 3.00 ms. De una forma a ocho, el mismo arr[i].x se volvió unas 2.8 veces más lento, y después se estabilizó. La regla práctica: crea los objetos de un mismo tipo en un solo lugar (un constructor o una función fábrica), con todos los campos en el mismo orden, y no agregues ni borres (delete) propiedades después. Parte de esta diferencia también puede venir de la disposición en memoria, porque objetos de distinto tamaño quedan repartidos de otra manera; no separamos los dos efectos.
Calentamiento del JIT: por qué la primera ejecución miente
JavaScriptCore tiene cuatro niveles de ejecución: un intérprete (LLInt), un compilador JIT rápido Baseline, un JIT optimizador DFG y el JIT más agresivo, FTL. El código va subiendo de nivel a medida que se calienta. La consola jsc permite apagar niveles, lo que muestra qué aporta cada uno. La misma carga fija (40 lotes de 10 llamadas, 800,000 iteraciones del bucle en total), 5 procesos por configuración:
// tiers.js — fixed workload, timed in batches; run with different JIT tiers switched off
function score(n) {
  let h = 0;
  for (let i = 0; i < n; i++) h = (h * 31 + i) % 1000003;
  return h / 7;
}
const batches = []; let out = 0;
const T0 = performance.now();
for (let b = 0; b < 40; b++) {
  const t = performance.now();
  for (let k = 0; k < 10; k++) out += score(2000);   // 10 calls x 2,000 iterations
  batches.push(performance.now() - t);
}
const total = performance.now() - T0;
const us = (x) => (x * 1000).toFixed(0);
print(`total=${total.toFixed(1)}ms  batch#1=${us(batches[0])}us #2=${us(batches[1])}us #5=${us(batches[4])}us #10=${us(batches[9])}us #40=${us(batches[39])}us  check=${out.toFixed(1)}`);
$ jsc --useJIT=false tiers.js
total=31.1ms  batch#1=820us #2=800us #5=800us #10=780us #40=740us  check=39407657.1
$ jsc --useDFGJIT=false tiers.js
total=25.8ms  batch#1=780us #2=620us #5=640us #10=640us #40=640us  check=39407657.1
$ jsc --useFTLJIT=false tiers.js
total=5.0ms  batch#1=500us #2=120us #5=100us #10=120us #40=120us  check=39407657.1
$ jsc tiers.js
total=5.1ms  batch#1=480us #2=120us #5=120us #10=120us #40=100us  check=39407657.1

Medianas de 5 procesos: solo intérprete 30.8 ms, más Baseline 25.8 ms, más DFG 5.0 ms, configuración por defecto 5.1 ms. Con la configuración por defecto, el primer lote tardó de 480 a 620 µs y cada lote posterior de 100 a 120 µs: la primera ejecución midió sobre todo el intérprete y la compilación, no tu código. El nivel FTL no importó para 5 ms de trabajo; en una ejecución 50 veces más larga (2,000 lotes, 3 procesos), la configuración por defecto tardó 230.3 ms contra 249.0 ms con FTL apagado, alrededor de un 8% más rápida.
De aquí salen dos reglas prácticas. Cuando hagas un benchmark, ejecuta el código suficientes veces y reporta por separado el estado estable y la primera ejecución, como hace cada medición de esta clase. Y recuerda que los usuarios muchas veces solo reciben la primera ejecución: una página que ejecuta una función una vez al cargar obtiene velocidad de intérprete. Fíjate también en que el valor check idéntico demuestra que las cuatro configuraciones calcularon lo mismo.
Memoria: ¿caché o fuga?
Un lenguaje con recolector de basura libera los objetos a los que ya nada hace referencia. Por eso una fuga en JavaScript casi siempre es una referencia que olvidaste, muy a menudo un Map usado como caché con objetos como claves:
// leak.js — a "cache" keyed by objects: Map keeps them alive, WeakMap does not
// usage: jsc leak.js -- Map | WeakMap
const Kind = globalThis[arguments[0]];
const cache = new Kind();
const MB = (b) => (b / 1048576).toFixed(1) + " MB";
fullGC(); const base = gcHeapSize();
function handleRequest(i) {                     // each request object is used once, then dropped
  const req = { id: i, body: new Array(64).fill(i) };
  cache.set(req, { parsedAt: i });              // "memoize" per request
  return req.body.length;
}
let n = 0;
for (let i = 0; i < 50_000; i++) n += handleRequest(i);
fullGC();
print(`${arguments[0].padEnd(7)} after 50,000 requests + full GC: heap +${MB(gcHeapSize() - base)}  size=${cache.size ?? "(WeakMap has no size)"}`);
$ jsc leak.js -- Map; jsc leak.js -- WeakMap
Map     after 50,000 requests + full GC: heap +36.8 MB  size=50000
WeakMap after 50,000 requests + full GC: heap +0.1 MB  size=(WeakMap has no size)
Idéntico en tres ejecuciones. El Map mantuvo viva cada petición (36.8 MB, unos 770 bytes cada una, y creciendo para siempre en un servidor); el WeakMap las soltó, porque una entrada de WeakMap no mantiene viva su clave. El precio: un WeakMap no tiene size, no se puede recorrer y sus claves tienen que ser objetos. En navegadores lo confirmarías con un heap snapshot de DevTools, y en Node con --expose-gc y process.memoryUsage(); no se ejecutó ninguno de los dos aquí.
Tabla de decisión
| Situación | Haz esto | Medido aquí |
|---|---|---|
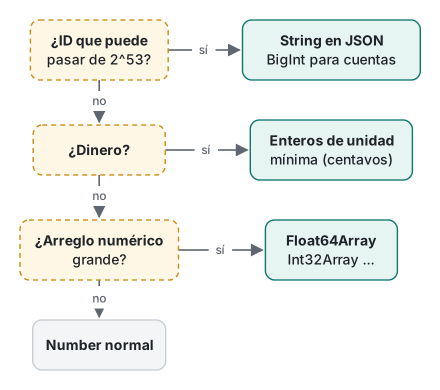
| IDs enteros que pueden pasar de 2^53 | Strings en el JSON; BigInt solo para aritmética |
...993 se volvió ...992 |
| Dinero | Enteros de la unidad más chica | toFixed(2) sobre 1.005 dio 1.00 |
| Aritmética exacta de enteros grandes | BigInt |
53× más lento que Number, pero correcto |
| Construir un string grande | += o join, los dos sirven |
11 a 16 ms para 3.4 MB |
| Inspeccionar mientras construyes | Inspecciona las piezas, no el string | 564 ms vs 2.2 ms |
| Arreglos numéricos grandes | Typed arrays, o arreglos normales sin huecos y de un solo tipo | Con huecos/mezclado 3.8× más lento |
| Muchos objetos de un mismo tipo | Un constructor, mismo orden de claves, sin delete |
8 formas 2.8× más lento |
| Benchmarks | Calienta; reporta la primera ejecución y la estable | primer lote de 4 a 5× más lento |
| Cachés por objeto | WeakMap |
36.8 MB vs 0.1 MB |
Ejercicios
- Predice y luego ejecuta en jsc:
print(JSON.parse("[12345678901234567890]")[0]); print((2.675).toFixed(2)); print(Number.MAX_SAFE_INTEGER + 2); - El benchmark de un compañero de equipo ejecuta una función una vez y reporta "12 ms". Tomando
tiers.jscomo modelo, anota los dos números que pedirías en su lugar y mídelos parascore(2000).
Respuestas
12345678901234567000,2.67y9007199254740992. El número de 20 dígitos se redondea al double más cercano; 2.675 en realidad es 2.67499999...; yMAX_SAFE_INTEGER + 2es 2^53 + 1, que no es representable, así que se redondea a 2^53.- El tiempo de la primera ejecución y la mediana del estado estable (después de suficientes ejecuciones como para que los tiempos dejen de bajar), cada uno sobre varios procesos nuevos. En nuestras pruebas, el primer lote de 10 llamadas tardó de 480 a 620 µs y el estado estable de 100 a 120 µs; un solo número de "12 ms" no te dice cuál de los dos es.
Límites honestos y notas de versión
- Un solo motor. Cada número de aquí es de JavaScriptCore en macOS 26.6.2, Apple M1 Pro. V8 (Chrome, Node.js, Deno) tiene otros niveles (Ignition, Sparkplug, Maglev, TurboFan) y otras heurísticas; las direcciones (los huecos y los tipos mezclados cuestan, muchas formas cuestan, el calentamiento importa, las ropes abaratan
+=) también están bien documentadas para V8, pero las proporciones serán distintas. No ejecutamos V8. - Exclusivo de jsc:
print,fullGC,gcHeapSize,--useJIT=falsey las demás opciones de niveles existen solo en la consola jsc. Los tamaños de heap son la contabilidad propia de JavaScriptCore. - Resolución del temporizador:
performance.now()avanzaba aquí en pasos de 20 µs, así que medimos lotes, nunca llamadas cortas individuales. Los navegadores reducen aún más la precisión de los temporizadores por seguridad (no ejecutado aquí). - Versiones: los typed arrays son de ES2015,
BigIntyBigInt64Arrayde ES2020,WeakRef/FinalizationRegistryde ES2021.JSON.rawJSON, el texto fuente en el reviver deJSON.parseyMath.sumPreciseson mucho más nuevos; solo comprobamos que funcionan en este jsc.
Anterior: Clase 5: async, promesas y el event loop · Esta es la última clase de la serie.
Serie: 1 tipos e igualdad · 2 funciones, scope y closures · 3 objetos y arreglos · 4 clases, prototipos y módulos · Relacionados: rendimiento en Dart: JIT vs AOT y memoria (en inglés) · JVM, JIT y GC en Java (en inglés) · la hoja de ruta para aprender a programar
Preguntas frecuentes
¿Por qué JSON.parse cambia mi ID de 17 o 19 dígitos?
Todo número de JavaScript es un double de 64 bits, que guarda enteros exactos solo hasta 2^53 - 1 = 9007199254740991. JSON.parse('{"id": 9007199254740993}') devolvió 9007199254740992 sin ningún error. Envía los IDs grandes como strings o, en motores recientes, usa el texto fuente del reviver (ctx.source) para construir un BigInt; las dos opciones se comprobaron en jsc.
¿Es lento concatenar strings con += en JavaScript?
No por sí mismo. En JavaScriptCore, += sobre 200,000 filas tardó unos 14 ms, lo mismo que push en un arreglo + join (unos 15 ms). Se vuelve cuadrático cuando lees dentro del string que crece en cada iteración: con 40,000 filas, += más un charCodeAt por iteración tardó 564 ms contra 2.2 ms de += solo.
¿BigInt es más lento que Number?
Sí, mucho. Sumar i*i para un millón de valores tardó 0.94 ms con Number y 49.9 ms con BigInt, unas 53 veces más lento, en jsc sobre un Apple M1 Pro. Pero el resultado con Number era incorrecto sin avisar, porque pasó de 2^53. Usa BigInt donde importe la exactitud por encima de 2^53 (IDs, criptografía, contadores exactos) y Number en todo lo demás.