SQLi y XSS en PHP heredado sin cambiar la salida
90 correcciones de SQL y de salida en 36 archivos de un backend PHP de hace una década, con respuestas idénticas byte por byte. Lo que el escáner no vio.
Este artículo es para ti si te tocó corregir inyección SQL y XSS en un backend PHP viejo que todavía llaman apps móviles, donde cambiar aunque sea un byte de una respuesta puede romper una versión de la app que no puedes actualizar. Es la típica herencia de un primer trabajo o de un cliente que llega con "el sistema lo hizo alguien que ya no está". Nuestra conclusión: escapar en línea justo en las líneas que arman el SQL y la salida, mantener query(), y demostrar que la salida no cambió comparando respuestas reales guardadas, no leyendo el parche. Eso encontró dos agujeros que la revisión del código había pasado por alto.
El backend en cuestión corre en un hosting compartido (Hostinger, LiteSpeed con el CDN del hosting adelante). Tiene APIs JSON en PHP que usan ocho apps móviles, más páginas PHP de la época WebView. Las versiones viejas de las apps que siguen instaladas todavía abren esas páginas dentro de un WebView, así que no se pueden borrar sin más. Todos los números de abajo salen de la auditoría del 2026-11-09.
Lo que encontramos
| Área | Archivos | Notas |
|---|---|---|
| Archivos de API JSON en uso | 12 | Los llaman versiones actuales y viejas de las apps |
| Páginas PHP de la época WebView | 20 | Las siguen abriendo versiones viejas instaladas |
| Includes compartidos | 4 | Navegación, una clase de utilidades compartida, helpers |
| Carpetas sin uso | 7 | Ninguna app las llama |
Las siete carpetas sin uso fueron lo más alarmante. Incluían un endpoint de login estilo REST que comparaba contraseñas en texto plano y scripts de prueba que podían insertar y borrar filas. Nada las referenciaba, pero eran accesibles desde internet. Las movimos fuera de la raíz web en lugar de borrarlas. Ahora devuelven 404, y si resulta que algo dependía de ellas, volver a ponerlas toma segundos.
El escáner, y las dos cosas que se le escaparon
Empezamos con un escáner heurístico, un script corto de Python con expresiones regulares:
- HIGH:
$_GET,$_POSTo$_REQUESTaparece directamente en una línea que contiene SQL. - MED: una variable asignada desde la entrada, sin sanitizar, aparece después en un string de SQL.
"Contiene SQL" significaba una lista de palabras clave: SELECT, INSERT INTO, UPDATE … SET, DELETE FROM, WHERE, ORDER BY, LIMIT, VALUES, LIKE, o una llamada a ->query(. Encontró la mayoría de los casos. Dos tipos se le escaparon.
Fallo 1: líneas de continuación. El código viejo arma las consultas línea por línea:
$Query  = "SELECT … FROM … WHERE col1 = '".$_GET['k1']."'";
$Query .= " AND col2 = '".$_GET['k2']."'";
La primera línea quedó marcada. La segunda no, porque AND no estaba en la lista de palabras clave. El escáner vio una asignación desde la entrada, marcó $Query como contaminada y siguió de largo. No reportó la línea en sí.
Fallo 2: contaminación a través de arrays. Este patrón aparecía en una página de búsqueda:
$arr[0] = $_GET['keyword1'];
$arr[1] = $_GET['keyword2'];
sort($arr);
$kw = implode(' ', $arr);
…
$Query .= " AND name LIKE '%".$kw."%'";
$Query .= " OR  code = '".$kw."'";
El escáner seguía variables simples ($x = …), no elementos de un array ($arr[0] = …). La contaminación entró al array, se ordenó, se unió en un string y luego se usó tanto en LIKE '%…%' como en = '…'. El escáner nunca vio la conexión.
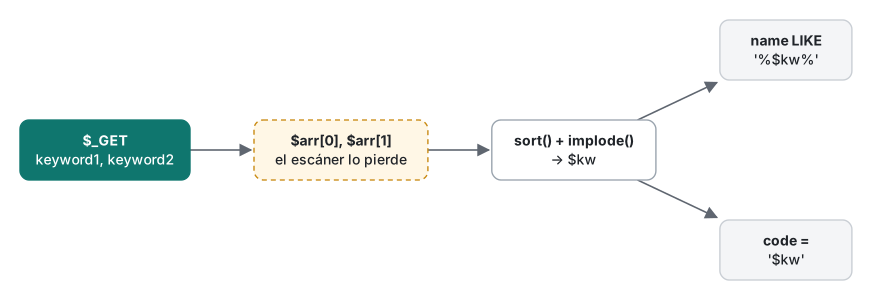
Una vez que conocimos estas dos formas, el rastreo manual encontró tres archivos más con el patrón del array. También encontró algo peor: una clase de utilidades compartida copiaba $_GET a una variable global, y un archivo distinto usaba esa global en su SQL. Ningún escáner que revise archivo por archivo ve eso. Solo lo encuentras siguiendo la cadena de includes.
La lección es simple: un escáner de regex te da una lista para empezar, no una prueba de que el código está limpio.
La corrección: escape en línea, no prepared statements
Los prepared statements son la respuesta correcta para código nuevo. Aquí habrían cambiado la salida de la API. Con mysqlnd, los prepared statements devuelven las columnas enteras y de punto flotante como números nativos, así que un campo JSON que era "7" pasa a ser 7. Los builds viejos de las apps que esperan un string pueden caerse por eso. Las mediciones están en nuestro artículo sobre prepared statements y los tipos en JSON (en inglés).
Así que escapamos cada valor solo en las líneas que arman $Query o $Sub_Query, y no tocamos nada más:
// before
$Query .= " AND col2 = '".$_GET['k2']."'";

// after
$Query .= " AND col2 = '".$Conn->real_escape_string((string)($_GET['k2'] ?? ''))."'";
El cast (string) cubre la entrada como array k2[]=x, que de otro modo lanzaría un TypeError en PHP 8. El ?? '' mantiene un parámetro ausente como el string vacío que en la práctica usaba el código viejo.
Por qué podíamos esperar una salida idéntica byte por byte con el tráfico real: real_escape_string solo toca siete caracteres: NUL, \n, \r, \, ', " y Ctrl-Z. Cada byte de un carácter UTF-8 multibyte vale 0x80 o más, así que las entradas con caracteres no ASCII y los dígitos (que es todo lo que las apps envían de verdad) pasan sin cambios. Lo mismo vale para la "ñ" o las tildes del español: ñ en UTF-8 son los bytes 0xC3 0xB1. El string SQL es el mismo, así que el conjunto de resultados y el JSON también.
Una advertencia para quien trabaje con sistemas heredados en japonés o chino: este razonamiento solo vale cuando el charset de la conexión es UTF-8, configurado con set_charset('utf8mb4'). Con Shift_JIS o GBK, el segundo byte de un carácter multibyte puede ser 0x5C (la barra invertida), y escapar con el charset equivocado es una forma conocida de escaparse de las comillas.
Conteo final:
| Ronda | Puntos SQL | Puntos de salida | Archivos |
|---|---|---|---|
| API | 13 | – | 12 |
| Páginas (pasada 1: 20 páginas, pasada 2: 4 includes compartidos) | 64 | 13 | 24 |
XSS: el contexto decide el escape
Las páginas devolvían parámetros de la petición dentro del HTML. La corrección depende de dónde cae el valor:
| Contexto de salida | Corrección |
|---|---|
Texto HTML (<h2>, <h3>) |
htmlspecialchars($v, ENT_QUOTES, 'UTF-8') |
Valor de atributo (value="…") |
lo mismo; ENT_QUOTES es obligatorio para atributos con comillas simples |
<title> armado dentro de una clase compartida |
escapar donde se arma el string del título, no en cada llamada |
URL dentro de un string de JS dentro de onclick |
primero rawurlencode, después htmlspecialchars |
La última fila necesita una explicación:
<a onclick="location.href='?d=<?= $d ?>'">          // vulnerable
<a onclick="location.href='?d=<?= htmlspecialchars($d, ENT_QUOTES, 'UTF-8') ?>'">  // still vulnerable
<a onclick="location.href='?d=<?= htmlspecialchars(rawurlencode($d), ENT_QUOTES, 'UTF-8') ?>'">  // ok
htmlspecialchars convierte ' en '. Pero el navegador decodifica las entidades del valor del atributo antes de pasárselo al motor de JavaScript, así que el JS ve una ' real y el string termina ahí. rawurlencode convierte la comilla en %27, que no significa nada para ninguno de los dos parsers. El htmlspecialchars de encima no cambia nada en su salida, pero mantiene simple la regla "todo atributo se escapa". Los valores reales en ese lugar eran fechas de 8 dígitos como 20251228, que rawurlencode deja intactas, así que la salida se mantuvo idéntica.
Cómo demostramos que la salida no cambió
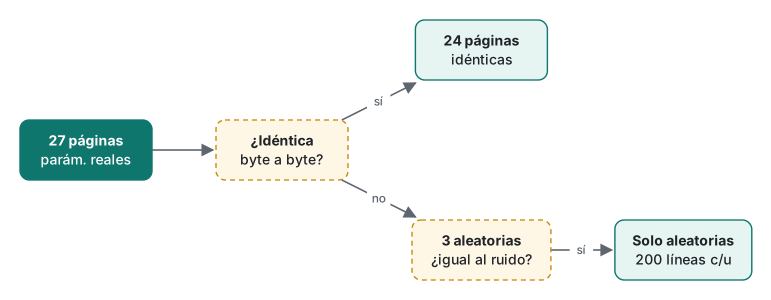
Antes de parchear, guardamos las respuestas de 27 páginas llamadas con parámetros reales tomados de las apps. Cada petición llevaba un parámetro de query único para saltarse la caché, así el CDN no podía responder desde caché (ya nos habían engañado respuestas cacheadas antes (en inglés)).
Después del deploy:
- 24 páginas: idénticas byte por byte.
- 3 páginas diferían. Muestran predicciones de números al azar, así que cada petición es distinta de todos modos.
Para las páginas aleatorias no aceptamos un "seguramente es la parte aleatoria". Pedimos cada página dos veces seguidas y registramos qué números de línea diferían entre esas dos descargas nuevas. Después comparamos la línea base contra la versión parcheada:
# condensed from the comparison script
def diff_lines(a: str, b: str) -> set[int]:
    return {i for i, (x, y) in enumerate(zip(a.splitlines(), b.splitlines())) if x != y}

noise   = diff_lines(fresh1, fresh2)       # random rows only
changed = diff_lines(baseline, patched)
assert len(fresh1.splitlines()) == len(patched.splitlines())
assert changed == noise                    # 200 lines each, same set
Los dos conjuntos eran las mismas 200 líneas, así que solo habían cambiado las filas aleatorias. La segunda pasada, que cubrió los cuatro includes compartidos, volvió a revisar 8 páginas más: todas idénticas. La comparación de snapshots de la API tuvo 0 fallas, y la verificación de URLs de todo el sitio pasó 53/53.
Probar el ataque cuando hay un WAF en el medio
La prueba obvia, ' OR '1'='1, no servía. El WAF del hosting la respondía con "Forbidden" antes de que corriera PHP, tanto para el código parcheado como para el sin parchear. Un WAF puede esconder un bug. No lo corrige, y un payload un poco distinto puede pasar.
Así que usamos entradas que el WAF ignora:
- SQL: una comilla simple sola. Los endpoints parcheados devolvieron
[]o un resultado vacío con status 200. Una comilla sin escapar produce en cambio un error de sintaxis SQL. - XSS: una etiqueta de prueba inofensiva,
<x1>, en cada parámetro. Después buscamos el<x1>literal en la respuesta HTML.
La primera pasada de XSS todavía reflejaba la etiqueta de prueba en dos lugares. Uno era un cuadro de búsqueda en un include compartido de navegación, el otro un título de página definido dentro de la clase de utilidades. Nuestro grep del código fuente no había visto ninguno de los dos, porque el valor entraba por un include y se imprimía lejos de donde se leía. Buscar en la respuesta los encontró. Por eso hicimos una segunda pasada sobre los cuatro includes.
Fallas que ya estaban ahí
Un control de regresión solo sirve si sabes qué estaba roto antes de empezar. Esto lo anotamos primero:
- Una página tenía un parse error de PHP (una llave sin cerrar) y siempre había devuelto 500. No desplegamos una versión parcheada de esa página. Arreglarla habría cambiado su comportamiento, y eso quedaba fuera del alcance de este trabajo.
- Las búsquedas que no coincidían con ninguna fila devolvían 500 antes y después del parche. Sin una línea base, eso parece exactamente una regresión.
Desplegar sin empeorar las cosas
- Modo solo actualización: el script de deploy abortaba si un archivo no existía ya en el servidor, así que un error de tipeo en una ruta no podía crear un archivo nuevo accesible.
- Backup primero: el original del servidor se descargaba antes de cada sobrescritura.
php -len cada archivo antes de subirlo. PHP 8.4 en local imprimióCase statements followed by a semicolon are deprecatedpara algunos archivos viejos. Ya existía y era inofensivo, pero tienes que saber que es viejo para que nadie frene el deploy por eso.
Qué enfoque elegir en cada caso
| Situación | Enfoque |
|---|---|
| Endpoint viejo, clientes que no puedes actualizar | Escape en línea en las líneas que arman SQL, mantener query(), comparar respuestas guardadas |
| Endpoint nuevo o versión nueva de la API | Prepared statements con un contrato de tipos documentado |
| Código sin uso pero accesible | Moverlo fuera de la raíz web, comprobar que devuelve 404, borrarlo después |
| El WAF bloquea tus payloads | Comilla sola y una etiqueta de prueba inofensiva; revisa la respuesta, no el código fuente |
| Contenido aleatorio en la página | Compara el conjunto de líneas cambiadas con el ruido entre dos descargas nuevas |
Lo clave: decide qué significa "sin cambios" antes de parchear, guarda la evidencia y deja que la comparación te diga si tenías razón.
Si quieres reforzar las bases antes de meterte con un backend así, revisa PHP desde cero: tipos, strings y arrays y INSERT, UPDATE, DELETE y restricciones en SQL. Y si el mismo servidor te da el error 1226 de MySQL, está explicado en max_connections_per_hour en hosting compartido.
Preguntas frecuentes
¿real_escape_string de mysqli cambia los textos con tildes, eñes o caracteres asiáticos?
No, siempre que el charset de la conexión sea UTF-8 (utf8mb4). Solo escapa NUL, \n, \r, la barra invertida, la comilla simple, la comilla doble y Ctrl-Z. Cada byte de un carácter UTF-8 multibyte vale 0x80 o más, así que el texto con á, ñ o caracteres CJK y los dígitos producen un SQL idéntico byte por byte.
¿Alcanza con htmlspecialchars para un valor dentro de un atributo onclick?
No. El navegador decodifica las entidades HTML del atributo antes de ejecutar el JavaScript, así que una comilla codificada se vuelve una comilla real dentro del string de JS. Para un valor que va en una URL dentro de ese string de JS, aplica primero rawurlencode y después htmlspecialchars.
¿Cómo pruebo una corrección de inyección SQL si el WAF del hosting bloquea mis payloads?
Usa entradas que el WAF deje pasar: una comilla simple sola para SQL (el endpoint corregido debería devolver un resultado vacío con 200, no un error de SQL) y una etiqueta inventada e inofensiva como <x1> para XSS, y después busca la etiqueta literal en la respuesta HTML.