循環キューのC++実装:満杯と空の区別、%とビットマスクの実測
2021年の循環キューに欠けていたisFullチェックで満杯のキューが空に見えるバグ、1スロット空ける方式とカウント方式、.NET Queue<T>の内部、%とビットマスクの添字計算の速度(849ms対214ms)。
2026年11月改訂: この記事は2021年に韓国語で書いた循環キューの講座を、日本語向けに書き直したものです。例を Apple clang 21(
-Wall -Wextra警告0件、ASan・UBSan 報告0件)で動かし直しました。ダミーのスロットを1つ設けて満杯と空を区別するという記事の説明は正しいのですが、enqueueがisFull()を一度も確かめておらず、1つ多く入れるだけで満杯のキューが自分を空だと報告します。サンプルの出力も今のコンパイラと違っており、原因は C++17 で変わった評価順序の規則でした。この2つの問題、正しい実装2通り、%とビットマスクの添字計算の実測をまとめます。
C/C++ で固定長の FIFO バッファ(音声やネットワークのバッファ、ログのリング、生産者・消費者キュー)を作る人と、C# の Queue<T> が内部で何をしているか知りたい人向けの記事です。循環キュー(リングバッファ)は配列にデータを置き、先頭(front)と末尾(rear)の添字だけをぐるりと回すので、dequeue で要素を動かしません。難しいのは添字を折り返すことではなく、満杯のリングと空のリングを見分けることで、これはサニタイザーが見つけてくれない種類のバグです。
普通の配列キューが遅い理由
先頭を常に0番に置く素朴な配列キューは、dequeue のたびに残りの要素を1つずつ前に詰めなければなりません。要素が1,000個なら1回の dequeue で999回の移動、キューを空にするまでで O(n²) です。解決策は、データの代わりに添字を動かすことです。
front:次に取り出す要素の添字rear:次の要素を書き込む添字- どちらも1ずつ進み、最後の添字の次は0に戻ります。
これで enqueue も dequeue も O(1) になり、配列はずっと使い回せます。そのかわり、front と rear だけでは要素がいくつ入っているか分からなくなります。(連結キューは容量そのものがないのでこの問題はありませんが、測ると約16倍遅くなりました。)
満杯と空のあいまいさ
4スロットの配列で考えます。最初は空で front == rear == 0。4つ入れると rear は 0 → 1 → 2 → 3 → また0 と進みます。完全に満杯なのに front == rear == 0 で、空の状態と見分けがつきません。
定番の解決策は2つです。
- 1スロット空けておく。
cap + 1個確保し、rearを1つ進めるとfrontに重なるなら満杯とみなします。空はfront == rear、満杯は(rear + 1) % n == front。2021年の記事が採った方法で、説明も正しいものでした。 - 要素数を数える。
headとcountを持ち、書き込み位置は(head + count) % cap。空はcount == 0、満杯はcount == cap。すべてのスロットを使えます。
.NET の Queue<T> は2つ目の方法です。.NET 10 でリフレクションを使って内部フィールドを読み、4スロットのキューを一周させて満杯にしたあとの状態です。
Int32[] _array, Int32 _head, Int32 _tail, Int32 _size, Int32 _version
array=[4,5,2,3] head=2 tail=2 size=4
after 5th item: array.Length=8 head=0 tail=5 size=5
head == tail なのに size は4。「満杯」を教えているのは要素数です。次の enqueue で配列が2倍になり、要素が順番どおりにコピーされます。
2021年のコードを動かす:欠けていた isFull チェック
2021年のクラスは capacity + 1 個のノードを確保し、isEmpty・isFull・getSize も正しく実装していました。ところが enqueue と dequeue がそれらを呼んでいません。enqueue は無条件に書いて rear を進め、dequeue は無条件に読んで front を進めます。3スロットのキューに4つ入れてみました。
CircularQueue cq(3);              // 使えるスロット3つ(+ダミー1つ)
for (int i = 1; i <= 4; i++) {
    cq.enqueue(i * 10);
    cout << "enqueue(" << i * 10 << ") -> size " << cq.getSize()
         << ", isEmpty " << cq.isEmpty() << ", isFull " << cq.isFull() << endl;
}
cout << "dequeue on 'empty' queue: " << cq.dequeue() << endl;
enqueue(10) -> size 1, isEmpty 0, isFull 0
enqueue(20) -> size 2, isEmpty 0, isFull 0
enqueue(30) -> size 3, isEmpty 0, isFull 1
enqueue(40) -> size 0, isEmpty 1, isFull 0
dequeue on 'empty' queue: 10
4回目の enqueue がダミーのスロットに書き込み、rear を front の位置に動かしました。キューは空だと言い張り、3つの値には届かなくなり、「空の」キューから dequeue しても古い 10 が出てきます。前の節のあいまいさに、チェックを省いたことでそのまま行き着いたわけです。
同じプログラムを -fsanitize=address,undefined でビルドし直しても報告はありません。 読み書きはすべて4要素の配列の内側で起きているので、サニタイザーから見れば何も問題がないのです。リングバッファの論理エラーは、ツールではなくテストとコード内のチェックで捕まえるしかありません。
2021年のコードを動かす:サンプル出力が違う理由
2021年のサンプルは、dequeue のたびに値と getFront()・getRear() を cout の1つの式で続けて出力していました。記事に載っていた最初と最後の行を、今の結果と並べます。
2021年の記事:  dequeued 10, Front: 3, Rear: 1  …  dequeued 520, Front: 0, Rear: 1
clang 21:     dequeued 10, Front: 4, Rear: 1  …  dequeued 520, Front: 1, Rear: 1
clang は -std=c++14 でも -std=c++17 でも同じ値でした。2021年の出力は、同じ式の中で getFront() が dequeue() より先に実行された場合の値です。C++17 より前は << の連鎖の被演算子をどの順で評価するか決まっておらず、コンパイラがそうしてもよかったのです。C++17(提案 P0145)からは << の被演算子は左から右へ評価する決まりになり、その結果が clang の出力です。2021年の記事の本文(「最終的に front と rear の添字はどちらも1」)も C++17 の結果と一致しており、載っていた出力とは合っていませんでした。直し方は簡単で、副作用のある呼び出しと、それが変える状態を読む呼び出しを1つの式に混ぜず、dequeue の結果をいったん変数に受けます。
また2021年の記事は、末尾が終端を越えると「キューの容量から末尾の添字を引く」と説明していましたが、実際には折り返し(wrap)です。rear は10番の次に0番へ戻るので、11スロットに3+9回 enqueue すると (3 + 9) mod 11 = 1 の位置にいます。
正しい循環キュー2通り
どちらも読み書きの前に確かめ、状態を壊すかわりに false を返します。
// A) 1スロット空ける:n = cap + 1
class SlotQueue {
    int* d_; int n_; int front_ = 0, rear_ = 0;
    int next(int i) const { return (i + 1) % n_; }
public:
    explicit SlotQueue(int cap) : d_(new int[cap + 1]), n_(cap + 1) {}
    ~SlotQueue() { delete[] d_; }
    SlotQueue(const SlotQueue&) = delete; SlotQueue& operator=(const SlotQueue&) = delete;
    bool empty() const { return front_ == rear_; }
    bool full()  const { return next(rear_) == front_; }
    int  size()  const { return (rear_ - front_ + n_) % n_; }
    bool enqueue(int v) { if (full()) return false; d_[rear_] = v; rear_ = next(rear_); return true; }
    bool dequeue(int& o) { if (empty()) return false; o = d_[front_]; front_ = next(front_); return true; }
};

// B) カウント方式:全スロットを使う
class CountQueue {
    int* d_; int cap_; int head_ = 0, count_ = 0;
public:
    explicit CountQueue(int cap) : d_(new int[cap]), cap_(cap) {}
    ~CountQueue() { delete[] d_; }
    CountQueue(const CountQueue&) = delete; CountQueue& operator=(const CountQueue&) = delete;
    bool empty() const { return count_ == 0; }
    bool full()  const { return count_ == cap_; }
    bool enqueue(int v) { if (full()) return false; d_[(head_ + count_) % cap_] = v; ++count_; return true; }
    bool dequeue(int& o) { if (empty()) return false; o = d_[head_]; head_ = (head_ + 1) % cap_; --count_; return true; }
};
容量3に同じ4回の enqueue をした結果です。
enqueue(10): slot ok   size 1 | count ok   size 1
enqueue(20): slot ok   size 2 | count ok   size 2
enqueue(30): slot ok   size 3 | count ok   size 3
enqueue(40): slot FULL size 3 | count FULL size 3
10 20 30 | dequeue on empty -> false
size() の (rear - front + n) % n の1行が、2021年の2分岐の getSize の代わりになります。選び方:1スロット空ける方式はフィールドが1つ少なく、生産者と消費者がそれぞれ自分の添字だけを書く単一生産者・単一消費者のロックフリーなリングに向いています。カウント方式は全スロットを使えて読みやすい方式です。
% とビットマスクの添字計算(実測)
enqueue と dequeue のたびに、折り返した添字を計算します。やり方は3つです。
i = (i + 1) % cap;           // 剰余:どんな容量でも
i = (i + 1) & (cap - 1);     // ビットマスク:容量は2のべき乗
if (++i == cap) i = 0;       // 比較してゼロに戻す:どんな容量でも
カウント方式のリングにそれぞれを入れ、容量1,024はコマンドライン引数から読んで、コンパイラが定数扱いできないようにしました。半分まで詰めてから enqueue+dequeue を2億組。Apple clang 21 -O2、Apple M1 Pro、3回実行です。
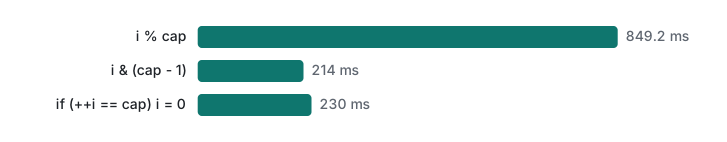
| 添字の折り返し | 1回目 | 2回目 | 3回目 |
|---|---|---|---|
% cap |
849.2 ms | 838.0 ms | 852.7 ms |
& (cap - 1) |
214.0 ms | 211.9 ms | 217.7 ms |
if (++i == cap) i = 0 |
230.0 ms | 228.7 ms | 244.2 ms |
剰余版は約4倍遅くなりました。生成された arm64 のコードを見ると理由が分かります。
(i + 1) % 1024u    (定数)        ->  add, and #0x3ff
(i + 1) % cap      (実行時の値)   ->  add, udiv, msub
(i + 1) % 1024     (符号付き int) ->  add, negs, and, and, csneg
容量が2のべき乗の定数なら、コンパイラがすでにマスクに変えてくれるので、手で & を書いても得はありません。容量が実行時に決まるなら本物の割り算が必要で、849ms がそのコストです。符号付き int の添字は定数でも負数の扱いのために命令が増えるので、添字は unsigned にしておくのが無難です。2のべき乗のサイズを強制できない場合は、比較してゼロに戻す分岐がマスクとほぼ同じ速さでした。分岐予測がほぼ常に当たるためです。
言語ごとの組み込み
| 言語 | リングバッファのキュー | 補足 |
|---|---|---|
| C# | Queue<T> |
要素数(_size)を持つ循環配列で、2倍ずつ拡張。空の場合は TryDequeue |
| C++ | std::queue<T> |
既定は std::deque で固定長のリングではない。連結キューの実測でリング14.5ms、std::queue 16.7ms |
| C++ の固定容量 | 自作するか boost::circular_buffer |
C++ 標準ライブラリに固定容量のリングバッファはない |
LIFO 側の同じオーバーフロー・アンダーフローのチェックはスタックの記事に、配列のスロットではなくノードで作る輪は循環連結リストの記事にあります。
テスト環境:Apple clang 21.0.0(-std=c++14/17/20 -Wall -Wextra、-fsanitize=address,undefined -g)、.NET SDK 10.0.403 / ランタイム 10.0.14、Apple M1 Pro。
よくある質問
循環キューはなぜ満杯と空を区別できない?
front と rear の添字だけだと、空のキューも完全に満杯のキューも front == rear になるからです。もう1つ規則が要ります。1スロットを空けておく(満杯は (rear + 1) % n == front)か、要素数を数える(空は count == 0、満杯は count == 容量)かです。.NET の Queue<T> は _size フィールドを持っており、満杯の4スロットのキューで head == tail == 2、size 4 を確認しました。
リングバッファの添字はビットマスクの方が % より本当に速い?
容量が実行時に決まるなら速いです。1,024スロットのリングで enqueue+dequeue を2億組くり返すと、% は849.2ms、& (cap - 1) は214.0ms、比較してゼロに戻す分岐は230.0msでした(Apple clang 21 -O2、Apple M1 Pro)。容量がコンパイル時の2のべき乗の定数なら、clang が % をすでに and 命令に変えます。
満杯の循環キューにチェックなしで enqueue するとどうなる?
2021年のコードでは、3スロットのキューに4回目の enqueue をすると rear が front の位置に来て、getSize() が0、isEmpty() が true を返し、入っていた3つの値が黙って失われました。どのアクセスも配列の内側なので、AddressSanitizer も UBSan も何も報告しませんでした。