자바스크립트 객체와 배열: map·reduce·복사 함정
자바스크립트 강좌 3. map/filter/reduce, 스프레드와 구조 분해, 얕은 복사 함정, sort() 에서 100 이 9 앞에 오는 이유, 한글 정렬, reduce 안 스프레드의 O(n²) 를 jsc 로 실측.
시리즈: 자바스크립트 강좌 3/6 (중급). map 과 filter 는 매일 쓰지만 가끔 원본 배열이 바뀌어 있거나, sort() 가 100 을 9 앞에 두거나, reduce 가 이유 없이 느려지는 분을 위한 글입니다. 다 읽으면 배열 메서드를 알맞게 고르고, 중첩된 부분을 실수로 공유하지 않게 복사하고, 숫자와 한글 문자열을 바르게 정렬하고, 제곱 시간이 걸리는 코드를 배포 전에 알아볼 수 있습니다.
실제 서비스의 자바스크립트는 대부분 데이터 처리입니다. API 가 객체 배열을 돌려주면 걸러 내고, 모양을 바꾸고, 묶고, 정렬해서 화면에 넘깁니다. 여기서 나는 버그는 대개 크래시가 아닙니다. 초안을 고쳤더니 모든 사용자의 기본 설정이 바뀌었다(얕은 복사), 랭킹에서 100 점이 9 점보다 아래에 있다, 영문 이름이 한글 이름보다 먼저 나와서 기획에서 다시 요청이 왔다, 통계 화면이 1초 동안 멈춘다(무해해 보이는 스프레드 하나). 자바의 스트림을 써 본 분이라면 map/filter 는 익숙하겠지만, 자바스크립트 배열 메서드는 지연 평가가 아니라 즉시 새 배열을 만든다는 점이 다릅니다. 아래 출력은 모두 macOS 26.6(Apple Silicon M1 Pro)의 JavaScriptCore 셸 jsc 로 실행했습니다. 별칭은 1강을 보세요. Node.js 와 브라우저는 실행하지 않았습니다.
객체: 속성, 없는 키, ?.
객체는 키와 값의 쌍(속성)의 모음입니다. 키는 문자열(또는 심볼)이고 값은 무엇이든 됩니다.
const user = { name: "Mina", age: 29, "favorite-color": "teal", tags: ["admin"] };
print(user.name, user["favorite-color"], user.email);
user.email = "x";                  // const 라도 객체 내용은 바꿀 수 있다
delete user.email;
print(Object.keys(user).join(","), "age" in user, Object.hasOwn(user, "toString"), "toString" in user);
print(user.address?.city, user.address?.city ?? "unknown");
print(JSON.stringify(user));
print(user.address.city);
Mina teal undefined
name,age,favorite-color,tags true false true
undefined unknown
{"name":"Mina","age":29,"favorite-color":"teal","tags":["admin"]}
Exception: TypeError: undefined is not an object (evaluating 'user.address.city')
global code@obj.js:8:19
실무에서 중요한 점입니다.
- 없는 속성은
undefined이고 오류가 아닙니다. 오류는 한 걸음 뒤, 그undefined의 속성을 또 읽을 때 납니다. 자바라면NullPointerException이 날 자리입니다. JavaScriptCore 는 실패한 식 전체(user.address.city)를 보여 주고, 크롬과 Node 는Cannot read properties of undefined (reading 'city')라고 표시합니다(여기서는 실행 안 함). const가 고정하는 것은 변수 연결이지 객체가 아닙니다.const객체에 속성을 추가하거나 지우는 것은 자유입니다. 자바의final참조와 같은 개념입니다.in은 프로토타입 체인까지 찾아서"toString" in user가 true 이고,Object.hasOwn은 그 객체 자신만 봅니다. 프로토타입은 4강에서 다룹니다.- 옵셔널 체이닝
a?.b는a가null이나undefined면 멈추고undefined를 돌려줍니다.??와 함께 쓰면 기본값이 됩니다. 없는 게 정상인 항목에 쓰고, 반드시 있어야 할 데이터가 빠진 것을 숨기는 용도로는 쓰지 마세요.
map·filter·reduce 와 친구들
배열 메서드는 콜백, 즉 요소마다 한 번씩 호출되는 함수를 받습니다. 가장 많이 쓰는 셋입니다.
const orders = [
  { id: 1, item: "pen",    price: 120, qty: 3 },
  { id: 2, item: "note",   price: 300, qty: 1 },
  { id: 3, item: "eraser", price: 80,  qty: 0 },
  { id: 4, item: "pen",    price: 120, qty: 2 },
];
const lines = orders.filter(o => o.qty > 0).map(o => ({ item: o.item, total: o.price * o.qty }));
print(JSON.stringify(lines));
print("sum:", lines.reduce((acc, l) => acc + l.total, 0));
const byItem = orders.reduce((acc, o) => { acc[o.item] = (acc[o.item] ?? 0) + o.qty; return acc; }, {});
print(JSON.stringify(byItem));
print(orders.find(o => o.price > 100).item, orders.findIndex(o => o.qty === 0),
      orders.some(o => o.qty === 0), orders.every(o => o.price > 50));
[{"item":"pen","total":360},{"item":"note","total":300},{"item":"pen","total":240}]
sum: 900
{"pen":5,"note":1,"eraser":0}
pen 2 true true
filter는 콜백이 truthy 를 돌려준 요소만 남기고,map은 각 요소를 새 값으로 바꿉니다. 둘 다 새 배열을 돌려주고 원본은 건드리지 않습니다.reduce는 배열을 하나의 값으로 접습니다. 두 번째 인수가 처음 누산기(accumulator) 값입니다.find/findIndex는 처음 찾은 곳에서 멈추고,some/every는 "하나라도/전부" 를 판정하며 역시 중간에 멈춥니다.- 이
jsc에서 동작을 확인한 최신 메서드:Object.groupBy(orders, o => o.item)은{"pen":[…2건…],…}을 돌려줬고,[1, [2, [3]]].flat()은1,2,3,[1, 2].flatMap(x => [x, x * 10])은1,10,2,20,[1, 2, 3].at(-1)은3이었습니다.
초깃값을 빠뜨리는 것은 데이터가 비었을 때만 터지는 전형적인 크래시입니다.
$ jsc reduce.js        # [].reduce((a, b) => a + b);
Exception: TypeError: reduce of empty array with no initial value
reduce@[native code]
global code@reduce.js:1:10
초깃값을 넣은 [].reduce((a, b) => a + b, 0) 은 0 이었습니다. 개발 서버에는 데이터가 있어서 통과하고, 운영에서 "오늘 주문 0건" 인 날 터지는 패턴입니다. 초깃값은 항상 넣으세요.
| 하고 싶은 것 | 쓸 것 | 돌려주는 값 |
|---|---|---|
| 모든 요소 변환 | map |
같은 길이의 새 배열 |
| 일부만 남기기 | filter |
같거나 짧은 새 배열 |
| 첫 일치 / 그 위치 | find / findIndex |
요소나 undefined / 위치나 -1 |
| 하나라도 / 전부 일치? | some / every |
불리언(중간에 멈춤) |
| 값 하나(합계·최댓값·객체) | 초깃값 있는 reduce |
무엇이든 |
| 묶기 | Object.groupBy (ES2024) |
배열을 값으로 가진 객체 |
| 부수 효과만 | for...of |
없음. break 가능 |
스프레드와 구조 분해 할당
스프레드(...)는 배열이나 객체를 새 배열·객체 안에 펼치고, 구조 분해 할당은 값을 꺼내 변수에 담습니다.
const user = { name: "Mina", age: 29, address: { city: "Springfield" } };
const { name, age: years, role = "member", address: { city } } = user;
print(name, years, role, city);                       // Mina 29 member Springfield
const [first, , third = "none", ...others] = ["a", "b"];
print(first, third, others.length);                   // a none 0
let p = 1, q = 2; [p, q] = [q, p]; print(p, q);       // 2 1
print(JSON.stringify({ ...{ a: 1, b: 2 }, ...{ b: 3 } }), Math.max(...[3, 9, 4]));  // {"a":1,"b":3} 9
function draw({ x = 0, y = 0 } = {}) { return `${x},${y}`; }
print(draw(), draw({ x: 5 }));                        // 0,0 5,0
const { missing: { deep } } = user;
Exception: TypeError: Cannot destructure property 'deep' from null or undefined value
global code@destr.js:10:35
이름 바꾸기(age: years), 기본값(role = "member"), 건너뛰기(, ,), 맞바꾸기가 모두 표시대로 동작했습니다. 뒤에 오는 스프레드가 이깁니다(b 는 3). 매개변수 구조 분해에 = {} 기본값을 달아 두면 호출하는 쪽이 인수 자체를 생략할 수 있습니다. 없는 속성을 중첩해서 구조 분해하면 user.missing.deep 과 마찬가지로 예외가 납니다.
흔한 실수: 얕은 복사
실수. 설정을 스프레드로 복사한 뒤 사본을 고친다.
const original = { name: "Mina", prefs: { theme: "dark" }, tags: ["admin"] };
const copy = { ...original };            // 얕은 복사
copy.name = "Ken";
copy.prefs.theme = "light";
copy.tags.push("editor");
print(original.name, original.prefs.theme, original.tags.join("+"));
print(copy.prefs === original.prefs);
Mina light admin+editor
true
실제로 일어나는 일. 스프레드는 첫 단계만 복사합니다. name 은 문자열이라 사본에 따로 생겼습니다. prefs 와 tags 는 객체이고, 복사되는 것은 참조(객체를 가리키는 화살표)라서 두 변수가 같은 prefs, 같은 tags 를 가리킵니다. 화면으로 치면 "초안을 고쳤더니 모두의 기본값이 바뀌었다" 버그입니다.
고치는 법과 jsc 에서 확인한 것:
const withDate = { at: new Date(Date.UTC(2026, 10, 12)), missing: undefined, m: new Map([["a", 1]]) };
const viaJson = JSON.parse(JSON.stringify(withDate));
print(typeof withDate.at, typeof viaJson.at, "missing" in viaJson, JSON.stringify(viaJson.m));
try { JSON.stringify({ n: 1n }); } catch (e) { print(e.name + ": " + e.message); }
print(typeof structuredClone);
try { structuredClone(original); } catch (e) { print(e.name + ": " + e.message); }
object string false {}
TypeError: JSON.stringify cannot serialize BigInt.
undefined
ReferenceError: Can't find variable: structuredClone
- JSON 왕복이 깊은 복사가 되는 것은 순수 JSON 데이터뿐입니다.
Date는 문자열이 되어 돌아왔고,undefined속성은 사라졌고,Map은{}가 됐고,BigInt는 예외를 던집니다. structuredClone은 브라우저와 Node 17 이상에서 쓰는 현대적인 답입니다(여기서는 실행 안 함). ECMAScript 가 아니라 HTML 표준에 정의되어 있고, 이jsc에는 없습니다. 엔진 셸이나 오래된 임베디드 런타임에서도 돌아야 하는 코드에는 대안이 필요합니다.
순수 데이터용 작은 대안을 여기서 실제로 시험했습니다.
function deepClone(v) {
  if (v === null || typeof v !== "object") return v;
  if (v instanceof Date) return new Date(v.getTime());
  if (Array.isArray(v)) return v.map(deepClone);
  if (v instanceof Map) return new Map([...v].map(([k, x]) => [k, deepClone(x)]));
  if (v instanceof Set) return new Set([...v].map(deepClone));
  return Object.fromEntries(Object.entries(v).map(([k, x]) => [k, deepClone(x)]));
}
const clone = typeof structuredClone === "function" ? structuredClone : deepClone;
clone(original) 뒤에 사본의 중첩 값을 고쳐도 원본은 dark admin 1 그대로였고, 복사된 Date 는 별개의 진짜 Date 였습니다. 순환 참조와 클래스 인스턴스는 처리하지 않습니다. 그럴 때가 structuredClone 의 차례입니다. Object.freeze 도 똑같이 얕습니다. Object.freeze({ mode: "prod", limits: { max: 10 } }) 다음에도 cfg.limits.max = 99 는 통과했고(99 출력), cfg.mode = "dev" 만 strict 모드에서 TypeError: Attempted to assign to readonly property. 를 냈습니다.
sort() 함정과 한글 정렬
const scores = [10, 9, 1, 100, 25];
const sorted = scores.sort();
print(sorted.join(","), "| original now:", scores.join(","), "| same array:", sorted === scores);
print([10, 9, 1, 100, 25].sort((a, b) => a - b).join(","));
const nums = [10, 9, 1, 100, 25];
print(nums.toSorted((a, b) => a - b).join(","), "| nums untouched:", nums.join(","));
print([undefined, 3, null, 1].sort().join("|"));
print(["1", "2", "3"].map(parseInt).join(","), ["1", "2", "3"].map(Number).join(","));
1,10,100,25,9 | original now: 1,10,100,25,9 | same array: true
1,9,10,25,100
1,9,10,25,100 | nums untouched: 10,9,1,100,25
1|3||
1,NaN,NaN 1,2,3
- 비교 함수 없는
sort()는 문자열로 비교하므로"100" < "25" < "9"가 됩니다. 숫자는(a, b) => a - b(음수면 a 가 앞)를 넘깁니다. 자바의Arrays.sort(int[])와 가장 크게 다른 점입니다. sort()는 원본을 바꾸고 같은 배열을 돌려줍니다(same array: true).toSorted()(ES2023)는 사본을 돌려주고nums는 그대로였습니다.undefined는 항상 맨 뒤,null은 문자열"null"로 비교되어3뒤에 옵니다(join이 둘 다 빈 문자열로 찍어서1|3||).- 같은 계열의 함정이
map(parseInt)입니다.map은(요소, 인덱스)를 넘기므로parseInt("2", 1)이 1 을 진법으로 해석해NaN이 됩니다.
한글과 영문이 섞인 회원 목록에서는 기본 정렬이 또 다른 문제를 만듭니다.
const ko = ["홍길동", "김철수", "이영희", "Kim", "kang", "강감찬"];
print(ko.toSorted().join(","));
print(ko.toSorted((a, b) => a.localeCompare(b, "ko")).join(","));
const files = ["file10.txt", "file9.txt", "file1.txt"];
print(files.toSorted((a, b) => a.localeCompare(b, undefined, { numeric: true })).join(","));
Kim,kang,강감찬,김철수,이영희,홍길동
강감찬,김철수,이영희,홍길동,kang,Kim
file1.txt,file9.txt,file10.txt
기본 sort() 는 UTF-16 코드 단위 순서라서 대문자 K 가 소문자 k 보다 앞이고, 영문이 전부 한글보다 먼저 옵니다. 한글 음절은 유니코드에 가나다순으로 놓여 있어서 한글끼리는 우연히 맞습니다. localeCompare(b, "ko") 는 한국어 규칙대로 한글을 먼저, 영문은 대소문자를 구분하지 않고(kang 다음 Kim) 뒤에 두었습니다. { numeric: true } 를 주면 file9 가 file10 앞에 옵니다. 어느 쪽 순서가 맞는지는 기획의 몫이지만, 기본 정렬은 어느 기획에도 맞지 않는다는 것만은 확실합니다.
널리 퍼진 실수로 불리언을 돌려주는 비교 함수 (a, b) => a > b 가 있습니다. 명세상 이것은 일관성 없는 비교 함수이고 결과는 구현에 따라 다릅니다. 솔직하게 시험해 봤습니다. 이 jsc 에서는 시드를 고정한 5~50,000개짜리 배열 100개를 a > b 로 정렬한 결과가 a - b 와 완전히 같았습니다(불일치 0). 그래도 올바른 코드는 아닙니다. V8(크롬, Node)은 크롬 70 무렵 TimSort 로 바꾼 뒤로 이 비교 함수에서 정렬되지 않은 결과를 낸다고 널리 보고되어 있습니다(여기서는 실행 안 함). "사파리에서는 되는" 코드가 다른 곳에서 깨지는 것입니다. 비교 함수는 숫자를 돌려주세요.
ES2019 부터 sort 는 안정 정렬이어야 해서 키가 같은 요소는 원래 순서를 유지합니다. 나이로 A30 B25 C30 D25 를 정렬하니 여기서는 BDAC 였습니다.
실측: reduce 안의 스프레드는 제곱으로 느려진다
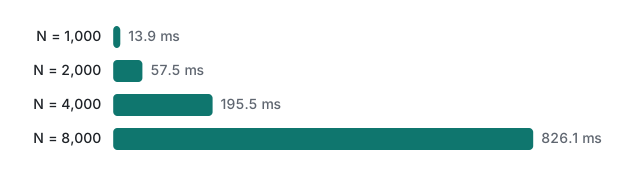
"불변(immutable)" 스타일이라며 reduce 안에서 스프레드로 색인을 만드는 코드를 자주 봅니다. 시드를 고정한 N 건으로 {id → item} 을 두 방식으로 만들고 배열 버전도 비교했습니다(spreadreduce.js, 칸마다 5회 중앙값, 프로세스 2번, Apple M1 Pro).
const spreadWay = items => items.reduce((acc, it) => ({ ...acc, [it.id]: it }), {});
const mutateWay = items => items.reduce((acc, it) => { acc[it.id] = it; return acc; }, {});
const arrSpread = items => items.reduce((acc, it) => [...acc, it.score], []);
const arrPush   = items => items.reduce((acc, it) => { acc.push(it.score); return acc; }, []);
N=1000: obj spread 13.9 ms | obj mutate 0.12 ms | arr spread 2.0 ms | arr push 0.04 ms
N=2000: obj spread 57.5 ms | obj mutate 0.08 ms | arr spread 6.6 ms | arr push 0.02 ms
N=4000: obj spread 195.5 ms | obj mutate 0.14 ms | arr spread 22.7 ms | arr push 0.08 ms
N=8000: obj spread 826.1 ms | obj mutate 0.30 ms | arr spread 49.7 ms | arr push 0.04 ms
두 번째 프로세스에서 객체 스프레드 열은 13.0 / 52.7 / 196.0 / 859.9 ms 였습니다. N 이 2배가 될 때마다 스프레드 버전은 약 4배가 됩니다. 매 단계 누산기 전체를 복사하므로 전체 일의 양이 1 + 2 + … + N, 즉 N² 에 비례하기 때문입니다. 8,000건이면 화면이 1초 가까이 멈춥니다. 여기서 누산기를 직접 고쳐도 안전한 이유는, 그것이 reduce 가 방금 만든, 누구에게도 보이지 않는 객체이기 때문입니다. 불변으로 지켜야 할 것은 공유되는 데이터이지, 혼자 쓰는 누산기가 아닙니다.
참고로 숫자 100만 개의 합을 네 방식으로(같은 기기, 5회, 워밍업 이후) 재 보니 for (i) 반복문이 약 0.5 ms, reduce 0.6 ms, for...of 1.0 ms, forEach 2.8 ms 였습니다. 5배 차이지만 100만 건에 3 ms 미만입니다. 어떤 메서드를 고르느냐보다 제곱으로 만들지 않는 것이 훨씬 중요합니다.
한계와 버전 메모
- 엔진: macOS 26.6.2 에 들어 있는 JavaScriptCore(프레임워크 21624.5.1.11.3)를
jsc로 실행했고, Node.js·Deno·브라우저는 실행하지 않았습니다. V8 동작과 메시지에 관한 내용은 그렇다고 표시했으며, 공개된 보고에 근거한 것이지 우리가 실행한 결과가 아닙니다. - 이 jsc 에 없는 것:
structuredClone(ECMAScript 가 아니라 HTML 표준)과console. 있음을 확인한 것:Object.groupBy,toSorted,toReversed,with,findLast,at,Object.hasOwn,flat/flatMap,Intl.Collator(ko로케일). - 버전: 배열 스프레드와 구조 분해는 ES2015, 객체 스프레드는 ES2018,
flat/flatMap/Object.fromEntries와 안정 정렬은 ES2019,?.와??는 ES2020,at과Object.hasOwn은 ES2022,toSorted/toReversed/with/findLast는 ES2023,Object.groupBy는 ES2024 입니다. 오래된 브라우저나 임베디드 엔진에는 최신 기능이 없을 수 있으니 이번처럼typeof로 확인하세요. - 시간은 한 대에서 잰 중앙값입니다. 보여 주려는 결과는 제곱이라는 모양이지 정확한 밀리초가 아닙니다.
연습 문제
1. 원본 배열을 바꾸지 않고 나이순, 나이가 같으면 이름순으로 정렬하세요: [{ name: "Ken", age: 30 }, { name: "Ann", age: 25 }, { name: "Bo", age: 30 }].
2. const bad = [...matrix]; bad[0][0] = 9; 를 하면 matrix 도 바뀝니다. 이유를 설명하고, 범용 깊은 복사 없이 2차원 배열용으로 고치세요.
정답
1. users.toSorted((a, b) => a.age - b.age || a.name.localeCompare(b.name)) 는 Ann,Bo,Ken 을 출력했고, 원본 순서는 Ken,Ann,Bo 그대로였습니다. 나이가 같으면 a.age - b.age 가 0(falsy)이라 || 가 이름 비교로 넘어갑니다.
2. 스프레드는 바깥 배열만 복사했고 행들은 공유된 참조 그대로입니다. matrix 는 [[9,2],[3,4]] 가 됐습니다. 한 단계 더 깊이 복사합니다: const good = m2.map(row => [...row]); 에서는 m2 가 [[1,2],[3,4]] 그대로이고 good 만 [[9,2],[3,4]] 가 됐습니다.
다음 강좌
4강에서는 toString 과 push 가 어디서 오는지 설명합니다. 프로토타입, class 문법, 비공개 #필드, getter, instanceof, 그리고 모듈이 무엇이고 jsc 에서 무엇이 되고 안 되는지 다룹니다.
- 이전: 자바스크립트 강좌 2/6: 함수·스코프·클로저
- 다음: 자바스크립트 강좌 4/6: 클래스·프로토타입·모듈
- 시리즈 이후: 비동기·Promise·이벤트 루프, 성능·메모리·숫자
- 비교해서 읽기: 자바 스트림·람다·Optional, 파이썬 자료형과 가변성
- 전체 지도: 프로그래밍 학습 로드맵
자주 묻는 질문
[10, 9, 1, 100].sort() 에서 왜 100 이 9 보다 앞에 오나요?
비교 함수 없이 쓴 sort() 는 요소를 문자열로 바꿔 한 글자씩 비교하기 때문에 "100" 이 "9" 보다 앞섭니다. 숫자라면 arr.sort((a, b) => a - b) 처럼 비교 함수를 넘깁니다. sort() 는 원본 배열도 바꾼다는 점에 주의하세요. toSorted()(ES2023)는 정렬된 사본을 돌려줍니다.
스프레드 문법은 깊은 복사인가요?
아닙니다. { ...obj } 와 [...arr] 는 첫 단계만 복사하고, 중첩된 객체와 배열은 공유됩니다. copy.prefs.theme 을 바꾸면 original.prefs.theme 도 바뀝니다. structuredClone(브라우저, Node 17 이상. 이번에 쓴 jsc 에는 없었음), 순수 JSON 데이터라면 JSON.parse(JSON.stringify(x)), 또는 작은 재귀 복사 함수를 씁니다.
reduce 안에서 스프레드를 쓰면 느린가요?
느리고, 시간 복잡도가 제곱입니다. reduce((acc, x) => ({ ...acc, [x.id]: x }), {}) 는 매 단계 누산기 전체를 복사하기 때문입니다. jsc 실측에서 8,000건에 약 830 ms, 누산기를 직접 고치는 버전은 0.3 ms 였습니다. 입력을 2배로 늘리면 시간이 약 4배가 됐습니다.