파이프와 리다이렉션 입문: grep·sort·uniq로 로그 집계
표준 입력·출력·에러, >·>>·2>&1·파이프를 직접 만든 2만 줄 로그로 연습. uniq·cut 이 조용히 틀리는 경우, sort 로 파일이 비는 함정, 셸 루프와의 속도 차이 실측.
시리즈: 명령줄 강좌 2/6 (초급). 터미널에서 폴더를 오갈 수 있게 된 사람(강좌 1)이 "오늘 모듈별로 에러가 몇 건 났지?" 같은 질문에 엑셀을 열지 않고 답할 수 있게 되는 회차입니다. 작은 도구를 파이프로 잇고, 출력과 에러를 원하는 곳으로 보내는 법을 익힙니다.
장애가 났을 때 운영 로그를 less 로 한참 넘겨 본 적이 있거나, 2만 줄을 엑셀에 붙여 넣어 개수를 센 적이 있다면 이 글이 그 일을 한 줄로 끝내 줍니다. 똑같이 재현할 수 있도록 고정 시드로 애플리케이션 로그를 만들고, 대표적인 grep | cut | sort | uniq -c 파이프라인을 한 단계씩 쌓아 올립니다. 그 과정에서 파이프라인이 에러 없이 틀린 숫자를 내는 다섯 가지 실수도 직접 재현하는데, 그중 하나는 작업 중인 파일을 통째로 비웁니다.
이전 강좌: 강좌 1, 경로와 파일. 전체 그림은 학습 로드맵에 있습니다.
실행 환경: macOS 26.6, Apple Silicon Mac(M1 Pro), zsh 5.9 와 bash 3.2.57, BSD 판 grep 2.6.0-FreeBSD·sort·uniq·cut·wc. 샘플 데이터를 만들 때만 Python 3.9.6 을 썼습니다. 출력은 터미널에서 그대로 옮겼고 홈 경로만 ~ 로 줄였습니다.
연습용 로그 만들기
실제 로그에는 사용자 데이터가 들어 있으니 연습용은 직접 만듭니다. 아래를 gen_log.py 로 저장하세요.
# gen_log.py - make a fake application log (same seed -> same file)
import random, sys
from datetime import datetime, timedelta

n = int(sys.argv[1]) if len(sys.argv) > 1 else 20000
rng = random.Random(42)
t = datetime(2026, 11, 12, 9, 0, 0)
levels = ["INFO"] * 80 + ["WARN"] * 12 + ["ERROR"] * 6 + ["DEBUG"] * 2
modules = ["auth", "cart", "db", "payment", "search"]
msgs = {"INFO": ["request ok", "cache hit", "login ok"],
        "WARN": ["slow query", "retrying"],
        "ERROR": ["timeout", "connection refused", "invalid token"],
        "DEBUG": ["state dump"]}
for _ in range(n):
    t += timedelta(seconds=rng.randint(0, 3))
    lv = rng.choice(levels)
    mod = rng.choice(modules[:3] if lv == "ERROR" and rng.random() < 0.5 else modules)
    ms = int(rng.lognormvariate(4.5, 0.8)) + (2000 if lv == "ERROR" else 0)
    print(f"{t:%Y-%m-%d %H:%M:%S} {lv:<5} {mod} user=u{rng.randint(1, 300):03d} ms={ms} {rng.choice(msgs[lv])}")
{lv:<5} 를 눈여겨보세요. 실제 로거들이 흔히 그러듯 레벨을 다섯 글자로 맞춥니다. 이 작은 부분이 나중에 발목을 잡습니다.
~/demo/logs % python3 gen_log.py > app.log

~/demo/logs % wc -l app.log
   20000 app.log

~/demo/logs % head -3 app.log
2026-11-12 09:00:00 INFO  db user=u053 ms=59 login ok
2026-11-12 09:00:00 INFO  payment user=u288 ms=35 request ok
2026-11-12 09:00:03 INFO  payment user=u004 ms=171 request ok

~/demo/logs % tail -2 app.log
2026-11-12 17:20:52 INFO  cart user=u073 ms=87 cache hit
2026-11-12 17:20:54 INFO  search user=u286 ms=146 login ok
wc -l 은 줄 수, head 와 tail 은 앞과 뒤의 줄(기본 10줄, -3 이면 3줄)을 보여 줍니다. 같은 스크립트로 만들었다면 md5 app.log 결과는 2ba81430e328ad259f3d851999fa857e 입니다.
세 개의 스트림: 표준 입력, 표준 출력, 표준 에러
모든 프로그램은 번호가 붙은 스트림 세 개를 열어 둔 채로 시작합니다.
- 0, 표준 입력(stdin): 읽어 들이는 곳. 리다이렉트하지 않으면 키보드.
- 1, 표준 출력(stdout): 정상 결과. 리다이렉트하지 않으면 화면.
- 2, 표준 에러(stderr): 에러 메시지. 역시 화면이지만 다른 통로입니다.

두 출력이 따로라는 건, 있는 파일과 없는 파일을 ls 에 같이 주고 표준 출력만 돌려 보면 알 수 있습니다.
~/demo/logs % ls app.log nothere.log
ls: nothere.log: No such file or directory
app.log

~/demo/logs % ls app.log nothere.log > out.txt
ls: nothere.log: No such file or directory

~/demo/logs % cat out.txt
app.log
> 는 1번만 돌리기 때문에 에러는 화면에 남았습니다. 결과를 파일로 저장해도 문제는 눈에 보이게 하는, 쓸모 있는 설계입니다.
리다이렉션: >, >>, 2>, 2>&1, /dev/null
~/demo/logs % ls app.log nothere.log 2> err.txt
app.log

~/demo/logs % cat err.txt
ls: nothere.log: No such file or directory

~/demo/logs % ls app.log nothere.log > all.txt 2>&1

~/demo/logs % cat all.txt
ls: nothere.log: No such file or directory
app.log

~/demo/logs % ls app.log nothere.log 2>&1 > all.txt
ls: nothere.log: No such file or directory

~/demo/logs % cat all.txt
app.log
| 이렇게 쓰면 | 표준 출력 | 표준 에러 |
|---|---|---|
cmd > f |
파일 f (먼저 비움) | 화면 |
cmd >> f |
파일 f 끝에 덧붙임 | 화면 |
cmd 2> e |
화면 | 파일 e |
cmd > f 2>&1 |
파일 f | 파일 f |
cmd 2>&1 > f |
파일 f | 화면 |
cmd 2> /dev/null |
화면 | 버림 |
cmd < f |
(표준 입력을 파일 f 에서 읽음) |
2>&1 은 "2번을, 1번이 지금 가리키는 곳으로 돌려라"라는 뜻입니다. 셸은 리다이렉션을 왼쪽부터 처리하므로 순서가 결과를 바꿉니다. /dev/null 은 써 넣은 것을 모두 버리는 특수 파일입니다. zsh 와 bash 모두 > f 2>&1 를 &> f 로 줄여 쓸 수 있습니다(둘 다 확인).
> 는 실행 전에 파일을 비우고 >> 는 덧붙입니다. echo one > notes.txt, echo two > notes.txt, echo three >> notes.txt 뒤에 cat notes.txt 는 two 와 three 두 줄이었습니다.
파이프: grep, cut, sort, uniq, wc 를 한 단계씩
파이프 | 는 왼쪽 명령의 표준 출력을 오른쪽 명령의 표준 입력에 잇습니다. 중간에 디스크에 쓰지 않고 두 명령이 동시에 돕니다. "모듈별 ERROR 줄 수는?"에 한 단계씩 답해 봅시다.
~/demo/logs % grep ERROR app.log | head -3
2026-11-12 09:00:27 ERROR db user=u251 ms=2376 timeout
2026-11-12 09:00:27 ERROR auth user=u282 ms=2019 timeout
2026-11-12 09:00:37 ERROR search user=u243 ms=2103 connection refused

~/demo/logs % grep -c ERROR app.log
1239

~/demo/logs % grep ERROR app.log | cut -d' ' -f4 | head -3
db
auth
search

~/demo/logs % grep ERROR app.log | cut -d' ' -f4 | sort | uniq -c | sort -rn
 352 cart
 349 auth
 317 db
 122 search
  99 payment
grep 은 패턴이 들어 있는 줄만 남기고(-c 면 개수만), cut -d' ' -f4 는 공백으로 나눈 네 번째 칸(모듈)을 꺼내고, sort 는 같은 줄을 모으고, uniq -c 는 연속된 같은 줄을 합쳐 세고, sort -rn 은 개수 순으로 줄 세웁니다(-n 숫자, -r 역순). 중간 결과를 저장하면서 계속 흘려보내려면 tee 를 씁니다. grep ERROR app.log | tee errors.txt | wc -l 은 1239 를 출력하고 errors.txt 에도 같은 1,239줄이 남습니다.
자주 하는 실수: 에러 없이 숫자가 틀리는 다섯 가지
1. sort 없는 uniq. uniq 는 붙어 있는 중복만 합칩니다.
~/demo/logs % grep ERROR app.log | cut -d' ' -f4 | uniq -c | head -4
   1 db
   1 auth
   2 search
   1 cart
에러는 없고 숫자만 틀렸습니다. 해결: 언제나 sort | uniq -c.
2. 칸을 맞춘 열에 cut. 다섯 글자로 맞춘 레벨을 떠올려 보세요. INFO 뒤에는 공백이 두 개이고, cut -d' ' 는 공백 하나하나를 구분자로 보기 때문에 네 번째 칸이 비어 버립니다.
~/demo/logs % cut -d' ' -f4 app.log | sort | uniq -c
18346
 423 auth
 445 cart
 402 db
 176 payment
 208 search
INFO 와 WARN 18,346줄이 빈칸이 됐습니다. 아까 잘 된 건 ERROR 가 딱 다섯 글자였기 때문일 뿐입니다. 해결은 tr -s ' ' 로 연속 공백을 하나로 줄인 뒤 cut 하거나, 공백 덩어리로 나누는 awk 를 쓰는 것입니다.
~/demo/logs % tr -s ' ' < app.log | cut -d' ' -f4 | sort | uniq -c
4083 auth
4126 cart
3998 db
3945 payment
3848 search
(awk '{print $4}' app.log | sort | uniq -c 도 같은 숫자였습니다.)
3. 숫자가 아니라 글자로 정렬. "가장 느린 요청은?"
~/demo/logs % grep -o 'ms=[0-9]*' app.log | cut -d= -f2 | sort | tail -3
99
996
997

~/demo/logs % grep -o 'ms=[0-9]*' app.log | cut -d= -f2 | sort -n | tail -3
2802
2911
2936
sort 는 글자를 비교하므로 997 이 2936 뒤로 갑니다. -n 을 주면 숫자로 비교합니다(grep -o 는 줄에서 맞는 부분만 출력합니다).
4. 파일을 자기 자신으로 리다이렉트.
~/demo/logs % printf 'cart\nauth\ndb\n' > modules.txt

~/demo/logs % sort modules.txt > modules.txt

~/demo/logs % wc -c modules.txt
       0 modules.txt
셸은 sort 가 읽기 시작하기 전에 modules.txt 를 쓰기용으로 열면서 비웁니다. 데이터는 사라졌습니다. 해결: sort -o modules.txt modules.txt(sort 는 다 읽은 뒤에 씀) 또는 새 파일에 쓰고 mv 로 되돌리기. 덮어쓰기 자체를 막을 수도 있습니다.
~/demo/logs % set -o noclobber

~/demo/logs % echo oops > modules.txt
zsh: file exists: modules.txt

~/demo/logs % echo ok >| modules.txt
bash 에서는 bash: modules.txt: cannot overwrite existing file 이 나옵니다. >| 로 강제로 덮어쓰는 건 둘 다 같습니다.
5. 파이프라인 뒤의 $?. $? 는 직전 명령의 종료 상태이고 0 이 성공입니다. grep 은 찾으면 0, 못 찾으면 1, 에러면 2 를 돌려줍니다.
~/demo/logs % grep -c CRITICAL app.log
0

~/demo/logs % echo $?
1

~/demo/logs % grep ERROR missing.log
grep: missing.log: No such file or directory

~/demo/logs % echo $?
2

~/demo/logs % grep CRITICAL app.log | wc -l; echo $pipestatus
       0
1 0
파이프라인 뒤의 $? 는 마지막 명령(성공한 wc)의 것입니다. zsh 는 모든 단계의 상태를 $pipestatus 에, bash 는 ${PIPESTATUS[@]} 에 남깁니다. 스크립트가 이를 알아차리게 하는 set -o pipefail 은 강좌 4에서 다룹니다.
zsh 와 bash 의 차이: MULTIOS
macOS 에서는 터미널의 zsh 와 많은 스크립트가 쓰는 bash 를 오가게 됩니다. 리다이렉션에서 차이가 드러나는 예입니다.
~/demo/logs % echo hello > a.txt > b.txt

~/demo/logs % cat a.txt b.txt
hello
hello
zsh 에는 기본으로 켜진 MULTIOS 옵션이 있어서 두 파일 모두에 씁니다. bash 3.2 에서 같은 줄을 실행하면 a.txt 는 비어 있고 hello 는 b.txt 에만 들어갔습니다. 어느 쪽에도 기대지 말고, 두 곳에 남기고 싶으면 tee 를 쓰세요.
실측: 파이프라인 한 줄 vs 셸 루프
파이썬을 먼저 배운 사람은 파일을 한 줄씩 읽는 루프부터 짜기 쉽습니다. 모듈별 ERROR 수를 네 가지 방법으로 세고, 2만 줄과 20만 줄(python3 gen_log.py 200000 > big.log)에서 각각 다섯 번씩 쟀습니다.
# pipe.sh
grep ERROR "$1" | cut -d' ' -f4 | sort | uniq -c

# awk.sh
awk '$3 == "ERROR" { n[$4]++ } END { for (m in n) print n[m], m }' "$1" | sort -k2

# loop_builtin.sh (bash 와 zsh -f 로 각각 실행)
while read -r d t lv mod rest; do
  if [ "$lv" = ERROR ]; then echo "$mod"; fi
done < "$1" | sort | uniq -c
네 방법 모두 같은 개수를 냈습니다. 중앙값(밀리초):
| 방법 | 2만 줄 | 20만 줄 |
|---|---|---|
파이프라인: grep→cut→sort→uniq -c |
10 | 33 |
awk 하나 |
36 | 286 |
bash 3.2 while read 루프 |
136 | 1,412 |
zsh 5.9 while read 루프 |
698 | 7,112 |
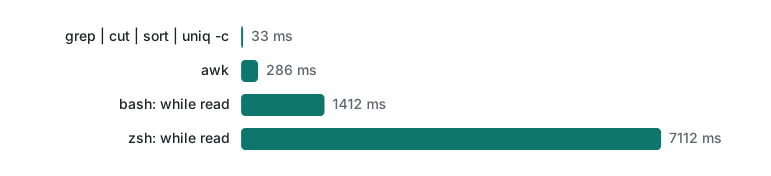
파이프라인이 빠른 건 grep 이 컴파일된 코드로 94% 의 줄을 먼저 버려서 뒤 단계에는 거의 아무것도 가지 않기 때문입니다. zsh 루프는 bash 루프보다 약 5배 느렸습니다. 프로파일링은 하지 않았지만, 그럴듯한 이유를 뒷받침하는 실험이 하나 있습니다. bash 는 일반 파일이면 블록 단위로 읽을 수 있지만 파이프에서는 한 바이트씩 읽어야 합니다. 같은 bash 루프에 cat app.log | 로 넣었더니 중앙값이 136 ms 에서 668 ms(3회)로 늘어 zsh 의 698 ms 와 비슷해졌습니다.
가장 느린 건 처음에 가장 흔히 짜는 버전, 즉 줄마다 cut 을 부르는 루프(lv=$(echo "$line" | cut -d' ' -f3))입니다. 프로세스를 수만 번 띄웁니다. 2만 줄에 73.3초가 걸렸습니다(한 번만 쟀고, 같은 컴퓨터에서 다른 작업도 돌고 있었습니다). 답은 같은데 파이프라인보다 약 7,000배 느립니다.
어떤 질문에 어떤 도구를
| 알고 싶은 것 | 도구 |
|---|---|
| X 가 들어 있는 줄 | grep X (-v 반대, -i 대소문자 무시) |
| X 가 들어 있는 줄 수 | grep -c X |
| 맞는 부분만 | grep -o 'ms=[0-9]*' |
| N 번째 칸 (구분자 한 글자) | cut -d, -fN |
| N 번째 칸 (공백 여러 개로 구분) | awk '{print $N}' |
| 값별 개수 | sort → uniq -c → sort -rn |
| 상위 10개 | 마지막에 head 로 파이프 |
| 중간 결과 저장 후 계속 | tee file |
솔직한 한계와 버전 메모
- macOS 26.6, zsh 5.9, bash 3.2.57 에서만 확인했습니다. BSD
wc는 숫자 앞을 공백으로 채웁니다(20000 app.log). 리눅스 GNUwc는 채우지 않고20000 app.log로 출력합니다(여기서는 실행 안 함). 스크립트에서 문자열로 비교하면 깨지므로wc -l < file결과를 숫자로 다루세요. uniq -c칸 너비도 BSD 와 GNU 가 다릅니다(여기서는 실행 안 함).cut말고awk로 읽으세요.grep -P(펄 호환 정규식)는 GNU 옵션이라 macOS grep 은grep: invalid option -- P로 거부합니다(강좌 3에서 실행). 정규식 문법 자체는 정규 표현식이란?을 보세요.- 시간은 Apple Silicon Mac(M1 Pro) 한 대에서, 따로 적지 않은 한 5회 중앙값이며 다른 작업도 돌고 있었습니다. 비율은 안정적이지만 절대값은 환경마다 다릅니다.
연습 문제
- WARN 줄을 모듈별로 많은 순서대로 세세요. (WARN 은 네 글자입니다.)
- ERROR 줄이 가장 많은 사용자 세 명은?
grep ERROR app.log missing.log의 결과는errors.txt로, 문제는problems.txt로 나눠 보내세요.errors.txt에서 어떤 의외의 모습이 보이나요?
정답
- 실수 2 와 같은 이유로
cut -d' '는 실패하고awk는 됩니다.
~/demo/logs % grep ' WARN ' app.log | cut -d' ' -f4 | sort | uniq -c
2510

~/demo/logs % grep ' WARN ' app.log | awk '{print $4}' | sort | uniq -c | sort -rn
 534 payment
 524 search
 503 auth
 481 cart
 468 db
grep -o로 사용자만 뽑아서 셉니다.
~/demo/logs % grep ERROR app.log | grep -o 'user=u[0-9]*' | sort | uniq -c | sort -rn | head -3
  12 user=u182
  11 user=u248
  11 user=u078
- 파일이 두 개면
grep은 맞는 줄 앞에 파일 이름을 붙입니다.
~/demo/logs % grep ERROR app.log missing.log > errors.txt 2> problems.txt

~/demo/logs % head -1 errors.txt
app.log:2026-11-12 09:00:27 ERROR db user=u251 ms=2376 timeout

~/demo/logs % cat problems.txt
grep: missing.log: No such file or directory
파일 이름을 빼려면 -h 를 붙입니다.
이전 강좌: 강좌 1: 경로와 파일. 다음 강좌: 강좌 3: find·xargs·sed·awk. 폴더 전체를 뒤지고 텍스트를 그 자리에서 고칩니다. 학습 로드맵으로 돌아가기.
자주 묻는 질문
> file 2>&1 과 2>&1 > file 은 무엇이 다른가요?
리다이렉션은 왼쪽부터 차례로 적용됩니다. > file 2>&1 은 표준 출력을 먼저 파일로 돌린 뒤 표준 에러를 같은 곳으로 보내므로 둘 다 파일에 들어갑니다. 2>&1 > file 은 표준 에러를 '그 순간의 표준 출력 = 화면'으로 돌린 다음 표준 출력만 옮기므로 에러는 계속 화면에 나옵니다.
uniq -c 개수가 이상하게 나오는 이유는?
uniq 는 서로 붙어 있는 같은 줄만 합칩니다. 정렬하지 않은 입력에서는 같은 모듈이 작은 덩어리마다 따로 세어졌습니다. 항상 sort | uniq -c 순서로 쓰고, 순위는 sort -rn 으로 매깁니다.
sort file > file 을 했더니 파일이 비었습니다. 왜죠?
셸은 sort 를 실행하기 전에 출력 파일을 열면서 내용을 비웁니다. 그래서 sort 는 이미 빈 파일을 읽습니다. sort -o file file 을 쓰거나, 임시 파일에 쓴 뒤 mv 로 되돌리세요.