Rendimiento en C, Makefiles y lldb: medido en macOS
Curso de C 6: filas vs columnas (54x), arreglo de structs vs struct de arreglos, Makefile con dependencias de headers y un crash rastreado con lldb.
Serie: curso de C 6/6 (avanzado). Esta clase es para ti si ya escribes C correcto y ahora necesitas que sea rápido, que compile como un proyecto de varios archivos y que se pueda depurar cuando truena frente a otra persona: tu líder técnico, un cliente que te contrató como freelancer o el profesor que revisa tu proyecto final. Al terminar vas a poder predecir cuál de dos bucles equivalentes es más rápido y medirlo, escribir un Makefile que recompile los archivos correctos y sacar un backtrace y las variables locales de un crash con lldb.
Dos bucles pueden calcular la misma suma y diferir por un factor de 50. Un proyecto puede compilar "con éxito" a partir de archivos objeto viejos e imprimir disparates. Un reporte de crash puede decir Segmentation fault: 11 y nada más. Son tres problemas cotidianos al trabajar con C, y esta última clase de la serie cubre los tres con programas que ejecutamos: los números están medidos, los mensajes de error están copiados y las sesiones de lldb son reales.
Entorno: Apple clang 21.0.0, GNU Make 3.81 (la versión que trae macOS), lldb-2103, Mac con Apple Silicon (M1 Pro), macOS. Los tiempos usan clock_gettime(CLOCK_MONOTONIC) y reportan el mejor de 5 repeticiones dentro de una ejecución; repetimos la ejecución completa cuatro veces y citamos la última. Las rutas se acortaron a ~/demo/…. Volver a la hoja de ruta para aprender a programar.
Por qué importa el orden en memoria: las líneas de caché en un párrafo
Un núcleo de CPU no lee bytes sueltos de la RAM. Lee líneas de caché completas (64 bytes en la mayoría de los chips x86-64; esta M1 Pro reporta hw.cachelinesize: 128 en sysctl) hacia cachés pequeñas y rápidas, y hace prefetch de las líneas siguientes cuando ve que avanzas hacia adelante. Por eso leer memoria en orden de direcciones sale casi gratis después del primer acceso; saltar de un lado a otro cuesta un viaje a un nivel más lento cada vez. C hace esto visible porque un arreglo 2D m[i][j] se guarda fila por fila: m[i][j] y m[i][j+1] son vecinos, m[i][j] y m[i+1][j] están a una fila entera de distancia.
Medido: filas vs columnas, 54 veces de diferencia
static int64_t sum_rows(const int *m) {            /* m[i][j], j inner: sequential */
    int64_t s = 0;
    for (int i = 0; i < N; i++) for (int j = 0; j < N; j++) s += m[(size_t)i * N + j];
    return s;
}
static int64_t sum_cols(const int *m) {            /* m[i][j], i inner: jumps 16 KiB */
    int64_t s = 0;
    for (int j = 0; j < N; j++) for (int i = 0; i < N; i++) s += m[(size_t)i * N + j];
    return s;
}
Con N = 4096 la matriz guarda 16.8 millones de int, 64 MiB, más que cualquier caché del chip. Las dos funciones suman los mismos números en distinto orden:
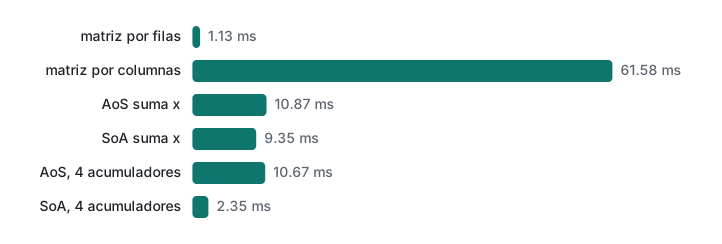
rows (i outer)             1.13 ms  (result 8583959407)
columns (j outer)         61.58 ms  (result 8583959407)
Mismo resultado, 54 veces el tiempo. El bucle por filas lee 64 MiB a unos 59 GB/s y clang lo vectoriza (suma varios int por instrucción). El bucle por columnas avanza 4096 × 4 = 16 KiB en cada acceso, así que cada línea de caché entrega un solo int útil y se desaloja antes de que se necesiten sus vecinos. En cuatro ejecuciones completas el tiempo por filas quedó entre 1.13 y 1.48 ms, y el tiempo por columnas entre 60.5 y 63.0 ms.
Error típico: traducir literalmente a bucles anidados una fórmula escrita como "para cada columna j, para cada fila i", como harías en Fortran o MATLAB (que guardan columna por columna). Lo que realmente pasa: el código es correcto y, sin avisar, 50 veces más lento. Solución: haz que el último índice sea el bucle más interno, o transpone los datos una vez si recorrer columnas es la parte crítica.
Arreglo de structs vs struct de arreglos
La misma idea aplica a los registros. Aquí hay 10 millones de partículas guardadas de dos maneras:
struct Particle { double x, y, z, vx, vy, vz, mass; int64_t id; };    /* 64 bytes */
struct Particles { double *x, *y, *z, *vx, *vy, *vz, *mass; int64_t *id; };
La primera es un arreglo de structs (AoS, array of structs): en memoria, a p[i].x le sigue p[i].y y luego el resto de la partícula i. La segunda es un struct de arreglos (SoA, struct of arrays): todos los valores de x están contiguos. Sumando solo x:
AoS sum of x              10.87 ms  (result 4995000000)
SoA sum of x               9.35 ms  (result 4995000000)
AoS sum of x, 4 acc       10.67 ms  (result 4995000000)
SoA sum of x, 4 acc        2.35 ms  (result 4995000000)
Las dos primeras líneas son la sorpresa honesta: SoA fue solo 14% más rápido. Los dos bucles simples estaban limitados por algo distinto de la memoria. Una suma de double s += … es una cadena: cada suma tiene que esperar a la anterior (la suma en coma flotante tarda varios ciclos), y el compilador no puede reordenarla, porque la suma en coma flotante no es asociativa y reordenar podría cambiar el resultado. Así que ambos bucles corrieron a "una suma por cada latencia de suma".
Romper la cadena en cuatro sumas independientes (s0 += x[i]; s1 += x[i+1]; …) quita ese límite, y ahora la que decide es la memoria: SoA bajó a 2.35 ms, mientras que AoS se quedó en 10.67 ms porque sigue arrastrando una partícula completa de 64 bytes por la caché por cada 8 bytes que usa (640 MB por pasada contra 80 MB). La disposición de los datos solo rinde cuando el bucle ya es lo bastante rápido para estar esperando a la memoria. Mide antes de reestructurar una base de código a SoA. (Aquí los valores son números enteros, así que la suma en cuatro partes da exactamente el mismo resultado; con doubles arbitrarios los últimos bits pueden variar.)
El benchmark completo, en un archivo:
/* cache.c: same work, different memory order.
   clang -std=c17 -O2 cache.c -o cache && ./cache */
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <time.h>

enum { N = 4096, REPS = 5, P = 10000000 };

static double now_ms(void) {
    struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t);
    return t.tv_sec * 1e3 + t.tv_nsec / 1e6;
}
static int64_t sum_rows(const int *m) {
    int64_t s = 0;
    for (int i = 0; i < N; i++) for (int j = 0; j < N; j++) s += m[(size_t)i * N + j];
    return s;
}
static int64_t sum_cols(const int *m) {
    int64_t s = 0;
    for (int j = 0; j < N; j++) for (int i = 0; i < N; i++) s += m[(size_t)i * N + j];
    return s;
}
struct Particle { double x, y, z, vx, vy, vz, mass; int64_t id; };    /* 64 bytes */
struct Particles { double *x, *y, *z, *vx, *vy, *vz, *mass; int64_t *id; };

static double sum_x_aos(const struct Particle *p) { double s = 0; for (int i = 0; i < P; i++) s += p[i].x; return s; }
static double sum_x_soa(const struct Particles *p) { double s = 0; for (int i = 0; i < P; i++) s += p->x[i]; return s; }
static double sum_x_aos4(const struct Particle *p) {
    double s0 = 0, s1 = 0, s2 = 0, s3 = 0;
    for (int i = 0; i < P; i += 4) { s0 += p[i].x; s1 += p[i+1].x; s2 += p[i+2].x; s3 += p[i+3].x; }
    return (s0 + s1) + (s2 + s3);
}
static double sum_x_soa4(const struct Particles *p) {
    double s0 = 0, s1 = 0, s2 = 0, s3 = 0;
    for (int i = 0; i < P; i += 4) { s0 += p->x[i]; s1 += p->x[i+1]; s2 += p->x[i+2]; s3 += p->x[i+3]; }
    return (s0 + s1) + (s2 + s3);
}

#define BEST(label, T, expr) do { double best = 1e30; T r = 0;                     \
    for (int k = 0; k < REPS; k++) { double t0 = now_ms(); r = (expr);            \
        double dt = now_ms() - t0; if (dt < best) best = dt; }                    \
    printf("%-22s %8.2f ms  (result %.0f)\n", label, best, (double)r); } while (0)

int main(void) {
    int *m = malloc((size_t)N * N * sizeof *m);    /* 64 MiB */
    uint32_t x = 42;                               /* fixed seed, xorshift32 */
    for (size_t i = 0; i < (size_t)N * N; i++) { x ^= x << 13; x ^= x >> 17; x ^= x << 5; m[i] = (int)(x & 1023); }
    BEST("rows (i outer)", int64_t, sum_rows(m));
    BEST("columns (j outer)", int64_t, sum_cols(m));
    free(m);

    struct Particle *aos = malloc(P * sizeof *aos);
    struct Particles soa;
    double **cols[] = { &soa.x, &soa.y, &soa.z, &soa.vx, &soa.vy, &soa.vz, &soa.mass };
    for (int c = 0; c < 7; c++) *cols[c] = malloc(P * sizeof(double));
    soa.id = malloc(P * sizeof(int64_t));
    for (int i = 0; i < P; i++) {
        double v = (double)(i % 1000);
        aos[i] = (struct Particle){ v, v, v, v, v, v, 1.0, i };
        for (int c = 0; c < 7; c++) (*cols[c])[i] = v;
        soa.id[i] = i;
    }
    BEST("AoS sum of x", double, sum_x_aos(aos));
    BEST("SoA sum of x", double, sum_x_soa(&soa));
    BEST("AoS sum of x, 4 acc", double, sum_x_aos4(aos));
    BEST("SoA sum of x, 4 acc", double, sum_x_soa4(&soa));
    return 0;
}
Compila sin warnings con -Wall -Wextra -Wpedantic. Reserva en total cerca de 1.3 GB; reduce P si tu máquina es pequeña.
Un Makefile que recompila los archivos correctos
Cuando un programa tiene varios archivos .c, recompilar todo a mano es lento y propenso a errores. make lee un Makefile con reglas, "target: prerrequisitos, y luego los comandos (la receta) para construir el target", y reconstruye un target solo cuando algún prerrequisito es más nuevo. Nuestro proyecto de tres archivos (main.c, stats.c, parse.c, más stats.h):
CC      = clang
CFLAGS  = -std=c17 -Wall -Wextra -O2 -g -MMD -MP
OBJS    = main.o stats.o parse.o

app: $(OBJS)
    $(CC) $(CFLAGS) -o $@ $(OBJS)

%.o: %.c
    $(CC) $(CFLAGS) -c $< -o $@

-include $(OBJS:.o=.d)

.PHONY: clean
clean:
    rm -f app $(OBJS) $(OBJS:.o=.d)
$@ es el target, $< el primer prerrequisito y %.o: %.c una regla de patrón para cada objeto. La parte importante es -MMD -MP: mientras compila, clang también escribe un archivo main.d con cada header que incluyó main.c, y -include mete esas listas en el Makefile. El archivo generado:
main.o: \
  …/MacOSX.sdk/SDKSettings.json \
  main.c stats.h
…/MacOSX.sdk/SDKSettings.json:
stats.h:
(Que el SDKSettings.json del SDK aparezca como dependencia es un detalle de Apple clang; significa que una actualización de Xcode provoca una recompilación, que es lo que quieres.) Primer build, luego uno que no hace nada y luego otro después de editar el header:
$ make
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -c main.c -o main.o
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -c stats.c -o stats.o
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -c parse.c -o parse.o
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -o app main.o stats.o parse.o
$ ./app
count=3 mean=3.000
$ make
make: `app' is up to date.
$ touch parse.c && make
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -c parse.c -o parse.o
clang -std=c17 -Wall -Wextra -O2 -g -MMD -MP -o app main.o stats.o parse.o
Solo se ejecutaron parse.o y el enlazado. make -j4 corre en paralelo las compilaciones independientes.
Tres trampas de Makefile, reproducidas
Trampa 1: espacios en vez de un TAB. Una línea de receta tiene que empezar con un TAB literal. Muchos editores insertan espacios. GNU Make 3.81 dice:
Makefile.spaces:6: *** missing separator. Stop.
La línea 6 es la primera línea de receta. cat -t Makefile muestra un tab real como ^I; si ves espacios, ese es el bug. Configura tu editor para conservar los tabs en archivos llamados Makefile.
Trampa 2: sin dependencias de headers. Esta es la peligrosa, porque nada falla. Toma el mismo Makefile sin -MMD -MP ni -include. Compila y luego agrega un campo al principio del struct en stats.h:
struct stats { const char *label; long count; double sum; }; /* was: { long count; double sum; } */
$ make -f Makefile.naive
make: `app' is up to date.
Make no sabe que stats.h importa, así que no recompila nada. Ahora edita main.c (nosotros solo le hicimos touch), que es lo que harías a continuación:
$ make -f Makefile.naive
clang -std=c17 -Wall -Wextra -O2 -g -c main.c -o main.o
clang -std=c17 -Wall -Wextra -O2 -g -o app main.o stats.o parse.o
$ ./app
count=4621256167635550208 mean=3.000
exit=0
main.o ahora usa la disposición nueva y stats.o la vieja. stats_add (disposición vieja) escribió count en el offset 0 y sum en el offset 8; main (disposición nueva) leyó count del offset 8, que contiene los bits del double 9.0 (1.5 + 2.5 + 5.0): 0x4022000000000000 = 4621256167635550208. Sin warning, sin crash, salida 0. Después de make clean && make con el Makefile que rastrea dependencias, la salida volvió a ser count=3 mean=3.000. Es un bug del sistema de build que se ve exactamente como corrupción de memoria, y el momento de sospecharlo es cuando "el bug desapareció después de un build limpio".
Trampa 3: ediciones dentro del mismo segundo. Compilamos y de inmediato le hicimos touch a parse.c:
make: `app' is up to date.
parse.c 1794494800.980412000
parse.o 1794494800.929907233
parse.c era 0.05 s más nuevo que parse.o, pero Make 3.81 tal como viene comparó segundos enteros y los vio iguales. Un segundo después, touch parse.c && make lo recompiló. Editando a mano no te va a pasar, pero sí puede pasar en scripts que generan un archivo y corren make de inmediato, o en pasos rápidos de CI. GNU Make puede comparar timestamps con fracciones de segundo cuando se compila con soporte para eso; por lo visto, el binario 3.81 que viene aquí no lo tenía (no probamos otros builds).
Depurar un crash con lldb
Un programa pequeño lee configuraciones de una tabla; una de las entradas no tiene valor:
#include <stdio.h>
#include <string.h>

struct entry { const char *key; const char *value; };

static const struct entry table[] = {
    { "host", "example.com" }, { "port", "8080" }, { "mode", NULL },  /* mode has no value */
};

static const char *lookup(const char *key) {
    for (size_t i = 0; i < sizeof table / sizeof table[0]; i++)
        if (strcmp(table[i].key, key) == 0) return table[i].value;
    return NULL;
}

static size_t value_len(const char *key) {
    const char *v = lookup(key);
    return strlen(v);                     /* crashes when v is NULL */
}

int main(void) {
    const char *keys[] = { "host", "port", "mode" };
    for (int i = 0; i < 3; i++)
        printf("%s -> %zu chars\n", keys[i], value_len(keys[i]));
    return 0;
}
Sin ayuda, todo lo que obtienes es esto (y cuando la salida va por un pipe, ni siquiera las dos primeras líneas):
bash: line 1: 77904 Segmentation fault: 11  ./crash
exit=139
El código de salida 139 es 128 + 11: señal 11, SIGSEGV. Compila con -O0 -g (información de depuración, sin optimización) y ejecútalo dentro de lldb. -b es modo batch, -o ejecuta un comando y -k ejecuta un comando solo si el proceso truena:
clang -std=c17 -Wall -Wextra -O0 -g crash.c -o crash
lldb -b -o run -k bt -k "frame select 1" -k "frame variable" -k "frame select 2" -k "frame variable" -k kill ./crash < /dev/null
(lldb) run
host -> 11 chars
port -> 4 chars
Process 78194 stopped
* thread #1, queue = 'com.apple.main-thread', stop reason = EXC_BAD_ACCESS (code=1, address=0x0)
    frame #0: 0x0000000188df6ac4 libsystem_platform.dylib`_platform_strlen + 4
(lldb) bt
* thread #1, queue = 'com.apple.main-thread', stop reason = EXC_BAD_ACCESS (code=1, address=0x0)
  * frame #0: 0x0000000188df6ac4 libsystem_platform.dylib`_platform_strlen + 4
    frame #1: 0x00000001000005a0 crash`value_len(key="mode") at crash.c:18:12
    frame #2: 0x000000010000051c crash`main at crash.c:24:46
    frame #3: 0x0000000188a244e4 dyld`start + 6992
(lldb) frame select 1
frame #1: 0x00000001000005a0 crash`value_len(key="mode") at crash.c:18:12
-> 18       return strlen(v);                     /* crashes when v is NULL */
(lldb) frame variable
(const char *) key = 0x000000010000067a "mode"
(const char *) v = 0x0000000000000000
(lldb) frame select 2
(lldb) frame variable
(const char *[3]) keys = ([0] = "host", [1] = "port", [2] = "mode")
(int) i = 2
Léelo en orden: EXC_BAD_ACCESS (code=1, address=0x0) significa una lectura en la dirección 0, o sea, un puntero NULL. El frame 0 está dentro de la librería de C (strlen), que nunca es donde está el bug. El frame 1 es nuestro código: value_len con key="mode", y frame variable muestra v = 0x0. El frame 2 dice que fue la tercera vuelta del bucle (i = 2). Diagnóstico en una sola pantalla, sin agregar ningún printf. (Una nota sobre el modo batch: nuestro primer intento, con -k up y stdin abierto, nunca regresó y hubo que matarlo. Cerrar stdin con < /dev/null y terminar con -k kill hizo que todas las ejecuciones siguientes salieran limpias.)
Con -O2 -g la misma sesión ayuda menos:
    frame #1: 0x00000001000004b0 crash2`value_len(key=<unavailable>) at crash.c:18:12 [opt] [inlined]
warning: crash2 was compiled with optimization - stepping may behave oddly; variables may not be available.
(lldb) frame variable
(const char *) key = <no location, value may have been optimized out>
(const char *) v = 0x0000000000000000
[opt] [inlined]: la función se fusionó dentro de main y key ya no existe en ningún registro. Depura con -O0 cuando puedas; publica con -O2 -g para que los reportes de crash de los usuarios sigan teniendo números de línea.
Un breakpoint condicional se detiene antes del crash, solo en el caso malo:
(lldb) breakpoint set -f crash.c -l 18 -c 'v == 0'
Breakpoint 1: where = crash`value_len + 28 at crash.c:18:19, address = 0x0000000100000598
(lldb) run
host -> 11 chars
port -> 4 chars
* thread #1, queue = 'com.apple.main-thread', stop reason = breakpoint 1.1
    frame #0: 0x0000000100000598 crash`value_len(key="mode") at crash.c:18:19
(lldb) frame variable
(const char *) key = 0x000000010000067a "mode"
(const char *) v = 0x0000000000000000
Para comparar, -fsanitize=address convierte el mismo crash en un reporte sin necesidad de depurador: ERROR: AddressSanitizer: SEGV on unknown address 0x000000000000 … Hint: address points to the zero page. seguido de #1 … in value_len crash.c:18 y #2 … in main crash.c:24.
Tabla de decisión: qué herramienta para qué síntoma
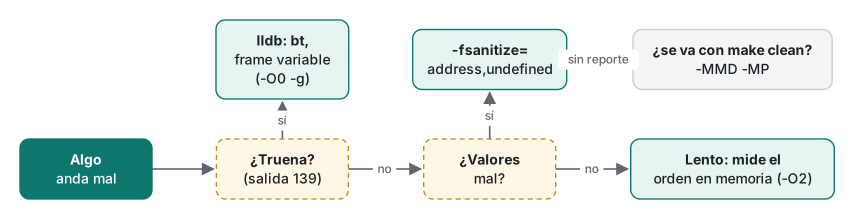
| Síntoma | Herramienta | Qué mirar |
|---|---|---|
| Bucle sobre arreglos correcto pero lento | mide dos órdenes de bucle; -O2 |
el bucle más interno debe recorrer direcciones consecutivas |
| Bucle lento sobre muchos structs, usando un solo campo | prueba SoA y acumuladores independientes | ¿el bucle está limitado por memoria o por latencia? |
Segmentation fault: 11 / salida 139 |
lldb -b -o run -k bt -k "frame variable", compilado con -O0 -g |
el primer frame que sea código tuyo |
| Valores corruptos, sin crash | -fsanitize=address,undefined (clases 3–5) |
el primer reporte, no el último |
El bug desaparece después de make clean |
dependencias de headers (-MMD -MP) |
¿existen los archivos .d y se incluyen? |
*** missing separator. Stop. |
cat -t Makefile |
las líneas de receta deben empezar con ^I |
Límites honestos y notas de versión
- Todos los tiempos: una sola Mac con Apple Silicon (M1 Pro), Apple clang 21.0.0
-O2, mejor de 5 dentro de una ejecución, cuatro ejecuciones. Los números absolutos dependen del sistema de memoria; la proporción de 54x sería distinta en otra CPU, la dirección no. - El tamaño de línea de caché de la primera sección es conocimiento general, no algo que hayamos medido aquí; solo medimos tiempos de bucles completos.
- GNU Make 3.81 es de 2006; macOS todavía lo trae. GNU Make actual (4.x) agrega funciones como
.RECIPEPREFIX(para usar algo distinto de TAB) y la pista "did you mean TAB instead of 8 spaces?". No lo instalamos ni lo ejecutamos. -MMD -MPson flags de GCC/clang, no forman parte de make. GDB no está disponible en esta Mac; los comandos de lldb equivalen abt,frame Neinfo localsde GDB (no lo ejecutamos aquí).- La salida de lldb se recortó (se quitaron las líneas de desensamblado después de la parada) y se acortaron las rutas. Los PID y las direcciones son de nuestras ejecuciones y en las tuyas van a ser distintos.
Ejercicios
- El filtro de imágenes de un colega recorre
for (x = 0; x < W; x++) for (y = 0; y < H; y++) out[y][x] = f(in[y][x]);sobrefloat in[H][W]. ¿Qué cambias, y cómo demuestras que sirvió? - Sin
-MMD, ¿cuál es el cambio más pequeño aMakefile.naivepara que los tres objetos se recompilen cuando cambiestats.h?
Respuestas
- Intercambia los bucles para que
x(el último índice) sea el más interno:for (y…) for (x…). Demuéstralo midiendo ambas versiones con la misma entrada de semilla fija y un arnés de "mejor de N" comocache.c, en-O2, y verificando que la salida (o un checksum de ella) sea idéntica. - Agrega una línea:
$(OBJS): stats.h. Lo probamos con Make 3.81: después detouch stats.h,makerecompilómain.o,stats.oyparse.oy volvió a enlazar. La desventaja es que tienes que mantener esa lista a mano, y por eso-MMD -MPes mejor.
Lo que sigue
Aquí termina la serie de C. Para aplicar estas herramientas a estructuras de datos reales, prueba el artículo de algoritmos de ordenamiento (en inglés), o vuelve a la clase 1 para compartir la serie con alguien que recién empieza.
Anterior: Clase 5: comportamiento indefinido y el optimizador · Siguiente: la hoja de ruta para aprender a programar, para ver hacia dónde ir después de C
Preguntas frecuentes
¿Por qué recorrer una matriz por columnas es tan lento en C?
C guarda los arreglos 2D fila por fila. Recorrer una fila lee bytes consecutivos, así que cada línea de caché que llega se aprovecha completa y el bucle se vectoriza. Recorrer una columna salta 16 KiB por paso en una matriz de int de 4096x4096, así que casi cada acceso necesita una línea nueva. Medimos 1.13 ms por filas y 61.58 ms por columnas con los mismos datos, unas 54 veces más lento.
¿Qué significa el error 'Makefile: *** missing separator. Stop.'?
Una línea de receta (el comando debajo de un target) tiene que empezar con un carácter TAB, y la tuya empieza con espacios, normalmente porque el editor convirtió el tab. GNU Make 3.81, la versión que trae macOS, imprime exactamente 'Makefile.spaces:6: *** missing separator. Stop.' con el número de línea. Reemplaza los espacios iniciales por un TAB; cat -t muestra los tabs como ^I.
¿Cómo veo dónde truena un programa en C sin agregar printf?
Compila con -g (y de preferencia -O0), ejecútalo dentro de lldb y, cuando se detenga, escribe bt para ver la pila de llamadas y frame variable para ver las variables locales del frame seleccionado. En modo batch: lldb -b -o run -k bt -k 'frame variable' ./app. Nuestro crash mostró v = 0x0000000000000000 en value_len(key="mode") en crash.c:18.