Strings, structs y buffer overflows en C con ASan
Curso de C 4: el terminador NUL, trampas de strcpy/strncpy/snprintf, padding de structs (32 vs 16 bytes) y un overflow atrapado de tres formas.
Serie: curso de C 4/6 (intermedio). Esta clase es para ti si ya escribes funciones en C y usas punteros, y ahora te toca manejar texto y registros en código real: un parser para el proyecto de la universidad, un firmware que arma mensajes o un módulo que alguien en tu primer trabajo te pidió revisar. Al terminar vas a poder predecir dónde termina un string en C, elegir con intención entre strcpy, strncpy y snprintf, leer la disposición en memoria de un struct y leer el reporte de AddressSanitizer de un buffer overflow.
Si mantienes una librería en C, parseas un protocolo o revisas un pull request que copia un nombre de usuario a un campo de tamaño fijo, esta clase trata de la familia de bugs que ha causado más avisos de seguridad que cualquier otra en C. Los ejemplos son pequeños a propósito: un byte que falta, una copia sin revisar. Se muestran solo con fines defensivos: el bug, lo que reportan las herramientas y la solución.
Entorno: Apple clang 21.0.0 (clang -std=c17 -Wall -Wextra), Mac con Apple Silicon (M1 Pro), macOS. Cada salida de abajo se copió de una ejecución real; solo se acortaron las rutas. Los builds con sanitizer usan -O0 -g -fsanitize=address. Volver a la hoja de ruta para aprender a programar.
Un string en C es un arreglo más una promesa
C no tiene un tipo string. Un "string" es un arreglo de char cuyo contenido termina con un byte en cero, '\0' (llamado NUL). Cada función de la librería que recibe un char *, como strlen, printf("%s") o strcpy, avanza hasta encontrar ese cero. Nada guarda la longitud; nada guarda el tamaño del arreglo. Ese es todo el diseño, y casi todos los bugs de esta clase salen de ahí.
#include <stdio.h>
#include <string.h>

int main(void) {
    char a[] = "hello";          /* 6 bytes: h e l l o \0 */
    char b[5] = "hello";         /* 5 bytes: no room for \0 (legal in C!) */
    const char *p = "hello";
    printf("sizeof a = %zu, strlen a = %zu\n", sizeof a, strlen(a));
    printf("sizeof p = %zu, strlen p = %zu\n", sizeof p, strlen(p));
    printf("strlen b = %zu\n", strlen(b));   /* reads past the end */
    return 0;
}
clang 21 se da cuenta de la tercera línea:
nul.c:6:17: warning: initializer-string for character array is too long, array size is 5 but
initializer has size 6 (including the null terminating character); did you mean to use the
'nonstring' attribute? [-Wunterminated-string-initialization]
Es solo un warning porque char b[5] = "hello"; es C válido: el estándar permite explícitamente omitir el terminador cuando al arreglo le falta exactamente un byte. El programa corre e imprime:
sizeof a = 6, strlen a = 5
sizeof p = 8, strlen p = 5
strlen b = 13
Tres lecciones en tres líneas. sizeof de un arreglo cuenta el terminador; strlen no. sizeof de un puntero es el tamaño del puntero (8 bytes en una Mac de 64 bits), apunte a lo que apunte. Y strlen(b) devolvió 13 para una palabra de 5 letras, porque siguió leyendo los bytes vecinos del stack hasta que por casualidad encontró un cero. El número 13 no es estable ni significa nada; con otra disposición sería otro número o un crash.
AddressSanitizer (ASan), una opción del compilador que rodea cada objeto con bytes "envenenados" y revisa cada acceso, convierte el 13 silencioso en un reporte:
==73077==ERROR: AddressSanitizer: stack-buffer-overflow on address 0x00016f6063c5 ...
READ of size 6 at 0x00016f6063c5 thread T0
    #0 0x0001012a6800 in strlen+0x22c (libclang_rt.asan_osx_dynamic.dylib:arm64e+0x16800)
    #1 0x0001007f89e4 in main nul.c:10
  This frame has 2 object(s):
    [32, 38) 'a' (line 5)
    [64, 69) 'b' (line 6) <== Memory access at offset 69 overflows this variable
SUMMARY: AddressSanitizer: stack-buffer-overflow nul.c:10 in main
Léelo de abajo hacia arriba: SUMMARY da el tipo de error y la línea, la lista del frame muestra que b ocupa los bytes 64 a 68 del frame, y el acceso en el offset 69 está uno más allá. READ of size 6 es strlen intentando leer las 5 letras más el byte donde debería estar el NUL.
Comparar y modificar strings: dos errores que clang atrapa a medias
Error típico 1: comparar con ==.
char answer[8] = "yes";
if (answer == "yes") puts("== says equal");
else                 puts("== says NOT equal");
if (strcmp(answer, "yes") == 0) puts("strcmp says equal");
mistakes.c:6:16: warning: result of comparison against a string literal is unspecified
(use an explicit string comparison function instead) [-Wstring-compare]
Lo que realmente pasa: == compara dos direcciones, la del arreglo en el stack y la del literal en datos de solo lectura. Nunca son iguales, así que el programa imprimió == says NOT equal y luego strcmp says equal. Solución: siempre strcmp(a, b) == 0 (o strncmp con un límite conocido).
Error típico 2: escribir dentro de un literal de string. char *lit = "hello"; lit[0] = 'J'; compila sin ningún warning con -Wall -Wextra en C (solo es error en C++). En macOS el literal vive en una página de solo lectura:
bash: line 1: 74295 Bus error: 10           ./mistakes
exit=138
Solución: si necesitas modificarlo, conviértelo en arreglo, char s[] = "hello";, que copia el literal al stack. Declara los punteros a literales como const char * para que el compilador detenga la escritura por ti.
Otra trampa se escondía en esta ejecución: cuando redirigimos la salida a un archivo, ./mistakes > out.txt dejó out.txt vacío (0 bytes), aunque las dos líneas de puts se ejecutaron antes del crash. stdout usa buffer por líneas en una terminal pero buffer completo hacia un archivo o un pipe, y un crash descarta el buffer. Cuando un programa que truena "no imprime nada", agrega fflush(stdout) o manda los diagnósticos a stderr, que no tiene buffer.
strcpy, strncpy y snprintf: lo que hace realmente cada uno
Esta es la función de nuestro pull request. Copia un nombre a un campo de 8 bytes:
#include <stdio.h>
#include <string.h>

/* Copies a user name into a fixed 8-byte field. Bug: no length check. */
static void set_name(char *dst, const char *src) {
    strcpy(dst, src);
}

int main(int argc, char **argv) {
    char name[8];
    int  points = 100;
    const char *input = argc > 1 ? argv[1] : "alice";
    set_name(name, input);
    printf("name=%s points=%d\n", name, points);
    return 0;
}
set_name recibe solo un puntero, así que ni ella ni strcpy saben que el destino tiene 8 bytes. Fíjate que 8 caracteres tampoco caben: "abcdefgh" necesita 9 bytes con su NUL.
strncpy(dst, src, n) parece la solución con límite, pero se diseñó para campos de ancho fijo en formatos de archivo antiguos, no para strings de C. Si src tiene n caracteres o más, copia exactamente n y no termina el string:
char b[8];
strncpy(b, "bartholomew", sizeof b);
printf("strncpy: last byte = %d (0 means terminated)\n", b[7]);
strncpy: last byte = 111 (0 means terminated)
111 es 'o'. El buffer ahora es un string sin final, y el siguiente printf("%s", b) es la lectura fuera de límites de la primera sección. clang 21 no dio ningún warning en esta línea.
snprintf(dst, cap, "%s", src) siempre termina el string (cuando cap > 0) y devuelve la longitud que quería escribir. Ese valor de retorno es la gracia: compáralo con la capacidad y sabrás si truncaste.
/* Returns 0 on success, -1 if src did not fit (dst still gets a truncated, terminated copy). */
static int copy_str(char *dst, size_t cap, const char *src) {
    int n = snprintf(dst, cap, "%s", src);
    return (n < 0 || (size_t)n >= cap) ? -1 : 0;
}
snprintf: "barthol" rc=-1
snprintf: "alice" rc=0
snprintf(NULL, 0, ...) says it needs 23 bytes + 1 for NUL
La última línea muestra un segundo uso: snprintf(NULL, 0, fmt, ...) no escribe nada y te dice de qué tamaño hacer un buffer con malloc.
| Función | ¿Conoce la capacidad? | ¿Siempre termina el string? | ¿Te avisa si truncó? | Úsala cuando |
|---|---|---|---|---|
strcpy |
no | sí, si no se desborda | no | nunca con datos de afuera |
strncpy |
sí | no (cuando src ≥ n) | no | campos de ancho fijo que no son strings |
strncat |
solo la cantidad restante | sí | no | rara vez; es fácil equivocarse con el argumento |
snprintf(d, cap, "%s", s) |
sí | sí (cap > 0) | sí, por el valor de retorno | opción por defecto, C99 portable |
strlcpy |
sí | sí | sí, devuelve strlen(src) | macOS/BSD; glibc 2.38+ (no se ejecutó en Linux aquí) |
llevar tú la longitud + memcpy |
sí | lo escribes tú | sí | bucles críticos y builders (ver medición) |
Un overflow, atrapado de tres maneras distintas
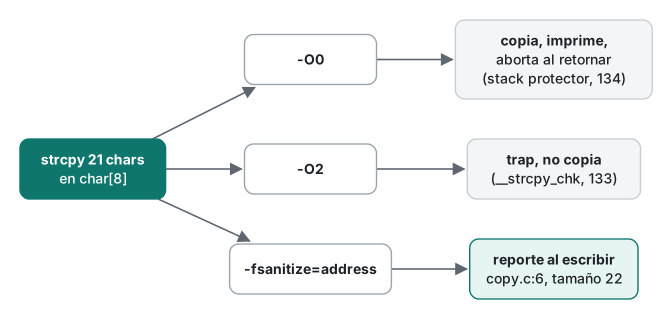
Ejecuta el programa de strcpy con un nombre de 21 caracteres. Lo que ves depende de cómo lo compilaste, y esa es la parte que un resumen deja fuera.
-O0 normal: el programa imprime y después muere.
name=bartholomew_the_third points=100
bash: line 1: 78502 Abort trap: 6           ./copy_O0 bartholomew_the_third
exit=134
(Capturado en una terminal; cuando en cambio mandamos la salida por un pipe, la línea name= se perdió en el buffer de stdout, como arriba.) El overflow ocurrió, los datos corruptos se imprimieron, y solo al salir de main el stack protector se dio cuenta. El compilador coloca un valor aleatorio (el canario) junto a la dirección de retorno y lo revisa antes de retornar. lldb confirma quién jaló el gatillo:
* thread #1, queue = 'com.apple.main-thread', stop reason = signal SIGABRT
    frame #2: 0x0000000188cf5a1c libsystem_c.dylib`__abort + 152
    frame #3: 0x0000000188cf5af4 libsystem_c.dylib`__stack_chk_fail + 96
    frame #4: 0x0000000100000518 copy_O0g`main(argc=2, argv=0x000000016fdfe848) at copy.c:15:5
La línea 15 es return 0;. En un servidor que corre por mucho tiempo, el daño habría vivido hasta que la función retornara, quizá mucho después.
-O2 normal: el programa muere antes de la copia, con otra señal.
bash: line 1: 78507 Trace/BPT trap: 5       ./copy_O2 bartholomew_the_third
exit=133
Los headers de macOS convierten strcpy en __builtin___strcpy_chk(dst, src, size) (esto es _FORTIFY_SOURCE). En -O2 el compilador hace inline de set_name dentro de main, puede ver que name mide 8 bytes y pasa 8; la libc revisa la longitud y se detiene en __chk_fail_overflow. En -O0 la misma llamada recibió "tamaño desconocido", así que la revisión no pudo ayudar. Ambos binarios importan ___strcpy_chk; solo el optimizado conocía el tamaño.
-fsanitize=address: el programa se detiene en la escritura exacta.
==73154==ERROR: AddressSanitizer: stack-buffer-overflow on address 0x00016dade388 ...
WRITE of size 22 at 0x00016dade388 thread T0
    #0 0x000102d82af0 in strcpy+0x458 (libclang_rt.asan_osx_dynamic.dylib:arm64e+0x3aaf0)
    #1 0x000102320a84 in set_name copy.c:6
    #2 0x0001023209a4 in main copy.c:13
  This frame has 1 object(s):
    [32, 40) 'name' (line 10) <== Memory access at offset 40 overflows this variable
SUMMARY: AddressSanitizer: stack-buffer-overflow copy.c:6 in set_name
WRITE of size 22: 21 caracteres más el NUL en 8 bytes, en copy.c:6, llamada desde la línea 13. Código de salida 134 (en macOS ASan aborta). Este es el reporte al que debes apuntar durante el desarrollo y en CI.
La solución es pasarle la capacidad a la función que copia y decidir qué significa truncar:
static int set_name(char *dst, size_t cap, const char *src) {
    int n = snprintf(dst, cap, "%s", src);
    return (n < 0 || (size_t)n >= cap) ? -1 : 0;
}
/* in main: */
if (set_name(name, sizeof name, input) != 0)
    fprintf(stderr, "warning: name truncated to \"%s\"\n", name);
Compilado con -fsanitize=address,undefined y ejecutado con la misma entrada:
warning: name truncated to "barthol"
name=barthol points=100
exit=0
La regla detrás: una función que escribe en un buffer debe recibir el tamaño del buffer. sizeof name funciona solo donde name todavía es un arreglo; dentro de set_name daría 8, el tamaño de un puntero (la clase 2 mostró este decay).
Structs: padding que puedes medir
Un struct agrupa campos, y el compilador los acomoda en el orden en que los declaras, insertando padding para que cada campo empiece en un múltiplo de su alineación (8 para double, 4 para int32_t, 1 para char). offsetof de <stddef.h> muestra el resultado:
#include <stdio.h>
#include <stddef.h>
#include <stdint.h>
#include <stdbool.h>

struct Bad  { char flag; double price; char kind; int32_t qty; bool active; };
struct Good { double price; int32_t qty; char flag; char kind; bool active; };

#define SHOW(T, f) printf("  %-7s offset %2zu size %zu\n", #f, offsetof(struct T, f), sizeof(((struct T*)0)->f))

int main(void) {
    printf("struct Bad: sizeof %zu, alignof %zu\n", sizeof(struct Bad), _Alignof(struct Bad));
    SHOW(Bad, flag); SHOW(Bad, price); SHOW(Bad, kind); SHOW(Bad, qty); SHOW(Bad, active);
    printf("struct Good: sizeof %zu, alignof %zu\n", sizeof(struct Good), _Alignof(struct Good));
    SHOW(Good, price); SHOW(Good, qty); SHOW(Good, flag); SHOW(Good, kind); SHOW(Good, active);
    return 0;
}
struct Bad: sizeof 32, alignof 8
  flag    offset  0 size 1
  price   offset  8 size 8
  kind    offset 16 size 1
  qty     offset 20 size 4
  active  offset 24 size 1
struct Good: sizeof 16, alignof 8
  price   offset  0 size 8
  qty     offset  8 size 4
  flag    offset 12 size 1
  kind    offset 13 size 1
  active  offset 14 size 1
Los mismos 15 bytes de datos; 32 bytes contra 16. Bad tiene 7 bytes vacíos después de flag, 3 después de kind y 7 al final, para que el siguiente elemento de un arreglo también quede alineado. No tienes que calcularlo a mano; -Wpadded lista cada hueco:
layout.c:6:33: warning: padding struct 'struct Bad' with 7 bytes to align 'price' [-Wpadded]
layout.c:6:59: warning: padding struct 'struct Bad' with 3 bytes to align 'qty' [-Wpadded]
layout.c:6:8: warning: padding size of 'struct Bad' with 7 bytes to alignment boundary [-Wpadded]
layout.c:7:8: warning: padding size of 'struct Good' with 1 byte to alignment boundary [-Wpadded]
No dejes -Wpadded activado siempre (casi todos los structs lo disparan); úsalo para inspeccionar un header. Dos consecuencias prácticas: nunca hagas fwrite de un struct a un archivo o socket esperando que otro compilador u otra CPU lo lea de vuelta (el padding y el orden de bytes cambian), y nunca compares structs con memcmp (los bytes de padding guardan lo que hubiera ahí antes).
Medido: strcat en un bucle y structs con padding vs compactos
Dos costos invisibles en una code review. Ambos medidos con clock_gettime(CLOCK_MONOTONIC), el mejor de 5 ejecuciones, clang -O2, Mac con Apple Silicon (M1 Pro). El programa completo está al final de esta sección.
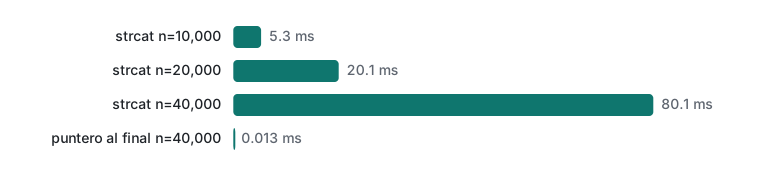
Unir n palabras con strcat frente a recordar dónde está el final:
| n palabras | strcat cada vez |
guardar un puntero al final |
|---|---|---|
| 10,000 | 5.30 ms | 0.003 ms |
| 20,000 | 20.1 ms | 0.006 ms |
| 40,000 | 80.1 ms | 0.013 ms |
Duplicar n multiplica por 4 el tiempo de strcat: cada llamada ejecuta strlen sobre todo lo que llevas unido, así que el trabajo total crece con n². Con 40,000 palabras es unas 6,000 veces más lento que llevar la cuenta de la longitud. Es la misma razón por la que vale tanto que snprintf devuelva la longitud: guarda el número y nunca vuelves a recorrer.
Sumar un campo en 10,000,000 de structs: struct Bad (32 bytes) tardó 5.41 ms y struct Good (16 bytes) 2.71 ms, con los mismos valores de qty. El bucle lee un int por elemento en ambos casos, pero la memoria llega en líneas de caché completas (128 bytes en esta M1 Pro, según sysctl hw.cachelinesize): una línea contiene 4 structs Bad u 8 Good. La mitad de bytes movidos, la mitad del tiempo. La clase 6 lleva esta idea más lejos.
/* bench4.c: strcat in a loop vs remembering the end; padded vs packed structs.
   clang -std=c17 -O2 bench4.c -o bench4 && ./bench4 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <stdint.h>
#include <stdbool.h>
#include <time.h>

static double now_ms(void) {
    struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t);
    return t.tv_sec * 1e3 + t.tv_nsec / 1e6;
}
static size_t join_strcat(char *buf, int n) {      /* rescans buf on every call */
    buf[0] = '\0';
    for (int i = 0; i < n; i++) strcat(buf, "word,");
    return strlen(buf);
}
static size_t join_end(char *buf, int n) {         /* remembers where the end is */
    char *end = buf;
    for (int i = 0; i < n; i++) { memcpy(end, "word,", 5); end += 5; }
    *end = '\0';
    return (size_t)(end - buf);
}
struct Bad  { char flag; double price; char kind; int32_t qty; bool active; };
struct Good { double price; int32_t qty; char flag; char kind; bool active; };
static struct Bad  *gb;
static struct Good *gg;
enum { N = 10000000 };
static size_t sum_bad(void)  { size_t t = 0; for (int i = 0; i < N; i++) t += gb[i].qty; return t; }
static size_t sum_good(void) { size_t t = 0; for (int i = 0; i < N; i++) t += gg[i].qty; return t; }

#define BEST(label, expr) do { double best = 1e30; volatile size_t r = 0;           \
    for (int k = 0; k < 5; k++) { double t0 = now_ms(); r = (expr);              \
        double dt = now_ms() - t0; if (dt < best) best = dt; }                   \
    printf("%-26s %9.3f ms  (result %zu)\n", label, best, (size_t)r); } while (0)

int main(void) {
    int sizes[] = {10000, 20000, 40000};
    char *buf = malloc(40000 * 5 + 1);
    for (int s = 0; s < 3; s++) {
        char l1[40], l2[40];
        snprintf(l1, sizeof l1, "strcat   n=%d", sizes[s]);
        snprintf(l2, sizeof l2, "end ptr  n=%d", sizes[s]);
        BEST(l1, join_strcat(buf, sizes[s]));
        BEST(l2, join_end(buf, sizes[s]));
    }
    free(buf);
    struct Bad  *b = gb = malloc(N * sizeof *b);
    struct Good *g = gg = malloc(N * sizeof *g);
    srand(42);
    for (int i = 0; i < N; i++) {
        int q = rand() % 100;
        b[i] = (struct Bad){ .qty = q, .price = q * 0.5 };
        g[i] = (struct Good){ .qty = q, .price = q * 0.5 };
    }
    BEST("sum qty, Bad (32 B)",  sum_bad());
    BEST("sum qty, Good (16 B)", sum_good());
    free(b); free(g);
    return 0;
}
Compila limpio incluso con -Wpedantic. Los dos bucles de structs imprimieron el mismo checksum (494840983), así que el más rápido no se está saltando trabajo.
Límites honestos y notas de versión
- Todo esto se ejecutó con Apple clang 21.0.0 en macOS arm64. Los números de padding valen para las ABI de 64 bits comunes (arm64 y x86-64 en Linux/macOS/Windows dan los mismos 32/16 para estos structs), pero el estándar solo dice "definido por la implementación"; medimos solo esta máquina.
- Vimos
-Wunterminated-string-initializationy su sugerencia denonstringen clang 21 con-Wall -Wextraa secas; no revisamos qué versiones anteriores lo emiten. - Los resultados
Abort trap: 6(stack protector) yTrace/BPT trap: 5(revisión de_FORTIFY_SOURCE) son comportamiento de la libc de macOS. Linux con glibc reporta en cambio*** stack smashing detected ***o*** buffer overflow detected ***(no lo ejecutamos aquí). Ninguno reemplaza a ASan: solo ven algunos overflows, y solo después o justo antes del daño. - Estándares:
strncpy,strcatyoffsetofson C89;snprintfes C99;_Alignofes C11 (alignofpasó a ser palabra clave en C23).memccpyystrdupentraron a ISO C en C23.strlcpyno está en ISO C; está en POSIX.1-2024, en macOS/BSD y en glibc desde la 2.38. - Los tiempos son el mejor de 5 en una máquina sin carga. Las proporciones (n², la mitad de bytes ≈ la mitad del tiempo) son lo importante; tus números absolutos van a variar.
Ejercicios
- Sin ejecutarlo, ¿qué imprimen
sizeof(struct A)ysizeof(struct B)en una Mac de 64 bits?struct A { char a; int b; char c; };ystruct B { int b; char a; char c; }; - Escribe
int append(char *dst, size_t cap, size_t *len, const char *src), que agregasrc, mantiene*lenactualizado y devuelve -1 sin modificar dst si el resultado no cabe. Pruébala con un buffer de 12 bytes y"GET ","/index",".html".
Respuestas
A=12 B=8. EnA,btiene que empezar en el offset 4, así que siguen 3 bytes después dea, luegocen 8 y 3 bytes de padding al final para llegar a un múltiplo de 4. EnB, los dos char quedan en 4 y 5, y 2 bytes de padding al final dan 8.- Una versión, revisada con
-fsanitize=address,undefined:
static int append(char *dst, size_t cap, size_t *len, const char *src) {
    size_t n = strlen(src);
    if (*len + n + 1 > cap) return -1;
    memcpy(dst + *len, src, n + 1);      /* copies the NUL too */
    *len += n;
    return 0;
}
append "GET " -> rc=0 buf="GET " len=4
append "/index" -> rc=0 buf="GET /index" len=10
append ".html" -> rc=-1 buf="GET /index" len=10
"GET /index.html" necesita 16 bytes, así que la tercera llamada se niega y el buffer sigue siendo un string válido.
Para practicar más con structs y punteros en una estructura de datos real, mira los artículos de lista enlazada (en inglés) y de pila (en inglés), también revisados con ASan.
Lo que sigue
La clase 5 entra al comportamiento indefinido: por qué el optimizador puede borrar tus revisiones de overflow y cómo UBSan te avisa antes.
Anterior: Clase 3: punteros, memoria y malloc · Siguiente: Clase 5: comportamiento indefinido y el optimizador
Preguntas frecuentes
¿strncpy es un reemplazo seguro de strcpy?
No. Cuando el origen mide lo mismo que el buffer o más, strncpy llena todos los bytes y no escribe el NUL final. En nuestra prueba el último byte de un buffer de 8 bytes fue 111 ('o'), no 0, así que el siguiente strlen o printf lee más allá del final. Usa snprintf(dst, sizeof dst, "%s", src) y revisa su valor de retorno, o strlcpy si tu plataforma lo tiene.
¿Por qué el sizeof de mi struct es mayor que la suma de sus campos?
El compilador inserta padding (relleno) para que cada campo quede en una dirección múltiplo de su alineación. Un struct con char, double, char, int32_t y bool necesita 15 bytes de datos pero midió 32 bytes en arm64; ordenar los mismos campos de mayor a menor dio 16. Imprime offsetof de cada campo, o compila con -Wpadded, para ver dónde están los huecos.
¿Por qué mi programa en C imprime bien y después truena con Abort trap: 6?
En macOS, un buffer overflow en el stack con -O0 muchas veces lo detecta el stack protector solo cuando la función retorna. El strcpy que se desbordó ya se ejecutó y el printf ya imprimió; después __stack_chk_fail llamó a abort (código de salida 134). Compila con -fsanitize=address para detenerte en la escritura exacta.