Internos de Git: objetos, packfiles, gc y bisect
Calcula a mano el hash de un blob, haz un commit con plumbing, mide gc y binarios grandes, y encuentra con bisect el commit malo en 8 pruebas de 300.
Serie: curso de Git 6/6 (avanzado). Para quienes usan Git todos los días (clases 1 a 5) y quieren saber qué hay dentro de .git, por qué algunos repositorios se vuelven lentos y enormes, y cómo encontrar el commit que rompió algo. Vas a calcular hashes de objetos a mano, armar un commit sin git commit y medir gc, archivos grandes y bisect.
Esta clase es para quien escuchó "no hagas commit de ese video" sin ningún número que lo respalde, para quien se pregunta por qué un rebase cambia los hashes, o para quien necesita encontrar cuál de 300 commits rompió un cálculo. Pasa mucho en equipos chicos y proyectos de freelance: alguien sube los .apk de cada versión al repositorio y meses después clonar tarda una eternidad. Conocer el modelo de objetos convierte los comportamientos raros de Git (IDs nuevos después de un rebase, commits "borrados" que se pueden recuperar, clones enormes) en consecuencias predecibles. Todo lo de abajo se ejecutó y se midió; nada está parafraseado de la documentación.
Entorno: Git 2.54.0 (Apple Git-157), shasum de macOS, Python 3.9.6 (del sistema) para generar datos de prueba fijos, Mac con Apple Silicon (M1 Pro). Repositorios de prueba con una identidad de demostración y fechas fijas, así que los hashes de abajo son reproducibles.
Un blob es "blob \0" más tus bytes
$ printf 'hello\n' > hello.txt
$ git hash-object hello.txt
ce013625030ba8dba906f756967f9e9ca394464a
$ printf 'blob 6\0hello\n' | shasum -a 1
ce013625030ba8dba906f756967f9e9ca394464a  -
Ese es todo el secreto: el ID del objeto es el SHA-1 de una cabecera corta (blob, un espacio, el tamaño en bytes, un byte NUL) seguida del contenido. El nombre del archivo no forma parte de él. Después de git add, el objeto aparece en el disco con su hash como nombre (los dos primeros dígitos hexadecimales son el directorio):
$ find .git/objects -type f
.git/objects/ce/013625030ba8dba906f756967f9e9ca394464a
$ git cat-file -t ce01362     ->  blob
$ git cat-file -s ce01362     ->  6
$ git cat-file -p ce01362     ->  hello
El archivo en disco pesa 21 bytes: está comprimido con zlib. Si lo descomprimes con Python ves exactamente los bytes que se hashearon:
$ python3 -c "import zlib;print(zlib.decompress(open('.git/objects/ce/013625030ba8dba906f756967f9e9ca394464a','rb').read()))"
b'blob 6\x00hello\n'
Cambia un carácter y obtienes un objeto completamente distinto (hello → v2 dio 8c1384d…). Git nunca guarda "el cambio"; guarda versiones completas y deja que el packfile las comprima después.
Árboles y commits: cómo se guarda una instantánea
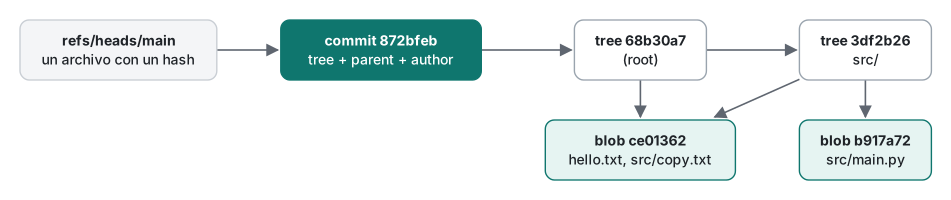
Agregamos src/copy.txt (que también contiene hello) y src/main.py, e hicimos commit. Cuenta los objetos:
.git/objects/3d/f2b26e…   tree  (src/)
.git/objects/68/b30a75…   tree  (root)
.git/objects/87/2bfebe…   commit
.git/objects/b9/17a726…   blob  (main.py)
.git/objects/ce/013625…   blob  (hello.txt AND src/copy.txt)
Cinco objetos para tres archivos: los dos archivos que contienen hello comparten un solo blob. Leyéndolos:
$ git cat-file -p HEAD
tree 68b30a75a76fffa7bf25023339501ec8cd7104d5
author demo <demo@example.com> 1794445200 +0000
committer demo <demo@example.com> 1794445200 +0000

First commit
$ git cat-file -p HEAD^{tree}
100644 blob ce013625030ba8dba906f756967f9e9ca394464a    hello.txt
040000 tree 3df2b26ecb8bcdda43db72b3f32af69ffa7736b3    src
$ git cat-file -p HEAD:src
100644 blob ce013625030ba8dba906f756967f9e9ca394464a    copy.txt
100644 blob b917a726c93f902e43291d9009d6488385133b67    main.py
Un tree (árbol) es un listado de directorio: modo, tipo, hash y nombre. Un commit es un texto corto: el árbol raíz, el o los commits padre, el autor, quien hizo el commit (committer) y el mensaje. Y se hashea igual que un blob:
$ git cat-file commit HEAD > c.raw
$ printf 'commit %s\0' $(wc -c < c.raw | tr -d ' ') | cat - c.raw | shasum -a 1
872bfebe6661489bdb33dce1ebf41088eb94f21b  -
$ git rev-parse HEAD
872bfebe6661489bdb33dce1ebf41088eb94f21b
Como el hash del padre está dentro del texto del commit, cambiar cualquier commit cambia el hash de todos los que vienen después. Esa es toda la razón por la que el rebase "reescribe la historia" (clase 4), y por la que un ID de commit garantiza toda la historia que tiene detrás.
Hacer un commit solo con plumbing
git commit es un envoltorio cómodo sobre tres comandos de "plumbing" (fontanería, los comandos de bajo nivel):
$ echo "v2" > hello.txt
$ git add hello.txt
$ git write-tree
9bc1402c06ef1cef8f6d0e539a5333f3797b22de
$ echo "Commit made by hand" | git commit-tree 9bc1402 -p HEAD
6b582d907ea233b6037ec127b2e4405c052d999b
$ git update-ref refs/heads/main 6b582d9
$ git log --oneline
6b582d9 Commit made by hand
872bfeb First commit
$ git status --short
                       <- clean: the index already matched the new tree
write-tree convierte el index en objetos tree, commit-tree envuelve un árbol en un commit y update-ref mueve el nombre de la rama. El estado queda limpio porque el index ya coincidía con el árbol nuevo. Una rama de verdad es solo un archivo que guarda un hash. Errores que vas a ver cuando empieces a hurgar en los objetos:
$ git cat-file -p 0000000
fatal: Not a valid object name 0000000
También existen repositorios SHA-256 (git init --object-format=sha256); ahí git hash-object imprimió 2cf8d83d…ebb4, lo mismo que printf 'blob 6\0hello\n' | shasum -a 256. Mismo esquema, hash más largo.
Objetos sueltos contra packfiles: gc medido
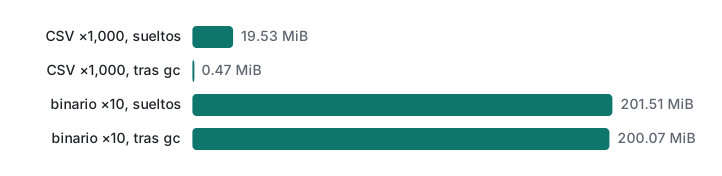
Cada git add / git commit escribe objetos sueltos (loose): un archivo zlib por objeto. git gc los empaqueta en un packfile y guarda los objetos parecidos como deltas entre sí. Para ver cuánto importa eso generamos, con random.seed(7) de Python, 1,000 commits que cambian cada uno una línea de un CSV de 1,000 líneas (30,691 bytes). Los commits se importaron con git fast-import y luego se desempaquetaron en objetos sueltos con git unpack-objects, para que cada ejecución empiece desde los mismos 3,000 objetos sueltos.
## before gc
count: 3000
size: 19.53 MiB
## after gc
count: 0
in-pack: 3000
packs: 1
size-pack: 484.38 KiB
| Ejecución (Mac con Apple Silicon, M1 Pro) | .git/objects antes |
después | tiempo de git gc |
|---|---|---|---|
| 1 | 20,000 KB | 564 KB | 0.80 s |
| 2 | 20,000 KB | 576 KB | 0.92 s |
| 3 | 20,000 KB | 568 KB | 0.92 s |
Dentro del pack, por tipo de objeto (git cat-file --batch-check='%(objectsize) %(objectsize:disk)'):
| Tipo | Cantidad | Tamaño sin comprimir | Tamaño en el pack |
|---|---|---|---|
| blob | 1,000 | 30,661,605 B | 214,805 B |
| tree | 1,000 | 39,000 B | 49,846 B |
| commit | 1,000 | 209,837 B | 146,248 B |
git verify-pack -v reportó 990 objetos guardados como deltas, con cadenas de hasta 49 de profundidad. Treinta megabytes de historia de un CSV se convirtieron en 210 KB de blobs. Fíjate en los árboles: los objetos diminutos se vuelven más grandes al comprimirlos, porque zlib tiene un costo fijo.
Normalmente no necesitas ejecutar gc tú: Git ejecuta gc --auto después de muchos comandos en cuanto hay suficientes objetos sueltos. Esa ejecución automática en segundo plano fue justamente la que arruinó nuestra medición en la clase 4.
Archivos binarios grandes: el dolor, medido
Ahora el caso del que todos advierten. Un archivo de 20 MiB de bytes aleatorios (random.seed(v) de Python para la versión v, así es reproducible) con commit en 10 versiones, como cuando vuelves a exportar un video o un asset de un juego.
## loose, after 10 commits
count: 40
size: 201.51 MiB
## git gc (1 run): 24.49 s
size-pack: 200.07 MiB
gc ahorró un 0.7% y tardó 24.49 s, contra 0.8–0.9 s con la historia de texto. Cada versión de 20,971,520 bytes ocupa 20,977,930 bytes en el pack: los datos aleatorios (o ya comprimidos) no se comprimen y no tienen deltas útiles, así que Git guarda cada versión completa, para siempre, y cada clon las descarga todas. Lo clonamos de tres maneras (transporte local file://, así que no se incluye el tiempo de red), 3 ejecuciones:
| Clon | Ejecución 1 | Ejecución 2 | Ejecución 3 | Tamaño de .git |
|---|---|---|---|---|
completo (--no-local) |
1.46 s | 1.66 s | 2.99 s | 207–213 MB |
--depth 1 |
0.23 s | 0.35 s | 0.28 s | 20 MB |
--filter=blob:none (sin blobs) |
0.27 s | 0.55 s | 0.39 s | 20 MB |
En una red real la diferencia crece: el clon completo transfiere unas diez veces más bytes que los superficiales. Los clones parciales tienen sus propios costos: en el clon superficial (shallow), git switch --detach HEAD~5 falló con fatal: invalid reference: HEAD~5 (esa historia no está), y en el clon sin blobs el mismo comando funcionó pero descargó la versión faltante en el momento (0.43 s aquí, y .git pasó de 20 MB a 40 MB). Para archivos que sí deben versionarse, Git LFS guarda solo punteros en Git; no está instalado en esta máquina, así que no se probó.
| Situación | Elección |
|---|---|
Archivos generados (builds, .apk, .ipa, exportaciones) |
no hagas commit; .gitignore y guárdalos como artefactos de release |
| Assets grandes que deben versionarse con el código | Git LFS (no se ejecutó aquí) |
| Solo necesitas el código más reciente (CI, una revisión rápida) | git clone --depth 1 |
| Necesitas la historia pero no el contenido viejo de los archivos | git clone --filter=blob:none |
| Ya hiciste commit de un archivo grande por error | se queda en la historia; quitarlo implica reescribir la historia (git filter-repo, no se ejecutó aquí) y que todos vuelvan a clonar |
git bisect: encuentra el commit malo en 8 ejecuciones de 300
Un cálculo de impuestos estaba bien al principio y ahora está mal; hay 300 commits en medio, todos llamados "Refactor step N". El bug (el 10% pasó a ser 1%) está en el commit 211, pero hagamos de cuenta que no lo sabemos. Bisect hace una búsqueda binaria sobre la historia; git bisect run deja que un script juzgue cada commit. El script debe salir con 0 si está bien y con 1 si está mal:
#!/bin/sh
# test_tax.sh: exit 0 = good, 1 = bad
out=$(python3 -c 'from tax import total; print(total(1000))')
[ "$out" = "1100" ]
$ git bisect start HEAD HEAD~299
Bisecting: 149 revisions left to test after this (roughly 7 steps)
[95892e7b…] Refactor step 150
$ git bisect run ~/demo/test_tax.sh
running '~/demo/test_tax.sh'
Bisecting: 74 revisions left to test after this (roughly 6 steps)
[d0546bdf…] Refactor step 225
running '~/demo/test_tax.sh'
Bisecting: 37 revisions left to test after this (roughly 5 steps)
[e787361d…] Refactor step 187
...
[72f52537…] Refactor step 211
running '~/demo/test_tax.sh'
72f52537d6519b73cf52dd4aa0392555090184c1 is the first bad commit
commit 72f52537d6519b73cf52dd4aa0392555090184c1
    Refactor step 211
 tax.py | 4 ++--
bisect found first bad commit
$ git bisect reset
Medido, 3 ejecuciones cada uno (Mac con Apple Silicon, M1 Pro), contra el enfoque ingenuo de hacer checkout y probar cada commit desde el más viejo hasta el primer fallo:
| Historia | bisect: ejecuciones de prueba | tiempo de bisect | lineal: ejecuciones de prueba | tiempo lineal |
|---|---|---|---|---|
| 300 commits, bug en el 211 | 8 | 0.44 / 0.37 / 0.38 s | 211 | 11.69 / 13.73 / 12.89 s |
| 3,000 commits, bug en el 2,111 | 11 | 0.52 / 0.50 / 0.49 s | 2,111 | 122.29 / 135.56 / 133.10 s |
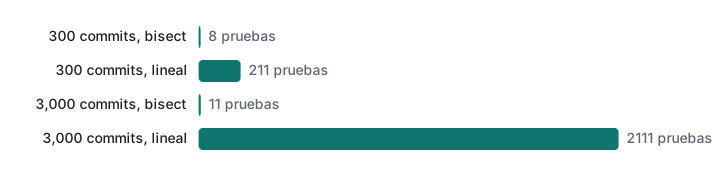
Diez veces más historia le costó a bisect tres ejecuciones más. Con una prueba que tarda un minuto (un build más una suite de tests), es la diferencia entre 11 minutos y un día y medio. Si quieres una guía completa de esta técnica, lee git bisect para cazar regresiones.
Errores comunes
Un script de bisect roto culpa al commit equivocado. Metimos un error de tipeo (pyhton3) en el script de prueba. Cada ejecución imprimió pyhton3: command not found, la comparación falló, el script salió con 1 ("malo") en cada commit, y bisect reportó con toda seguridad:
2d4b99385a37b3ebbb3cd09658e6d8af549f2ddd is the first bad commit
    Refactor step 2
bisect found first bad commit
Solución: ejecuta el script a mano en un commit que sabes que está bien y confirma que echo $? imprime 0, antes de bisect run. El código de salida 125 significa "no se puede probar, salta este commit"; los códigos mayores que 127 abortan el bisect.
Ejecutar git bisect good antes de start. Git responde You need to start by "git bisect start". Además, ejecuta git bisect reset al final, o te quedas en un commit desacoplado (detached) de la mitad de la historia.
Leer .git/objects con ls -l para juzgar el tamaño del repositorio. Solo muestra los objetos sueltos, y después de gc está casi vacío. Usa git count-objects -vH, que reporta por separado el tamaño suelto y el empaquetado.
Límites honestos y notas de versión
- Solo se comprobó en Git 2.54.0 (Apple Git-157). El formato de objetos SHA-256 existe desde Git 2.29 y estuvo marcado como experimental durante mucho tiempo; no se probó la interoperabilidad entre repositorios SHA-1 y SHA-256.
- El clon parcial (
--filter) necesita soporte del servidor; nuestro "servidor" local teníauploadpack.allowFilter=true. Los servicios de hosting varían. - Los tiempos de
gcdependen de los núcleos de CPU (la búsqueda de deltas usa varios hilos) y del disco; la variación entre ejecuciones fue de ±15%. El gc del archivo grande se midió una sola vez. duycount-objectsno coinciden del todo (bloques del sistema de archivos contra bytes de archivo); las tablas indican cuál usan.- Git LFS y
git filter-repono están instalados aquí y solo se describen.
Ejercicios
- Sin ejecutar Git, ¿qué línea de comandos imprime el ID de objeto de un archivo que contiene exactamente
hiseguido de un salto de línea (3 bytes)? Luego compruébalo congit hash-object. - Tu prueba de bisect necesita un build que a veces falla por razones ajenas al bug (una dependencia que falta en commits viejos). ¿Con qué código debería salir el script en ese caso, y por qué no con 1?
Respuestas
printf 'blob 3\0hi\n' | shasum -a 1. Debe coincidir conprintf 'hi\n' | git hash-object --stdin.- Con 125. Le dice a bisect "este commit no se puede probar, sáltalo". Salir con 1 marcaría el commit como malo y llevaría la búsqueda al lugar equivocado, exactamente como el script roto de arriba.
Anterior: Curso de Git 5: deshacer con reset, revert y reflog · Inicio de la serie: Curso de Git 1: init, add, commit · Relacionado: rebase y cherry-pick · Volver a la ruta de estudio para tu primer trabajo.
Preguntas frecuentes
¿Cómo calcula Git el hash de un commit o de un archivo?
Calcula el hash de una cabecera más el contenido: para un archivo, los bytes 'blob <tamaño>' seguidos de un byte NUL y el contenido del archivo. printf 'blob 6\0hello\n' | shasum dio ce013625…, exactamente lo que imprimió git hash-object. Un commit se hashea igual sobre su texto (tree, parent, author, committer, mensaje), y por eso cambiar un padre cambia todos los hashes posteriores.
¿git gc hace más pequeño un repositorio?
Con historia de texto, muchísimo: 1,000 versiones de un CSV de 30 KB ocupaban 19.53 MiB como objetos sueltos y 484 KiB después de git gc, porque 990 de las 1,000 versiones del archivo se guardaron como deltas. Con datos binarios aleatorios no ayudó nada: 10 versiones de un archivo de 20 MiB ocupaban 201.51 MiB sueltas y 200.07 MiB empaquetadas, y gc tardó 24.5 segundos.
¿Cuántos pasos necesita git bisect?
Más o menos el log2 del número de commits. Con git bisect run y un script de prueba, 300 commits necesitaron 8 ejecuciones de la prueba (0.4 s) y 3,000 commits 11 ejecuciones (0.5 s); probar cada commit desde el más viejo necesitó 211 y 2,111 ejecuciones (unos 12 s y 2 minutos). El script debe salir con 0 si está bien y con 1–127 (salvo 125) si está mal, o bisect culpa al commit equivocado.