C言語の二分探索:2021年のコードを動かし直してわかったこと
ソート済み配列を半分ずつ絞る二分探索。2021年の例を今コンパイルするとエラーになり、比較回数の説明も1回ずつずれていた。実測で直した改訂版。
2026年11月改訂: この記事は2021年に韓国語で書いた講座を、日本語で書き直したものです。動かし直すと、例のコードは今のCコンパイラではそのままコンパイルできず、比較回数の説明は1回ずつずれていて、中央値の計算にはオーバーフローのバグがありました。以下はすべて Apple M1 Pro、Apple clang 21 で計測し直した内容です。
考え方
二分探索は、ソート済みの配列で、真ん中の要素と比べて「目的の値があり得ない半分」を捨てながら探します。比較するたびに範囲が半分になるので「二分」探索と呼びます。
速さの感覚をつかむと、70億個から1つを探すとき、線形探索は平均35億回比較しますが、二分探索は最大33回です。この数字は後で実際に確かめます。
例で追ってみる
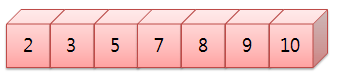
上のソート済み配列から8を探します。まず真ん中の要素を選びます。
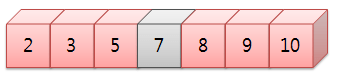
目的の値と比べます。小さければ左半分、大きければ右半分で続けます。8は真ん中の7より大きいので、左半分は見る必要がなく、右半分の真ん中を選び直します。
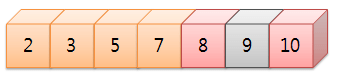
今度の真ん中は9です。8のほうが小さいので左側を探します。
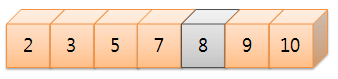
残った8が真ん中になり、目的の値と一致するので探索は終わりです。
比較回数(2021年の説明の訂正)
比較するたびに範囲は半分になります。要素数をn、回数をkとすると、kはnを2で何回割れば1になるか、つまり k ≈ log2(n) です。
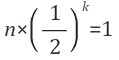
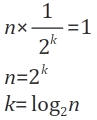
元の記事では「500万個なら最大22回、1000万個なら最大23回」と書いていましたが、どちらも1回少なく数えていました。 最悪の比較回数は floor(log2 n) + 1 です。実際に数えた結果です。
| 要素数n | 2021年の記事 | 実測(最悪) |
|---|---|---|
| 21(例の配列) | — | 5 |
| 5,000,000 | 22 | 23 |
| 10,000,000 | 23 | 24 |
| 7,000,000,000 | 33 | 33 |
/* 最悪の場合の反復回数を数える:末尾の要素を探すとき */
static long worst_iters(long long n) {
    long long lo = 0, hi = n - 1; long it = 0;
    while (lo <= hi) {
        it++;
        long long mid = lo + (hi - lo) / 2;
        if (mid < n - 1) lo = mid + 1; else return it;
    }
    return it;
}
実装(修正版)
int BinarySearch(const int dataArr[], int size, int findData)
{
    int low = 0, high = size - 1;
    while (low <= high)                      /* 範囲が空になったら見つからない */
    {
        int mid = low + (high - low) / 2;    /* (low + high) / 2 はオーバーフローする(後述) */
        if (dataArr[mid] > findData)      high = mid - 1;
        else if (dataArr[mid] < findData) low = mid + 1;
        else return mid;                     /* 見つかった */
    }
    return -1;
}
low と high は今の範囲の左端と右端、mid はその真ん中です。2021年版から変えたのは2か所です。
1. mid = (low + high) / 2 は大きな配列で壊れる
low + high が int の最大値(2,147,483,647)を超えるとオーバーフローします。要素数が約10億を超える配列なら実際に起きます。
overflow: low+high=3500000000 > INT_MAX=2147483647
          (int)(low+high)/2  = -397483648      ← 負のインデックス
          low+(high-low)/2   = 1750000000      ← 正しい値
low + (high - low) / 2 は数学的に同じ値ですが、途中の計算が範囲を超えません。Javaの標準ライブラリの二分探索にも長年残っていたほど、よくあるバグです。
2. 例のコードがそのままではコンパイルできない
2021年の main は while (true) を使っていました。Cで true を使うには <stdbool.h> が必要です(キーワードになったのはC23から)。
$ cc -std=c17 orig.c
orig.c:27:12: error: use of undeclared identifier 'true'
   27 |     while (true) {
さらに scanf の戻り値を確かめていなかったので、入力が終わっても、最後の値の結果を延々と出力し続けていました。修正した例は次のとおりです。
例(修正版)
#include <stdio.h>

int BinarySearch(const int dataArr[], int size, int findData);   /* 上の実装 */

int main(void)
{
    int dataArr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 17, 21, 24, 26, 27, 28};
    int length = sizeof dataArr / sizeof dataArr[0];
    int input;

    while (scanf("%d", &input) == 1) {       /* 入力が終わったら抜ける */
        int ret = BinarySearch(dataArr, length, input);
        if (ret != -1) printf("%d番目にあります。\n", ret + 1);
        else           printf("見つかりません。\n");
    }
    return 0;
}
$ printf "28\n4\n7\n17\n99\n" | ./bs
21番目にあります。
4番目にあります。
7番目にあります。
16番目にあります。
見つかりません。
-std=c17 -Wall -Wextra で警告なしにコンパイルでき、入力が終われば終了します。
線形探索との速度比較(実測)
1000万個のソート済み配列(a[i] = i * 2)から、ランダムに選んだ1,000個の値を探しました。clang -O2 でビルドしています。
| 方法 | 1,000回の探索 |
|---|---|
| 線形探索 | 1.636秒 |
| 二分探索 | 0.000089秒(0.089ミリ秒) |
約18,000倍の差です。ただし前提はデータがソート済みであることです。1回しか探さないなら、ソートの費用(O(n log n))のほうが線形探索より高くつきます。二分探索が真価を発揮するのは、同じデータを何度も探すときです。
実務で使うなら
- Cには標準ライブラリの
bsearch()があります。比較関数を渡すだけです。 - 同じ値が複数あって最初の位置が必要なら、見つけたあとも左へ範囲を絞り続ける lower bound 型にします。上の実装は、一致した位置のどれかを返します。
- C++なら
std::lower_bound/std::binary_search、Pythonならbisectモジュール、C#ならArray.BinarySearchを使います。自分で書くのは学習のため、本番ではライブラリを使いましょう。
よくある質問
二分探索の比較回数は最大何回?
要素数nのとき、最悪で floor(log2 n) + 1 回です。実際に数えると、500万個で23回、1000万個で24回、70億個で33回でした。
mid = (low + high) / 2 の何が問題?
lowとhighが大きいと、和がintの範囲を超えてオーバーフローします。low=1,500,000,000、high=2,000,000,000 ならmidは負の値(-397,483,648)になります。mid = low + (high - low) / 2 と書けば安全です。
線形探索よりどれくらい速い?
1000万個のソート済み配列で1,000回探すと、線形探索は1.636秒、二分探索は0.089ミリ秒でした(Apple M1 Pro、clang -O2)。