이진 탐색(Binary Search): 2021년 코드를 다시 돌려 보니
정렬된 배열을 반씩 줄여 가며 찾는 이진 탐색. 2021년 예제를 지금 컴파일하니 에러가 났고, 비교 횟수 설명도 1회씩 틀렸다. 실측으로 고친 보강판.
2026년 11월 보강: 2021년에 쓴 글을 다시 검증했습니다. 예제가 지금의 C 컴파일러에서 그대로는 컴파일되지 않았고, 비교 횟수 설명이 1회씩 틀렸으며, 큰 배열에서 생기는 오버플로 버그가 있었습니다. 아래는 고친 내용과 실측값입니다. 실행 환경은 Apple M1 Pro, Apple clang 21입니다.
데이터를 찾아보자!
순차 탐색에 이어 이진 탐색(Binary Search)을 살펴보겠습니다. 이진 탐색이란 이름이 붙은 이유는, 한 번 비교할 때마다 탐색 범위가 반(1/2)으로 줄어들기 때문입니다. 순차 탐색과 달리 정렬된 배열을 전제로 합니다.
얼마나 빠른지 감을 잡아 보면, 70억 개 중에서 하나를 찾을 때 순차 탐색은 평균 35억 번을 비교하지만, 이진 탐색은 최대 33번이면 됩니다(아래에서 실측으로 확인합니다).
이진 탐색의 탐색 과정
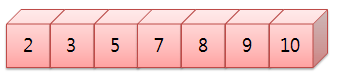
위와 같은 정렬된 배열에서 8을 찾아보겠습니다. 첫 단계에서는 데이터 집합의 중앙 요소를 고릅니다.
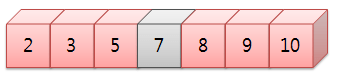
중앙 요소와 찾으려는 값을 비교합니다. 찾으려는 값이 더 작으면 중앙의 왼쪽에서, 더 크면 오른쪽에서 다시 중앙을 고릅니다. 8은 중앙값 7보다 크므로 왼쪽은 볼 필요가 없고, 오른쪽에서 다시 중앙을 고릅니다.
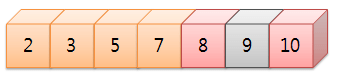
이번 중앙값은 9입니다. 8은 9보다 작으므로 왼쪽에서 찾습니다.
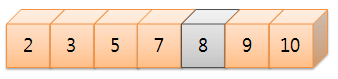
남은 데이터 8이 중앙값이 되고, 찾으려는 값과 같으므로 탐색을 마칩니다.
성능: 몇 번 비교하나 (2021년 설명 정정)
비교할 때마다 범위가 1/2로 줄어드니, 데이터가 n개이고 반복 횟수가 k라면 n을 2로 k번 나누어 1이 될 때까지, 즉 k ≈ log2(n)입니다.
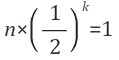
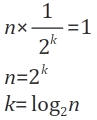
2021년 글에서는 "500만 개면 최대 22회, 1000만 개면 최대 23회"라고 썼는데, 둘 다 1회씩 적게 셌습니다. 최악의 경우 비교 횟수는 log2(n)을 내림한 값에 1을 더한 floor(log2 n) + 1입니다. 직접 세어 본 결과입니다.
| 원소 수 n | 2021년 글 | 실측 (최악) |
|---|---|---|
| 21 (예제 배열) | — | 5 |
| 5,000,000 | 22 | 23 |
| 10,000,000 | 23 | 24 |
| 7,000,000,000 | 33 | 33 |
/* 최악의 경우 반복 횟수를 센다: 맨 끝 원소를 찾을 때 */
static long worst_iters(long long n) {
    long long lo = 0, hi = n - 1; long it = 0;
    while (lo <= hi) {
        it++;
        long long mid = lo + (hi - lo) / 2;
        if (mid < n - 1) lo = mid + 1; else return it;
    }
    return it;
}
구현 (고친 버전)
int BinarySearch(const int dataArr[], int size, int findData)
{
    int low = 0, high = size - 1;
    while (low <= high)                      /* high가 low보다 작아지면 데이터가 없다 */
    {
        int mid = low + (high - low) / 2;    /* (low + high) / 2 는 오버플로가 난다 (아래 참고) */
        if (dataArr[mid] > findData)      high = mid - 1;
        else if (dataArr[mid] < findData) low = mid + 1;
        else return mid;                     /* 찾았다 */
    }
    return -1;                               /* 없다 */
}
low는 탐색 범위의 가장 왼쪽 위치, high는 가장 오른쪽 위치, mid는 그 가운데입니다. 2021년 코드와 달라진 곳은 두 군데입니다.
1. mid = (low + high) / 2 는 큰 배열에서 틀린 값을 낸다
low + high가 int 최댓값(2,147,483,647)을 넘으면 오버플로가 납니다. 원소가 10억 개를 넘는 배열이면 실제로 일어나는 일입니다.
overflow: low+high=3500000000 > INT_MAX=2147483647
          (int)(low+high)/2  = -397483648      ← 음수 인덱스
          low+(high-low)/2   = 1750000000      ← 올바른 값
low + (high - low) / 2는 수학적으로 같은 값이지만 중간 계산이 범위를 넘지 않습니다. 이 버그는 Java 표준 라이브러리의 이진 탐색에도 오랫동안 있었을 만큼 흔합니다.
2. 예제가 그대로는 컴파일되지 않는다
2021년 예제의 main은 while (true)를 썼는데, C에서 true는 <stdbool.h>를 포함해야 쓸 수 있습니다(C23부터는 키워드). 그대로 컴파일하면 이렇게 됩니다.
$ cc -std=c17 orig.c
orig.c:27:12: error: use of undeclared identifier 'true'
   27 |     while (true) {
또 입력이 끝나도(EOF) scanf의 반환값을 확인하지 않아, 마지막 값으로 같은 결과를 끝없이 출력하는 무한 루프에 빠졌습니다. 고친 예제는 아래와 같습니다.
예제 (고친 버전)
#include <stdio.h>

int BinarySearch(const int dataArr[], int size, int findData);   /* 위의 구현 */

int main(void)
{
    int dataArr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 17, 21, 24, 26, 27, 28};
    int length = sizeof dataArr / sizeof dataArr[0];
    int input;

    while (scanf("%d", &input) == 1) {       /* 입력이 끝나면(EOF) 루프를 빠져나온다 */
        int ret = BinarySearch(dataArr, length, input);
        if (ret != -1) printf("찾으려는 데이터는 %d번째에 있습니다.\n", ret + 1);
        else           printf("데이터를 찾을 수 없습니다.\n");
    }
    return 0;
}
$ printf "28\n4\n7\n17\n99\n" | ./bs
찾으려는 데이터는 21번째에 있습니다.
찾으려는 데이터는 4번째에 있습니다.
찾으려는 데이터는 7번째에 있습니다.
찾으려는 데이터는 16번째에 있습니다.
데이터를 찾을 수 없습니다.
순차 탐색과의 속도 비교 (실측)
1000만 개짜리 정렬 배열(a[i] = i * 2)에서 무작위로 고른 값 1,000개를 찾았습니다. clang -O2로 빌드했습니다.
| 방법 | 1,000번 검색 시간 |
|---|---|
| 순차 탐색 | 1.636초 |
| 이진 탐색 | 0.000089초 (0.089ms) |
약 18,000배 차이입니다. 다만 이진 탐색은 정렬돼 있어야 쓸 수 있으므로, 한 번만 찾을 거라면 정렬 비용(O(n log n))까지 따져야 합니다. 같은 배열에서 여러 번 찾을 때 진가가 나옵니다.
실무에서 쓸 때
- C에서는 표준 라이브러리
bsearch()가 있습니다. 비교 함수만 넘기면 됩니다. - 같은 값이 여러 개 있을 때 "처음 나오는 위치"가 필요하면, 찾은 뒤에도 왼쪽으로 범위를 계속 좁히는 lower bound 방식으로 바꿔야 합니다. 위 구현은 같은 값 중 아무 위치나 돌려줍니다.
- C++은
std::lower_bound/std::binary_search, Python은bisect모듈, C#은Array.BinarySearch를 쓰면 됩니다. 직접 구현은 공부용으로 충분합니다.
자주 묻는 질문
이진 탐색은 최대 몇 번 비교하나요?
원소가 n개일 때 최악의 경우 floor(log2 n) + 1번입니다. 실측하면 500만 개는 23번, 1000만 개는 24번, 70억 개는 33번이었습니다.
mid = (low + high) / 2 가 왜 문제인가요?
low와 high가 크면 둘의 합이 int 범위를 넘어 오버플로가 납니다. low=1,500,000,000, high=2,000,000,000이면 mid가 음수(-397,483,648)가 됩니다. mid = low + (high - low) / 2 로 쓰면 안전합니다.
순차 탐색보다 얼마나 빠른가요?
1000만 개짜리 정렬 배열에서 1,000번 검색했을 때 순차 탐색은 1.636초, 이진 탐색은 0.089밀리초였습니다(Apple M1 Pro, clang -O2).