深さ優先探索(DFS):再帰の限界を実測、閉路検出とトポロジカルソート
再帰DFSと明示的スタックのDFSで訪問順が変わる理由、一直線のグラフでC++とC#の再帰がスタックオーバーフローで落ちるNの実測、3色の閉路検出とトポロジカルソートまで実際の出力で解説する。
2026年11月改訂: この記事は2021年に韓国語で書いたDFSの解説を、日本語向けに書き直したものです。当時の例2つを Apple clang 21(Apple M1 Pro)で
-Wall -Wextraと-fsanitize=address,undefinedを付けてコンパイルし直したところ、どちらも警告なしで元の出力と一致しました。ただし迷路の例は経路がないとき「最短距離: 9」のような誤った値を出し、すべての経路をなめる方式のため7×7の空のグリッドで46.65秒かかりました。図はすべて描き直し、再帰の深さの限界(C++とC#)の実測、閉路検出、トポロジカルソート、再帰と反復DFSの順序の違いを追加しています。
再帰でDFSを書いて、サンプルは通ったのに大きな入力で突然落ちた経験のある人、あるいは再帰をスタックに書き換えたら訪問順が変わってテストが壊れた人に向けた記事です。結論から書くと、再帰DFSは深さおよそ10万〜17万で既定のスタックを使い切り、スタック版で再帰と同じ順序にしたいなら取り出すときに訪問済みにして、隣接頂点を逆順に積む必要があります。
同じグラフでBFSを動かした結果は幅優先探索(BFS)の記事に、スタックというデータ構造そのものはスタックの記事にあります。
再帰DFSと訪問順
DFS(Depth First Search)は、行けるところまで一方向に進み、行き止まったら直前の頂点に戻って別の隣接頂点へ進みます。「戻る場所」を覚えておくのがスタックで、再帰で書けば関数呼び出しのスタックがその役を引き受けます。2021年の記事が「DFSはスタックを使う」と書きながらコードは再帰だったのは、この意味です。
BFSの記事と同じグラフ(頂点8個、辺 1-2, 1-3, 1-4, 2-5, 3-5, 3-6, 4-7, 5-8, 6-8, 7-8)を使い、隣接頂点は番号の小さい順に調べます。BFSでは距離順に 1 2 3 4 5 6 7 8 と広がりましたが、DFSは次のように1本の道を深く潜ります。
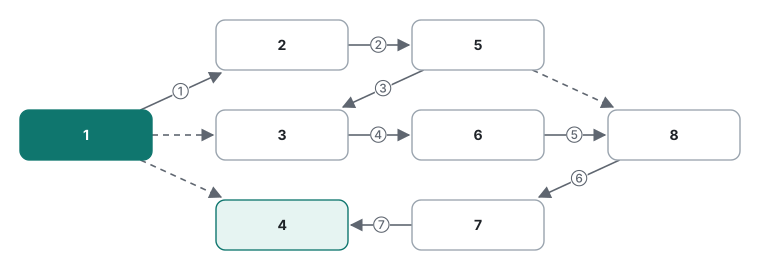
2から5へ進んだあと5の隣の3へさかのぼり、3→6→8→7→4と一度も戻らずに7段潜ります。4は始点1と直接つながっているのに最後に訪問されます。BFSなら距離1だった頂点です。このようにDFSの訪問順は距離と無関係なので、DFSで最短距離を求めるにはすべての経路を調べるしかありません。そのコストは後半で2021年の迷路のコードを使って実測します。
再帰と明示的スタック:順序が変わる理由
再帰を std::stack に置き換える方法はいくつかあり、書き方によって訪問順が変わります。同じグラフで4通り実行しました。
void dfsRec(int v) {
    seen[v] = 1;
    order.push_back(v);
    for (int w : adj[v])
        if (!seen[w]) dfsRec(w);
}

// mark on pop; reverse = push neighbours largest-first so the smallest is on top
void dfsStack(int s, bool reverse) {
    std::stack<int> st;
    st.push(s);
    while (!st.empty()) {
        int v = st.top(); st.pop();
        if (seen[v]) continue;             // already visited via another path
        seen[v] = 1;
        order.push_back(v);
        if (reverse) {
            for (auto it = adj[v].rbegin(); it != adj[v].rend(); ++it)
                if (!seen[*it]) st.push(*it);
        } else {
            for (int w : adj[v]) if (!seen[w]) st.push(w);
        }
    }
}

// BFS code with the queue swapped for a stack (marks on push): NOT a DFS
void stackMarkOnPush(int s) {
    std::stack<int> st;
    st.push(s); seen[s] = 1;
    while (!st.empty()) {
        int v = st.top(); st.pop();
        order.push_back(v);
        for (auto it = adj[v].rbegin(); it != adj[v].rend(); ++it)
            if (!seen[*it]) { seen[*it] = 1; st.push(*it); }
    }
}
実行結果です(-Wall -Wextra -fsanitize=address,undefined、警告なし)。
recursive                          1 2 5 3 6 8 7 4
stack, push in list order          1 4 7 8 6 3 5 2
stack, push in reverse order       1 2 5 3 6 8 7 4
stack, mark on push (not DFS)      1 2 5 8 6 7 3 4
- 隣接頂点をそのまま積むと、最後に積んだ4から出てくるので、番号の大きい隣から調べるDFSになります。DFSとしては正しいものの、再帰とは順序が違います。
- 逆順に積むと一番小さい隣がスタックの一番上に来るので、再帰とまったく同じ順序になります。再帰を反復に書き換えて出力を変えたくない場合はこの方法です。
- BFSのコードのキューをスタックに替えただけのもの(積むときに訪問済みにする)はDFSではありません。6に着いた時点で隣の3はまだ訪問していないので、本当のDFSなら3へ進むはずですが、1を処理したときに「印」が付いているため飛ばされます。隣接頂点をどんな順番にしてもこの順序にはなりません。連結成分を数える程度なら問題ありませんが、閉路検出やトポロジカルソートのように「いつ処理が終わったか」が意味を持つ場面では誤りになります。
まとめると、BFSは積むときに印を付け(BFSの記事で実測)、反復DFSは取り出すときに印を付けます。スタックには同じ頂点が何度も入りうるので、取り出した直後の if (seen[v]) continue; が欠かせません。
再帰の深さの限界:C++とC#が落ちるNを実測
再帰DFSの深さはグラフの形で決まります。最悪なのは頂点が一列につながった一直線のグラフ(0-1-2-…-(N-1))で、深さがNになります。連結リストのような形の木や、迷路の長い一本道が実際にこの形です。Nを増やしながら、どこで落ちるかを二分探索で調べました。
// Path graph 0-1-2-...-(N-1): recursive DFS goes N calls deep.
std::vector<std::vector<int>> adj;
std::vector<char> seen;
int visited = 0;

void dfs(int v) {
    seen[v] = 1;
    visited++;
    for (int w : adj[v])
        if (!seen[w]) dfs(w);
}

int main(int argc, char** argv) {
    int n = std::atoi(argv[1]);
    adj.assign(n, {});
    seen.assign(n, 0);
    for (int i = 0; i + 1 < n; i++) { adj[i].push_back(i + 1); adj[i + 1].push_back(i); }
    dfs(0);   // or dfsIter(0): the explicit-stack version from above
    std::printf("visited %d\n", visited);
}
C#も同じ構造です(dotnet new console、net10.0、C# 14、Release ビルド)。
int n = int.Parse(args[0]);
var adj = new List<int>[n];
for (int i = 0; i < n; i++) adj[i] = new List<int>(2);
for (int i = 0; i + 1 < n; i++) { adj[i].Add(i + 1); adj[i + 1].Add(i); }
var seen = new bool[n];
int visited = 0;

void Dfs(int v)
{
    seen[v] = true;
    visited++;
    foreach (int w in adj[v])
        if (!seen[w]) Dfs(w);
}

Dfs(0);
Console.WriteLine($"visited {visited}");
Apple M1 Pro の macOS で、メインスレッドのスタックは ulimit -s で 8,176KB(約8MB)です。結果は次のとおりです。
| ビルド | 成功した最大のN | 最初に落ちたN | 落ち方 |
|---|---|---|---|
| C++ clang -O0 | 130,702 | 130,703 | SIGSEGV、終了コード139 |
| C++ clang -O2 | 174,273 | 174,274 | SIGSEGV、終了コード139 |
C++ -O2、ulimit -s 65520 |
1,397,603 | 1,397,604 | SIGSEGV |
| C++ ASan ビルド | — | 100,000で既に失敗 | AddressSanitizer: stack-overflow |
| C# .NET 10 Release(既定) | 104,488 | 104,489 | 「Stack overflow.」、終了コード134 |
C# Release、DOTNET_TieredCompilation=0 |
174,192 | 174,193 | 同じ |
| C# 256MBスタックのスレッド | 3,000,000でも成功 | — | — |
| 明示的スタック(C++・C#) | 10,000,000でも成功 | — | — |
境界は環境変数のサイズなどで数個ぶん揺れました(同じ C++ -O2 のバイナリでも、シェルから実行すると174,273、Python の subprocess から実行すると174,264まで成功。C#もビルドや実行ごとに1〜2の差)。おおよそ C++ -O2 で17万、-O0 で13万、C#で10万 と覚えておけば十分です。8MBをNで割ると、呼び出し1回あたり -O2 で約48バイト、-O0 で約64バイト使っている計算です。
C#でN=1,000,000を与えたときの実際の出力です。
Stack overflow.
Repeated 104514 times:
--------------------------------
   at Program+<>c__DisplayClass0_0.<<Main>$>g__Dfs|0(Int32)
--------------------------------
   at Program.<Main>$(System.String[])
C#で押さえておきたい点は2つあります。1つ目は、StackOverflowException は try/catch で捕まえられず、プロセスがそのまま終了することです(Microsoft Learn の StackOverflowException のページにも同じ説明があります)。サーバーなら、深い入力のリクエスト1つでプロセス全体が落ちます。2つ目は、既定の階層型コンパイルではメソッドが最初は最適化されていない Tier 0 のコードで動くことです。深い再帰は最適化版に切り替わる前に底まで潜るので、フレームが大きいまま約10万で落ちたと考えられます。DOTNET_TieredCompilation=0 で最初から最適化すると C++ -O2 とほぼ同じ17万まで届きましたが、この設定に頼るのは解決策ではありません。
対処は3つです。(1) 明示的なスタックに書き換える(いちばん確実で、上の表では1,000万でも成功)。(2) 大きなスタックを持つスレッドで動かす(C#なら new Thread(() => Dfs(0), maxStackSize: 256 * 1024 * 1024)、C++なら ulimit -s やスレッド属性)。(3) 深さが入力サイズに比例しないアルゴリズム(BFSなど)に替える。AtCoderなどのジャッジではスタックサイズを自由に変えられないことが多いので、(1) が安全です。
閉路検出とトポロジカルソート
DFSがBFSよりはっきり有利なのが、有向グラフの閉路検出とトポロジカルソートです。鍵は頂点を3色に分けることです。
- 白(WHITE):まだ訪問していない
- 灰(GRAY):訪問を始めて、いま辿っている再帰の経路上にある
- 黒(BLACK):その頂点から行ける先をすべて処理し終えた
探索中に灰色の頂点へ向かう辺に出会ったら、いまの経路の祖先に戻る辺なので閉路です。そして頂点が黒になった順(帰りがけ順)を逆にするとトポロジカル順になります。ある頂点が終わったということは、その後に来るべき頂点がすべて先に終わっているからです。
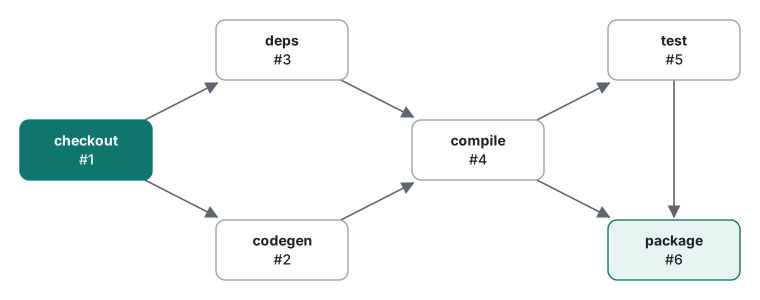
例として小さなビルド手順を使います。矢印は「先に終わらせる」という意味です。
enum Color { WHITE, GRAY, BLACK };   // unvisited / on the current path / finished

bool dfs(int v) {
    color[v] = GRAY;
    for (int w : out[v]) {
        if (color[w] == GRAY) {                // back edge: w is an ancestor of v
            for (int x = v; x != w; x = parent[x]) cycle.push_back(x);
            cycle.push_back(w);
            std::reverse(cycle.begin(), cycle.end());
            return false;
        }
        if (color[w] == WHITE) {
            parent[w] = v;
            if (!dfs(w)) return false;
        }
    }
    color[v] = BLACK;
    post.push_back(v);                         // all dependants are done
    return true;
}
// sort(): call dfs on every WHITE vertex, then print post in reverse
上のグラフで1回、続いて誤って package → deps の辺を足して1回実行しました。
order: checkout codegen deps compile test package
cycle: deps -> compile -> test -> package -> deps
閉路があるとき、親をたどってどの経路が輪になっているかまで出せるのが実務では便利です。ビルドツールやパッケージマネージャーが「circular dependency: A → B → C → A」と教えてくれるのはこの仕組みです。
よくある間違いは、灰と黒を区別せずに「訪問済みなら閉路」と判定することです。条件を color[w] != WHITE に変えて実行したところ、閉路のない最初のグラフでも compile → package の辺を閉路と報告しました。compile から test を経て package がすでに終わって(黒になって)いて、compile → package の辺で再び出会っただけなのにです。無向グラフなら「親以外の訪問済みの隣」で判定できますが、有向グラフでは3色が必須です。
トポロジカルソートは、入次数0の頂点からキューで取り出していく Kahn のアルゴリズム(BFS系)でもできます。再帰の深さが心配な大きなグラフならそちらが安全で、閉路の経路を示したいならDFSが便利です。
2021年のコードの検証:DFSで最短経路を求めると
2021年の記事の例2つをそのままコンパイルした結果です。
- 例1(隣接行列のDFS):
-Wall -Wextraで警告0、元の入力で記事と同じ出力(訪問順 1 2 4 8 5 6 3 7)でした。ただしBFSの記事の例と同じくmap[30][30]なので、頂点番号は29までしか安全に使えません。 - 例2(DFSで迷路の最短距離):警告なしでコンパイルでき、元の入力で記事と同じ「13」が出ました。このときのDFS呼び出しは27回です。問題は2つありました。
1つ目は、ゴールに到達できない迷路で誤った値を出すことです。初期値 min = n * n をそのまま出力するため、真ん中の行がふさがった3×3の迷路を与えると「最短距離: 9」と表示されました。経路がないことを区別するには -1 のような目印が必要です。
2つ目は、すべての経路をなめるので指数的に遅くなることです。訪問済みの印を戻す(map[y][x] = 1)バックトラッキングなので、壁が少ないほど経路の数が爆発します。clang -O2 でビルドし、空の n×n グリッドで呼び出し回数を数えました。
| 空のグリッド | DFS呼び出し回数 | 実行時間 |
|---|---|---|
| 5×5 | 90,111 | 0.01秒未満 |
| 6×6 | 18,470,411 | 0.08秒 |
| 7×7 | 10,966,485,141 | 46.65秒 |
同じ7×7のグリッドをBFSで解けば、49マスを1回ずつキューに入れるだけで終わります。2021年のコードの map[10][10] の上限である10×10まで行くと、現実的な時間では終わりません。最短距離はBFS、DFSは「経路があるか」「すべての場合を数える」「閉路があるか」に使うのが筋です。元の記事の図(グラフ、隣接行列、迷路のマス)は、すべて新しい図と実際の出力に置き換えました。
DFSを選ぶ場面
| やりたいこと | 選ぶもの |
|---|---|
| 最小の移動回数 | BFS |
| 到達できるか、連結成分の数 | DFSでもBFSでも可(深くなるなら反復版) |
| 有向グラフの閉路検出と経路の表示 | 3色のDFS |
| トポロジカルソート | DFSの帰りがけ順、または Kahn(キュー) |
| すべての経路・組み合わせの列挙(バックトラッキング) | 再帰DFS |
| 深さが10万を超えうる | 明示的スタックを使うDFS |
再帰DFSは短く読みやすい反面、入力サイズに比例する深さを許した時点で、上の表の数字(10万〜17万)が上限になります。小さなテスト入力では表に出ないので、グラフの大きさが10万を超えうるなら最初から反復版で書いておくほうが無難です。
よくある質問
再帰DFSは頂点数がどれくらいでスタックオーバーフローする?
一直線のグラフ(0-1-2-…)で実測すると、メインスレッドのスタックが8MBのmacOS(Apple M1 Pro)で、C++ -O0は約130,700、-O2は約174,270でセグメンテーション違反になりました。C#(.NET 10、Release)は約104,490で「Stack overflow.」と出てプロセスが終了しました。明示的なスタックなら両言語とも1,000万頂点でも問題ありませんでした。
再帰のDFSとスタックで書き直したDFSで訪問順が違うのはなぜ?
スタックは最後に積んだ隣接頂点から取り出すからです。隣接頂点をそのまま積むと 1 4 7 8 6 3 5 2、逆順に積むと再帰と同じ 1 2 5 3 6 8 7 4 になりました。積むときに訪問済みにすると 1 2 5 8 6 7 3 4 となり、DFSの順序ではなくなります。
有向グラフの閉路は訪問済み配列1つで検出できる?
できません。処理が終わった頂点(黒)と、いま辿っている経路上の頂点(灰)を区別する必要があります。訪問済みかどうかだけで判定すると、閉路のないビルド手順のグラフでも compile → package の辺を閉路と誤判定しました。