二分探索木(BST):2021年のCコードのバグと整列済み入力の罠
二分探索木の探索・挿入・削除(子が2つのノードを含む)を clang と ASan で再検証して2021年のコードのバグを修正し、整列済みの入力でリストと化した木の検索時間も実測しました。
2026年11月改訂: 2021年に韓国語で公開した記事の C のサンプルを Apple clang 21 でビルドし直しました。C としてはコンパイルできず(エラー2件)、C++ としてコンパイルすると警告2件、実行すると木にない値を「見つけた」と表示しました。さらに AddressSanitizer は、根を削除した瞬間の 解放済みメモリの読み出し(heap-use-after-free)を検出しました。原因は探索関数の
return抜けと、削除関数の戻り値を捨てていたmainです。一方で肝心の「子が2つあるノードの削除」のロジックは正しいものでした。修正したコードと実際の出力、そして整列済みの入力で木がリストになる現象の実測を加えました。
この記事は、二分探索木(BST)を自分で実装している人、特に削除でつまずいた人に向けたものです。結論から書くと、BST は「左は小さく、右は大きい」という1つの規則だけで、探索・挿入・削除を木の高さに比例する時間で行います。問題はその高さが挿入の順番しだいで log n にも n にもなることです。整列済みのキー5万個を入れたら検索は約900倍遅くなりました。だから実務では自作の BST ではなく、赤黒木である std::map や C# の SortedDictionary を使います。
BST の規則と探索
二分探索木は二分木に順序の規則を1つ加えたものです。どのノードでも、左部分木のキーはそのノードより小さく、右部分木のキーは大きい。 整列済み配列で真ん中と比べて半分を捨てる二分探索を、配列ではなく木の形で持っていると考えると分かりやすいでしょう。その代わり、配列と違って途中への挿入や削除で要素をずらす必要がありません。
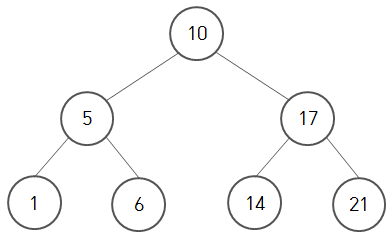
この木(10, 5, 1, 6, 17, 14, 21 の順に挿入)で14を探すと、10より大きいので右へ、17より小さいので左へ進み、14に出会います。16を探すと同じ道を14まで進み、14より大きいので右へ行こうとして NULL に当たり「見つからない」となります。比較回数は最大でも高さ+1回です。
2021年の探索関数は、再帰呼び出しの前に return が抜けていました。
    else if (Tree->Data > findData)
        searchNode(Tree->Left, findData);   // 結果を捨てている
    else
        searchNode(Tree->Right, findData);  // 結果を捨てている
}                                           // 値を返さずに関数が終わる
clang は警告を出し、
warning: non-void function does not return a value in all control paths [-Wreturn-type]
その警告はそのまま誤動作につながりました。-O0 でビルドして木にない16を入力すると、プログラムは「見つけた」と表示したあと、削除関数で「見つからない」と表示する矛盾した出力になりました。値を返さなかった関数の戻り値レジスタに残っていたゴミを、NULL でないポインタとして読んだためです。
해당 노드를 찾았습니다! 노드를 제거합니다. 노드의 위치는 0xf5578058 입니다.
해당하는 노드를 찾을 수 없습니다.
현재 트리 출력: 1 5 6 10 14 17 21
(メッセージは韓国語で、「ノードを見つけました!削除します。ノードの位置は0xf5578058です」「該当するノードが見つかりません」「現在の木:…」という意味です。)同じソースを C として -O2 でビルドすると、たまたま「見つかりませんでした」と正しく表示されました。最適化レベルで結果が変わる、典型的な未定義動作です。C++ としてビルドし UBSan を有効にすると、最初の検索ですぐに止まります。
algorithm-binary-search-tree-0.c:19:7: runtime error: execution reached the end of a value-returning function without returning a value
修正版の探索は再帰をやめてループにしました。木がどれだけ深くてもスタックを使いません。
Node* search(Node* t, int key) {
    while (t && t->data != key)
        t = key < t->data ? t->left : t->right;
    return t;
}
2021年のコードで出たエラーと警告の全部
現在のコンパイラ(Apple clang 21、-Wall -Wextra)が報告したものをまとめます。
- C としてはコンパイルエラー。
typedef struct Node { Node* Left; ... } Node;の構造体の中では、Nodeはまだ typedef されていないので C では使えません。C++ なら通るので、2021年は C++ コンパイラでビルドしていたと考えられます。
algorithm-binary-search-tree-0.c:5:5: error: must use 'struct' tag to refer to type 'Node'
    5 |     Node* Left;
      |     ^
      |     struct
-Wreturn-type:上で見た探索関数のreturn抜け。-Wformat:ノードのアドレスを%#xで表示していました。64ビット環境のポインタは8バイトなのでunsigned intとして表示すると値が正しくありません。実際、どのノードを見つけても毎回同じ0xf5578058が表示されました。ポインタは%pで表示します。今回の版ではアドレスの表示自体をやめました。
warning: format specifies type 'unsigned int' but the argument has type 'Node *' (aka 'struct Node *') [-Wformat]
- 終わらない入力ループ。
while(1) { scanf(...); }は入力が終わっても(EOF)最後の値を持ったまま回り続けます。4つ入力したあとは、最後の17を延々と処理し直していました。while (scanf("%d", &key) == 1)に変えました。
挿入と削除、そして use-after-free
挿入は探索と同じ道をたどり、空いた位置に新しいノードをつなぎます。2021年の insertNode は木が空(根が NULL)だと NULL を参照して落ちる作りで、すでにあるキーを入れると新しいノードをつなぎも解放もしませんでした。小さなテストで leaks --atExit がそのノードを ROOT LEAK として報告しました。新しい insert は根を返すので空の木でも動き、重複キーではノードを作りません。
削除は3つの場合に分かれます。
- 子が0個:ノードを解放し、親には NULL を返す。
- 子が1個:ノードを解放し、その子を親に返す。子が1段上がる。
- 子が2個:右部分木の最小値(中順の後続ノード)をノードにコピーし、右部分木からその後続ノードを削除する。後続ノードには左の子がないので、上の簡単な場合になる。
2021年の removeNode はこれを正しく実装していました。64個のキーに対してランダムな挿入・削除100回を5,000ラウンド(計50万回)行い、毎回 BST の順序と要素数を検査したところ、呼び出し側が戻り値を受け取る限りすべて通過しました。問題は呼び出し側でした。2021年の main は removeNode(Tree, input); と書いて戻り値を捨てていました。根に子が1つしか残っていない状態で根を削除すると、関数の中では根を解放して子を新しい根として返しますが、main の Tree は解放済みのメモリを指したままです。1、5、6、10の順に削除すると ASan が検出しました。
==63477==ERROR: AddressSanitizer: heap-use-after-free on address 0x603000001c30 at pc 0x00010051a828 bp 0x00016f8e62e0 sp 0x00016f8e62d8
READ of size 8 at 0x603000001c30 thread T0
    #0 0x00010051a824 in printTree bst-min.c:79
    #1 0x00010051ac38 in main bst-min.c:105

freed by thread T0 here:
    #0 0x000100ea5368 in free+0x7c (libclang_rt.asan_osx_dynamic.dylib:arm64e+0x41368)
    #1 0x00010051a72c in removeNode bst-min.c:70
    #2 0x00010051ac24 in main bst-min.c:103
ASan なしで動かすと、解放されたメモリにまだ古い内容が残っていてそれらしい結果が出ることがあり、かえって危険です。修正したプログラム全体です。
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    struct Node* left;          /* 2021: Node* left;  -> error in C */
    struct Node* right;
    int data;
} Node;

static Node* create_node(int data) {
    Node* n = malloc(sizeof *n);
    if (!n) { perror("malloc"); exit(1); }
    n->left = n->right = NULL;
    n->data = data;
    return n;
}

Node* search(Node* t, int key) {
    while (t && t->data != key)                     /* 2021: recursive call without return */
        t = key < t->data ? t->left : t->right;
    return t;
}

Node* insert(Node* t, int data) {                   /* returns the (possibly new) root */
    if (t == NULL) return create_node(data);
    if (data < t->data)      t->left  = insert(t->left, data);
    else if (data > t->data) t->right = insert(t->right, data);
    /* equal: already present, nothing allocated */
    return t;
}

static Node* find_min(Node* t) {
    while (t && t->left) t = t->left;
    return t;
}

Node* remove_node(Node* t, int data) {              /* returns the new root of this subtree */
    if (t == NULL) return NULL;                     /* not found */
    if (data < t->data)      t->left  = remove_node(t->left, data);
    else if (data > t->data) t->right = remove_node(t->right, data);
    else if (t->left && t->right) {                 /* two children */
        Node* succ = find_min(t->right);            /* in-order successor */
        t->data = succ->data;
        t->right = remove_node(t->right, succ->data);
    } else {                                        /* zero or one child */
        Node* child = t->left ? t->left : t->right;
        free(t);
        return child;
    }
    return t;
}

void print_inorder(const Node* t) {
    if (!t) return;
    print_inorder(t->left);
    printf("%d ", t->data);
    print_inorder(t->right);
}

void free_tree(Node* t) {
    if (!t) return;
    free_tree(t->left);
    free_tree(t->right);
    free(t);
}

int main(void) {
    Node* root = NULL;
    int init[] = {10, 5, 1, 6, 17, 14, 21};
    for (size_t i = 0; i < sizeof init / sizeof init[0]; ++i) root = insert(root, init[i]);

    int key;
    while (scanf("%d", &key) == 1) {                /* 2021: while(1) -> endless loop at EOF */
        if (search(root, key)) {
            root = remove_node(root, key);          /* 2021: return value ignored */
            printf("removed %d: ", key);
        } else {
            printf("%d not found: ", key);
        }
        print_inorder(root);
        printf("\n");
    }
    free_tree(root);
    return 0;
}
-Wall -Wextra で警告0件、ASan・UBSan ビルドでもエラー0件でした。子が2つある根から削除する入力 10 6 5 14 17 16 10 1 21 の実際の出力です。
removed 10: 1 5 6 14 17 21
removed 6: 1 5 14 17 21
removed 5: 1 14 17 21
removed 14: 1 17 21
removed 17: 1 21
16 not found: 1 21
10 not found: 1 21
removed 1: 21
removed 21:
1行目で根の10が削除され、右部分木の最小値14がその位置を引き継ぎました。最後に木が空になっても問題なく終了します。macOS の ASan にはリーク検出がない(detect_leaks is not supported on this platform)ため leaks --atExit で確認し、0 leaks for 0 total leaked bytes でした。
整列済みの入力:木がリストになるとき(実測)
BST の操作はすべて O(高さ) です。ランダムな順で入れれば高さの期待値は O(log n) ですが、整列済みの順で入れると新しいキーが毎回右端にだけつながり、退化木、つまり連結リストになります。キー0〜49,999を2通りの順で入れ、同じ5万個のキーをランダムな順で検索しました(Apple clang 21 -O2、Apple M1 Pro、2回実行の2回目。挿入はループ版)。
| 木 | 挿入順 | 高さ | 構築 | 5万回の検索 |
|---|---|---|---|---|
| 自作 BST | シャッフル | 38 | 3.92 ms | 4.10 ms |
| 自作 BST | 整列済み | 50,000 | 3,733.86 ms | 3,691.03 ms |
std::set(赤黒木) |
整列済み | — | 3.82 ms | 6.05 ms |
同じデータで入れる順番を変えただけで、検索が約900倍遅くなりました。高さ38は log2(50,000) ≈ 15.6 の約2.4倍で、ランダムに作った BST としては普通の値です。整列済みのほうは、1回の検索が平均2万5千回のポインタたどりになります。
実データは思った以上によく整列しています。自動採番の ID、タイムスタンプ、キー順に出力された CSV などです。そして高さが n になると問題は速度だけではありません。上の再帰版 insert や free_tree も高さの分だけスタックを使うので、木構造の記事で測ったとおり、数十万段でスタックオーバーフローを起こして落ちます。この計測でループ版の挿入を使ったのはそのためです。
実務での答え:平衡二分探索木
挿入や削除のたびに回転を行って高さを O(log n) に保つ木を、平衡二分探索木と呼びます。自分で実装する場面はほとんどなく、標準ライブラリを使えば済みます。
- C++:
std::mapとstd::set。規格が求める O(log n) を満たすため、libc++ も libstdc++ も赤黒木で実装しています。上の表のとおり、整列済みの入力でも検索は6.05msでした。 - C#:
SortedDictionary<TKey, TValue>とSortedSet<T>。.NET 10 でリフレクションを使って中を見ると、SortedDictionaryの内部フィールド_setはSortedSetを継承したTreeSet型で、ノードにはBlack/Redの値を持つNodeColorプロパティがありました。つまり赤黒木です。整列済みのキー50,000個の挿入に43.51ms、5万回のContainsKeyに16.09msでした(Release、ウォームアップ後)。
使い分けの目安です。
| 必要なこと | 選ぶもの |
|---|---|
| キーで引くだけ | ハッシュテーブル(std::unordered_map、Dictionary) |
| 整列順の走査、範囲検索、最小・最大 | 平衡 BST(std::map、SortedDictionary) |
| 最小のものを次々に取り出す | ヒープ(std::priority_queue、PriorityQueue) |
| データが固定で検索だけ | 整列済み配列+二分探索 |
自作の BST はアルゴリズムの学習や面接の題材としては最適ですが、挿入順を制御できない本番のコードには入れないほうが安全です。
まとめ
- BST の規則:左 < ノード < 右。探索・挿入・削除はすべて O(高さ)。
- 子が2つあるノードは、右部分木の最小値をコピーしてそちらを削除します。2021年のコードのこのロジックは50万回のランダム検証を通過しました。
- 2021年のコードの実際のバグ:C でのコンパイルエラー、探索の
return抜け(ない値を「見つけた」)、%#xによるポインタ表示、戻り値を捨てるmain(heap-use-after-free)、EOF での無限ループ。すべて修正しました。 - 整列済みのキー5万個で作った BST は高さ50,000で、検索が約900倍遅くなりました。実務では赤黒木の
std::mapやSortedDictionaryを使います。
よくある質問
子が2つあるノードはどう削除しますか?
右部分木の最小値(中順の後続ノード)を探してその値を削除対象のノードにコピーし、右部分木からその後続ノードを削除します。後続ノードには左の子がないので、子が0個か1個の簡単な場合に帰着します。2021年のコードのこの部分は正しく、ランダムな挿入・削除50万回の検証を通過しました。
整列済みのデータを入れるとどれくらい遅くなりますか?
キー50,000個をシャッフルして入れると高さ38で、5万回の検索が4.1msでした。0から順に入れると高さ50,000のリストになり、同じ検索に3,691ms、約900倍かかりました(Apple M1 Pro、clang -O2)。
実務では何を使えばいいですか?
自動で平衡を保つ木を使います。C++ の std::map と std::set、C# の SortedDictionary と SortedSet はどれも赤黒木です。整列済みのキー50,000個で作った std::set でも、5万回の検索は6.1msでした。