ヒープ:sift-up/down、O(n)構築の実測、PriorityQueue
最小ヒープの挿入と取り出し(sift-up/down)、配列での表現、n回挿入とO(n)構築の比較回数の実測、ヒープソートの速度、C# PriorityQueue が安定でない点と C++ priority_queue まで。
2026年11月改訂: 2021年に韓国語で公開した記事の最小ヒープ(C++)を、Apple clang 21 で
-Wall -Wextraと-fsanitize=address,undefined -gの両方でビルドし直しました。警告は1件(-Wnull-conversion)で、同じ入力に対する出力は2021年と同じでした。さらにランダムな挿入・取り出し40万回をstd::priority_queueと突き合わせたところすべて一致し、ヒープのロジック自体は正しいことを確認しました。残っていた問題は2つです。ヒープオブジェクトをコピーすると同じメモリを二重解放すること(ASan が double-free として検出)と、最小値を取り出す関数がその値を返さないことです。どちらも直したうえで、2021年の記事が「あとで調べてみて」と流していたヒープソートと O(n) のヒープ構築を、実測付きで補いました。
この記事は、優先度付きキューの中で何が起きているかを知りたい人と、「ヒープは1つずつ push して作ればいいのでは?」と考えたことがある人に向けたものです。先に結論を書くと、二分ヒープは配列1本に収めた完全二分木で、挿入は sift-up 1回、最小値の取り出しは sift-down 1回で、どちらも O(log n) です。データが最初からそろっているなら一括構築(heapify)のほうが悪くなることはなく、不利な入力では比較回数が10分の1以下でした。実務では自作より C# の PriorityQueue<TElement, TPriority> や C++ の std::priority_queue を使うことになりますが、両者は既定の向きが逆で、C# 版は安定でない点に注意が必要です。
ヒープとは:形の規則と順序の規則
二分ヒープは次の2つを同時に満たす二分木です。
- 形の規則:完全二分木であること。最後の段以外はすべて埋まり、最後の段は左から詰めます。
- 順序の規則:最小ヒープなら、どの親も子以下。最大ヒープなら子以上。
2021年の記事は「親は常に子より小さい」と書いていましたが、同じ値が複数入ることがあるので「以下」が正確です。(「Max Heep」などの綴りの誤りも直しました。)
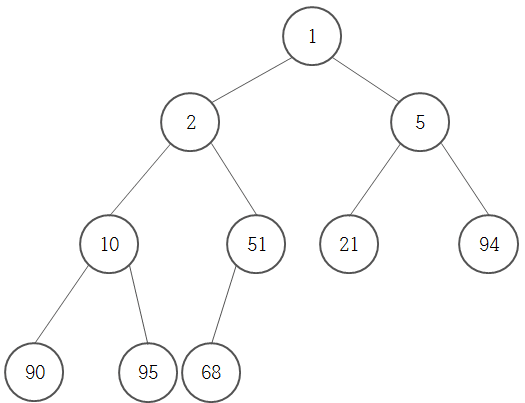
この最小ヒープでは根の1が全体の最小値です。順序の規則は親子の間にしか適用されないので、兄弟やいとこの間には順序がありません。左の枝の51が右の枝の21より大きくても問題ありません。ここが二分探索木との大きな違いです。ヒープは「いちばん小さいもの」をすぐ取り出せますが、任意の値を探す用途には向きません。
配列による表現
完全二分木には穴がないので、段ごとに配列へ並べれば無駄がなく、ポインタも不要です。
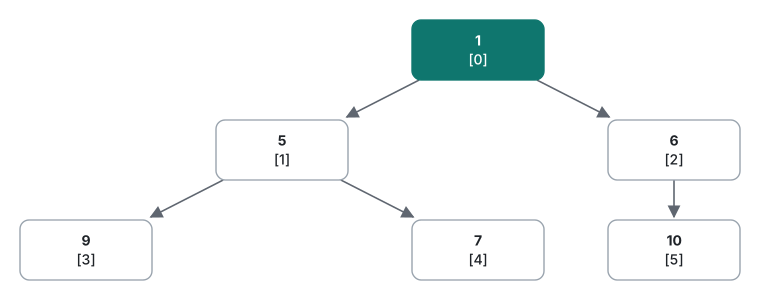
インデックス i の親は (i - 1) / 2、左の子は 2i + 1、右の子は 2i + 2 です。深さ d のノードは配列の 2^d − 1 から 2^(d+1) − 2 番に入ります(2021年の記事のこの式は正しいものでした)。
挿入(sift-up)と最小値の取り出し(sift-down)
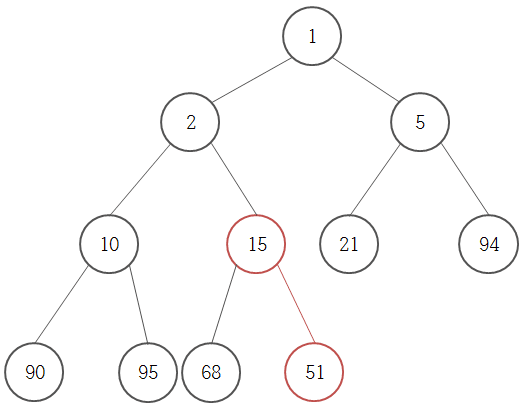
挿入:新しい値を配列の末尾(木の次の空き位置)に置き、親より小さい間は親と入れ替えながら上へ移動させます。上のヒープに15を入れると、51の右の子の位置に置かれて51と入れ替わり、新しい親の2より大きいので止まります。
最小値の取り出し:根を取り出し、最後の要素を根の位置へ移してから、2つの子のうち小さいほうと比べ、子のほうが小さければ入れ替えながら下へ移動させます。元のヒープから1を取り出すと、最後の68が根に来ます。
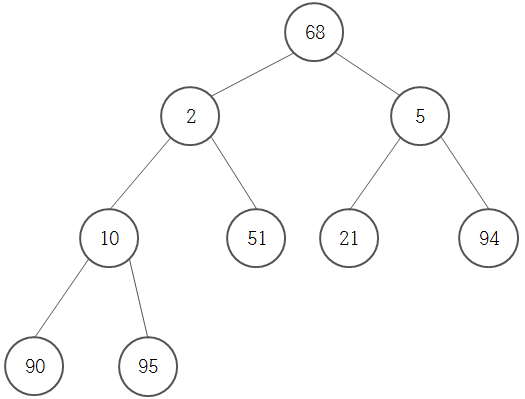
68は2と5のうち小さい2と、次に10と51のうち小さい10と入れ替わり、子の90と95より小さくなったので止まります。
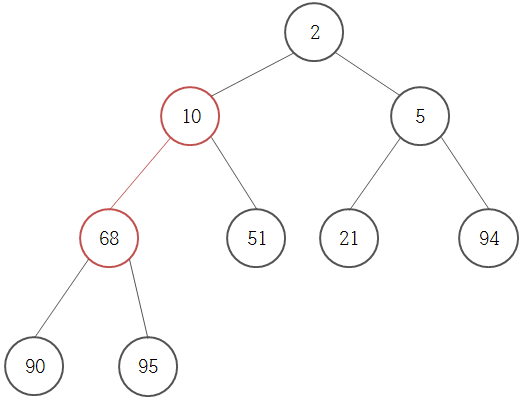
どちらの操作も根から葉への1本の経路を動くだけなので O(log n) です。2021年のコードは生の int* 上で Insert と extractMin として実装していました。以下は同じアルゴリズムを std::vector で書き直したものです。
#include <cstdio>
#include <utility>
#include <vector>

class MinHeap {
public:
    void push(int v) { a.push_back(v); sift_up(a.size() - 1); }
    bool empty() const { return a.empty(); }
    int top() const { return a[0]; }
    int pop() {                                 // returns the minimum (2021: void extractMin)
        int min = a[0];
        a[0] = a.back();
        a.pop_back();
        if (!a.empty()) sift_down(0, a.size());
        return min;
    }
    void print() const { for (int x : a) std::printf("%d ", x); std::printf("\n"); }
private:
    std::vector<int> a;
    void sift_up(size_t i) {
        while (i > 0 && a[i] < a[(i - 1) / 2]) {
            std::swap(a[i], a[(i - 1) / 2]);
            i = (i - 1) / 2;
        }
    }
    void sift_down(size_t i, size_t n) {
        for (;;) {
            size_t l = 2 * i + 1, r = l + 1, m = i;
            if (l < n && a[l] < a[m]) m = l;
            if (r < n && a[r] < a[m]) m = r;
            if (m == i) return;
            std::swap(a[i], a[m]);
            i = m;
        }
    }
};

int main() {
    MinHeap h;
    for (int x : {1, 7, 10, 9, 5, 6}) h.push(x);
    h.print();
    for (int k = 0; k < 3; ++k) { int m = h.pop(); std::printf("pop %d -> ", m); h.print(); }
}
1 5 6 9 7 10
pop 1 -> 5 7 6 9 10
pop 5 -> 6 7 10 9
pop 6 -> 7 9 10
同じ入力(1 7 10 9 5 6)で2021年のプログラムが出力した配列の状態と、1行ずつ一致します。
2021年のコードで実際に出た警告とバグ
警告1件。 上書きする直前に根を「空にする」ための1行です。
data-structure-heap-0.cpp:55:15: warning: implicit conversion of NULL constant to 'int' [-Wnull-conversion]
   55 |     heap[0] = NULL;
      |             ~ ^~~~
      |               0
NULL はヌルポインタ定数で整数値ではありません。しかも次の行でその位置は上書きされるので、この行は消しても動作は変わりません。
コピーで二重解放。 2021年の Heap クラスはコンストラクタで new int[]、デストラクタで delete[] をしていましたが、コピーコンストラクタとコピー代入を定義していませんでした(いわゆる3の規則の違反)。サンプルの main はコピーしないので表に出ませんでしたが、Heap b = a; を1行足すだけで ASan が検出しました。
==64767==ERROR: AddressSanitizer: attempting double-free on 0x603000001c30 in thread T0:
    #0 0x000100e9c644 in _ZdaPv+0x74 (libclang_rt.asan_osx_dynamic.dylib:arm64e+0x50644)
    #1 0x000100518c10 in Heap::~Heap() old_heap.inc:25
MinHeap のようにメモリを std::vector に任せれば、コピー・ムーブ・解放は追加のコードなしで正しく動きます。
値を返さない extractMin。 extractMin() は void だったので、取り出した最小値を呼び出し側が受け取れませんでした。優先度付きキューとして使うには値が必要なので、pop() が値を返すようにしました。
メモリリークについて:macOS の AddressSanitizer には LeakSanitizer が含まれない(detect_leaks is not supported on this platform)ため、leaks --atExit で別途確認しました。2021年版も新しい版も 0 leaks でした。
ヒープを O(n) で一括構築する(実測)
要素が最初からそろっている場合、ヒープの作り方は2つあります。
- n回挿入:1つずつ push。最悪の場合はどの要素も根まで上がるので O(n log n)。
- Floyd のボトムアップ構築:配列はそのままに、最後の親
n/2 − 1から0番まで逆順にsift_downを呼ぶ。大半のノードは下のほうにあってほとんど動かないので、全体で O(n)。
static void build_floyd(std::vector<int>& v) {      // O(n): sift down from the last parent
    for (size_t i = v.size() / 2; i-- > 0;) sift_down(v, i, v.size());
}
int 1,000万個で比較回数と時間を測りました(Apple clang 21 -O2、Apple M1 Pro、5回中の最小値)。自作関数には比較回数のカウンタが入っている分だけ時間がかかっています。std::make_heap にはカウンタはありません。
| 入力 | 方法 | 比較回数 | 時間 |
|---|---|---|---|
| ランダム | n回挿入 | 22,806,170 | 82.32 ms |
| ランダム | Floyd | 18,811,948 | 70.33 ms |
| ランダム | std::make_heap |
— | 35.08 ms |
| 降順 | n回挿入 | 213,222,809 | 108.17 ms |
| 降順 | Floyd | 19,999,970 | 40.79 ms |
| 降順 | std::make_heap |
— | 12.89 ms |
意外だったのは、ランダム入力では n回挿入でも1要素あたり約2.3回しか比較しなかったことです。ランダムな値はたいてい下から1〜2段上がったところで落ち着くので、O(n log n) は最悪の場合の話でした。ただし最悪の場合は簡単に起きます。最小ヒープに降順のデータを入れると新しい値が毎回根まで上がり、比較は10.7倍に増えました。Floyd 方式は入力順に関係なく約2n回でした。時間の差(2.7倍)が比較回数の差より小さいのは、sift-up が毎回通る上のほうの段がキャッシュに残っているためと思われます(未計測の推測です)。実務での結論は単純で、データが手元にあるなら一括で構築します。悪くなることはなく、実データはすでに整列済みかそれに近いことがよくあります。C# の要素コレクションを受け取る PriorityQueue コンストラクタと、イテレータ範囲を受け取る C++ の std::priority_queue コンストラクタは、どちらもこの方式で構築します。
ヒープソートと実測
ヒープを作ったら、根を未整列範囲の末尾と入れ替え、範囲を1つ縮めて sift-down、を繰り返します。追加メモリなしでその場で整列でき、最小ヒープなら降順、最大ヒープなら昇順になります。
static void heapsort_desc(std::vector<int>& v) {    // min-heap -> descending order in place
    build_floyd(v);
    for (size_t end = v.size(); end > 1; --end) { std::swap(v[0], v[end - 1]); sift_down(v, 0, end - 1); }
}
ランダムな int 1,000万個の整列時間です(同じ環境、5回中の最小値)。
| 方法 | 時間 |
|---|---|
上の heapsort_desc(比較カウンタ入り) |
3,485 ms |
std::make_heap + std::sort_heap |
1,621 ms |
std::sort |
234 ms |
ヒープソートは最悪でも O(n log n) で追加メモリも要りませんが、毎回配列の離れた位置を行き来するためキャッシュ効率が悪く、ライブラリ版でも std::sort より7倍近く遅くなりました。libc++ の std::sort はイントロソートで、クイックソートの再帰が深くなりすぎたときの保険としてだけヒープソートに切り替えます。クイックソートなど他の整列は整列アルゴリズムの記事で比べています。ヒープが本当に役立つのは全体の整列ではなく、「次々に変わるデータから最小のものを取り出す」ことと「上位 k 個だけを保つ」ことです。
いま使うヒープ:PriorityQueue と std::priority_queue
C++ の std::priority_queue は既定で最大ヒープです。最小ヒープにするには比較子を std::greater にします。
std::vector<int> in{1, 7, 10, 9, 5, 6};
std::priority_queue<int> maxq(in.begin(), in.end());            // max-heap by default, built in O(n)
std::priority_queue<int, std::vector<int>, std::greater<int>> minq(in.begin(), in.end());
max: 10 9 7 6 5 1
min: 1 5 6 7 9 10
C# の PriorityQueue<TElement, TPriority> は .NET 6 で追加され、Microsoft Learn では配列ベースの4分木(quaternary)の最小ヒープと説明されています。要素と優先度を別々に持つのが特徴で、安定ではありません。同じ優先度の要素が入れた順に出てくる保証はありません。.NET 10.0.14 で確認しました。
var pq = new PriorityQueue<string, int>();
string[] jobs = ["a", "b", "c", "d", "e", "f", "g", "h"];
foreach (var j in jobs) pq.Enqueue(j, 1);           // all the same priority
pq.Enqueue("urgent", 0);
while (pq.TryDequeue(out var job, out var pri)) Console.Write($"{job}({pri}) ");

// make it FIFO among equal priorities: add an insertion counter
var fifo = new PriorityQueue<string, (int Priority, long Seq)>();
long seq = 0;
foreach (var j in jobs) fifo.Enqueue(j, (1, seq++));
fifo.Enqueue("urgent", (0, seq++));
same priority, unstable: urgent(0) b(1) h(1) g(1) f(1) e(1) d(1) c(1) a(1)
with sequence number:    urgent a b c d e f g h
a から h の順に入れたのに、b、h、g、f…a の順で出てきました。ジョブキューのように「同じ優先度なら先着順」が必要なら、上のように(優先度, 通し番号)のタプルを優先度にします。タプルは先頭の項目から比べるので、同じ優先度なら通し番号の順になります。
ほかにも実務で使えるメンバーを .NET 10 で確かめました。
- 最大ヒープ:
new PriorityQueue<int, int>(Comparer<int>.Create((x, y) => y.CompareTo(x)))で10 9 7 6 5 1。 - 上位 k 個の保持:サイズ k の最小ヒープに
EnqueueDequeue(x, x)。追加して最小値を取り出す処理を sift 1回で済ませます。42, 7, 99, 13, 58, 3, 77, 21 の上位3個は 58, 77, 99 でした。 - 一括構築:
new PriorityQueue<int, int>([(5, 5), (1, 1), (3, 3)])でPeek()は1。 - 任意の要素の削除:
Remove(3, out _, out _)がTrueを返しました。線形探索なので O(n) です。 UnorderedItemsは名前のとおりヒープ配列の順で、整列されていません。
まとめ
- 二分ヒープ=完全二分木+親 ≤ 子(最小ヒープ)。配列1本で表し、親は
(i-1)/2、子は2i+1と2i+2。 - 2021年のヒープのロジックは40万回のランダム検証をすべて通過しました。
NULLを int に入れる警告、コピー時の二重解放、値を返さないextractMinを直しました。 - データがそろっているなら n回挿入ではなく O(n) の heapify を使います。降順の1,000万個では比較が2億1,322万回から2,000万回に減りました。
- ヒープソートは最悪でも O(n log n) ですが、実測では
std::sortより7倍近く遅くなりました。 - C# の
PriorityQueueは最小ヒープで安定ではなく、C++ のstd::priority_queueは既定が最大ヒープです。
よくある質問
ヒープは1つずつ挿入して作るのと一括で作るのとでどれくらい違いますか?
int 1,000万個で測ると、ランダム入力では n回挿入が約2,281万回、ボトムアップの Floyd 方式が約1,881万回の比較で、差は小さめでした。しかし最小ヒープに降順の入力を入れると、n回挿入は約2億1,322万回と10倍以上に増え、Floyd 方式は2,000万回のままでした(Apple M1 Pro、clang -O2)。
C# の PriorityQueue は同じ優先度の要素を入れた順に返しますか?
返しません(安定ではありません)。優先度1で a〜h の8個を入れて取り出すと、.NET 10.0.14 では b h g f e d c a の順でした。入れた順が必要なら(優先度, 通し番号)のタプルを優先度にします。
C++ の std::priority_queue は最小ヒープですか、最大ヒープですか?
既定は最大ヒープです。最小ヒープにするには std::priority_queue<int, std::vector<int>, std::greater<int>> のように比較子を std::greater にします。C# の PriorityQueue は逆で、既定が最小ヒープです。