PHP 8.5 の OPcache・JIT・プロファイリングを実測:何が本当に速くなるか
CLI では OPcache でかえって遅くなり、サーバーのリクエストは 35 倍速に。JIT は計算で 4.5 倍、文字列処理で 8%。900 倍遅い文字列連結とジェネレーターのメモリも実測。
シリーズ:PHP 講座 6/6(上級)。 PHP のコードは動いていて、次は時間とメモリがどこに消えているかを知りたい方向けです。読み終えると、OPcache と JIT を効く場所でだけ有効にし(効かない場所もわかり)、プロファイラーを入れずに hrtime で計測し、PHP が実際に実行する opcode を読み、必要以上に 100 倍コストのかかるループの書き方を見分けられるようになります。
「PHP のページが遅い」と言うと真っ先に「JIT を有効にしてみたら」と返ってくるチームなら、この記事が役に立ちます。私たちの計測では JIT は純粋な計算で 4.5 倍、よくある Web 処理で 8% でしたが、文字列を組み立てる 1 行を直しただけで約 900 倍になりました。レンタルサーバーのように php.ini を自由に変えられない環境ほど、コード側の改善が効きます。数値はすべて下記の環境で測ったもので、計測にだまされた例(ファイルが新しすぎて OPcache なしで動いたベンチマーク)もそのまま載せています。
実行環境: PHP 8.5.6 CLI(NTS)+ Zend OPcache、Apple Silicon Mac(M1 Pro)、macOS、memory_limit=128M。xdebug・SPX・xhprof・Blackfire は入っておらず、この記事でも何もインストールしません。時間はすべて hrtime() で測り、中央値には実行回数を添えました。出力中のパスは ~/demo/ に短縮しています。
拡張なしのプロファイリング:hrtime と「何を測っているか」の確認
hrtime(true) は単調増加するナノ秒カウンターを整数で返します。microtime(true) と違い、システム時計を合わせても跳ばず、浮動小数点の丸めもありません。この記事のプロセス内ベンチマークはすべてこの関数で動かしました。
<?php
// one warm-up call, then the median of 5 rounds
function bench(string $name, callable $fn, int $rounds = 5): void {
    $fn();                                            // warm-up round, discarded
    $t = [];
    for ($r = 0; $r < $rounds; $r++) { $s = hrtime(true); $res = $fn(); $t[] = (hrtime(true) - $s) / 1e6; }
    sort($t);
    printf("%-34s %8.2f ms   (%s)\n", $name, $t[intdiv($rounds, 2)], is_scalar($res) ? $res : count($res));
}
結果の値も表示します。2 つのやり方で結果が違えば、違う仕事を比べていることになるからです。本物のプロファイラー(xdebug のプロファイラー、SPX、Blackfire)ならどの関数が遅いかを推測なしで見せてくれます。ここにはないので、やり方はこうです。リクエスト全体を測り、怪しい箇所の周りを hrtime で囲んで半分ずつ絞り込みます。
PHP には、実際に何を実行しているかを見る手段も入っています。opcache.opt_debug_level は最適化前(0x10000)と後(0x20000)の opcode を出力します。
function f(array $a): int {
    $n = 0;
    for ($i = 0; $i < count($a); $i++) $n += strlen("hello") * 2;
    return $n;
}
$ php -d opcache.enable_cli=1 -d opcache.opt_debug_level=0x20000 ops.php
f:
     ; (after optimizer)
0004 CV1($n) = ADD CV1($n) int(10)
0005 PRE_INC CV2($i)
0006 T4 = COUNT CV0($a)
0007 T3 = IS_SMALLER CV2($i) T4
0008 JMPNZ T3 0004
strlen("hello") * 2 は最適化前の出力の時点ですでに定数 int(10) でした。コンパイラーが畳み込んだのです。こう書いて「strlen はどれくらい速いか」を測ると、足し算を測ることになります。そして count() は関数呼び出しではなく COUNT という opcode 1 つです。これは後でまた出てきます。
OPcache:CLI とサーバーで正反対
OPcache はコンパイル済みの opcode を共有メモリに保存し、次のリクエストで構文解析とコンパイルを省きます。CLI では既定で無効(opcache.enable_cli => Off)で、それには理由があります。小さなクラス 2,000 個の 437KB のファイルを生成し、設定ごとに新しい php プロセスを 20 回(最初の 1 回は捨てる)起動して測りました。
empty script                 median   56.1 ms
opcache.enable_cli=0         median   64.7 ms   last line: M1999-05998 loaded 2000 classes in 7.78 ms
opcache.enable_cli=1         median   75.7 ms   last line: M1999-05998 loaded 2000 classes in 17.49 ms
enable_cli=1 + file_cache    median   58.3 ms   last line: M1999-05998 loaded 2000 classes in 1.74 ms
20 回の計測をさらに 2 セット行うと 63.9/75.3/58.2、64.3/74.5/58.2ms でした。enable_cli=1 で CLI はかえって遅くなりました。プロセスごとに最適化をかけてキャッシュを埋め、そのまま終了するので、再利用される機会がありません。opcache.file_cache=<ディレクトリ> と opcache.file_cache_only=1 を付けるとコンパイル結果がディスクに残り、次のプロセスは 2,000 クラスを 7.78ms ではなく 1.74ms で読み込みました。56ms という底にも注目してください。拡張を 67 個読み込むこの PHP ビルドは、起動だけでスクリプト全体より時間がかかります。
サーバーは逆です。ビルトインサーバーは長く生きる 1 つのプロセスで、opcache.enable が効きます。ext/curl で順番に 300 リクエスト(最初の 1 回は除外)を送りました。
| ビルトインサーバー | 中央値 | p95 | スクリプト内の読み込み時間 |
|---|---|---|---|
opcache.enable=0 |
6.79ms(2 回目 6.95) | 7.43ms | 6.31ms |
opcache.enable=1 |
0.18ms(0.20) | 0.26ms | 0.01ms |
計測後の opcache_get_status() は hits=1198 misses=3 cached_scripts=3 でした。1 リクエストあたり約 35 倍で、ほぼすべてがコンパイル時間です。PHP-FPM や Apache の mod_php は 2 行目のように動くので、本番では OPcache を有効にしておけば済みます。
JIT:CPU だけを使うベンチマーク
PHP 8.0 から OPcache には、よく実行される opcode を機械語に変える JIT コンパイラーが入っています。8.5 では既定で無効です(opcache.jit => disable、opcache.jit_buffer_size => 64M)。テストは 600×600、1 ピクセルあたり最大 200 回反復のマンデルブロ集合で、PHP のループ内の純粋な浮動小数点計算です。
<?php
// mandel.php — CPU-bound: 600x600 Mandelbrot, 200 iterations max. Prints a checksum.
declare(strict_types=1);
function mandel(int $w, int $h, int $maxIter): int {
    $inside = 0;
    for ($y = 0; $y < $h; $y++) {
        $ci = 2.0 * $y / $h - 1.0;
        for ($x = 0; $x < $w; $x++) {
            $cr = 3.0 * $x / $w - 2.0;
            $zr = 0.0; $zi = 0.0; $i = 0;
            while ($i < $maxIter && $zr * $zr + $zi * $zi < 4.0) {
                $t = $zr * $zr - $zi * $zi + $cr;
                $zi = 2.0 * $zr * $zi + $ci;
                $zr = $t;
                $i++;
            }
            if ($i === $maxIter) $inside++;
        }
    }
    return $inside;
}
$t = hrtime(true);
$r = mandel(600, 600, 200);
printf("mandel %d  %.1f ms\n", $r, (hrtime(true) - $t) / 1e6);
設定ごとに新しいプロセスで 5 回、スクリプト内のタイマーで測り、すべての実行が同じチェックサム 91677 を出力しました。
| フラグ | 中央値 | 最小〜最大 |
|---|---|---|
opcache.enable_cli=0 |
524.7ms | 524.4〜525.5 |
enable_cli=1・jit=disable |
334.4ms | 333.6〜338.7 |
jit=tracing・jit_buffer_size=0 |
333.2ms | 332.8〜333.8 |
jit=tracing・バッファ 64M |
75.0ms | 74.6〜76.4 |
jit=function・バッファ 64M |
74.1ms | 73.9〜74.9 |
わかったことは 3 つです。OPcache だけでもループは 1.6 倍速くなりました。最適化器が型を推論し、特化した opcode を使うからです。JIT はそこにさらに 4.5 倍を上乗せしました。そしてバッファ 0 の jit=tracing は、何も言わずに何もしませんでした。本当の状態は opcache_get_status(false)['jit'] が教えてくれます。
-d opcache.jit=tracing                              → opcache_get_status: false
-d opcache.enable_cli=1 -d opcache.jit=tracing      → jit enabled=true on=true kind=5 buffer=67108848
... -d opcache.jit_buffer_size=0                    → jit enabled=false on=false kind=5 buffer=0
-d opcache.enable_cli=1 -d opcache.jit=bogus
PHP Warning:  Invalid "opcache.jit" setting. Should be "disable", "on", "off", "tracing", "function" or 4-digit number in Unknown on line 0
enable_cli=1 がなければ CLI での JIT 設定はまったく効かず、警告が出るのはタイプミスのときだけです。このベンチマークのようにホットな関数が 1 つだけなら tracing と function はほぼ同じで、ホットな経路が複数の関数にまたがるときは一般に tracing が有利です。
文字列・配列処理での JIT
PHP の時間の大半は配列の構築、json_encode、ソート、文字列関数に使われ、これらは JIT の有無と関係なく PHP 内部の C コードとして動きます。
<?php
// strwork.php — "web-ish" work: build rows, json_encode, explode, str_replace, sort.
declare(strict_types=1);
mt_srand(42);
$t = hrtime(true);
$total = 0;
for ($round = 0; $round < 40; $round++) {
    $rows = [];
    for ($i = 0; $i < 5000; $i++) {
        $rows[] = ['id' => $i, 'name' => 'user_' . mt_rand(1, 99999), 'tags' => 'a,b,c,' . ($i % 7)];
    }
    $json = json_encode($rows);
    $back = json_decode($json, true);
    usort($back, fn($a, $b) => strcmp($a['name'], $b['name']));
    foreach ($back as $r) {
        $total += count(explode(',', $r['tags'])) + strlen(str_replace('user_', 'u:', $r['name']));
    }
}
printf("strwork %d  %.1f ms\n", $total, (hrtime(true) - $t) / 1e6);
| フラグ | 5 回の中央値 | 最小〜最大 |
|---|---|---|
| OPcache なし | 261.5ms | 254.1〜267.6 |
| OPcache・JIT オフ | 261.2ms | 260.2〜267.5 |
| JIT tracing | 240.2ms | 234.9〜245.0 |
| JIT function | 244.7ms | 241.0〜258.0 |
約 8% で、最小〜最大の範囲がほとんど接しています。DB を問い合わせてテンプレートを描画する普通のページなら、効果はさらに小さくなります。I/O 待ちはまったく速くならないからです。画像処理、数値計算、PHP で書いたパーサーなら JIT を有効にする価値があり、CRUD アプリなら効くのは OPcache で、JIT は誤差の範囲です。
メモリ:100 万件を配列で、ジェネレーターで
整数 100 万個を合計した後の memory_get_peak_usage() を、モードごとに新しいプロセスで、ループ前の使用量からの増分として測りました。
function numbers(int $n): Generator { for ($i = 0; $i < $n; $i++) yield $i; }
// 'array': $a = range(0, $n - 1); foreach ($a as $v) $sum += $v;
// 'gen':   foreach (numbers($n) as $v) $sum += $v;
| 100 万件 | ピーク増分 | 時間 |
|---|---|---|
range() の整数配列 |
16.0MB | 7ms |
ジェネレーター(yield) |
0.0MB | 22ms |
["k$i" => $i] 文字列キー |
76.0MB | 66ms |
["row-$i", …] 文字列 |
54.2MB | 45ms |
[['id' => $i, 'v' => …], …] 行の配列 |
128M で Fatal、1G で 374.6MB | 185ms |
整数だけの packed 配列は 1 要素 16 バイトです。ジェネレーターは値を 1 つずつしか持ちませんが、ここでは 3 倍遅くなりました。yield のたびに関数を再開するからです。文字列キーにはハッシュテーブルとキー文字列が加わります。1 行ごとに配列を持つ最後のケースは「全行取得」のクエリが作る形で、既定の上限では落ちました。
PHP Fatal error: Allowed memory size of 134217728 bytes exhausted (tried to allocate 20480 bytes) in ~/demo/mem.php on line 13
ジェネレーターは大きな入力(CSV、PDOStatement::fetch() のカーソル)を流すための道具で、「メモリ不足」を「一定のメモリ」に変えてくれます。すでにメモリに収まる小さな配列なら、配列のほうが速いです。
よくある遅い書き方を実測
slow.php で各パターンを bench() で動かしました。ウォームアップ 1 回の後の 5 回の中央値で、まず OPcache なし(CLI の既定)、次に OPcache + tracing JIT で測りました。
| パターン | OPcache なし | OPcache + JIT |
|---|---|---|
条件に count($data) を書いた for、100 万 |
7.55ms | 1.13ms |
count() を変数に出す |
6.54ms | 1.02ms |
foreach |
5.24ms | 1.89ms |
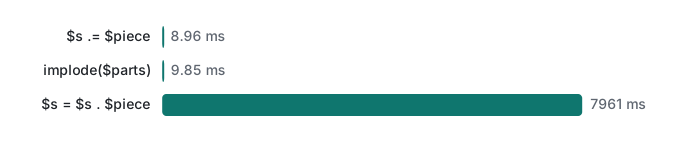
$s .= $piece、20 万個 |
8.96ms | 8.33ms |
$s = $s . $piece、20 万個 |
7,961ms | 7,619ms |
$s = $piece . $s、2 万個 |
66.70ms | 95.60ms |
配列を implode()、20 万個 |
9.85ms | 9.96ms |
in_array で 1 万件を 1 万個の文字列から |
232.51ms | 224.93ms |
array_flip 1 回 + isset 1 万回 |
0.37ms | 0.26ms |
in_array、1 回だけ探す |
0.04ms | 0.04ms |
array_flip + isset、1 回だけ探す |
0.08ms | 0.09ms |
$all = array_merge($all, $chunk)、2 千 × 50 |
227.13ms | 224.18ms |
array_push($all, ...$chunk) |
1.06ms | 1.10ms |
断片を集めて array_merge(...$parts) 1 回 |
0.46ms | 0.46ms |
条件の中の count() は最もよく繰り返される高速化のコツですが、ここでは最も重要度が低いものでした。100 万回で 1ms の差です。count() は O(1) の opcode だからです(上のダンプ)。読みやすさのために外に出すのは構いません。JIT ありでは foreach が 3 つの中で一番遅くなりました。PHP 5 時代の言い伝えは計測の前では生き残りません。
本当の落とし穴は文字列連結にありました。
よくある間違い:ループ内の $s = $s . $x
間違い。 追記を長い形で書くこと。同じ行で別の処理もするときによく出てきます。$html = $html . render($row); のような書き方です。
実際に起きること。 毎回新しい文字列を作り、それまでに作った内容を全部コピーします。20 万個で 8.96ms ではなく 7,961ms、約 900 倍で、サイズの 2 乗で増えます。
n= 25000  s=s.x     91.6 ms   s.=x  1.00 ms
n= 50000  s=s.x    296.6 ms   s.=x  2.06 ms
n=100000  s=s.x   1141.0 ms   s.=x  4.10 ms
n を 2 倍にすると 3.2〜3.8 倍遅くなり、.= は線形に増えました。参照が 1 つだけなら PHP は文字列をその場で伸ばせるからです。前に付け足す($s = $piece . $s)のも 2 乗で増えます。JIT も効きませんでした(7,619ms)。
修正。 .= を使うか、断片を配列に集めて implode() を 1 回。どちらも約 9ms でした。
in_array と反転した配列の isset。 in_array は配列を先頭から順に見るので、1 万個の中から 1 万回探すと最悪 1 億回の比較で 232ms です。一度反転すると値がハッシュテーブルのキーになり、isset はハッシュ検索 1 回なので 0.37ms、628 倍速くなりました。ただし 1 回だけ探すなら反転のコストのほうが大きくなります(0.08 対 0.04ms)。同じ配列を何度も探すときに反転しましょう。
ループ内の array_merge も、大きくなる配列を毎回コピーする同じ 2 乗の形です。断片を集めて最後に 1 回まとめると、227ms が 0.46ms になりました。
だますマイクロベンチマーク(私たちもだまされた)
JIT のウォームアップを見せようと、mandel(150, 150, 200) を 6 回呼ぶ小さなファイルを作り、作った直後に opcache.jit=tracing で動かしました。
call 1: 33.38 ms
call 2: 32.96 ms
...
call 6: 33.82 ms
JIT オフと同じでした。JIT バッファは 1KB ほど増えただけです。原因は opcache.file_update_protection => 2 でした。書きかけのファイルをキャッシュしないように、OPcache は直近 2 秒以内に変更されたファイルをキャッシュせず、キャッシュがなければ JIT もありません。2 秒後に同じコマンドを実行すると次のとおりです。
call 1: 5.16 ms
call 2: 4.72 ms
call 6: 4.70 ms
生成した直後に動かしたベンチマーク、編集して 2 秒以内に再実行したベンチマークは、OPcache なしの PHP を測っています。この記事で見たほかの落とし穴です。
- CLI の既定値は本番ではない。 OPcache なしで
count()のループは 7.55ms、ありなら 1.13ms。サーバーと同じ OPcache 設定で測りましょう。 - 定数の畳み込み。 ループ内の
strlen("hello")は10にコンパイルされます。コンパイラーが知り得ない値を与えましょう。 - 小さすぎて意味のない差。 1 回だけの検索の 0.04 対 0.08ms は事実ですが重要ではありません。重要なのは 232 対 0.37ms のほうです。
- プロセス起動が支配する。 空のスクリプトで 56ms。CLI ツールでの 5ms の改善は、その横では見えません。
- ノイズ。
strworkは同じ実行同士でも 254〜268ms で揺れました。5% 未満の差を語るには、もっと多く回す必要があります。
判断表
| 状況 | やること | 根拠 |
|---|---|---|
| Web サーバー(FPM、mod_php、LiteSpeed) | opcache.enable=1 |
1 リクエスト 6.79 → 0.18ms |
| 1 回で終わる CLI、cron | enable_cli=0 のまま、または opcache.file_cache |
64.7 / 75.7 / 58.3ms |
| PHP ループ内の純粋な計算 | opcache.jit=tracing(バッファ > 0) |
334 → 75ms |
| JSON、文字列、配列、DB | JIT よりアルゴリズム | 261 → 240ms |
| 文字列の組み立て | .= か implode |
8.96 対 7,961ms |
| 何度も行う存在確認 | array_flip を 1 回してから isset |
232 → 0.37ms |
| 大きな入力 | ジェネレーター | 0MB 対 Fatal |
| JIT は有効? | opcache_get_status()['jit']['on'] を確認 |
バッファ 0 だと黙って無効 |
正直な限界とバージョンメモ
- 計測は PHP 8.5.6、Apple Silicon の 1 台だけです。x86-64 の Linux サーバーでは JIT の効果は変わるでしょう。古いバージョンは動かしていません。PHP の変更履歴によると、JIT は 8.0 で追加され、8.4 で既定値が
opcache.jit=disable、jit_buffer_size=64Mに変わりました(それ以前はjit=tracingでバッファ 0、つまりやはり無効)。 - プロファイラー拡張は使っていません。xdebug・SPX・xhprof・Blackfire なら関数ごとのコストが見えますが、
hrtimeは囲んだ部分しか測れません。レンタルサーバーではこうした拡張を入れられないことが多いので、この方法は覚えておく価値があります。 - サーバーのテストは PHP のシングルスレッドのビルトインサーバーに順番にリクエストを送ったもので、同時アクセスの負荷ではありません。OPcache が取り除くコンパイルのコストを示すだけで、スループットではありません。
memory_get_peak_usage()は PHP 自身のアロケーターしか数えません。ライブラリが確保するメモリ(第 5 回の argon2、画像ライブラリ、SQLite エンジン)は出てきません。
演習
1. アクティブな利用者の ID を返す関数です。利用者 3 万人、アクティブなアドレス 1 万件で 1,213ms かかりました。結果を変えずに速くし、結果が同じであることをどう証明するか答えてください。
function activeIds(array $users, array $activeEmails): array {
    $out = [];
    foreach ($users as $u) {
        if (in_array($u['email'], $activeEmails, true)) $out = array_merge($out, [$u['id']]);
    }
    return $out;
}
解答
2 乗のパターンが 2 つあります。ループ内の in_array と、見つかるたびに $out をコピーする array_merge です。
function activeIds(array $users, array $activeEmails): array {
    $active = array_flip($activeEmails);      // once: values become keys
    $out = [];
    foreach ($users as $u) {
        if (isset($active[$u['email']])) $out[] = $u['id'];
    }
    return $out;
}
確認すべき違いが 1 つあります。in_array(..., true) は厳密比較ですが、配列のキーは "123" のような数字の文字列を整数に変えます。メールアドレスでは起こり得ません。同じシード(mt_srand(42))で作った入力に両方を実行し、=== で比べれば証明になります。私たちの実行結果は slow 1212.8 ms, fast 2.49 ms, 4625 ids, identical: true、約 490 倍でした。
PHP 講座はここまでです。同じコードのセキュリティ面は第 5 回で扱いました。
前回: 第 5 回:XSS・CSRF・セッション · 最初から: 第 1 回:型・文字列・配列
関連記事:Python 第 6 回:プロファイリングと最適化 · Java 第 6 回:JIT・GC・メモリ · プリペアドステートメントで JSON の数値型が変わった理由
よくある質問
PHP の CLI で OPcache を有効にするとスクリプトは速くなりますか?
1 回実行して終わるスクリプトなら速くなりません。クラス 2,000 個を読み込むスクリプトは opcache.enable_cli=1 で 63.9〜64.7ms から 74.5〜75.7ms に遅くなりました。プロセスごとにキャッシュを作って捨てるからです。opcache.file_cache を加えると 58.2ms でした。1 つのプロセスが動き続けるビルトインサーバーでは、1 リクエストが 6.79ms から 0.18ms になりました。
PHP 8.5 で JIT を有効にするとどれくらい速くなりますか?
処理内容しだいです。CPU だけを使うマンデルブロ計算は 334.4ms(OPcache あり・JIT オフ)から opcache.jit=tracing で 75.0ms、約 4.5 倍でした。json_encode・usort・explode・str_replace 中心の処理は 261.2ms から 240.2ms、約 8% でした。時間の大半が C で書かれた組み込み関数の中で使われるからです。
$s = $s . $x は $s .= $x より遅いのですか?
ループの中では桁違いに遅くなります。20 万個の断片から 2.3MB の文字列を作ると、.= は 8.96ms、$s = $s . $x は 7,961ms でした(PHP 8.5)。後者は毎回文字列全体をコピーします。JIT でも直りませんでした。