자바 컬렉션 성능 실측: ArrayList·HashMap·ArrayDeque (JDK 26)
ArrayList와 LinkedList, HashMap과 TreeMap, ArrayDeque와 Stack을 JDK 26에서 워밍업 후 실측. 박싱 비용, 초기 용량, ConcurrentModificationException까지.
시리즈: 자바 강좌 3/6 (중급). 클래스는 쓸 줄 알지만 List·Set·Map·Deque 구현체는 습관대로 고르는 분을 위한 글입니다. 다 읽고 나면 어떤 컬렉션이 언제 느려지는지 예측하고, 초보 때 꼭 만나는 컬렉션 예외 두 가지를 피하고, 라이브러리 없이 내 코드의 시간을 재 볼 수 있습니다.
코딩테스트를 자바로 준비해 본 분이라면 BFS 코드에서 Queue<Integer> q = new LinkedList<>();를, DFS 코드에서 Stack<Integer>를 수없이 보셨을 겁니다. 실무에서도 "정렬돼 있으면 좋으니까" TreeMap을 고르거나, 루프 안에서 요소를 지우다가 예외를 맞는 일이 흔합니다. 이 글은 그런 선택을 감이 아니라 숫자로 다시 보게 해 드리고, 아래 숫자는 모두 직접 잰 것, 에러는 모두 실제 실행에서 복사한 것입니다.
실행 환경: OpenJDK 26(Temurin 26+35), Apple Silicon Mac(M1 Pro, 8코어), macOS. 힙 크기 변화가 시간에 섞이지 않도록 java -Xms3g -Xmx3g로 실행했고, 난수는 new Random(42)로 고정했습니다.
JMH 없이 재는 방법
자바 마이크로벤치마크의 정석은 JMH입니다. 이 시리즈는 JDK에 들어 있는 것만 쓰고 아무것도 설치하지 않는다는 원칙이 있어서 JMH를 쓰지 않았습니다. 대신 모든 측정을 아래 함수 하나로 통일했습니다. 먼저 몇 번 시간을 재지 않고 돌려서 JIT 컴파일러가 코드를 컴파일하게 하고(워밍업), 그다음 여러 번 재서 중앙값을 냅니다.
static long sink; // 결과를 여기에 더해서 JIT이 계산을 지워 버리지 못하게 한다

static double measure(String name, int warmup, int runs, LongSupplier task) {
    for (int i = 0; i < warmup; i++) sink += task.getAsLong();
    double[] t = new double[runs];
    for (int i = 0; i < runs; i++) {
        long s = System.nanoTime();
        sink += task.getAsLong();
        t[i] = (System.nanoTime() - s) / 1e6;
    }
    Arrays.sort(t);
    System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n",
                      name, t[runs / 2], t[0], t[runs - 1]);
    return t[runs / 2];
}
2배 이상의 차이를 보기에는 충분하지만, 10% 차이를 두고 논쟁하기에는 부족합니다. 벤치마크마다 JVM을 새로 띄우지 않고, GC 멈춤도 아무 데나 끼어듭니다. 그래서 전체를 네 번 돌렸고, 실행마다 결과가 달랐던 항목은 범위를 같이 적었습니다. 전체 코드는 글 끝에 있습니다.
ArrayList vs LinkedList: get(i), 맨 앞 삽입, 순회
둘 다 List라서 바꿔 끼워도 될 것 같지만 내부가 완전히 다릅니다. ArrayList는 크기가 늘어나는 배열이고, LinkedList는 prev·next 포인터를 가진 노드 객체의 사슬입니다.
== get(i) x 10,000 random indexes, size 100,000
ArrayList.get                      median     0.082 ms  (min 0.058, max 0.355)
LinkedList.get                     median   454.775 ms  (min 451.945, max 463.801)
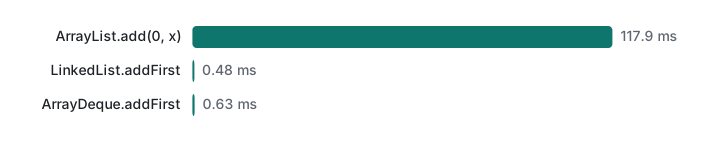
== add(0, x) x 50,000 into an empty list
ArrayList.add(0,x)                 median   117.930 ms  (min 116.612, max 122.530)
LinkedList.addFirst                median     0.483 ms  (min 0.397, max 0.761)
ArrayDeque.addFirst                median     0.633 ms  (min 0.571, max 0.691)
== for-each over 1,000,000 elements
ArrayList iterate                  median     0.968 ms  (min 0.964, max 0.977)
LinkedList iterate                 median     1.923 ms  (min 1.909, max 1.937)
세 덩어리를 나눠서 보면 이렇습니다.
- get(i):
LinkedList.get(i)는 가까운 쪽 끝부터 노드를 하나씩 따라갑니다. 10만 개짜리 리스트에서 최대 5만 번입니다. 무작위로 1만 번 읽는 데 455ms,ArrayList는 0.08ms였습니다.LinkedList를for (int i = 0; i < list.size(); i++) list.get(i)로 도는 코드는 O(n²)이고, 이 클래스가 사람을 괴롭히는 가장 흔한 방식입니다. - 맨 앞 삽입: 여기서는
LinkedList가 약 240배 빠릅니다.ArrayList.add(0, x)는 기존 요소를 전부 한 칸씩 밀기 때문입니다. 그런데ArrayDeque도 거의 같은 시간에 끝났고, 요소당 메모리는 더 적습니다. - 순회: 연결 리스트가 괜찮아야 할 순차 읽기에서도 2배 느렸습니다. 노드가 각각 따로 할당된 객체라서 CPU가 연속된 메모리를 읽는 대신 포인터를 쫓아다니기 때문입니다.
그래서 코딩테스트 BFS의 new LinkedList<>()는 new ArrayDeque<>()로 바꾸는 것을 권합니다. offer·poll·peek 메서드 이름은 그대로라서 한 줄만 고치면 됩니다. 실무 코드에서 LinkedList가 최선이었던 경우는 아직 찾지 못했습니다. 연결 리스트가 왜 이렇게 동작하는지는 연결 리스트 직접 구현 글에서 손으로 만들어 볼 수 있습니다.
HashMap vs TreeMap 조회, ArrayDeque vs Stack
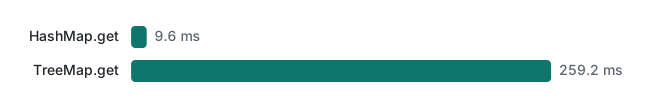
== 1,000,000 lookups, 100,000 String keys
HashMap.get                        median     9.623 ms  (min 9.493, max 10.595)
TreeMap.get                        median   259.214 ms  (min 238.363, max 322.357)
== push+pop 1,000,000 (stack use)
Stack push/pop                     median     4.674 ms  (min 4.252, max 5.679)
ArrayDeque push/pop                median     6.911 ms  (min 6.600, max 144.144)
TreeMap이 27배 느렸습니다(네 번의 실행에서 HashMap 중앙값은 8.9~17.2ms, TreeMap은 259~380ms). 이유는 두 가지가 겹칩니다. 키 10만 개짜리 레드-블랙 트리는 깊이가 17 안팎이라 한 번 찾을 때 비교를 17번쯤 합니다. 해시 한 번에 equals 한 번 정도인 HashMap과는 차원이 다릅니다. 게다가 키가 "user-12345" 같은 모양이라 compareTo가 매번 공통 접두사 "user-"부터 한 글자씩 비교합니다. 실제 회원 ID, URL, 파일 경로는 접두사가 겹치는 경우가 많습니다. TreeMap은 firstKey()·headMap()·ceilingKey()나 정렬된 순회가 필요할 때 제값을 하고, 조회만 한다면 잘못 고른 맵입니다. 트리 구조 자체는 이진 탐색 트리 글을 참고하세요.
Stack 결과는 저희도 예상 밖이었습니다. 흔히 "Stack은 synchronized라서 느리다"고 하지만, JDK 26에서는 경쟁 없는 락이 싸서 네 번 모두 Stack이 느리지 않았습니다(중앙값 4.7~7.0ms, ArrayDeque는 5.3~11.3ms, 양쪽 모두 GC 잡음 포함). 그러니 Stack을 피하는 이유는 속도가 아니라 API입니다.
Stack<String> st = new Stack<>();
ArrayDeque<String> dq = new ArrayDeque<>();
for (String s : List.of("a", "b", "c")) { st.push(s); dq.push(s); }
System.out.println("Stack      " + st + "  peek=" + st.peek());
System.out.println("ArrayDeque " + dq + "  peek=" + dq.peek());
Stack      [a, b, c]  peek=c
ArrayDeque [c, b, a]  peek=c
peek()은 둘 다 c인데, Stack은 내부가 Vector라서 바닥부터 출력하고 순회합니다. 스택 내용을 디버깅 출력으로 확인하다가 순서가 거꾸로 보여서 헷갈리는 경우가 이것입니다. 또 아무나 st.get(0)이나 st.add(x)를 불러 스택 규칙을 깰 수 있습니다. ArrayDeque는 pop 순서로 순회하고 덱 연산만 제공합니다. 한 가지 제약은 null을 넣으면 NullPointerException이 난다는 점입니다.
박싱 비용과 초기 용량
List<Integer>가 담는 것은 숫자가 아니라 Integer 객체의 참조입니다. 1,000만 개를 더해 봤습니다.
== sum of 10,000,000 ints
int[] sum                          median     3.281 ms  (min 3.205, max 3.306)
List<Integer> sum (0..999)         median     6.814 ms  (min 6.670, max 6.951)
List<Integer> sum (distinct)       median     6.764 ms  (min 6.663, max 6.869)
박싱된 리스트가 약 2배 느렸습니다. 값이 0~999인 경우(Integer 캐시에서 나오므로 실제 객체는 1,000개뿐)와 0~9,999,999인 경우(객체 1,000만 개)를 둘 다 재 봤는데 시간이 같았습니다. 둘 다 순서대로 할당돼서 메모리에 붙어 있기 때문입니다. 오래 도는 서버에서는 객체가 생성 시점마다 흩어지므로 차이가 더 벌어지는 경향이 있습니다. 더 큰 비용은 메모리입니다. 압축 포인터를 쓰는 64비트 JVM에서 리스트 한 칸은 참조 4바이트에 Integer 객체 16바이트, int[]는 4바이트입니다. 코딩테스트에서 수백만 개의 숫자를 List<Integer>에 담다가 메모리 초과가 나는 이유이기도 합니다.
초기 용량은 공짜로 얻는 개선입니다. 새 ArrayList는 빈 상태로 시작해 첫 add에서 10칸을 만들고, 가득 찰 때마다 50%씩 늘리며 기존 배열을 복사합니다. JDK에 들어 있는 ThreadMXBean.getThreadAllocatedBytes로 현재 스레드가 할당한 바이트를 쟀습니다.
grow steps to reach 1000000: 29
allocated, default capacity : 14,586,416 bytes
allocated, new ArrayList<>(N): 4,000,040 bytes
median time, default  : 2.505 ms
median time, presized : 2.205 ms
용량 없이 100만 개를 채우면 버려진 중간 배열들 때문에 할당량이 3.6배였고, 시간은 12%쯤 더 걸렸습니다. 메모리 숫자는 정확하고 매번 같았고, 시간 차이는 작습니다. 크기를 알 때(다른 컬렉션을 옮겨 담을 때 등)는 넘겨 주세요. HashMap은 Java 19부터 부하율 0.75를 계산해 주는 HashMap.newHashMap(n)이 있습니다. new HashMap<>(n)은 n개를 다 넣기 전에 리사이즈가 일어납니다.
흔한 실수 1: ConcurrentModificationException
거의 모든 사람이 처음 만나는 컬렉션 예외입니다. 루프를 돌면서 짝수를 지워 보겠습니다.
import java.util.*;

public class Cme {
    public static void main(String[] args) {
        List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
        for (Integer n : nums) {
            if (n % 2 == 0) nums.remove(n);   // 순회 중에 remove(Object)
        }
        System.out.println(nums);
    }
}
실제로 일어나는 일 (java Cme.java):
Exception in thread "main" java.util.ConcurrentModificationException
    at java.base/java.util.ArrayList$Itr.checkForComodification(ArrayList.java:1104)
    at java.base/java.util.ArrayList$Itr.next(ArrayList.java:1058)
    at Cme.main(Cme.java:6)
for-each는 Iterator로 컴파일됩니다. ArrayList는 구조가 바뀐 횟수를 modCount 필드에 세고, 이터레이터는 next()마다 이 값을 비교합니다. 스택 트레이스의 6번째 줄이 remove 줄이 아니라 for 줄인 것에 주목하세요. 삭제는 성공했고, 루프의 다음 단계가 그걸 알아챈 것입니다. 이름에 "Concurrent"가 붙어 있지만 스레드와는 관계가 없습니다.
더 나쁜 점은 이 검사가 항상 걸리지 않는다는 것입니다. 끝에서 두 번째 요소를 지우면 next()가 다시 불리기 전에 루프가 끝납니다.
List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4));
for (Integer n : nums) {
    if (n == 3) nums.remove(n);
}
System.out.println(nums);
[1, 2, 4]
예외 없이 운 좋게 동작했습니다. 이런 코드는 테스트 데이터로는 통과하고 운영 데이터에서 터집니다. Javadoc이 이 검사를 "best-effort"라고 부르는 이유입니다.
해결: 의도를 그대로 코드로 씁니다.
List<Integer> a = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
a.removeIf(n -> n % 2 == 0);
System.out.println("removeIf      " + a);

List<Integer> b = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
for (Iterator<Integer> it = b.iterator(); it.hasNext(); )
    if (it.next() % 2 == 0) it.remove();
System.out.println("it.remove()   " + b);
removeIf      [1, 3, 5]
it.remove()   [1, 3, 5]
removeIf를 우선 쓰세요. ArrayList에서는 배열을 한 번만 당겨 정리하지만, it.remove()는 호출할 때마다 뒷부분을 밉니다. 지울 때마다 로그를 남기는 것처럼 조건식 하나로 표현하기 어려울 때만 명시적 이터레이터를 씁니다.
흔한 실수 2: List.of는 읽기 전용
List.of·Set.of·Map.of(Java 9+)는 불변 컬렉션을 돌려줍니다. 문제는 타입에 그 사실이 드러나지 않는다는 것입니다. 그냥 List<String>입니다.
List<String> a = Arrays.asList("x", "y");
a.set(0, "X");                       // 됨: 크기 고정일 뿐 읽기 전용은 아님
System.out.println(a);
List<String> fixed = List.of("x", "y");
try { a.add("z"); } catch (UnsupportedOperationException e) { System.out.println("Arrays.asList add -> " + e); }
try { fixed.contains(null); } catch (NullPointerException e) { System.out.println("List.of contains(null) -> " + e); }
fixed.add("z");
[X, y]
Arrays.asList add -> java.lang.UnsupportedOperationException
List.of contains(null) -> java.lang.NullPointerException
Exception in thread "main" java.lang.UnsupportedOperationException
    at java.base/java.util.ImmutableCollections.uoe(ImmutableCollections.java:145)
    at java.base/java.util.ImmutableCollections$AbstractImmutableCollection.add(ImmutableCollections.java:150)
    at Immutable.main(Immutable.java:11)
인터페이스 하나 뒤에 서로 다른 계약 세 가지가 숨어 있습니다. Arrays.asList는 크기만 고정이라 set은 됩니다. List.of는 모든 변경을 거부하고, null도 거부합니다. contains(null)조차 예외입니다. 컴파일러는 이 중 어느 것도 잡아 주지 않고 실행해야 알 수 있습니다. 수정할 생각이면 복사하세요. new ArrayList<>(List.of(...))가 위 예제들에서 쓴 방법입니다.
순서 있는 컬렉션(Java 21): getFirst, getLast, reversed
Java 21 전에는 "마지막 요소"를 리스트는 list.get(list.size() - 1), 덱은 deque.peekLast(), LinkedHashSet은 루프로 구했습니다. Java 21의 SequencedCollection·SequencedSet·SequencedMap 인터페이스가 이걸 하나의 어휘로 통일했습니다.
List<String> list = new ArrayList<>(List.of("mon", "tue", "wed"));
System.out.println(list.getFirst() + " " + list.getLast() + " " + list.reversed());
LinkedHashMap<String, Integer> lhm = new LinkedHashMap<>();
lhm.put("x", 1); lhm.put("y", 2); lhm.putFirst("w", 0);
System.out.println(lhm + " first=" + lhm.firstEntry() + " reversed=" + lhm.reversed());
LinkedHashSet<String> set = new LinkedHashSet<>(List.of("b", "c"));
set.addFirst("a");
System.out.println(set + " last=" + set.getLast());
List<String> rev = list.reversed();
rev.add("thu");          // 원본에 반영된다: 원본의 맨 앞에 추가
System.out.println("original after rev.add: " + list);
mon wed [wed, tue, mon]
{w=0, x=1, y=2} first=w=0 reversed={y=2, x=1, w=0}
[a, b, c] last=c
original after rev.add: [thu, mon, tue, wed]
두 가지를 기억하세요. reversed()는 복사본이 아니라 뷰입니다. 뷰의 끝에 추가했더니 원본의 맨 앞에 "thu"가 들어갔습니다. 그리고 빈 리스트의 getFirst()는 NoSuchElementException을 던집니다. null을 돌려주는 덱의 peekFirst()와 다릅니다. 버전도 확인했습니다. 같은 코드를 javac --release 20으로 컴파일하면 error: cannot find symbol ... method getFirst()로 실패하고, --release 21에서는 컴파일됩니다.
결정표
| 필요한 것 | 쓸 것 | 피할 것 | 근거(위 실측) |
|---|---|---|---|
| 인덱스로 읽는 리스트 | ArrayList |
LinkedList |
get(i) 1만 번: 0.08ms vs 455ms |
| 큐·스택·양 끝 (BFS/DFS 포함) | ArrayDeque |
Stack, LinkedList, ArrayList.add(0, x) |
맨 앞 삽입 0.63ms vs 118ms, Stack은 Vector 메서드 노출 |
| 키 조회만 | HashMap |
TreeMap |
100만 번 조회 9.6ms vs 259ms |
| 정렬된 키, 범위, 가장 가까운 키 | TreeMap |
매번 HashMap을 정렬 |
ceilingKey, headMap, firstKey |
| 삽입 순서 유지 | LinkedHashMap / LinkedHashSet |
HashMap에 기대기 |
HashMap 순서는 정해져 있지 않음 |
| 수백만 개의 숫자 | int[], long[] |
List<Integer> |
합계 2배 느림, 메모리 약 5배 |
| 크기를 알 때 | new ArrayList<>(n), HashMap.newHashMap(n) |
기본 용량 | 100만 개에서 할당 3.6배 차이 |
| 순회 중 삭제 | removeIf, iterator.remove() |
for-each 안의 list.remove() |
예외, 또는 운에 맡긴 성공 |
| 상수 리스트 | List.of |
add를 부르는 코드에 넘기기 |
실행 시 UnsupportedOperationException |
한계와 버전 메모
- JMH가 아닙니다. 워밍업과 중앙값은 있지만 JVM 포크, 블랙홀, 오차 범위가 없습니다. 2배 이상의 차이는 믿어도 되고 20% 이하는 "비슷하다"로 보세요. 최댓값이 튀는 것은 GC 멈춤 때문입니다(
ArrayDeque한 번은 144ms). - 기계 한 대. Apple Silicon(M1 Pro), OpenJDK 26, 기본 G1 GC. x86 서버는 캐시 크기가 달라서 비율은 대체로 유지되지만 절대값은 다릅니다.
- 확인한 버전:
List.of는 Java 9부터(--release 8은cannot find symbol ... method of(String,String)으로 실패,--release 9는 성공). 순서 있는 컬렉션은 Java 21부터(--release 20/21로 확인).HashMap.newHashMap은 Java 19부터(--release 18실패,19성공). 나머지는 26에서만 실행했습니다. - 동시성 컬렉션(
ConcurrentHashMap,CopyOnWriteArrayList)은 재지 않았습니다. 5강 가상 스레드와 동시성에서 다룹니다. - C#을 아는 분은 C# 제네릭 컬렉션과 비교해 보세요. 자바만의 함정은 박싱과
Stack extends Vector입니다.
직접 돌려 보기
CollBench.java로 저장하고 java -Xms3g -Xmx3g CollBench.java로 실행합니다(힙 약 3GB, 1분 남짓 걸림).
import java.util.*;
import java.util.function.*;

public class CollBench {
    static long sink;

    static double measure(String name, int warmup, int runs, LongSupplier task) {
        for (int i = 0; i < warmup; i++) sink += task.getAsLong();
        double[] t = new double[runs];
        for (int i = 0; i < runs; i++) {
            long s = System.nanoTime();
            sink += task.getAsLong();
            t[i] = (System.nanoTime() - s) / 1e6;
        }
        Arrays.sort(t);
        System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n", name, t[runs / 2], t[0], t[runs - 1]);
        return t[runs / 2];
    }

    public static void main(String[] args) {
        final int N = 100_000;
        Random rnd = new Random(42);
        int[] idx = new int[10_000];
        for (int i = 0; i < idx.length; i++) idx[i] = rnd.nextInt(N);

        List<Integer> al = new ArrayList<>(), ll = new LinkedList<>();
        for (int i = 0; i < N; i++) { al.add(i); ll.add(i); }
        System.out.println("== get(i) x 10,000 random indexes, size 100,000");
        measure("ArrayList.get", 5, 7, () -> { long s = 0; for (int i : idx) s += al.get(i); return s; });
        measure("LinkedList.get", 2, 5, () -> { long s = 0; for (int i : idx) s += ll.get(i); return s; });

        System.out.println("== add(0, x) x 50,000 into an empty list");
        measure("ArrayList.add(0,x)", 3, 5, () -> { List<Integer> l = new ArrayList<>(); for (int i = 0; i < 50_000; i++) l.add(0, i); return l.size(); });
        measure("LinkedList.addFirst", 3, 5, () -> { LinkedList<Integer> l = new LinkedList<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });
        measure("ArrayDeque.addFirst", 3, 5, () -> { ArrayDeque<Integer> l = new ArrayDeque<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });

        System.out.println("== for-each over 1,000,000 elements");
        List<Integer> al2 = new ArrayList<>(), ll2 = new LinkedList<>();
        for (int i = 0; i < 1_000_000; i++) { al2.add(i % 1000); ll2.add(i % 1000); }
        measure("ArrayList iterate", 10, 9, () -> { long s = 0; for (int v : al2) s += v; return s; });
        measure("LinkedList iterate", 10, 9, () -> { long s = 0; for (int v : ll2) s += v; return s; });

        System.out.println("== 1,000,000 lookups, 100,000 String keys");
        Map<String, Integer> hm = new HashMap<>(), tm = new TreeMap<>();
        String[] keys = new String[N];
        for (int i = 0; i < N; i++) { keys[i] = "user-" + i; hm.put(keys[i], i); tm.put(keys[i], i); }
        String[] q = new String[1_000_000];
        for (int i = 0; i < q.length; i++) q[i] = keys[rnd.nextInt(N)];
        measure("HashMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += hm.get(k); return s; });
        measure("TreeMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += tm.get(k); return s; });

        System.out.println("== push+pop 1,000,000 (stack use)");
        measure("Stack push/pop", 5, 7, () -> { Stack<Integer> st = new Stack<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });
        measure("ArrayDeque push/pop", 5, 7, () -> { ArrayDeque<Integer> st = new ArrayDeque<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });

        System.out.println("== sum of 10,000,000 ints");
        int M = 10_000_000;
        int[] arr = new int[M];
        List<Integer> boxed = new ArrayList<>(M);
        for (int i = 0; i < M; i++) { arr[i] = i % 1000; boxed.add(i % 1000); }
        measure("int[] sum", 10, 9, () -> { long s = 0; for (int v : arr) s += v; return s; });
        measure("List<Integer> sum (0..999)", 10, 9, () -> { long s = 0; for (int v : boxed) s += v; return s; });
        List<Integer> boxedBig = new ArrayList<>(M);
        for (int i = 0; i < M; i++) boxedBig.add(i);
        measure("List<Integer> sum (distinct)", 10, 9, () -> { long s = 0; for (int v : boxedBig) s += v; return s; });
        System.out.println("sink=" + (sink != 0));
    }
}
(초기 용량 숫자는 com.sun.management.ThreadMXBean을 쓴 40줄짜리 별도 프로그램으로 쟀고, 측정 방식은 같습니다.)
이전: 2강: 클래스·레코드·인터페이스 · 다음: 4강: 스트림·람다·Optional
자주 묻는 질문
코딩테스트 BFS에서 Queue<Integer> q = new LinkedList<>() 대신 무엇을 써야 하나요?
ArrayDeque입니다. 맨 앞에 50,000개를 넣는 실측에서 LinkedList.addFirst는 0.48ms, ArrayDeque.addFirst는 0.63ms로 거의 같았고, 순회는 LinkedList가 약 2배 느렸습니다. ArrayDeque는 노드 객체를 따로 만들지 않아 메모리도 적게 씁니다. 단 null은 넣을 수 없습니다.
for-each 안에서 list.remove()를 하면 왜 ConcurrentModificationException이 나나요?
for-each는 Iterator로 컴파일되고, ArrayList의 Iterator는 next()마다 수정 횟수(modCount)를 확인합니다. 루프 안에서 remove하면 횟수가 바뀌어 다음 next()에서 예외가 납니다. 끝에서 두 번째 요소를 지울 때는 예외 없이 지나가기도 해서 더 위험합니다. removeIf나 iterator.remove()를 쓰세요.
Stack 클래스는 느려서 쓰지 말라는 게 맞나요?
JDK 26 실측에서는 속도 차이가 없었습니다(push/pop 100만 번에 둘 다 약 5ms). 피하는 이유는 API입니다. Stack은 Vector를 상속해서 get(i), add()로 스택 규칙을 깰 수 있고, 출력과 순회 순서가 바닥부터입니다. ArrayDeque는 pop 순서로 순회합니다.