Java コレクションの選び方と性能:JDK 26 で実測
ArrayList と LinkedList、HashMap と TreeMap、ArrayDeque と Stack を JDK 26 でウォームアップ付き実測。ボクシング、初期容量、ConcurrentModificationException も。
シリーズ:Java 講座 3/6(中級)。 クラスは書けるものの、List・Set・Map・Deque の実装クラスは「いつものもの」で選んでいる方向けです。読み終えると、どのコレクションがどんなときに遅くなるかを予測でき、初心者が必ず出会う2つの例外を避け、ライブラリなしで自分のコードの時間を計れるようになります。
業務システムの保守では、Vector・Stack・Hashtable が残った古いコードや、「ソートされていると便利だから」と選ばれた TreeMap、ループ内で要素を消して落ちるバッチ処理によく出会います。Java Silver / Gold の試験勉強ではコレクションの API は覚えても、どれがどれだけ遅いかまでは問われません。この記事はその選択を勘ではなく数字で見直すためのもので、数字はすべて自分たちで計ったもの、エラーはすべて実際の実行結果からのコピーです。
実行環境: OpenJDK 26(Temurin 26+35)、Apple Silicon Mac(M1 Pro、8 コア)、macOS。ヒープサイズの変化が時間に混ざらないよう java -Xms3g -Xmx3g で実行し、乱数は new Random(42) で固定しました。
JMH を使わずに計る方法
Java のマイクロベンチマークの定番は JMH です。このシリーズは JDK に同梱されたものだけを使い、何もインストールしない方針なので、JMH は使っていません。代わりに、すべての計測を次の1つの関数にそろえました。まず時間を計らずに数回動かして JIT コンパイラにコンパイルさせ(ウォームアップ)、そのあと複数回計って中央値を出します。
static long sink; // 結果をここに足して、JIT が計算ごと消さないようにする

static double measure(String name, int warmup, int runs, LongSupplier task) {
    for (int i = 0; i < warmup; i++) sink += task.getAsLong();
    double[] t = new double[runs];
    for (int i = 0; i < runs; i++) {
        long s = System.nanoTime();
        sink += task.getAsLong();
        t[i] = (System.nanoTime() - s) / 1e6;
    }
    Arrays.sort(t);
    System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n",
                      name, t[runs / 2], t[0], t[runs - 1]);
    return t[runs / 2];
}
2 倍以上の差を見るには十分ですが、10% の差を議論するには足りません。ベンチマークごとに JVM を起動し直さず、GC の停止もどこにでも入り込みます。そのため全体を 4 回実行し、実行ごとに結果がぶれた項目は範囲も書きました。コード全体は記事の最後にあります。
ArrayList と LinkedList:get(i)、先頭への追加、走査
どちらも List なので差し替えられそうに見えますが、中身はまったく違います。ArrayList は伸びる配列、LinkedList は prev・next を持つノードオブジェクトの鎖です。
== get(i) x 10,000 random indexes, size 100,000
ArrayList.get                      median     0.082 ms  (min 0.058, max 0.355)
LinkedList.get                     median   454.775 ms  (min 451.945, max 463.801)
== add(0, x) x 50,000 into an empty list
ArrayList.add(0,x)                 median   117.930 ms  (min 116.612, max 122.530)
LinkedList.addFirst                median     0.483 ms  (min 0.397, max 0.761)
ArrayDeque.addFirst                median     0.633 ms  (min 0.571, max 0.691)
== for-each over 1,000,000 elements
ArrayList iterate                  median     0.968 ms  (min 0.964, max 0.977)
LinkedList iterate                 median     1.923 ms  (min 1.909, max 1.937)
3 つのブロックを分けて読みます。
- get(i):
LinkedList.get(i)は近いほうの端からノードを1つずつたどります。10 万件のリストなら最大 5 万回です。ランダムに 1 万回読むと 455ms、ArrayListは 0.08ms でした。LinkedListをfor (int i = 0; i < list.size(); i++) list.get(i)で回すコードは O(n²) で、コードレビューでいちばんよく見かける問題です。 - 先頭への追加:ここでは
LinkedListが約 240 倍速くなります。ArrayList.add(0, x)は既存の要素をすべて1つずつずらすからです。ただしArrayDequeもほぼ同じ時間で終わり、要素あたりのメモリも少なく済みます。 - 走査:連結リストが得意なはずの順次読み出しでも 2 倍遅くなりました。ノードが1つずつ別のオブジェクトなので、CPU は連続したメモリを読む代わりにポインタを追いかけることになります。
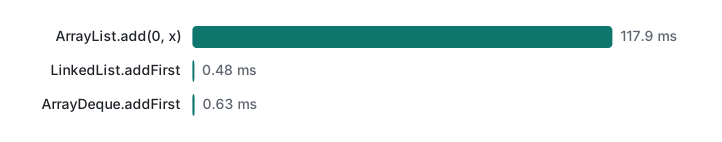
結論として、先頭を触るなら必要なのは Deque であり、既定の Deque は ArrayDeque です。アプリケーションのコードで LinkedList が最善だった例は、まだ見つけられていません。連結リストがなぜこう動くかは、連結リストを自作する記事で手を動かして確かめられます。
HashMap と TreeMap の検索、ArrayDeque と Stack
== 1,000,000 lookups, 100,000 String keys
HashMap.get                        median     9.623 ms  (min 9.493, max 10.595)
TreeMap.get                        median   259.214 ms  (min 238.363, max 322.357)
== push+pop 1,000,000 (stack use)
Stack push/pop                     median     4.674 ms  (min 4.252, max 5.679)
ArrayDeque push/pop                median     6.911 ms  (min 6.600, max 144.144)
TreeMap は 27 倍遅くなりました(4 回の実行で HashMap の中央値は 8.9〜17.2ms、TreeMap は 259〜380ms)。理由が2つ重なっています。キー 10 万件の赤黒木は深さ 17 前後なので、1回の検索で比較を 17 回ほど行います。ハッシュ1回と equals 1回程度で済む HashMap とは桁が違います。さらにキーが "user-12345" の形なので、compareTo は毎回共通の接頭辞 "user-" から1文字ずつ比べます。社員番号、URL、ファイルパスなど、実データのキーは接頭辞がそろっていることが多いものです。TreeMap が本領を発揮するのは firstKey()・headMap()・ceilingKey() やソート順の走査が必要なときで、検索だけなら選ぶべきマップではありません。木の構造そのものは 二分探索木の記事 を参照してください。
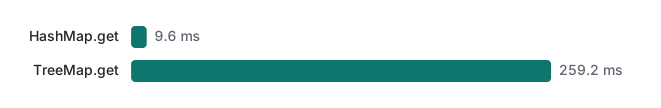
Stack の結果は予想外でした。よく「Stack は synchronized だから遅い」と言われますが、JDK 26 では競合のないロックは安く、4 回とも Stack は遅くありませんでした(中央値 4.7〜7.0ms、ArrayDeque は 5.3〜11.3ms、どちらも GC のぶれを含む)。したがって Stack を避ける理由は速度ではなく API です。
Stack<String> st = new Stack<>();
ArrayDeque<String> dq = new ArrayDeque<>();
for (String s : List.of("a", "b", "c")) { st.push(s); dq.push(s); }
System.out.println("Stack      " + st + "  peek=" + st.peek());
System.out.println("ArrayDeque " + dq + "  peek=" + dq.peek());
Stack      [a, b, c]  peek=c
ArrayDeque [c, b, a]  peek=c
peek() はどちらも c ですが、Stack は中身が Vector なので底から表示・走査します。ログに出したスタックの順序が逆に見えて混乱するのはこのためです。また誰でも st.get(0) や st.add(x) を呼んでスタックの規則を破れます。ArrayDeque は pop の順に走査し、両端キューの操作だけを公開します。制約は1つで、null を入れると NullPointerException になります。古いコードの Stack を置き換えるときは、null を積んでいないか先に確認してください。
ボクシングのコストと初期容量
List<Integer> が持っているのは数値ではなく Integer オブジェクトへの参照です。1,000 万件を合計してみます。
== sum of 10,000,000 ints
int[] sum                          median     3.281 ms  (min 3.205, max 3.306)
List<Integer> sum (0..999)         median     6.814 ms  (min 6.670, max 6.951)
List<Integer> sum (distinct)       median     6.764 ms  (min 6.663, max 6.869)
ボクシングしたリストは約 2 倍遅くなりました。値が 0〜999 の場合(Integer キャッシュから取られるので実体は 1,000 個だけ)と、0〜9,999,999 の場合(オブジェクト 1,000 万個)の両方を計りましたが、時間は同じでした。どちらも順番に確保されてメモリ上で隣り合っているためです。長時間動くサーバーでは生成時期ごとにオブジェクトが散らばるので、差は広がりがちです。より大きいのはメモリのコストです。圧縮ポインタを使う 64 ビット JVM では、リストの1要素が参照 4 バイトと Integer オブジェクト 16 バイト、int[] なら 4 バイトです。
初期容量は手軽に得られる改善です。新しい ArrayList は空で始まり、最初の add で 10 要素分を確保し、満杯になるたびに 50% ずつ増やして古い配列をコピーします。JDK 同梱の ThreadMXBean.getThreadAllocatedBytes で、現在のスレッドが確保したバイト数を計りました。
grow steps to reach 1000000: 29
allocated, default capacity : 14,586,416 bytes
allocated, new ArrayList<>(N): 4,000,040 bytes
median time, default  : 2.505 ms
median time, presized : 2.205 ms
容量を指定せずに 100 万件を入れると、捨てられた途中の配列のせいで確保量が 3.6 倍になり、時間は 12% ほど長くなりました。メモリの数字は正確で毎回同じ、時間の差は小さめです。CSV を読み込んで詰め替えるときのようにサイズがわかっているなら、渡しましょう。HashMap には Java 19 から、負荷係数 0.75 を考慮してくれる HashMap.newHashMap(n) があります。new HashMap<>(n) だと n 件入れる前にリサイズが起きます。
よくある間違い1:ConcurrentModificationException
ほぼ全員が最初に出会うコレクションの例外です。ループしながら偶数を消してみます。
import java.util.*;

public class Cme {
    public static void main(String[] args) {
        List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
        for (Integer n : nums) {
            if (n % 2 == 0) nums.remove(n);   // 走査中に remove(Object)
        }
        System.out.println(nums);
    }
}
実際に起きること(java Cme.java):
Exception in thread "main" java.util.ConcurrentModificationException
    at java.base/java.util.ArrayList$Itr.checkForComodification(ArrayList.java:1104)
    at java.base/java.util.ArrayList$Itr.next(ArrayList.java:1058)
    at Cme.main(Cme.java:6)
拡張 for 文は Iterator にコンパイルされます。ArrayList は構造が変わった回数を modCount フィールドで数え、イテレータは next() のたびにそれを比べます。スタックトレースの 6 行目が remove の行ではなく for の行である点に注意してください。削除そのものは成功し、ループの次の一歩がそれに気づいたのです。名前に "Concurrent" とありますが、スレッドとは関係ありません。
さらに悪いことに、このチェックはいつも働くわけではありません。最後から 2 番目の要素を消すと、next() が再び呼ばれる前にループが終わります。
List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4));
for (Integer n : nums) {
    if (n == 3) nums.remove(n);
}
System.out.println(nums);
[1, 2, 4]
例外なしで、たまたま動きました。こういうコードはテストデータでは通り、本番データで落ちます。Javadoc がこのチェックを "best-effort" と呼ぶのはこのためです。
対策: 意図をそのままコードにします。
List<Integer> a = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
a.removeIf(n -> n % 2 == 0);
System.out.println("removeIf      " + a);

List<Integer> b = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
for (Iterator<Integer> it = b.iterator(); it.hasNext(); )
    if (it.next() % 2 == 0) it.remove();
System.out.println("it.remove()   " + b);
removeIf      [1, 3, 5]
it.remove()   [1, 3, 5]
基本は removeIf です。ArrayList では配列を1回詰めるだけですが、it.remove() は呼ぶたびに後ろをずらします。削除ごとにログを残すなど、条件式1つで書きにくいときだけ明示的なイテレータを使います。
よくある間違い2:List.of は読み取り専用
List.of・Set.of・Map.of(Java 9 以降)は不変コレクションを返します。困るのは、型にそれが表れないことです。ただの List<String> です。
List<String> a = Arrays.asList("x", "y");
a.set(0, "X");                       // OK:サイズ固定なだけで読み取り専用ではない
System.out.println(a);
List<String> fixed = List.of("x", "y");
try { a.add("z"); } catch (UnsupportedOperationException e) { System.out.println("Arrays.asList add -> " + e); }
try { fixed.contains(null); } catch (NullPointerException e) { System.out.println("List.of contains(null) -> " + e); }
fixed.add("z");
[X, y]
Arrays.asList add -> java.lang.UnsupportedOperationException
List.of contains(null) -> java.lang.NullPointerException
Exception in thread "main" java.lang.UnsupportedOperationException
    at java.base/java.util.ImmutableCollections.uoe(ImmutableCollections.java:145)
    at java.base/java.util.ImmutableCollections$AbstractImmutableCollection.add(ImmutableCollections.java:150)
    at Immutable.main(Immutable.java:11)
1つのインターフェースの裏に、3 種類の契約が隠れています。Arrays.asList はサイズ固定なだけで set はできます。List.of はあらゆる変更を拒否し、null も拒否します。contains(null) ですら例外です。コンパイラはどれも検出せず、実行して初めてわかります。変更するつもりならコピーしましょう。上の例で使っている new ArrayList<>(List.of(...)) がその書き方です。
順序付きコレクション(Java 21):getFirst、getLast、reversed
Java 21 より前は「最後の要素」を、リストなら list.get(list.size() - 1)、両端キューなら deque.peekLast()、LinkedHashSet ならループで取っていました。Java 21 の SequencedCollection・SequencedSet・SequencedMap インターフェースが、これを1つの語彙にまとめました。
List<String> list = new ArrayList<>(List.of("mon", "tue", "wed"));
System.out.println(list.getFirst() + " " + list.getLast() + " " + list.reversed());
LinkedHashMap<String, Integer> lhm = new LinkedHashMap<>();
lhm.put("x", 1); lhm.put("y", 2); lhm.putFirst("w", 0);
System.out.println(lhm + " first=" + lhm.firstEntry() + " reversed=" + lhm.reversed());
LinkedHashSet<String> set = new LinkedHashSet<>(List.of("b", "c"));
set.addFirst("a");
System.out.println(set + " last=" + set.getLast());
List<String> rev = list.reversed();
rev.add("thu");          // 元のリストに反映される:元の先頭に追加
System.out.println("original after rev.add: " + list);
mon wed [wed, tue, mon]
{w=0, x=1, y=2} first=w=0 reversed={y=2, x=1, w=0}
[a, b, c] last=c
original after rev.add: [thu, mon, tue, wed]
2 点を覚えておいてください。reversed() はコピーではなくビューです。ビューの末尾に追加したら、元のリストの先頭に "thu" が入りました。また空のリストの getFirst() は NoSuchElementException を投げます。null を返す両端キューの peekFirst() とは違います。バージョンも確認しました。同じコードを javac --release 20 でコンパイルすると error: cannot find symbol ... method getFirst() で失敗し、--release 21 では通ります。
判断表
| 必要なもの | 使うもの | 避けるもの | 根拠(上の実測) |
|---|---|---|---|
| 添字で読むリスト | ArrayList |
LinkedList |
get(i) 1 万回:0.08ms 対 455ms |
| キュー・スタック・両端 | ArrayDeque |
Stack、ArrayList.add(0, x) |
先頭追加 0.63ms 対 118ms、Stack は Vector のメソッドが見える |
| キーで引くだけ | HashMap |
TreeMap |
100 万回の検索 9.6ms 対 259ms |
| ソート済みのキー、範囲、最も近いキー | TreeMap |
毎回 HashMap をソート |
ceilingKey、headMap、firstKey |
| 挿入順を保つ | LinkedHashMap / LinkedHashSet |
HashMap の順序に期待 |
HashMap の順序は規定されていない |
| 数百万件の数値 | int[]、long[] |
List<Integer> |
合計が 2 倍遅い、メモリ約 5 倍 |
| サイズがわかっている | new ArrayList<>(n)、HashMap.newHashMap(n) |
既定の容量 | 100 万件で確保量 3.6 倍の差 |
| 走査中の削除 | removeIf、iterator.remove() |
拡張 for 内の list.remove() |
例外、または運任せの成功 |
| 定数リスト | List.of |
add を呼ぶコードに渡す |
実行時に UnsupportedOperationException |
限界とバージョンのメモ
- JMH ではありません。 ウォームアップと中央値はありますが、JVM のフォーク、ブラックホール、誤差範囲はありません。2 倍以上の差は信じてよく、20% 以下は「ほぼ同じ」と見てください。最大値が跳ねているのは GC の停止です(
ArrayDequeで一度 144ms)。 - マシンは1台。 Apple Silicon(M1 Pro)、OpenJDK 26、既定の G1 GC。x86 のサーバーではキャッシュサイズが違うので、比率はおおむね保たれても絶対値は変わります。
- 確認したバージョン:
List.ofは Java 9 から(--release 8はcannot find symbol ... method of(String,String)で失敗、--release 9は成功)。順序付きコレクションは Java 21 から(--release 20と21で確認)。HashMap.newHashMapは Java 19 から(--release 18で失敗、19で成功)。それ以外は 26 でのみ実行しました。 - 並行コレクション(
ConcurrentHashMap、CopyOnWriteArrayList)は計っていません。第 5 回 仮想スレッドと並行処理で扱います。 - C# を知っている方は C# のジェネリックコレクション と比べてみてください。Java 特有の落とし穴はボクシングと
Stack extends Vectorです。
自分で動かす
CollBench.java として保存し、java -Xms3g -Xmx3g CollBench.java で実行します(ヒープ約 3GB、1 分ほどかかります)。
import java.util.*;
import java.util.function.*;

public class CollBench {
    static long sink;

    static double measure(String name, int warmup, int runs, LongSupplier task) {
        for (int i = 0; i < warmup; i++) sink += task.getAsLong();
        double[] t = new double[runs];
        for (int i = 0; i < runs; i++) {
            long s = System.nanoTime();
            sink += task.getAsLong();
            t[i] = (System.nanoTime() - s) / 1e6;
        }
        Arrays.sort(t);
        System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n", name, t[runs / 2], t[0], t[runs - 1]);
        return t[runs / 2];
    }

    public static void main(String[] args) {
        final int N = 100_000;
        Random rnd = new Random(42);
        int[] idx = new int[10_000];
        for (int i = 0; i < idx.length; i++) idx[i] = rnd.nextInt(N);

        List<Integer> al = new ArrayList<>(), ll = new LinkedList<>();
        for (int i = 0; i < N; i++) { al.add(i); ll.add(i); }
        System.out.println("== get(i) x 10,000 random indexes, size 100,000");
        measure("ArrayList.get", 5, 7, () -> { long s = 0; for (int i : idx) s += al.get(i); return s; });
        measure("LinkedList.get", 2, 5, () -> { long s = 0; for (int i : idx) s += ll.get(i); return s; });

        System.out.println("== add(0, x) x 50,000 into an empty list");
        measure("ArrayList.add(0,x)", 3, 5, () -> { List<Integer> l = new ArrayList<>(); for (int i = 0; i < 50_000; i++) l.add(0, i); return l.size(); });
        measure("LinkedList.addFirst", 3, 5, () -> { LinkedList<Integer> l = new LinkedList<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });
        measure("ArrayDeque.addFirst", 3, 5, () -> { ArrayDeque<Integer> l = new ArrayDeque<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });

        System.out.println("== for-each over 1,000,000 elements");
        List<Integer> al2 = new ArrayList<>(), ll2 = new LinkedList<>();
        for (int i = 0; i < 1_000_000; i++) { al2.add(i % 1000); ll2.add(i % 1000); }
        measure("ArrayList iterate", 10, 9, () -> { long s = 0; for (int v : al2) s += v; return s; });
        measure("LinkedList iterate", 10, 9, () -> { long s = 0; for (int v : ll2) s += v; return s; });

        System.out.println("== 1,000,000 lookups, 100,000 String keys");
        Map<String, Integer> hm = new HashMap<>(), tm = new TreeMap<>();
        String[] keys = new String[N];
        for (int i = 0; i < N; i++) { keys[i] = "user-" + i; hm.put(keys[i], i); tm.put(keys[i], i); }
        String[] q = new String[1_000_000];
        for (int i = 0; i < q.length; i++) q[i] = keys[rnd.nextInt(N)];
        measure("HashMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += hm.get(k); return s; });
        measure("TreeMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += tm.get(k); return s; });

        System.out.println("== push+pop 1,000,000 (stack use)");
        measure("Stack push/pop", 5, 7, () -> { Stack<Integer> st = new Stack<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });
        measure("ArrayDeque push/pop", 5, 7, () -> { ArrayDeque<Integer> st = new ArrayDeque<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });

        System.out.println("== sum of 10,000,000 ints");
        int M = 10_000_000;
        int[] arr = new int[M];
        List<Integer> boxed = new ArrayList<>(M);
        for (int i = 0; i < M; i++) { arr[i] = i % 1000; boxed.add(i % 1000); }
        measure("int[] sum", 10, 9, () -> { long s = 0; for (int v : arr) s += v; return s; });
        measure("List<Integer> sum (0..999)", 10, 9, () -> { long s = 0; for (int v : boxed) s += v; return s; });
        List<Integer> boxedBig = new ArrayList<>(M);
        for (int i = 0; i < M; i++) boxedBig.add(i);
        measure("List<Integer> sum (distinct)", 10, 9, () -> { long s = 0; for (int v : boxedBig) s += v; return s; });
        System.out.println("sink=" + (sink != 0));
    }
}
(初期容量の数字は com.sun.management.ThreadMXBean を使った 40 行ほどの別プログラムで計りました。計り方は同じです。)
よくある質問
古いコードの Stack や Vector は ArrayDeque や ArrayList に置き換えるべきですか?
新規コードでは置き換えを勧めますが、理由は速度ではありません。JDK 26 の実測では push/pop 100 万回で Stack と ArrayDeque はどちらも約 5ms でした。Stack は Vector を継承しているため get(i) や add() でスタックの規則を破れ、出力と走査の順序が底からになります。
拡張 for 文の中で list.remove() すると ConcurrentModificationException になるのはなぜですか?
拡張 for 文は Iterator にコンパイルされ、ArrayList の Iterator は next() のたびに変更回数(modCount)を確認します。ループ内で remove すると回数が変わり、次の next() で例外になります。最後から 2 番目の要素を消すと例外が出ずに通ることもあり、より危険です。removeIf か iterator.remove() を使います。
HashMap と TreeMap はどれくらい速度が違いますか?
"user-12345" のような String キー 10 万件から 100 万回引くと、HashMap は 9.6ms、TreeMap は 259.2ms で約 27 倍でした(JDK 26、Apple Silicon Mac)。TreeMap はキーのソート順や範囲検索が必要なときに選びます。