Pruebas inestables (flaky): reloj, azar, orden e hilos
Reproduce cinco tipos de pruebas flaky en Python, mide su tasa de fallos (de 8% a 70%) y llévala a 0 con reloj UTC, semillas, limpieza, locks y eventos.
Serie: curso de pruebas y depuración 5/6 (avanzado). Para quien tiene un CI "casi siempre en verde" y ya empezó a darle a "volver a ejecutar" sin preguntarse por qué. Al terminar vas a poder reproducir una prueba inestable cuando quieras, medir su tasa de fallos y quitar la causa en lugar del síntoma.
Seguro te pasó en el primer trabajo, o en el proyecto final del bootcamp: el pipeline falla, alguien escribe "lo volví a correr y pasó" y todos siguen. Si haces freelance, es peor: el cliente ve la insignia roja del CI en su repositorio y te pregunta si el código está roto. Eso es una prueba flaky (inestable): pasa o falla con el mismo código. Su costo no son solo las reejecuciones; el equipo aprende a ignorar los builds en rojo y la única falla real se esconde entre el ruido. En esta clase tomamos las cinco causas más comunes (el reloj, el azar, el orden de las pruebas, los hilos y los sleep fijos), hacemos fallar cada una a propósito, contamos cuántas veces falla, la arreglamos y volvemos a contar.
Entorno: Python 3.9.6 (el Python del sistema en macOS), solo unittest, sin plugins, una Mac con Apple Silicon (M1 Pro), 8 núcleos. Cada tasa es un conteo real con su N al lado. Las semillas están fijas donde el azar no es el tema. Las rutas están acortadas a ~/demo/…. Esta clase se apoya en la clase 3, primeras pruebas unitarias, y en la clase 4, dobles de prueba y fixtures.
Qué significa "flaky" y la única regla para arreglarla
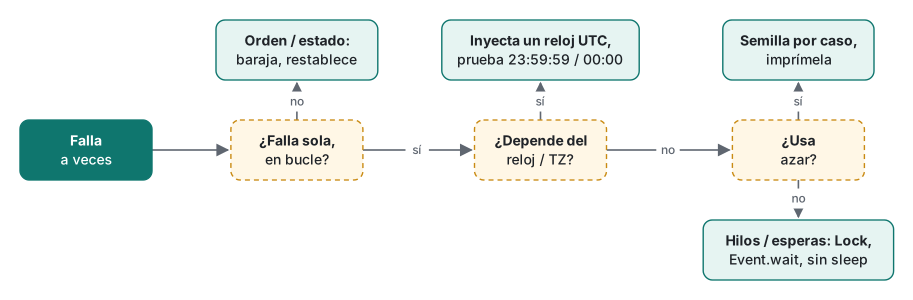
Una prueba flaky tiene una entrada oculta. El código bajo prueba es el mismo cada vez, pero algo que la prueba no controla cambia entre corridas: el reloj, el generador de números aleatorios, qué prueba corrió antes, cómo el sistema operativo reparte los hilos, qué tan ocupada está la máquina. El arreglo siempre sigue la misma idea: encontrar la entrada oculta y convertirla en una entrada explícita.
La regla que te mantiene honesto: una prueba flaky no está arreglada hasta que mides su tasa de fallos, antes y después, con el mismo N. Un verde después de reejecutar no significa nada si la prueba ya estaba en verde la mayoría de las veces. Por eso cada sección de abajo tiene un número de "antes" y uno de "después".
La herramienta de medición más simple es un bucle de reejecución, y funciona con cualquier runner:
fails=0
for i in $(seq 1 100); do
  python3 -m unittest -q test_coupon 2>/dev/null || fails=$((fails + 1))
done
echo "$fails/100 failed"
Causa 1: azar sin semilla
Un generador de códigos de descuento. La especificación dice que un código debe tener al menos un dígito, y la prueba revisa exactamente eso:
# coupon.py
import random
import string

ALPHABET = string.ascii_letters + string.digits   # 62 caracteres

def make_code(length=8, rng=random):
    """Devuelve un código de descuento. Especificación: al menos un dígito."""
    return "".join(rng.choice(ALPHABET) for _ in range(length))
# test_coupon.py
class CouponTest(unittest.TestCase):
    def test_code_has_a_digit(self):
        code = make_code()
        self.assertTrue(any(c.isdigit() for c in code), code)
Ocho corridas seguidas imprimieron OK, FAILED, OK, FAILED, OK, OK, FAILED, OK. Una corrida que falla se ve así:
FAIL: test_code_has_a_digit (test_coupon.CouponTest)
----------------------------------------------------------------------
Traceback (most recent call last):
  File "~/demo/flaky/test_coupon.py", line 8, in test_code_has_a_digit
    self.assertTrue(any(c.isdigit() for c in code), code)
AssertionError: False is not true : ZYRtMYHA
La prueba tiene razón; el código está mal. Nada garantiza que aparezca un dígito. La probabilidad de que los 8 caracteres salgan de las 52 letras es (52/62)^8 = 24.48%. Lo medimos: 2,509 fallos en 10,000 llamadas (25.09%), y 2,487 (24.87%) en una segunda corrida.
Error común → qué pasa en realidad → arreglo. El primer instinto es poner random.seed(1) al inicio de la prueba. Con la semilla 1 el código es iK2ZWeqh, tiene un dígito, y la prueba pasa para siempre. Con la semilla 4 sería ptgUzEjf y fallaría para siempre. Fijar la semilla no arregla el bug; congela el volado, y solo te enteras de qué lado cayó. La versión útil corre muchas semillas, y cada fallo dice qué semilla lo reproduce:
SEED = int(os.environ.get("TEST_SEED", "14"))

class CouponTest(unittest.TestCase):
    def check_many(self, fn):
        master = random.Random(SEED)
        for i in range(200):
            seed = master.randrange(2**32)
            code = fn(rng=random.Random(seed))
            with self.subTest(seed=seed):
                self.assertTrue(any(c.isdigit() for c in code), f"{code} (seed={seed})")
Ahora el bug falla en cada corrida, de forma determinista: con TEST_SEED=14, FAILED (failures=45) de 200 casos; el primero, MOZdpuqf (seed=4038782778), y make_code(rng=random.Random(4038782778)) devuelve otra vez MOZdpuqf en un REPL. El arreglo real está en el código: meter un dígito a propósito.
def make_code_fixed(length=8, rng=random):
    chars = [rng.choice(ALPHABET) for _ in range(length - 1)]
    chars.insert(rng.randrange(length), rng.choice(string.digits))
    return "".join(chars)
Después: 0 fallos en 10,000 semillas. De aquí salen dos hábitos: recibe el generador como parámetro (rng=random) para que las pruebas lo controlen, e imprime siempre la semilla.
Causa 2: el reloj, la medianoche y el horario de verano
Esta duele más a quien está de guardia, porque falla de noche. Una etiqueta de fecha de vencimiento:
# due.py
from datetime import date, datetime, timedelta, timezone

def due_label(due: date, today: date) -> str:
    if due == today:
        return "today"
    if due == today + timedelta(days=1):
        return "tomorrow"
    return "later" if due > today else "overdue"

def label_for_now_flaky(due: date) -> str:
    return due_label(due, datetime.now().date())          # reloj local

def label_for(due: date, now_utc: datetime) -> str:       # un solo reloj, recibido
    return due_label(due, now_utc.astimezone(timezone.utc).date())
La prueba flaky construye "mañana" en UTC y lo compara con la fecha local:
def test_tomorrow(self):
    due = (datetime.now(timezone.utc) + timedelta(days=1)).date()   # fecha UTC
    self.assertEqual(label_for_now_flaky(due), "tomorrow")          # fecha local
Con TZ=UTC pasa. La corrimos cerca de las 06:00 UTC con el reloj de la máquina en una zona 8 horas detrás de UTC (TZ=XST8, un nombre inventado), donde todavía es "ayer":
AssertionError: 'later' != 'tomorrow'
- later
+ tomorrow
¿Qué tan seguido falla? Depende de la hora, así que en lugar de esperar recorrimos con un reloj fijo los 1,440 minutos de un día UTC y evaluamos la misma lógica en cada minuto:
| Reloj de la máquina | Minutos con fallo (de 1,440) | Tasa | Primer fallo (UTC) | Después del arreglo |
|---|---|---|---|---|
| UTC-8 | 480 | 33.3% | 00:00 | 0 |
| UTC-5 | 300 | 20.8% | 00:00 | 0 |
| UTC | 0 | 0% | ninguno | 0 |
| UTC+3 | 180 | 12.5% | 21:00 | 0 |
Esa tabla explica el reporte clásico "solo falla en el servidor de CI, y solo en la tarde": el CI corre en UTC, tu laptop no, y la ventana de fallos dura exactamente la diferencia horaria. Si trabajas con clientes en otro país, esto te va a pasar.
Las pruebas arregladas reciben el reloj y fijan los bordes, así significan lo mismo a cualquier hora:
class FixedDueTest(unittest.TestCase):
    def check(self, now):
        due = (now + timedelta(days=1)).date()
        self.assertEqual(label_for(due, now), "tomorrow")

    def test_tomorrow_one_second_before_midnight(self):
        self.check(datetime(2026, 11, 14, 23, 59, 59, tzinfo=timezone.utc))

    def test_tomorrow_at_midnight(self):
        self.check(datetime(2026, 11, 15, 0, 0, tzinfo=timezone.utc))

    def test_month_and_year_end(self):
        self.check(datetime(2026, 12, 31, 23, 30, tzinfo=timezone.utc))
Horario de verano (DST). Un día no siempre dura 86,400 segundos. Convertimos medianoches locales a timestamps bajo una zona inventada con horario de verano (TZ="XST5XDT,M3.2.0,M11.1.0", que cambia el segundo domingo de marzo y el primer domingo de noviembre) y dividimos entre 86,400:
2026-03-08 -> 2026-03-09 23 h int(seconds/86400) = 0 | date subtraction = 1
2026-11-01 -> 2026-11-02 25 h int(seconds/86400) = 1 | date subtraction = 1
int(seconds / 86400) dice que entre el 8 y el 9 de marzo hay 0 días. Con TZ=UTC los cuatro pares dieron 24 h. Restar objetos date siempre da lo correcto. Guarda y compara instantes en UTC; convierte a hora local solo para mostrar.
Error común: hacer patch de datetime.now. El mock obvio falla con el tipo integrado:
  File "…/python3.9/unittest/mock.py", line 1502, in __enter__
    setattr(self.target, self.attribute, new_attr)
TypeError: can't set attributes of built-in/extension type 'datetime.datetime'
Puedes reemplazar el nombre datetime dentro de tu propio módulo con una subclase cuyo now() devuelva un valor fijo (lo hicimos, y la función flaky devolvió tomorrow a las 23:59:59). Pero pasar el reloj como argumento es más simple y deja la dependencia a la vista en la firma de la función.
Causa 3: el orden de las pruebas y el estado compartido
"Pasa sola, falla en la suite" casi siempre significa estado compartido. Un módulo de precios con IVA del 16%:
# pricing.py
DEFAULTS = {"tax_rate": 0.16, "currency": "MXN"}
config = DEFAULTS            # bug 1: un alias, no una copia

def set_option(key, value):
    config[key] = value

def price_with_tax(amount):
    return round(amount * (1 + config["tax_rate"]), 2)
class PricingTest(unittest.TestCase):
    def test_default_tax(self):
        self.assertEqual(pricing.price_with_tax(100), 116.0)

    def test_zero_tax_promo(self):
        pricing.set_option("tax_rate", 0.0)       # bug 2: nunca se deshace
        self.assertEqual(pricing.price_with_tax(100), 100)

    def test_rounding(self):
        self.assertEqual(pricing.price_with_tax(250), 290.0)
unittest corre los métodos en orden alfabético, así que test_zero_tax_promo corre de casualidad al final y la suite queda en verde. Agrega una prueba cuyo nombre quede después, o reparte la suite entre workers en paralelo, y se rompe. python3 -m unittest en Python 3.9 no tiene opción para barajar, así que escribimos un runner de unas 25 líneas que carga las pruebas, las baraja con random.Random(seed) para las semillas 0 a 199 y vuelve a importar los módulos cada vez para empezar con estado limpio. Resultado: 139 de 200 órdenes fallaron (teoría: 2/3, la prueba promo tiene que ir al final). El primer orden con fallo fue el de la semilla 0:
first failing order (seed 0): ['test_default_tax', 'test_zero_tax_promo', 'test_rounding']
AssertionError: 250.0 != 290.0
El arreglo tiene dos partes, una por bug. En el código, config = dict(DEFAULTS) más una función reset(). En las pruebas, una limpieza que corre aunque falle la aserción:
class PricingTest(unittest.TestCase):
    def setUp(self):
        self.addCleanup(pricing.reset)          # corre aunque la prueba falle

    def test_zero_tax_promo_patch_dict(self):
        with mock.patch.dict(pricing.config, {"tax_rate": 0.0}):
            self.assertEqual(pricing.price_with_tax(100), 100)
Después: 0 de 200 órdenes barajados fallaron. Fíjate que con config = DEFAULTS ni siquiera reset() habría servido, porque los "valores por defecto" también se estaban modificando.
Causa 4: una carrera entre hilos
Cuatro hilos suman cada uno 50,000 visitas en un contador compartido:
class HitCounter:
    def __init__(self):
        self.value = 0
    def hit(self):
        self.value += 1            # leer, sumar, escribir: tres pasos
La prueba espera 200,000. Seis corridas imprimieron 194148, 156216, 199794, OK, 104471, OK. El GIL no hace atómico a +=: Python puede cambiar de hilo entre la lectura y la escritura. Cambia más o menos cada sys.getswitchinterval() segundos, 0.005 en esta máquina, y eso explica un patrón sorprendente que medimos:
| Configuración (100 corridas cada una) | Fallos | Tiempo por corrida |
|---|---|---|
| sin lock, 4 x 10,000 | 0 | 6.2 ms |
| sin lock, 4 x 20,000 | 0 | 12.2 ms |
| sin lock, 4 x 40,000 | 23 | 24.2 ms |
| sin lock, 4 x 50,000 | 54 | 30.4 ms |
| sin lock, 4 x 60,000 | 46 | 36.4 ms |
sin lock, 4 x 1,000, sys.setswitchinterval(1e-6) |
100 | 2.3 ms |
threading.Lock, 4 x 1,000, setswitchinterval(1e-6) |
0 | 5.9 ms |
threading.Lock, 4 x 50,000 |
0 | 59.9 ms |
La prueba pequeña (10,000 por hilo) nunca falló, porque cada hilo terminaba su trabajo dentro de una sola porción de 5 ms. Así es como las condiciones de carrera sobreviven a la revisión de código y a las pruebas unitarias, y aparecen en producción con carga real. El truco para recordar es la sexta fila: achicar el intervalo de cambio convierte una carrera rara en una reproducible al 100%, en una prueba de 2 ms. Cuando la prueba ya falla siempre, agrega el lock y la misma configuración dura lo comprueba:
class SafeHitCounter:
    def __init__(self):
        self.value = 0
        self._lock = threading.Lock()
    def hit(self):
        with self._lock:
            self.value += 1
El lock duplicó el costo aquí (59.9 ms contra 30.4 ms para 200,000 visitas): está bien para un contador, y vale la pena medirlo en código que corre muchísimo. Para ver cómo el GIL reparte los hilos, revisa hilos, procesos y asyncio (en inglés); para un event loop de un solo hilo con sus propias sorpresas de orden, promesas y event loop en JavaScript (en inglés).
Causa 5: esperas con sleep
Un worker en segundo plano calcula un resultado, y la prueba "espera lo suficiente":
class ThumbnailWorker:
    def __init__(self):
        self.result = None
        self.done = threading.Event()

    def submit(self, n):
        def run():
            self.result = sum(i * i for i in range(n))   # unos 16 ms de CPU
            self.done.set()
        threading.Thread(target=run, daemon=True).start()
w = ThumbnailWorker(); w.submit(400_000)
time.sleep(0.02)                      # "con esto alcanza"
assert w.result is not None
Con la máquina tranquila: 0 de 200 corridas fallaron. Luego agregamos algo que una suite real suele tener: un hilo ocupado con CPU que otra prueba olvidó detener. Cuatro tandas de 200 corridas fallaron 17, 9, 19 y 21 veces (8.3% en promedio). El hilo ocupado se queda con el GIL la mitad del tiempo, así que el trabajo de 16 ms tarda casi el doble. Curiosamente, la carga a nivel del sistema operativo (12 procesos quemando CPU en 8 núcleos) produjo solo 1 fallo en 200; el disparador real era el hilo dentro del mismo proceso.
| Forma de esperar (con hilo ocupado, 200 corridas) | Fallos | Espera promedio |
|---|---|---|
time.sleep(0.02) |
9 a 21 | 33 ms |
time.sleep(0.05) |
0 | 63.4 ms |
w.done.wait(timeout=5) |
0 | 20.1 ms |
El sleep más largo "arregla" la inestabilidad haciendo lenta cada corrida. Esperar el evento es confiable y además lo más rápido, porque regresa en cuanto termina el trabajo; el timeout solo está para que un bug real falle en lugar de colgarse.
Ese hilo olvidado merece su propia prueba. Esta clase base hace fallar a cualquier prueba que deje un hilo corriendo:
class NoLeakedThreads(unittest.TestCase):
    def setUp(self):
        before = set(threading.enumerate())
        def check():
            leaked = [t.name for t in threading.enumerate() if t not in before and t.is_alive()]
            self.assertEqual(leaked, [], "test left threads running")
        self.addCleanup(check)
Una prueba que arrancó un hilo poller y olvidó detenerlo falló con AssertionError: Lists differ: ['poller'] != [], y después todo el proceso se quedó colgado tras imprimir FAILED, porque un hilo que no es daemon mantiene vivo a Python. Tuvimos que matarlo a los 5 segundos (salida 142, por alarm). Si tu job de CI "se cuelga cuando las pruebas ya terminaron", busca exactamente esto.
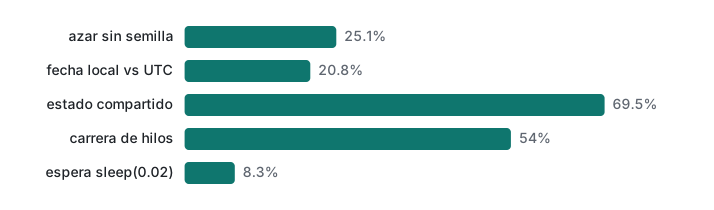
Antes y después, en una tabla
| Causa | Antes | Después | Arreglo |
|---|---|---|---|
| Azar sin semilla | 2,509/10,000 (25.09%) | 0/10,000 semillas | garantiza la propiedad en el código; semilla por caso, imprímela |
| Fecha local vs UTC | 300/1,440 minutos en UTC-5 | 0/1,440 | inyecta un reloj UTC; prueba 23:59:59 y 00:00 |
| Estado compartido, orden barajado | 139/200 órdenes | 0/200 | copia los valores por defecto; addCleanup(reset); patch.dict |
| Carrera de hilos, 4 x 50,000 | 54/100 | 0/100 | threading.Lock; reprodúcela con setswitchinterval(1e-6) |
sleep(0.02), hilo ocupado |
66/800 | 0/200 | Event.wait(timeout=…); detecta hilos olvidados |
¿Cuarentena o borrar? Si no puedes arreglar una prueba flaky hoy, márcala con claridad (por ejemplo @unittest.skip("flaky: issue-123, 54/100")) junto con su tasa medida, para que deje de entrenar al equipo a ignorar los builds en rojo. Nunca dejes que "reintentar tres veces" se vuelva el arreglo permanente: en la clase 6 medimos cómo una prueba que falla 10% de las veces hace que git bisect culpe al commit equivocado.
Límites honestos y notas de versión
- Todo corrió solo con Python 3.9.6.
sys.setswitchintervalexiste desde Python 3.2. Las versiones free-threaded de Python (3.13+) y otras versiones pueden tener otras tasas de carrera; no las corrimos. python3 -m unittesten 3.9 no tiene orden aleatorio integrado. Existen plugins como pytest-randomly, pero no se instalaron ni se corrieron aquí.- La demo de horario de verano usa una cadena de zona POSIX inventada, no una región real; las reglas reales vienen de la base de datos tz y cambian por ley.
- Las tasas dependen de la máquina. Toma nuestros números como "así de grande puede ser" y mide los tuyos con el bucle de arriba.
- Al depurar un fallo flaky, los logs que incluyen la semilla, el valor del reloj y el orden de las pruebas hacen reproducible la siguiente vez. Un ejemplo donde los logs, y no una corazonada, encontraron la causa real: el diagnóstico equivocado de un agente de IA, atrapado por los logs (en inglés). Para ver dónde encaja esta serie, la ruta de estudio para tu primer trabajo.
Ejercicios
- Una prueba revisa que
shuffle_deck()nunca repita una carta. Falló una vez en el CI la semana pasada. ¿Qué dos cosas agregas antes que nada? - Un reporte usa
date.today()para elegir el archivo "de ayer". El CI corre en UTC; el servidor del cliente no. ¿Qué valores fijas en las pruebas?
Respuestas
- Recibir el generador en
shuffle_deck(rng=...)y correr muchas semillas consubTest, imprimiendo la semilla al fallar; luego medir la tasa en un bucle antes de tocar el código. Un fallo que se vio una vez es real hasta que una medición diga lo contrario. - Pasa
now(en UTC) a la función y prueba al menos 23:59:59 y 00:00:00 UTC, el primer día de un mes y el 1 de enero. Si la función tiene que usar la hora local, prueba también una fecha de cambio de horario con una zona fija.
Anterior: Curso de pruebas y depuración 4: dobles de prueba, mocks y fixtures · Siguiente: Curso de pruebas y depuración 6: cazar regresiones con git bisect
Preguntas frecuentes
¿Cómo demuestro que arreglé una prueba flaky?
Mide su tasa de fallos antes y después, con el mismo N. Córrela en un bucle (usamos de 100 a 10,000 corridas), baraja el orden de las pruebas con semillas fijas o recorre con un reloj fijo cada minuto de un día. Nuestras pruebas fallaban 25%, 21%, 70%, 54% y 8% de las veces antes del arreglo y 0 veces con el mismo número de corridas después. Un solo CI en verde no demuestra nada.
¿Por qué mi prueba pasa sola pero falla cuando corre toda la suite?
Otra prueba cambió un estado compartido (un dict a nivel de módulo, un singleton, una variable de entorno, un archivo) y no lo devolvió. En nuestra demo, una prueba ponía el impuesto en 0 y nunca lo restablecía: 139 de 200 órdenes barajados fallaron. Restablece el estado con addCleanup en setUp, o usa unittest.mock.patch.dict, y copia los dicts de valores por defecto en lugar de crear un alias.
¿Por qué no puedo hacer mock de datetime.datetime.now directamente?
datetime.datetime es un tipo integrado y sus atributos no se pueden reemplazar. En Python 3.9.6, mock.patch('datetime.datetime.now') lanzó TypeError: can't set attributes of built-in/extension type 'datetime.datetime'. Pasa la hora actual a tu función como argumento (un reloj), o reemplaza el nombre datetime dentro de tu propio módulo con una subclase.