Depurar con print, logging y un depurador
Cuándo usar print, logging o un depurador: sesión real de pdb, post-mortem, lldb con un crash en C, patito de goma, repro mínimo y el costo del logging.
Serie: curso de pruebas y depuración 2/6 (principiante). Para quien depura llenando el código de print y cruzando los dedos. Al terminar vas a poder elegir entre print, logging y un depurador, seguir un bug real con pdb y lldb, y reducir un bug confuso a una reproducción de dos líneas.
La clase 1 trató sobre leer el reporte que deja un programa cuando se cae. La mayoría de los bugs no se caen. El total sale mal, un reporte elige la fila equivocada, un bucle nunca termina. Ese es el problema que resuelve esta clase, tanto si estás en un bootcamp como en tu primer trabajo o atendiendo a un cliente freelance que dice "el descuento no se aplica": el programa corre, la respuesta está mal y nadie te da un stack trace.
Todo se ejecutó en una Mac con Apple Silicon (M1 Pro) con Python 3.9.6, PHP 8.5.6, Apple clang 21 y lldb-2103. Las rutas se acortaron a ~/demo/.
El bug que vamos a perseguir
Una tienda aplica un cupón del 10 %. Este es el código que te entregan en el proyecto final del bootcamp:
import sys


def apply_discount(price, percent):
    return price - price * percent // 100


def cart_total(items, percent):
    total = 0
    for name, price, qty in items:
        total += apply_discount(price, percent) * qty
    return total


CART = [("lápiz", 120, 3), ("cuaderno", 300, 2)]
COUPON = {"BOOTCAMP10": 0.1, "BROKEN": None}   # bug: 0.1 should be 10

if __name__ == "__main__":
    print(cart_total(CART, COUPON[sys.argv[1]]))
$ python3 discount.py BOOTCAMP10
960.0
El total esperado es 108 × 3 + 270 × 2 = 864. Salió 960, que es el precio sin descuento, y además es un float (número decimal). Ni excepción ni traceback. El comentario delata el bug, claro; lo importante es ver qué te habría dicho cada herramienta sin él.

Depurar con print, y la trampa de C que se come tus prints
El primer instinto es poner print(price, percent) dentro de apply_discount. Funciona, y para un script de diez líneas es la herramienta correcta. En cuanto el código crece aparecen dos problemas:
- Los print no tienen nivel, así que no puedes apagarlos sin editar el código, y los que olvidas terminan en la salida de producción.
- La salida puede quedar en un búfer: guardada en memoria para escribirse después. Si el programa se cae antes, se pierde.
Lo segundo no es teoría. Este programa en C busca tres ids de usuario; el id 7 no existe, así que find_user devuelve NULL:
#include <stdio.h>
#include <string.h>

struct user { int id; const char *name; };

static struct user USERS[] = { {1, "lucia"}, {2, "mateo"}, {3, "sofia"} };

static struct user *find_user(int id) {
    for (size_t i = 0; i < sizeof USERS / sizeof USERS[0]; i++)
        if (USERS[i].id == id) return &USERS[i];
    return NULL;                       /* not found */
}

static size_t name_length(int id) {
    struct user *u = find_user(id);
    return strlen(u->name);            /* crashes when u == NULL */
}

int main(void) {
    int ids[] = {2, 3, 7};
    for (int i = 0; i < 3; i++)
        printf("id=%d len=%zu\n", ids[i], name_length(ids[i]));
    return 0;
}
$ clang -std=c17 -Wall -Wextra -g -O0 users.c -o users
$ ./users > out.txt; echo "exit=$?"; wc -c < out.txt
exit=139
       0
Se imprimieron dos líneas antes del crash, pero el archivo está vacío. Cuando stdout va a un archivo o a un pipe, C lo guarda en un búfer por bloques; el crash (salida 139, un segmentation fault) mató el proceso antes de que el bloque se escribiera. En una terminal habrías visto las líneas, porque la terminal usa búfer por líneas. Al cambiar printf por fprintf(stderr, …), que no usa búfer, obtuvimos las dos líneas (id=2 len=5, id=3 len=5) antes del mismo exit 139. Por esto "el log se corta justo antes del crash" engaña a tanta gente cuando hay una caída en producción.
lldb: ¿dónde se cayó el programa en C, y con qué?
No hacen falta prints. Compila con -g (información de depuración) y deja que el depurador atrape el crash. Le pasamos a lldb un archivo de comandos (run, bt, frame variable, up, frame variable, quit) con lldb -s lldb.txt ./users (recortamos los mensajes de arranque y parte del listado de código):
(lldb) run
id=2 len=5
id=3 len=5
Process 37131 stopped
* thread #1, queue = 'com.apple.main-thread', stop reason = EXC_BAD_ACCESS (code=1, address=0x8)
    frame #0: 0x0000000100000634 users`name_length(id=7) at users.c:16:22
   14   static size_t name_length(int id) {
   15       struct user *u = find_user(id);
-> 16       return strlen(u->name);            /* crashes when u == NULL */
(lldb) bt
* thread #1, queue = 'com.apple.main-thread', stop reason = EXC_BAD_ACCESS (code=1, address=0x8)
  * frame #0: 0x0000000100000634 users`name_length(id=7) at users.c:16:22
    frame #1: 0x00000001000005b4 users`main at users.c:22:43
    frame #2: 0x0000000188a244e4 dyld`start + 6992
(lldb) frame variable
(int) id = 7
(user *) u = NULL
(lldb) up
frame #1: 0x00000001000005b4 users`main at users.c:22:43
-> 22           printf("id=%d len=%zu\n", ids[i], name_length(ids[i]));
(lldb) frame variable
(int[3]) ids = ([0] = 2, [1] = 3, [2] = 7)
(int) i = 2
bt(backtrace) es el stack trace de la clase 1.frame variableimprime todas las variables locales del frame seleccionado:u = NULL.upsube a quien llamó, para ver qué entrada lo causó:i = 2, id 7.address=0x8es un detalle bonito:nameestá a 8 bytes del inicio destruct user(unintde 4 bytes y 4 de relleno), así que leeru->nameconu == NULLtoca la dirección 8.
Las líneas id=2 len=5 aparecen aquí porque lldb ejecuta el programa en una terminal. Para más lldb (watchpoints, builds con -O2), mira rendimiento en C, Make y lldb (en inglés).
pdb: paso a paso por el bug de Python
pdb es el depurador que trae Python. Se inicia con python3 -m pdb discount.py BOOTCAMP10. Los comandos básicos:
| Comando | Qué hace |
|---|---|
break 11 (b) |
detenerse cuando la línea 11 está por ejecutarse |
continue (c) |
correr hasta el siguiente breakpoint |
next (n) |
ejecutar la línea actual sin entrar a las llamadas |
step (s) |
ejecutar la línea actual entrando a las llamadas |
return (r) |
correr hasta que la función actual retorne |
p expr |
imprimir una expresión |
where (w) |
mostrar la pila; up/down para moverse |
quit (q) |
salir |
Manejamos la sesión con un here-doc para que sea reproducible. pdb no muestra los comandos que lee de un archivo, así que usamos un envoltorio de 20 líneas cuyo único cambio es imprimir cada comando después del prompt (Pdb). Si los escribes a mano, la salida es la misma.
> ~/demo/discount.py(1)<module>()
-> import sys
(Pdb) break 11
Breakpoint 1 at ~/demo/discount.py:11
(Pdb) continue
> ~/demo/discount.py(11)cart_total()
-> total += apply_discount(price, percent) * qty
(Pdb) p name, price, qty, percent
('lápiz', 120, 3, 0.1)
(Pdb) step
--Call--
> ~/demo/discount.py(4)apply_discount()
-> def apply_discount(price, percent):
(Pdb) where
  … 2 frames del propio depurador recortados
  ~/demo/discount.py(19)<module>()
-> print(cart_total(CART, COUPON[sys.argv[1]]))
  ~/demo/discount.py(11)cart_total()
-> total += apply_discount(price, percent) * qty
> ~/demo/discount.py(4)apply_discount()
-> def apply_discount(price, percent):
(Pdb) p price * percent
12.0
(Pdb) p price * percent // 100
0.0
(Pdb) return
--Return--
> ~/demo/discount.py(5)apply_discount()->120.0
-> return price - price * percent // 100
(Pdb) next
> ~/demo/discount.py(10)cart_total()
-> for name, price, qty in items:
(Pdb) p total
360.0
(Pdb) quit
El tercer p es el momento del hallazgo: percent vale 0.1, así que price * percent // 100 es 12.0 // 100, o sea 0.0. El descuento siempre es cero y el float se cuela en total. No tuviste que adivinar dónde poner un print: te detuviste en el bucle y miraste.
Post-mortem: depurar después del crash
El cupón BROKEN apunta a None y se cae. python3 -m pdb -c continue discount.py BROKEN corre hasta la excepción y te deja en el frame que la lanzó:
TypeError: unsupported operand type(s) for *: 'int' and 'NoneType'
Uncaught exception. Entering post mortem debugging
> ~/demo/discount.py(5)apply_discount()
-> return price - price * percent // 100
(Pdb) p price, percent
(120, None)
(Pdb) up
> ~/demo/discount.py(11)cart_total()
-> total += apply_discount(price, percent) * qty
(Pdb) p name, qty
('lápiz', 3)
(Pdb) quit
Desde dentro de un programa, import pdb; pdb.post_mortem() en un bloque except, o breakpoint() (Python 3.7+) en cualquier lugar, te da el mismo prompt.
logging: niveles, formato y hora en UTC
Un depurador necesita que estés frente al teclado cuando ocurre el bug. En producción, de madrugada, no lo estás. Para eso existe el logging: prints con nivel (DEBUG < INFO < WARNING < ERROR < CRITICAL), marca de tiempo y nombre, que puedes subir o bajar sin tocar el código.
import logging
import sys
import time

logging.Formatter.converter = time.gmtime          # timestamps in UTC
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)sZ %(levelname)-7s %(name)s: %(message)s",
    datefmt="%Y-%m-%dT%H:%M:%S",
    stream=sys.stderr,
)
log = logging.getLogger("checkout")


def apply_discount(price, percent):
    log.debug("apply_discount price=%r percent=%r", price, percent)
    if not 0 <= percent <= 100:
        log.warning("percent out of range: %r", percent)
    return price - price * percent // 100


def checkout(order_id, items, percent):
    total = sum(apply_discount(p, percent) * q for p, q in items)
    log.info("order=%s items=%d total=%s", order_id, len(items), total)
    return total


checkout("P-4001", [(120, 3), (300, 2)], 10)
checkout("P-4002", [(120, 1)], 0.1)
try:
    checkout("P-4003", [(120, 1)], None)
except TypeError:
    log.exception("checkout failed order=%s", "P-4003")
2026-11-14T06:00:41Z INFO    checkout: order=P-4001 items=2 total=864
2026-11-14T06:00:41Z INFO    checkout: order=P-4002 items=1 total=120.0
2026-11-14T06:00:41Z ERROR   checkout: checkout failed order=P-4003
Traceback (most recent call last):
  File "~/demo/log_demo.py", line 31, in <module>
    checkout("P-4003", [(120, 1)], None)
  File "~/demo/log_demo.py", line 23, in checkout
    total = sum(apply_discount(p, percent) * q for p, q in items)
  File "~/demo/log_demo.py", line 23, in <genexpr>
    total = sum(apply_discount(p, percent) * q for p, q in items)
  File "~/demo/log_demo.py", line 17, in apply_discount
    if not 0 <= percent <= 100:
TypeError: '<=' not supported between instances of 'int' and 'NoneType'
Lo que hace útiles estas líneas a las 3 de la mañana:
- UTC con
Z. Servidores, teléfonos, clientes y compañeros viven en zonas horarias distintas; una línea de log sin zona no se puede cruzar con nada.loggingusa la hora local salvo que pongasconverter = time.gmtime. - Pares clave=valor (
order=P-4002) que puedes buscar congrep. log.exceptiondentro deexceptagrega el traceback completo (el error de "imprimir solo el mensaje" de la clase 1, corregido).- La segunda línea delata el bug si lees con atención:
total=120.0, un float, y sin descuento. La validación de rango no saltó, porque 0.1 sí está entre 0 y 100. Los logs muestran síntomas; pensar te toca a ti.
Pon level=logging.DEBUG y aparecen las líneas apply_discount price=120 percent=10 sin editar ni una llamada. PHP tiene la misma idea en error_log(): en la línea de comandos escribe en stderr, y con php -d error_log=app.log escribió [14-Nov-2026 06:05:50 UTC] checkout order=P-4002 percent=0.1 type=float en un archivo. Revisa que date.timezone diga UTC en tu servidor, como en el nuestro. Los scripts de shell tienen su propia versión de esto en scripts de shell robustos con cron y logging (en inglés).
Cuando el programa se cuelga: faulthandler
Un programa colgado no imprime nada. faulthandler de Python puede volcar la pila de cada hilo después de un tiempo límite:
import faulthandler
import time

faulthandler.dump_traceback_later(2, exit=True)   # print every thread's stack after 2 s


def wait_for_payment(status):
    while status != "paid":        # bug: status is never refreshed
        time.sleep(0.1)


wait_for_payment("pending")
Timeout (0:00:02)!
Thread 0x00000001f582e180 (most recent call first):
  File "~/demo/hang.py", line 9 in wait_for_payment
  File "~/demo/hang.py", line 12 in <module>
python3 -X faulthandler hace lo mismo con los segmentation faults dentro de extensiones en C (Fatal Python error: Segmentation fault, salida 139).
Patito de goma y repro mínimo: dos bugs encontrados sin herramientas
Depurar con patito de goma (rubber duck) es explicar tu código línea por línea, en voz alta, a alguien que no sabe nada; a un patito de goma si no hay nadie libre. Esta función etiqueta las notas de clase:
def add_tag(post, tag, tags=[]):
    tags.append(tag)
    post["tags"] = tags
    return post


a = add_tag({"title": "Clase 1"}, "python")
b = add_tag({"title": "Clase 2"}, "freelance")
print(a)
print(b)
{'title': 'Clase 1', 'tags': ['python', 'freelance']}
{'title': 'Clase 2', 'tags': ['python', 'freelance']}
Al explicarlo: "tags empieza como una lista vacía nueva en cada llamada… ¿de verdad?". Decir "en cada llamada" en voz alta es donde se rompe. Python evalúa el valor por defecto una sola vez, cuando se ejecuta el def, así que todas las llamadas comparten una misma lista. El arreglo es tags=None y tags = [] if tags is None else tags.
Un repro mínimo (reproducción mínima) es el programa más pequeño que todavía muestra el bug. Un reporte de 32 líneas leía este CSV e imprimía la build más reciente por plataforma:
app,platform,build,date,notes
shop,ios,8,2026-09-30,primera build pública
shop,ios,9,2026-10-14,arregla crash al iniciar sesión
shop,android,9,2026-10-14,arregla crash al iniciar sesión
shop,ios,10,2026-11-02,nuevo checkout
shop,android,10,2026-11-02,nuevo checkout
shop,android,11,2026-11-10,hotfix redondeo de cupón
$ python3 release_report.py releases.csv
release report (2026-11-14)
  android  build   9  2026-10-14  arregla crash al iniciar sesión
  ios      build   9  2026-10-14  arregla crash al iniciar sesión
Android 11 e iOS 10 son más nuevas. Recortamos el programa paso a paso, comprobando en cada corte que el bug seguía ahí: datos escritos en el código, sin agrupar, sin fechas ni notas, sin el módulo csv. Terminó en una línea:
$ python3 -c 'print(max(["9", "10"]))'
9
$ python3 -c 'print(max(["9", "10"], key=int))'
10
El CSV te da strings, y los strings se comparan carácter por carácter: "9" > "1". El arreglo en el reporte es key=lambda r: int(r["build"]). Un repro de una línea es además lo mejor para pegar en una pregunta o en un reporte de bug; nadie puede ayudarte con un script de 32 líneas y un CSV privado de tu cliente.
Medido: lo que cuesta el logging cuando está apagado
¿Se pueden dejar llamadas a log.debug en código que se ejecuta mucho? Medimos 200 000 llamadas de cada estilo, 7 repeticiones, mediana, Python 3.9.6, Apple M1 Pro. El nivel del logger era INFO, así que todos los debug estaban desactivados; el info activo escribía en un búfer en memoria con marca de tiempo.
def debug_lazy(i):    log.debug("order=%s i=%d", ORDER, i)
def debug_fstring(i): log.debug(f"order={ORDER} i={i}")
def debug_guarded(i):
    if log.isEnabledFor(logging.DEBUG):
        log.debug("order=%s i=%d", ORDER, i)
def info_enabled(i):  log.info("order=%s i=%d", ORDER, i)
| Estilo | ns por llamada |
|---|---|
| función vacía (referencia) | 43 |
debug apagado, con guarda isEnabledFor |
208 |
debug apagado, argumentos estilo % (perezosos) |
297 |
print a un búfer en memoria |
792 |
debug apagado, argumento f-string |
847 |
info activo, con hora y formato |
10 262 |
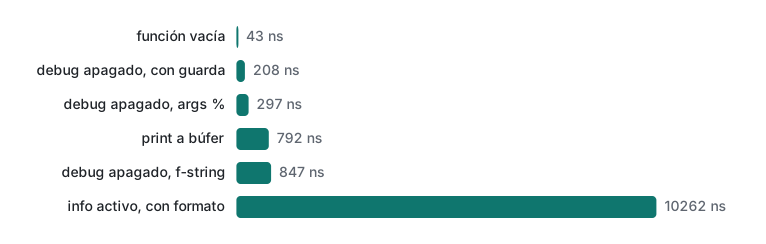
Un debug desactivado cuesta unos 0,3 µs; mil por petición son 0,3 ms: está bien. Un f-string cuesta casi el triple aunque no se registre nada, porque Python arma el texto antes de que debug pueda decir "no me interesa". Una línea activa cuesta unos 10 µs, 35 veces más que una desactivada. Registra lo necesario en INFO, deja los detalles en DEBUG con argumentos estilo %, y protege los argumentos realmente caros con isEnabledFor. Para medir el resto de tu programa, mira perfilado y optimización en Python (en inglés).
Límites honestos y notas de versión
- Aquí usamos Python 3.9.6.
breakpoint()existe desde 3.7. Las versiones nuevas de Python siguen agregando funciones apdb; solo ejecutamos lo que trae 3.9. Los tiempos absolutos cambian entre versiones y máquinas; lo que hay que recordar son las proporciones. python3 -m trace --traceimprime cada línea ejecutada. Funcionó bien aquí y sirve para ver "¿por qué rama entró?", pero en programas reales produce miles de líneas.- PHP: Xdebug no está instalado en esta Mac, así que no mostramos un depurador paso a paso para PHP; sí ejecutamos
error_log()y los ajustes conphp -d. - En macOS el depurador es lldb. gdb no está instalado aquí; sus comandos cambian un poco (
btes igual,frame variableesinfo locals). - Si el depurador y los logs no coinciden, confía en el código que puedes leer. Un asistente de IA nos dio una vez un diagnóstico seguro y equivocado que los logs desmintieron; la historia está en el diagnóstico equivocado de un agente de IA que delataron los logs (en inglés).
Ejercicios
- En la sesión de pdb de arriba, ¿qué comando te habría mostrado
percenten el momento en queapply_discountdevolvió 120.0? - Un programa en C que corre como
./app >> app.logse cae, y el log termina 50 líneas antes del crash. Da dos formas de que aparezcan las últimas líneas. - Reescribe
log.debug(f"payload={json.dumps(big)}")para que no cueste casi nada cuando DEBUG está apagado.
Respuestas
p percent(op price, percent) mientras estás detenido en la línea--Return--; ahí el frame todavía existe.args(a) también imprime todos los argumentos de la función actual.- Escribir la salida de depuración en stderr (sin búfer), llamar a
setvbuf(stdout, NULL, _IOLBF, 0)al inicio demainpara tener búfer por líneas, o hacerfflush(stdout)después de cada línea importante. Mejor todavía: ejecutarlo dentro de lldb o con-fsanitize=addresspara ver el crash en sí. if log.isEnabledFor(logging.DEBUG): log.debug("payload=%s", json.dumps(big)). Pasar solo"%s", bigevita armar el mensaje, pero no evitajson.dumps; la guarda evita las dos cosas.
Anterior: Clase 1: cómo leer mensajes de error y stack traces · Siguiente: Clase 3: tus primeras pruebas unitarias · También en esta serie: dobles de prueba, pruebas inestables, git bisect. Vuelve a la ruta de estudio de programación.
Preguntas frecuentes
¿Depurar con print está mal?
No, pero tiene dos trampas. Los print que olvidas borrar llegan a producción, y en C la salida de printf que sigue en un búfer se pierde si el programa se cae. En nuestra prueba, un programa en C redirigido a un archivo imprimió dos líneas antes de caerse y el archivo quedó con 0 bytes. Escribe la salida de depuración en stderr o usa logging.
¿Cuánto cuesta una llamada a logging.debug() desactivada en Python?
Unos 0,3 microsegundos por llamada en nuestra medición (Python 3.9, Apple M1 Pro, mediana de 7 ejecuciones × 200 000 llamadas), contra unos 10 microsegundos de una línea activa con marca de tiempo. Pasar un f-string cuesta unos 0,85 microsegundos aunque DEBUG esté apagado, porque el texto se arma antes de la llamada.
¿Cómo depuro un script de Python que ya se cayó?
Ejecútalo con python3 -m pdb -c continue script.py. Cuando se lanza la excepción, pdb entra en modo post-mortem en la línea que falló; ahí puedes usar p para imprimir variables, where para ver la pila y up para revisar las variables de quien llamó.