Tokens aleatorios seguros: random vs secrets, medido
Reconstruimos el random de Python con 624 salidas y adivinamos los siguientes cupones; luego medimos secrets, random_bytes, UUIDv4 y semillas de reloj.
Serie: curso de seguridad básica 3/6 (intermedio). Para quien ya guarda contraseñas con un hash como corresponde (curso 2) y ahora tiene que emitir IDs de sesión, enlaces para restablecer la contraseña, API keys o códigos de cupón. Al terminar vas a saber qué función aleatoria llamar en Python y PHP, cuántos bits necesita un token y por qué "se ve aleatorio" no prueba nada.
Si haces proyectos freelance para tiendas online o saliste de un bootcamp armando tu primer backend, tarde o temprano vas a generar códigos que valen plata: cupones de descuento, enlaces de invitación, tokens de reseteo. El RGPD europeo y las leyes de protección de datos de América Latina piden, en términos generales, medidas técnicas adecuadas para proteger los datos personales; un token adivinable que abre una cuenta ajena difícilmente cuenta como "adecuado" (esto es una idea general, no asesoría legal). La causa casi siempre es la misma: se usó un generador aleatorio de propósito general donde hacía falta uno criptográfico. Abajo rompemos una app de juguete nuestra que hace exactamente eso, medimos cada alternativa y cerramos con la regla. Todo corrió en Python 3.9.6, PHP 8.5.6 y OpenSSL 4.1.0 en una Mac con Apple Silicon (M1 Pro), con semillas fijas donde importan. Los ataques apuntan solo a código y datos creados en esa misma máquina.
Si "hash" y "MAC" todavía se te mezclan, lee primero el curso 1. Esta serie es parte de la hoja de ruta para aprender programación.
random vs secrets: dos herramientas distintas
Python trae dos APIs aleatorias que se parecen y no son lo mismo:
| Módulo | Algoritmo | Semilla | Para qué |
|---|---|---|---|
random |
Mersenne Twister (MT19937), estado de 624 palabras de 32 bits | os.urandom si llamas random.seed() sin argumento, o lo que le pases |
simulaciones, juegos, mezclar datos de prueba, ejecuciones reproducibles |
secrets (3.6+) |
ningún algoritmo propio: lee el CSPRNG del sistema operativo | el kernel | tokens, claves, salts, cupones, todo lo que a un atacante le sirva adivinar |
Un CSPRNG (generador de números pseudoaleatorios criptográficamente seguro) tiene una promesa extra: ver cualquier cantidad de su salida no te ayuda a predecir la siguiente. MT19937 no promete eso. Es excelente siendo aleatorio en lo estadístico y pésimo siendo impredecible.
import random, secrets
print(secrets.token_hex(16))       # 32 caracteres hex = 128 bits
print(secrets.token_urlsafe(16))   # ~22 caracteres URL-safe = 128 bits
print(secrets.DEFAULT_ENTROPY)     # bytes que usa si no pasas un largo
try:
    random.SystemRandom().getstate()
except Exception as e:
    print(type(e).__name__, e)
e6a825116541f1d1a20030e60398aa48
CBomwXz1dT6i6kcAXQqszA
32
NotImplementedError System entropy source does not have state.
Esa última línea resume un CSPRNG en un solo mensaje de error: dentro del proceso no hay ningún estado que alguien pueda copiar.
Error común: cupones con random → un clon los adivina → solución
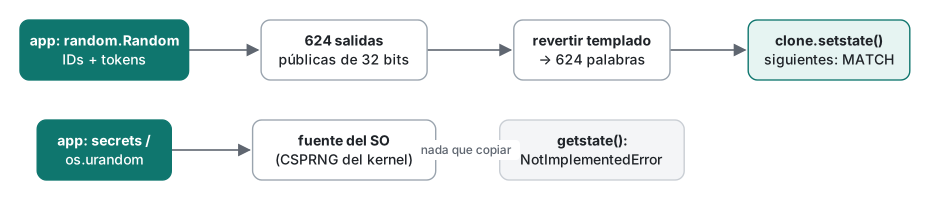
Así se ve el error en su forma más común. Una tienda de juguete usa un solo random.Random para dos cosas: IDs de pedido públicos (8 caracteres hex que aparecen en el comprobante, inofensivos por sí solos) y códigos de cupón de descuento. Quien junte 624 IDs de pedido consecutivos puede reconstruir el generador.
¿Cómo? MT19937 guarda 624 palabras de estado. Cada salida de 32 bits es una palabra del estado pasada por una función de "templado": cuatro pasos de desplazamiento y XOR. Cada paso es reversible, así que cada salida devuelve una palabra del estado exacta. Con 624 salidas tienes el estado completo, y el propio setstate() de Python lo carga en un clon.
# mt_cupon_es.py - demo LOCAL: reconstruir el estado de random con 624 salidas
import random

def unshift_right(y, shift):
    result = y
    for _ in range(32 // shift + 1):
        result = y ^ (result >> shift)
    return result & 0xFFFFFFFF

def unshift_left(y, shift, mask):
    result = y
    for _ in range(32 // shift + 1):
        result = y ^ ((result << shift) & mask)
    return result & 0xFFFFFFFF

def untemper(y):                      # deshacer los 4 pasos de templado, al revés
    y = unshift_right(y, 18)
    y = unshift_left(y, 15, 0xEFC60000)
    y = unshift_left(y, 7, 0x9D2C5680)
    y = unshift_right(y, 11)
    return y

def issue(r):                         # emitir un cupón de descuento
    return f"CUPON-{r.getrandbits(40):010X}"

victim = random.Random(42)                                # semilla fija para la demo
observed = [victim.getrandbits(32) for _ in range(624)]   # IDs de pedido públicos
real = [issue(victim) for _ in range(3)]                  # cupones de otros clientes

clone = random.Random()
clone.setstate((3, tuple(untemper(v) for v in observed) + (624,), None))
guess = [issue(clone) for _ in range(3)]
for a, b in zip(real, guess):
    print(a, "|", b, "MATCH" if a == b else "differ")
CUPON-AA3FE12E47 | CUPON-AA3FE12E47 MATCH
CUPON-5A1A50AEC3 | CUPON-5A1A50AEC3 MATCH
CUPON-8FC7B5B2BC | CUPON-8FC7B5B2BC MATCH
Reconstruir el estado tomó una mediana de 1,08 ms (100 reconstrucciones × 5 corridas). La tupla (3, state, None) es el formato que devuelve getstate() en CPython 3.9: versión 3, 624 palabras más un índice de posición, y sin gaussiana en caché. Si le pasas una tupla de largo equivocado obtienes ValueError: state vector is the wrong size.
Tres excusas que se escuchan seguido:
- "Pero yo solo uso
randrange, nogetrandbits." Una vez que el clon tiene el estado, reproduce todas las llamadas siguientes, incluidasrandrange,choiceyshuffle, porque todas sacan de la misma corriente de 32 bits. Juntar el estado es más difícil cuando las salidas que ves están truncadas, pero también hay métodos publicados para eso. No apoyes tu seguridad en "el atacante ve menos bits". - "La semilla salió de
os.urandom." Da igual. La semilla solo fija el estado inicial; las salidas siguen filtrando el estado. - "Nadie va a juntar 624 valores." Una API con tráfico entrega 624 IDs en segundos.
Solución: usa secrets para todo lo secreto y deja random para simulaciones.
import secrets
session_id   = secrets.token_urlsafe(32)        # 256 bits, apto para cookie
reset_token  = secrets.token_urlsafe(32)        # va en la URL; guarda solo su hash
api_key      = "sk_" + secrets.token_hex(32)
cupon        = "CUPON-" + secrets.token_hex(16).upper()  # 128 bits + límite de canjes
Regla: si adivinar el valor le sirve a un atacante, sale del CSPRNG del sistema operativo, nunca de un generador con semilla.
PHP y otros lenguajes
PHP tiene la misma división. mt_rand() y rand() (alias de mt_rand desde PHP 7.1) son Mersenne Twister. random_bytes() y random_int() (PHP 7.0+) leen el CSPRNG del sistema. PHP 8.2 agregó la clase Random\Randomizer, cuyo motor por defecto es Random\Engine\Secure.
<?php
echo bin2hex(random_bytes(16)), "\n";                               // token hex de 128 bits
echo rtrim(strtr(base64_encode(random_bytes(16)), '+/', '-_'), '='), "\n";  // URL-safe
echo str_pad((string)random_int(0, 999999), 6, '0', STR_PAD_LEFT), "\n";    // código de 6 dígitos
mt_srand(1114); $a = mt_rand(); mt_srand(1114); $b = mt_rand();
echo "mt_rand same seed: $a $b\n";
$s = new Random\Randomizer();
echo get_class($s->engine), "\n";
echo uniqid(), "\n", uniqid(), "\n";
cd11d73e54d4712cfa62290971d93ec7
a6OmaIUvgPVddjIEO3rPkA
473973
mt_rand same seed: 324694876 324694876
Random\Engine\Secure
6af7e6f032055
6af7e6f032076
Mira los dos uniqid(): solo cambian los últimos tres dígitos hex, porque uniqid() es la hora actual en microsegundos escrita en hexadecimal. Es casi único, no secreto. PHP 8.5 además avisa de costumbres viejas: MT_RAND_PHP imprimió Deprecated: Constant MT_RAND_PHP is deprecated since 8.3, as it uses a biased non-standard variant of Mt19937, y lcg_value() imprimió Deprecated: Function lcg_value() is deprecated since 8.4, use \Random\Randomizer::getFloat() instead.
| Lenguaje | Fuente segura (ejecutada aquí salvo nota) | No usar para secretos |
|---|---|---|
| Python | secrets.token_bytes/hex/urlsafe, os.urandom |
random.* |
| PHP | random_bytes, random_int, Random\Randomizer() |
mt_rand, rand, uniqid, lcg_value |
| Java 26 | java.security.SecureRandom (algoritmo impreso: NativePRNG) |
java.util.Random, Math.random |
| Dart | Random.secure() |
Random() |
| CLI | openssl rand -hex 32 |
$RANDOM de la shell |
| JS en el navegador | crypto.getRandomValues, crypto.randomUUID (no ejecutado: nuestro shell jsc no tiene crypto; typeof crypto imprimió undefined) |
Math.random |
Largo del token vs tiempo para adivinarlo
¿Cuánto es suficiente? Cuenta los bits y divide por la velocidad de intentos. En promedio, un atacante encuentra un token específico después de probar la mitad del espacio. Las velocidades de abajo son supuestos, no mediciones: 1.000 intentos por segundo contra un endpoint online sin límite de intentos, y 10⁹ por segundo para una verificación offline (por ejemplo, si se filtraron hashes rápidos sin salt de los tokens). La última columna supone un millón de tokens válidos a la vez, así que cualquier acierto cuenta.
| Token | Bits | 10³/s online | 10⁹/s offline | 10⁶ tokens vivos, 10⁹/s |
|---|---|---|---|---|
| código de 6 dígitos | 19,9 | 8,3 min | 0,0005 s | instantáneo |
| 8 caracteres hex | 32 | 24,9 días | 2,15 s | instantáneo |
| 16 caracteres hex | 64 | ~10⁸ años | 292 años | 2,56 horas |
| UUIDv4 | 122 | ~10²⁶ años | ~10²⁰ años | ~10¹⁴ años |
token_hex(16) |
128 | ~10²⁸ años | ~10²² años | ~10¹⁶ años |
token_urlsafe(32) |
256 | ~10⁶⁶ años | ~10⁶⁰ años | ~10⁵⁴ años |
Dos lecciones. Primero, un código de 6 dígitos solo es seguro por lo que lo rodea: un vencimiento corto y un tope de intentos (por ejemplo, 5 y el código muere). Lo mismo con los cupones: el límite de canjes por cliente importa tanto como el largo. Segundo, 64 bits parece enorme hasta que hay muchos tokens vivos a la vez. Usa 128 bits como piso y 256 por defecto; no cuesta nada.
Entropía de UUIDv4. Un UUID versión 4 tiene 128 bits, pero 4 son el nibble de versión y 2 son los bits de variante, así que quedan 122 bits aleatorios. El uuid.uuid4() de CPython es literalmente UUID(bytes=os.urandom(16), version=4) (imprimimos el código fuente con inspect.getsource), así que en Python sale del CSPRNG. Otras librerías y otras versiones no: v1 contiene una marca de tiempo y un ID de nodo, y v7 empieza con una marca de tiempo en milisegundos. Un UUID es un formato de identificador; cuando quieres decir "secreto", usa secrets.
Sembrar con el reloj: medido
El segundo error clásico es volver a sembrar en cada request con la hora actual, muchas veces copiado de código C viejo (srand(time(NULL))).
# timeseed.py - por qué sembrar con el reloj es peligroso (demo local)
import random, time
def reset_token(now):                 # MAL: vuelve a sembrar con el reloj en cada request
    r = random.Random(int(now))
    return f"{r.getrandbits(128):032x}"

T = 1794614400                        # "hora del servidor" fija (2026-11-14 00:00 UTC)
a = reset_token(T + 0.12)             # el usuario A pide restablecer
b = reset_token(T + 0.87)             # el usuario B, en el mismo segundo
print("A:", a); print("B:", b); print("same token:", a == b)

victim = reset_token(T + 37.4)        # el observador conoce la hora con +-1 minuto
cands = [reset_token(s) for s in range(T - 60, T + 61)]
print("candidates:", len(cands), "victim in list:", victim in cands)
A: 7a7c99a76d9b36196739a5195bf659ee
B: 7a7c99a76d9b36196739a5195bf659ee
same token: True
candidates: 121 victim in list: True
Dos usuarios en el mismo segundo recibieron el mismo token de reseteo. Y quien sepa más o menos cuándo se pidió el reseteo (lo puede disparar él mismo) solo tiene 121 candidatos para probar. Un token que parece de 128 bits con unos 7 bits de incertidumbre real.
¿Qué tan rápido salen los candidatos? Generar un token para cada uno de los 86.400 segundos de un día tomó 1,15 s (mediana de 5 corridas, rango de 1,146 a 1,158 s), unas 75.000 semillas por segundo en un núcleo. Con esa velocidad medida: un año entero de semillas por segundo son unos 7 minutos, y una hora de semillas en milisegundos (3,6 millones) son unos 48 segundos. Un reloj más fino no te salva.
Regla: nunca siembres tú un generador con fines de seguridad. Un CSPRNG no necesita semilla tuya.
Velocidad: ¿lo seguro es lento?
La excusa de siempre es la velocidad. Medimos un token de 128 bits por llamada, 200.000 llamadas × 5 corridas, mediana.
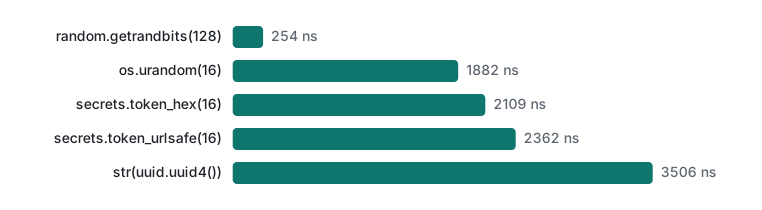
secrets.token_hex(16) costó 2.109 ns contra 254 ns de random.getrandbits(128): unas 8 veces más lento, y aun así 2 microsegundos. Un millón de tokens toma unos 2 segundos. En PHP 8.5 la misma comparación dio 310 ns para bin2hex(random_bytes(16)) contra 22 ns para mt_rand() (5 × 200.000, mediana). Ningún número se acerca al costo de la escritura en la base de datos que guarda el token.
Límites honestos y notas de versión
- Solo Python 3.9.6.
secretsse agregó en Python 3.6 (PEP 506);random.randbytes, en 3.9. No probamos versiones anteriores. - El formato de estado
(3, tupla_de_625, None)es un detalle de implementación de CPython; funcionó en 3.9.6. - PHP:
random_bytes/random_intdesde 7.0,Random\Randomizerdesde 8.2; los avisos de deprecación de arriba son de 8.5.6. - La tabla de tiempos usa velocidades supuestas (10³/s y 10⁹/s), no mediciones. Los ataques online reales los limita tu rate limiting.
crypto.getRandomValuesdel navegador ycrypto.randomBytesde Node no se ejecutaron aquí.- Recuperar el estado a partir de salidas truncadas (como
randrange(10**6)) es posible según la literatura, pero no lo demostramos.
Ejercicios
- Un token tiene 10 caracteres elegidos de forma uniforme de
[a-z0-9]consecrets.choice. ¿Cuántos bits de entropía tiene y alcanza como ID de sesión? - Tu app guarda los tokens de reseteo de contraseña en la base de datos en texto plano. ¿Qué idea de otro curso de la serie arregla el riesgo si se filtra la tabla, y qué guardarías en su lugar?
Respuestas
- log2(36¹⁰) = 10 × log2(36) ≈ 51,7 bits. Muy corto para un ID de sesión; a 10⁹ intentos offline por segundo el tiempo esperado es de unos 21 días para un token y mucho menos con muchos tokens vivos. Usa
secrets.token_urlsafe(32). - Guarda un hash del token (SHA-256 alcanza aquí, porque el token ya tiene 256 bits aleatorios, a diferencia de una contraseña humana del curso 2). Cuando se usa el enlace, hasheas el token recibido y lo buscas. Bórralo después de un uso o al vencer.
Siguiente
- Anterior: Seguridad básica 2/6: hash de contraseñas con bcrypt y Argon2
- Siguiente: Seguridad básica 4/6: trampas de la firma JWT HS256, donde una clave débil cae con una lista de 100 palabras
- Por dónde viajan los tokens: cookies y sesiones en HTTP (en inglés) y seguridad en PHP: XSS, CSRF y sesiones (en inglés)
- Comparar un token de forma segura es el curso 6: ataques de tiempo y comparación en tiempo constante
Preguntas frecuentes
¿Puedo usar el módulo random de Python para IDs de sesión o códigos de cupón?
No. random usa Mersenne Twister (MT19937). En nuestra demo local, 624 salidas consecutivas de 32 bits bastaron para reconstruir su estado completo en cerca de 1 ms, y el clon imprimió exactamente los tres siguientes códigos de cupón. Usa secrets.token_urlsafe(32) o secrets.token_hex(32).
¿Qué tan largo debe ser un token aleatorio?
Al menos 128 bits de un CSPRNG; 256 bits (secrets.token_urlsafe(32)) no cuesta nada extra. En nuestra tabla, un token de 32 bits cae en unos 2 segundos a mil millones de intentos offline por segundo, mientras que uno de 128 bits necesita unos 10^22 años a esa misma velocidad.
¿Un UUIDv4 sirve como token secreto?
uuid.uuid4() de Python lee os.urandom(16), así que sus 122 bits aleatorios no se pueden adivinar. Aun así es un mal hábito: otras versiones (v1, v7) llevan marcas de tiempo, y con el mismo largo secrets te da más entropía. Para secretos, usa secrets.