Ataques de timing y comparación en tiempo constante
Curso de seguridad 6: == vs hash_equals y compare_digest medidos por prefijo, en proceso y por HTTP en loopback, y un login que revela qué usuarios existen.
Serie: curso de seguridad básica 6/6 (avanzado). Esta última clase es para ti si alguna vez escribiste if ($token === $expected) y después leíste que debía ser hash_equals. Vas a medir en tu propia computadora cuánto filtra una comparación según cuántos bytes coinciden, si esa fuga sobrevive a un viaje HTTP, y qué fuga de tiempo es realmente grande en una app web típica. La clase cierra con una checklist de toda la serie.
Los ataques de timing suenan a curiosidad de laboratorio, y para cierto código lo son. Para otro código son un bug que se explota con una sola petición. En proyectos freelance es muy común heredar un login o un formulario de "olvidé mi contraseña" que revela si un correo está registrado. Con el RGPD y las leyes de datos personales de América Latina en mente, ten presente que el simple hecho de que alguien tenga cuenta en cierto servicio puede ser un dato personal sensible. El objetivo de esta clase es distinguir esos casos con números y no con folclore, y reportar los números con honestidad incluso cuando la señal se pierde en el ruido.
Entorno: Mac con Apple Silicon (M1 Pro), Python 3.9.6 (time.perf_counter_ns), PHP 8.5.6 (hrtime) y php -S 8.5.6 escuchando en 127.0.0.1:18150. Todas las mediciones se hicieron contra código y datos creados para esta clase en esta máquina. Las semillas son fijas (random.seed(2026), mt_srand(2026)) y el orden de medición se mezcló para que la deriva afecte a todos los casos por igual. Las rutas se acortaron a ~/demo/.
Qué necesita un ataque de timing
Una comparación como a == b normalmente se detiene en el primer byte distinto. Si el atacante controla b y puede medir el tiempo, sabe cuántos bytes iniciales acertó. Con un token hexadecimal de 64 caracteres, eso convierte una adivinanza imposible (16^64) en 64 adivinanzas pequeñas de 16 candidatos cada una.
Que funcione en la práctica depende de tres cosas:
- Señal: cuánto tiempo extra cuesta un byte coincidente más. Un
memcmpque compara bloques de 16 bytes casi no cuesta nada por byte; un bucle escrito a mano en un lenguaje interpretado cuesta mucho más. - Ruido: todo lo demás que varía (el planificador, la red, el resto del trabajo del servidor). El atacante lo combate con repeticiones y estadística.
- Muestras: el ruido baja más o menos con la raíz cuadrada del número de mediciones. Una señal diez veces más pequeña necesita unas cien veces más peticiones.
Medimos las tres. Para cada caso damos la mediana (robusta frente a valores atípicos) y el IQR (rango intercuartílico: el ancho de la mitad central de las mediciones).
Dentro del proceso: == de Python vs hmac.compare_digest
El primer script mide ambas comparaciones contra un secreto, con intentos cuyos primeros k bytes son correctos y el byte k es incorrecto.
# ~/demo/t_inproc.py — medir == y compare_digest según la longitud del prefijo correcto
import hmac, random, statistics, sys, time
random.seed(2026)
L = int(sys.argv[1]) if len(sys.argv) > 1 else 64
secret = bytes(random.choice(b"0123456789abcdef") for _ in range(L))
def guess(k):                                    # primeros k bytes bien, el byte k mal
    if k >= L: return bytes(bytearray(secret))   # mismo valor, otro objeto
    return secret[:k] + b"x" + secret[k+1:]
prefixes = sorted({0, L//4, L//2, 3*L//4, L-1, L})
cands = {k: guess(k) for k in prefixes}
INNER, REPS = 2000, 301
fns = {"==": lambda a, b: a == b, "compare_digest": hmac.compare_digest}
res = {(f, k): [] for f in fns for k in prefixes}
order = list(res)
for r in range(REPS):
    random.shuffle(order)                        # mezclar para que la deriva afecte a todos
    for f, k in order:
        fn, g = fns[f], cands[k]
        t0 = time.perf_counter_ns()
        for _ in range(INNER):
            fn(secret, g)
        res[(f, k)].append((time.perf_counter_ns() - t0) / INNER)
for (f, k), v in res.items():
    q = statistics.quantiles(v, n=4)
    print(f"{f:>15} prefix={k:>5}: median {q[1]:7.2f} ns  IQR {q[2]-q[0]:5.2f} ns")
Nuestra primera ejecución tenía un bug que vale la pena mostrar. Construimos el intento "todo correcto" con bytes(secret), y el == sobre él era tan rápido como fallar en el byte 0. La razón: bytes() de un objeto bytes devuelve el mismo objeto, y el == de CPython responde de inmediato cuando ambos lados son el mismo objeto. La corrección es la copia con bytearray de arriba. Un benchmark que compara un objeto consigo mismo no mide nada.
Con un secreto de 64 bytes (301 repeticiones × 2.000 llamadas):
| Intento | == mediana (IQR) |
compare_digest mediana (IQR) |
|---|---|---|
| 0 bytes correctos | 84,42 ns (2,57) | 89,50 ns (1,72) |
| 16 bytes correctos | 86,12 ns (1,54) | 89,46 ns (1,99) |
| 32 bytes correctos | 87,08 ns (1,56) | 89,48 ns (1,71) |
| 63 bytes correctos | 87,17 ns (1,74) | 89,48 ns (1,59) |
| los 64 correctos | 87,04 ns (1,82) | 89,48 ns (1,84) |
== se movió unos 2,8 ns en total, más o menos lo mismo que su propio IQR. El escalón está entre 0 y 32 bytes y después queda plano, lo que encaja con un memcmp que compara en bloques grandes. compare_digest se mantuvo dentro de 0,1 ns en todos los prefijos. Con un secreto de 4.096 bytes la fuga se vuelve evidente: == pasó de 82,98 ns (0 bytes correctos) a 205,33 ns (4.095 correctos), mientras compare_digest quedó entre 1.861 y 1.868 ns. Fíjate en el costo del tiempo constante: unas 9 veces más lento que == con 4 KiB, pero solo de 2 a 5 ns más lento con un token normal de 64 bytes.
Dentro del proceso: === de PHP, hash_equals y un bucle a mano
PHP tiene un tercer participante: el bucle carácter por carácter que la gente escribe cuando quiere "hacerlo bien" por su cuenta.
<?php
// ~/demo/t_inproc.php (extracto) — la comparación que medimos
function loop_eq(string $a, string $b): bool {             // comparación ingenua que sale antes
    if (strlen($a) !== strlen($b)) return false;
    for ($i = 0; $i < strlen($a); $i++) if ($a[$i] !== $b[$i]) return false;
    return true;
}
// medido igual que el script de Python: 301 repeticiones mezcladas x 2.000 llamadas, hrtime(true)
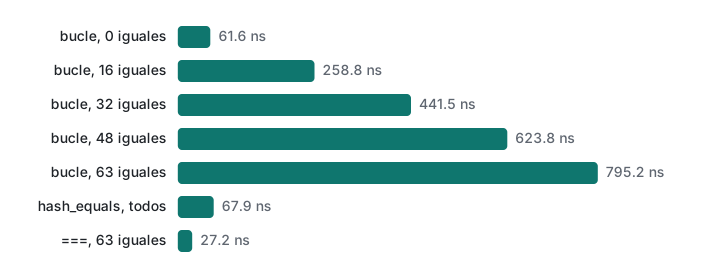
| Intento (secreto de 64 bytes) | === |
hash_equals |
bucle a mano |
|---|---|---|---|
| 0 bytes correctos | 25,94 ns | 67,85 ns | 61,56 ns |
| 16 bytes correctos | 26,29 ns | 67,88 ns | 258,81 ns |
| 32 bytes correctos | 26,85 ns | 67,85 ns | 441,54 ns |
| 48 bytes correctos | 27,21 ns | 67,85 ns | 623,75 ns |
| 63 bytes correctos | 27,23 ns | 67,85 ns | 795,17 ns |
Los IQR fueron de 0,15 a 6 ns. Tres comportamientos distintos:
===filtra, pero muy poco: 1,35 ns entre 0 y 63 bytes coincidentes.hash_equalses plano con un margen de 0,03 ns.- El bucle filtra unos 11,6 ns por byte coincidente ((795,17 − 61,56) / 63). Es el ataque de timing de libro, escrito con buenas intenciones.
Por HTTP en loopback: ¿sobrevive la señal?
Las cifras dentro del proceso son el mejor caso para un atacante. Un atacante real ve el viaje HTTP completo. Así que pusimos las mismas tres comparaciones detrás de php -S en 127.0.0.1 y medimos desde un cliente Python aparte. Es nuestro propio servidor en nuestra propia máquina; no intervino nada más.
<?php
// ~/demo/router.php — php -S 127.0.0.1:18150 router.php  (servidor local de demo)
const SECRET = '3f9c2a7e5b1d4c8f0a6e2b9d7c1f5a3e8b0d4f6a2c9e7b1d5f3a0c8e6b4d2f19'; // valor de demo
function loop_eq(string $a, string $b): bool {
    if (strlen($a) !== strlen($b)) return false;
    for ($i = 0; $i < strlen($a); $i++) if ($a[$i] !== $b[$i]) return false;
    return true;
}
$path = parse_url($_SERVER['REQUEST_URI'], PHP_URL_PATH);
if ($path === '/check') {
    $t = (string)($_GET['t'] ?? '');
    $ok = match ($_GET['mode'] ?? '') {
        'eq'    => $t === SECRET,
        'hash'  => hash_equals(SECRET, $t),
        'loop'  => loop_eq(SECRET, $t),
        default => false,
    };
    http_response_code($ok ? 200 : 403);
    echo $ok ? "ok\n" : "no\n";
}
# ~/demo/t_http.py — una conexión nueva por petición, casos mezclados
# uso: python3 t_http.py 3000 eq,hash,loop 0,32,63
import http.client, random, statistics, sys, time
random.seed(2026)
SECRET = "3f9c2a7e5b1d4c8f0a6e2b9d7c1f5a3e8b0d4f6a2c9e7b1d5f3a0c8e6b4d2f19"
N = int(sys.argv[1])
modes = sys.argv[2].split(",")
ks = [int(k) for k in sys.argv[3].split(",")]
cases = [(m, k) for m in modes for k in ks]
res = {c: [] for c in cases}
order = cases * N
random.shuffle(order)
for mode, k in order:
    conn = http.client.HTTPConnection("127.0.0.1", 18150)
    t0 = time.perf_counter_ns()
    conn.request("GET", f"/check?mode={mode}&t={SECRET[:k]}x{SECRET[k+1:]}")
    conn.getresponse().read()
    res[(mode, k)].append((time.perf_counter_ns() - t0) / 1000)   # microsegundos
    conn.close()

def boot_ci(a, b, B=2000):           # IC 95 % de median(b) - median(a)
    rnd = random.Random(7)
    d = sorted(statistics.median(rnd.choices(b, k=len(b))) - statistics.median(rnd.choices(a, k=len(a)))
               for _ in range(B))
    return d[int(.025 * B)], d[int(.975 * B)]

for m in modes:
    for k in ks:
        q = statistics.quantiles(res[(m, k)], n=4)
        print(f"{m:>5} prefix={k:>2}: median {q[1]:6.1f} us  IQR {q[2]-q[0]:5.1f} us")
    a, b = res[(m, ks[0])], res[(m, ks[-1])]
    lo, hi = boot_ci(a, b)
    d = statistics.median(b) - statistics.median(a)
    print(f"      difference {d*1000:+.0f} ns, 95% CI [{lo*1000:+.0f}, {hi*1000:+.0f}] ns")
Con python3 t_http.py 3000 eq,hash,loop 0,32,63 (27.000 peticiones, 11,2 s):
| Modo | 0 correctos | 32 correctos | 63 correctos | mediana(63) − mediana(0), IC 95 % |
|---|---|---|---|---|
=== |
192,6 µs | 192,3 µs | 191,5 µs | −1.146 ns [−1.875, −250] |
hash_equals |
191,7 µs | 192,8 µs | 192,5 µs | +770 ns [−104, +1.459] |
| bucle | 192,1 µs | 192,7 µs | 192,7 µs | +541 ns [−314, +1.355] |
El IQR de cada caso fue de unos 20 µs, más de 20 veces toda la señal del bucle (730 ns). Mira la fila de ===: su intervalo excluye el cero, pero en la dirección equivocada. Una comparación no puede volverse más rápida cuando coinciden más bytes, así que es ruido y deriva que se alinearon por casualidad, justo lo que hay que esperar de vez en cuando si pruebas tres cosas a la vez. Una ejecución anterior del mismo experimento (antes de ordenar el script) tuvo un IQR de 60 µs y los tres intervalos contenían el cero. Una sola observación de "fue 1 µs más lento" no prueba nada, en ninguna dirección.
Después medimos solo el bucle y hash_equals, con 0 y 63 bytes correctos y 20.000 peticiones por caso: python3 t_http.py 20000 hash,loop 0,63 (80.000 peticiones, 44,3 s):
| Modo | 0 correctos | 63 correctos | Diferencia, IC 95 % |
|---|---|---|---|
hash_equals |
190,3 µs (IQR 14,0) | 190,5 µs (IQR 14,2) | +126 ns [−84, +416] |
| bucle | 190,3 µs (IQR 14,3) | 191,2 µs (IQR 14,1) | +875 ns [+624, +1.084] |
Ahora sí aparece la fuga del bucle, cerca de los 730 ns medidos dentro del proceso, y el intervalo excluye el cero. La ejecución anterior coincidió: bucle +688 ns [+208, +1.186], hash_equals −166 ns [−625, +292]. El resumen honesto:
- En loopback, la diferencia completa de 63 bytes de un bucle lento se detectó con decenas de miles de peticiones.
- Para recuperar un token hace falta la diferencia por byte, unos 11,6 ns. Nuestro intervalo del 95 % medía entre ±230 y ±490 ns con 20.000 peticiones. Reducirlo a unos ±6 ns requeriría entre (230/6)² ≈ 1.500 y (490/6)² ≈ 6.700 veces más muestras: de decenas de millones a unas 10^8 peticiones por byte candidato. Es una extrapolación, no una medición.
- Para el
===de PHP (1,35 ns en todo el token) no vimos nada.
Nada de esto hace que === sea aceptable. Un atacante en la misma red o en el mismo host de la nube tiene menos ruido que un cliente Python en loopback, mejor estadística que una mediana y mucha más paciencia que nuestros 44 segundos. Hay investigaciones publicadas que mostraron ataques de timing remotos contra diferencias pequeñas en buenas condiciones. La corrección cuesta nanosegundos, así que la decisión es fácil.
La fuga fácil de medir: quién tiene cuenta
Las fugas de tiempo grandes en apps web casi nunca están en la comparación de strings. Vienen de hacer trabajo caro para algunas entradas y no para otras. El clásico es un login que solo ejecuta password_verify si el usuario existe. El mismo router tiene un endpoint /login:
// ~/demo/router.php, continuación: agrégalo debajo del bloque /check
// users.php devuelve ['mina' => '$2y$10$…'] (bcrypt con costo 10)
// hash bcrypt de un string aleatorio que nadie conoce, mismo costo que los reales
const DUMMY_HASH = '$2y$10$KDMs6ijzOIwe1yxm5R15tOxeShXOlOTt33nqyt3WzZ5xQOkehLuLG';
if ($path === '/login') {
    $users = require __DIR__ . '/users.php';
    $u = (string)($_POST['user'] ?? '');
    $p = (string)($_POST['pass'] ?? '');
    if (($_GET['fix'] ?? '') === '1') {
        $hash = $users[$u] ?? DUMMY_HASH;                // SOLUCIÓN: siempre un verify de bcrypt
        $ok = password_verify($p, $hash) && isset($users[$u]);
    } else {
        $ok = isset($users[$u]) && password_verify($p, $users[$u]);   // BUG: sale antes
    }
    http_response_code($ok ? 200 : 401);
    echo $ok ? "welcome\n" : "invalid\n";
}
Mandamos 300 logins con contraseña incorrecta por caso, mezclados, cada uno con conexión nueva:
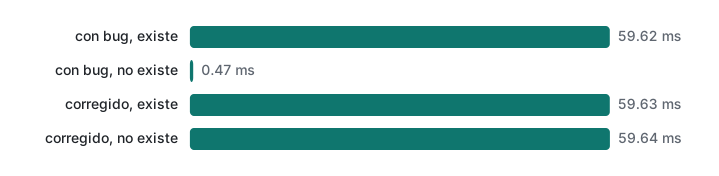
buggy user=mina  : status [401], median  59.62 ms  IQR  0.60 ms
buggy user=nobody: status [401], median   0.47 ms  IQR  0.16 ms
fixed user=mina  : status [401], median  59.63 ms  IQR  0.58 ms
fixed user=nobody: status [401], median  59.64 ms  IQR  0.58 ms
Mismo estado, mismo cuerpo y una diferencia de 127 veces en el tiempo. Una petición por nombre de usuario basta para saber qué cuentas existen; no hace falta estadística. Con el hash señuelo, el endpoint corregido responde a ambos usuarios con 0,01 ms de diferencia, muy dentro del IQR. Una segunda ejecución dio lo mismo (59,61 ms contra 0,45 ms con el bug; 59,62 contra 59,58 ms corregido). El mismo patrón aparece en "olvidé mi contraseña" ("manda el correo solo si el usuario existe"), en la validación de registro y en API keys que se buscan y luego se verifican. La corrección siempre es la misma idea: hacer el mismo trabajo caro en ambos caminos y devolver la misma respuesta. Limitar intentos (ver la clase 2) encarece explotar lo que quede.
Errores comunes y qué pasa en realidad
| Error | Qué vimos | Corrección |
|---|---|---|
| Bucle de comparación "seguro" hecho a mano | 11,6 ns por byte coincidente; detectable en loopback | hash_equals / hmac.compare_digest |
hmac.compare_digest con str no ASCII |
TypeError: comparing strings with non-ASCII characters is not supported (con 'contraseña') |
Compara bytes, o digests en hexadecimal |
hash_equals con null de un campo ausente |
TypeError: hash_equals(): Argument #2 ($user_string) must be of type string, null given |
Valida o convierte antes: (string)($_GET['t'] ?? '') |
Argumentos invertidos en hash_equals |
Resultado correcto, pero la longitud del string del usuario puede influir en el tiempo | Valor conocido primero, entrada del usuario después |
| Trabajo caro solo para usuarios válidos | 0,47 ms contra 59,62 ms | Hash señuelo; respuestas idénticas |
Hacer benchmark de x == x |
Atajo de identidad: "todo correcto" igual de rápido que 0 bytes | Compara objetos distintos |
| Buscar un token en la BD por su valor | La comparación del índice no es de tiempo constante (descrito, no medido) | Guarda el SHA-256 del token y busca por él |
La última fila merece código. Guarda solo un hash del token; el usuario presenta el token; tú lo hasheas y comparas hashes. Un atacante no puede controlar el prefijo de una salida SHA-256, así que una fuga de prefijo no le sirve, y el digest en hexadecimal es ASCII, así que compare_digest nunca lanza excepción:
import hashlib, hmac, secrets
token = secrets.token_urlsafe(32)                         # se envía al usuario una sola vez
stored = hashlib.sha256(token.encode()).hexdigest()       # solo esto va a la BD
def check(presented: str) -> bool:
    h = hashlib.sha256(presented.encode()).hexdigest()
    return hmac.compare_digest(h, stored)
print(len(token), check(token), check(token[:-1] + "x"), check("contraseña"))
# 43 True False False
Tanto hash_equals como compare_digest pueden revelar la longitud del secreto en algunos casos (su documentación lo dice). Con tokens y digests de longitud fija no importa, y es otra razón para comparar hashes.
Otros canales laterales (descritos, no ejecutados)
El tiempo es un canal entre varios. No medimos estos, pero conviene reconocerlos:
- Mensajes de error o códigos de estado distintos: "usuario inexistente" frente a "contraseña incorrecta", o 404 frente a 403 para objetos que existen. Filtra sin ninguna estadística. Devuelve el mismo mensaje.
- Tamaño de la respuesta: comprimir una página que contiene un secreto y texto controlado por el atacante permite deducir el secreto por el tamaño (la idea de los ataques CRIME y BREACH contra la compresión en HTTPS). Para el lado del transporte, ver HTTPS y TLS (en inglés).
- Cachés de CPU y predicción de saltos: las implementaciones de AES con tablas y las ramas que dependen del secreto filtran a través del hardware compartido (ataques tipo Spectre y de timing de caché). Es una razón para usar bibliotecas criptográficas revisadas en lugar de tu propio AES.
- Trabajo que depende de datos secretos: parsers que salen antes, regex que hacen más o menos backtracking, consultas que terminan antes.
- Límites de intentos y bloqueos: un bloqueo que solo se activa para cuentas existentes también revela su existencia.
Elegir la comparación correcta
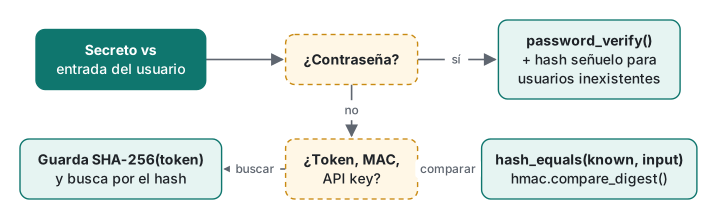
| Qué comparas | Usa | Nota |
|---|---|---|
| Contraseña | password_verify (PHP), la función verify de la biblioteca |
Ejecútala con un hash señuelo para usuarios desconocidos |
| HMAC/firma (webhooks, JWT, CSRF) | hash_equals($expected, $given), hmac.compare_digest |
Recalcula el valor esperado; nunca confíes en uno recibido |
| API key o token de recuperación en la BD | SHA-256 del token como clave guardada | Busca por hash y compara hashes |
| Código numérico corto (OTP) | Comparación en tiempo constante más límite de intentos | El límite importa más que la comparación |
| Datos no secretos | == / === está bien |
No toda comparación necesita tiempo constante |
Cierre de la serie: la checklist
Seis clases en una página. Si alguien nuevo en el equipo te pregunta qué revisar antes de publicar, esta es la lista:
- Codificar no es cifrar. Base64 y hexadecimal los revierte cualquiera (clase 1).
- Contraseñas: bcrypt o Argon2id con
password_hash/password_verify, nunca un hash rápido; rehashea cuando cambies el costo; cuidado con el límite de 72 bytes de bcrypt (clase 2). - Aleatoriedad:
secrets/random_bytespara tokens, nuncarandom/mt_rand, nunca con semilla basada en la hora; 128 bits o más (clase 3). - Tokens firmados: fija el algoritmo, rechaza
alg: none, usa una clave HMAC aleatoria de 32 bytes, revisaexpyaud(clase 4). - Cifrado: solo AEAD (AES-256-GCM o XChaCha20-Poly1305), un nonce aleatorio nuevo por mensaje, tag de 16 bytes comprobado, claves fuera de la BD (clase 5).
- Comparaciones:
hash_equals/compare_digestpara secretos, el mismo trabajo y la misma respuesta para usuarios válidos e inválidos (esta clase). - El resto de la seguridad web: sentencias preparadas contra inyección SQL (PDO y SQLite (en inglés)), escapar la salida y tokens CSRF (XSS, CSRF y sesiones (en inglés)), atributos de cookies (headers, cookies y sesiones (en inglés)) y HTTPS en todo el sitio (TLS (en inglés)). Para auditar una base de código PHP vieja sin cambiar su salida, ver la auditoría SQLi/XSS de una app PHP heredada.
Límites honestos y notas de versión
- Medido en una sola M1 Pro con Python 3.9.6, PHP 8.5.6 y
php -S8.5.6.php -Ses de un solo proceso y cerró cada conexión; un servidor de producción con keep-alive, TLS y otro tráfico tiene otro perfil de ruido, y puede ser más fácil o más difícil de atacar. - El cliente en loopback era Python con
http.client, que agrega su propia variación. Un cliente en C o un socket crudo reduciría el ruido; no lo probamos. - La cifra de "10^7 a 10^8 peticiones por byte" es una extrapolación a partir de los intervalos con 20.000 peticiones, suponiendo que el ruido baja con la raíz cuadrada del número de muestras.
- El ruido en loopback cambió entre ejecuciones (IQR de 60 µs en una, 20 µs en la siguiente). Corre tu propia prueba más de una vez antes de creerle.
hash_equalsexiste desde PHP 5.6 yhmac.compare_digestdesde Python 3.3; solo ejecutamos las versiones de arriba.- Los canales laterales de la sección anterior están descritos, no ejecutados.
Ejercicios
1. Un handler de webhooks valida la firma con if ($_SERVER['HTTP_X_SIGNATURE'] == hash_hmac('sha256', $body, $secret)). Enumera todo lo que está mal en esa línea y reescríbela.
2. Tu formulario de recuperación dice "Si ese correo existe, te enviamos un enlace", pero tarda 300 ms cuando la dirección existe (genera la vista y manda el correo) y 5 ms cuando no. ¿Qué aprende un atacante y cómo lo corriges sin cambiar el mensaje?
Respuestas
1. (a) == no es de tiempo constante, y además es laxo: PHP 8.5.6 todavía compara como números los strings que parecen números, así que "0e1234" == "0e5678" es true. Un HMAC hexadecimal que por casualidad sea 0e seguido solo de dígitos coincidiría con cualquier otro string así. (b) El header puede faltar y dar null. (c) El valor recibido va primero, así que la comparación recorre el string del atacante. Reescritura: $given = (string)($_SERVER['HTTP_X_SIGNATURE'] ?? ''); $expected = hash_hmac('sha256', $body, $secret); if (!hash_equals($expected, $given)) { http_response_code(401); exit; }. Además, calcula el HMAC sobre el cuerpo crudo tal como llegó.
2. La diferencia de 60 veces le dice al atacante qué direcciones tienen cuenta, exactamente como en la demo del login. Corrección: responde de inmediato en ambos casos y haz el trabajo en segundo plano (una cola o un job que corre después de enviar la respuesta), para que el tiempo de la petición no dependa de si la cuenta existe. Agrega un límite de intentos por IP y por dirección.
Lo que sigue
- Anterior: curso de seguridad básica 5/6: AES-GCM bien usado
- Inicio de la serie: curso de seguridad básica 1/6: hash, cifrado y codificación
- El resto de la serie: hash de contraseñas, tokens aleatorios seguros, trampas de JWT HS256
- Lo básico de Python usado en los scripts: tipos y mutabilidad en Python
- Todas las series de clases: la hoja de ruta para aprender a programar
Preguntas frecuentes
¿Comparar un token de API con == es explotable de verdad?
Filtra, pero cuánto depende de la comparación. El === de PHP con un token de 64 bytes varió apenas 1,4 ns entre ningún byte correcto y 63 correctos, y por HTTP en loopback no lo vimos. Un bucle escrito a mano filtró unos 11,6 ns por byte coincidente, y su diferencia completa de 63 bytes se detectó por HTTP en loopback con 20.000 peticiones por caso. Usa hash_equals o hmac.compare_digest de todos modos: cuestan unas decenas de nanosegundos.
¿Cuál es la fuga de tiempo más fácil de medir en una app web?
Hacer trabajo caro solo para algunas entradas. Nuestro login respondía antes para usuarios inexistentes: 0,47 ms contra 59,62 ms con bcrypt de costo 10, una diferencia de 127 veces visible con una sola petición. Ejecutar password_verify contra un hash señuelo para usuarios desconocidos dejó los cuatro casos en unos 59,6 ms.
¿Por qué hmac.compare_digest lanza TypeError con mi token?
Con argumentos str, compare_digest solo acepta ASCII. Cualquier carácter no ASCII lanza TypeError: comparing strings with non-ASCII characters is not supported. Compara bytes (codifica ambos lados en UTF-8) o compara digests SHA-256 en hexadecimal, que siempre son ASCII.