Procesos, jobs y señales: qué significan 130/137/143
ps, kill, trap, jobs, wait y nohup en bash y zsh de macOS: por qué kill -INT no hizo nada, un proceso hijo huérfano y xargs -P medido: de 15.59 s a 3.89 s.
Serie: curso de línea de comandos 5/6 (avanzado). Para quien ya lanza trabajos largos desde scripts y quiere controlarlos: el backup nocturno de un cliente, el script de deploy de tu startup o el pipeline de CI que nadie quiere tocar. Vas a poder arrancar trabajo en paralelo, detenerlo limpiamente y entender qué te está diciendo un código de salida como 137.
Esta clase resuelve tres problemas que aparecen apenas los scripts corren sin supervisión: un job que "no se muere" o que deja un proceso hijo corriendo después de que lo detuviste, un log de CI o de un contenedor que solo dice exit code 137, y un lote que tarda 15 segundos cuando la máquina tiene 8 núcleos libres. Vas a ver el árbol de procesos, mandar cada señal común a procesos que lanzamos nosotros mismos, leer los códigos de salida que producen y medir lo que xargs -P realmente te da.
Entorno: macOS 26, Mac con Apple Silicon (M1 Pro, 8 núcleos), zsh 5.9 y GNU bash 3.2.57. ps, kill, pgrep y xargs de BSD. Las formas de GNU/Linux están marcadas como "no ejecutado aquí". La carpeta de trabajo aparece como ~/demo/jobs. Una regla de seguridad que seguimos todo el tiempo y que tú también deberías seguir: manda señales a los procesos por el PID que guardaste, nunca por nombre. pkill sleep también le pegaría a cualquier otro sleep de la máquina, incluidos los jobs de otras personas.
Si te saltaste clases, la clase 4 explica $? y set -e, que usamos aquí como base. La visión general para quien recién empieza está en la hoja de ruta de aprendizaje.
Procesos, PID y ps
Cada programa en ejecución es un proceso con un número, su PID. Cada proceso (excepto el primero) tiene un padre, cuyo número es el PPID. Tu shell es un proceso; cada comando que ejecuta es un proceso hijo. Tres variables de la shell te dan los números que necesitas:
$$: el PID de la shell actual (dentro de una( subshell )sigue mostrando el número del padre en bash 3.2;BASHPIDllegó en bash 4.0 y aquí imprimióunset),$!: el PID del último job que lanzaste en segundo plano,$?: el código de salida del último comando.
Lanza tres sleep en segundo plano y míralos:
# sig.sh (first part)
sleep 300 & p1=$!
sleep 300 & p2=$!
sleep 300 & p3=$!
ps -o pid,ppid,stat,command -p "$p1,$p2,$p3"
## bash
  PID  PPID STAT COMMAND
 3312  3310 S    sleep 300
 3313  3310 S    sleep 300
 3314  3310 S    sleep 300
## zsh
  PID  PPID STAT COMMAND
 3584  3581 SN   sleep 300
 3585  3581 SN   sleep 300
 3586  3581 SN   sleep 300
S significa durmiendo (sleeping). La N en zsh es una sorpresa que vale la pena conocer: la opción BG_NICE de zsh, activada por defecto, ejecuta los jobs en segundo plano con menor prioridad, incluso dentro de un script. bash no lo hizo. Si un trabajo en paralelo va más lento con zsh, esa es una de las razones.
ps -o ... -p PIDS es la forma BSD y funciona en macOS. En Linux es común ps -o pid,ppid,stat,cmd -p ... o ps -ef --forest (no ejecutado aquí). pgrep -P PID lista los hijos de un PID, y así encontramos los procesos que lanzó nuestro script sin buscar por nombre.
Señales y la regla 128+N
Una señal es un mensaje corto que el kernel le entrega a un proceso: "por favor detente", "detente ya", "tu terminal desapareció". Un proceso puede atrapar la mayoría de las señales y ejecutar un handler; dos (KILL y STOP) nunca se pueden atrapar. Cuando un proceso muere por la señal N, la shell reporta el código de salida 128 + N. El resto de sig.sh:
kill -TERM "$p1"; wait "$p1"; echo "TERM -> wait status $?"
kill -KILL "$p2"; wait "$p2"; echo "KILL -> wait status $?"
kill -INT "$p3"; sleep 0.5; kill -0 "$p3" && echo "INT ignored: $p3 still alive"
kill -TERM "$p3"; wait "$p3"; echo "then TERM -> $?"
kill -0 "$p1"; echo "kill -0 on finished pid -> $?"
## bash
sig.sh: line 5:  3312 Terminated: 15          sleep 300
TERM -> wait status 143
sig.sh: line 6:  3313 Killed: 9               sleep 300
KILL -> wait status 137
INT ignored: 3314 still alive
sig.sh: line 8:  3314 Terminated: 15          sleep 300
then TERM -> 143
sig.sh: line 9: kill: (3312) - No such process
kill -0 on finished pid -> 1
## zsh
TERM -> wait status 143
KILL -> wait status 137
INT ignored: 3586 still alive
then TERM -> 143
sig.sh:kill:9: kill 3584 failed: no such process
kill -0 on finished pid -> 1
kill -0 PID no manda nada; solo revisa que el proceso exista y que tengas permiso de mandarle señales. Es la prueba estándar de "¿sigue corriendo?", y la clase 6 la usa para detectar un lock abandonado.
Esta es la tabla que armamos con estas ejecuciones y algunas más (yes | head -1 para SIGPIPE, nohup para SIGHUP):
| Señal | N.º (macOS) | Acción por defecto | ¿Se puede atrapar? | Código de salida visto | Origen típico |
|---|---|---|---|---|---|
| HUP | 1 | terminar | sí | 129 | se cerró la terminal, se cayó el SSH |
| INT | 2 | terminar | sí | 130 | Ctrl-C |
| KILL | 9 | terminar | no | 137 | kill -9, el OOM killer, el runtime de contenedores después de un timeout |
| PIPE | 13 | terminar | sí | 141 | escribir en un pipe cerrado (yes | head -1) |
| TERM | 15 | terminar | sí | 143 | kill PID, docker stop, gestores de servicios |
| STOP / CONT | 17 / 19 | pausar / reanudar | no / sí | — | kill -STOP; ps muestra el estado T |
Los números de las señales no son todos portables: kill -l USR1 imprimió 30 en macOS, mientras que Linux usa 10 (no ejecutado aquí). Usa siempre los nombres (kill -TERM, trap ... TERM), nunca números distintos de los clásicos 1, 2, 9 y 15.
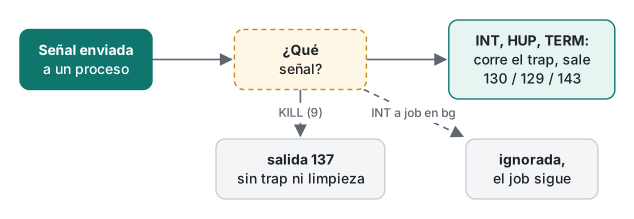
Error típico: kill -INT a un job en segundo plano
La línea INT ignored: ... still alive de arriba sorprende a casi todo el mundo. Lo que realmente pasa: cuando una shell no interactiva (un script) lanza un job con &, pone SIGINT y SIGQUIT en "ignorar" para ese hijo, así que un Ctrl-C en la terminal solo le llega al proceso en primer plano. Un proceso no puede dejar de ignorar una señal que ya estaba ignorada cuando la shell lo lanzó, así que ni siquiera un trap dentro del hijo la puede atrapar.
Se puso más raro cuando mandamos la señal inmediatamente después del &:
# three tries each
bash -c 'sleep 30 & p=$!; sleep 0.2; kill -INT $p; sleep 0.2; kill -0 $p 2>/dev/null && echo "alive after INT" || echo dead; ...'
bash -c 'sleep 30 & p=$!;            kill -INT $p; sleep 0.2; kill -0 $p 2>/dev/null && echo "nosleep: alive" || echo "nosleep: dead"; ...'
alive after INT
alive after INT
alive after INT
nosleep: dead
nosleep: dead
nosleep: dead
Sin demora, la señal llegó en la pequeñísima ventana entre el fork() y el momento en que el hijo activó el "ignorar", así que murió con 130. Es una condición de carrera: un script que "funciona" porque manda la señal rápido va a fallar en una máquina más ocupada. Solución: manda TERM a los jobs en segundo plano. No se ignora, se puede atrapar para hacer limpieza y es lo que mandan los gestores de servicios.
Para que conste, un proceso que de verdad muere por SIGINT sí reporta 130: sh -c 'kill -INT $$' devolvió 130, igual que un one-liner de Python que se interrumpió a sí mismo (después de imprimir KeyboardInterrupt).
Jobs en segundo plano, wait y cómo recoger los códigos de salida
cmd & regresa de inmediato; wait PID se bloquea hasta que ese job termina y devuelve su código de salida. Un wait sin argumentos espera a todos los jobs pero devuelve 0 y tira los códigos a la basura:
# waitall.sh
job() { sleep "$1"; return "$2"; }
job 0.3 0 & a=$!
job 0.1 3 & b=$!
job 0.2 0 & c=$!
fail=0
for p in $a $b $c; do
  if wait "$p"; then echo "pid $p ok"; else rc=$?; echo "pid $p failed rc=$rc"; fail=1; fi
done
wait; echo "plain wait returns $? (exit codes lost)"
exit $fail
pid 20922 ok
pid 20923 failed rc=3
pid 20926 ok
plain wait returns 0 (exit codes lost)
script exit=1
zsh 5.9 dio el mismo resultado. Fíjate que el job que terminó primero (b, 0.1 s) se reportó bien aunque lo esperamos en segundo lugar; la shell guarda el estado de los hijos terminados hasta que lo recoges. bash 4.3 agregó wait -n ("espera al que termine primero"); bash 3.2 respondió wait: -n: invalid option, así que en una Mac de fábrica recorres los PID como arriba.
trap: limpiar, y el huérfano que puede dejar
trap 'comandos' SEÑALES ejecuta comandos cuando la shell recibe una señal; la pseudoseñal EXIT se ejecuta siempre que la shell sale. Esta es una primera versión, equivocada:
# trap.sh
tmp=$(mktemp "${TMPDIR:-/tmp}/demo.XXXXXX")
cleanup() { rm -f "$tmp"; echo "cleanup: removed temp file"; }
trap cleanup EXIT
trap 'echo "got TERM"; exit 143' TERM
echo "working, pid $$"
sleep 300 &
wait $!
$ bash trap.sh & tp=$!; sleep 0.5; kill -TERM $tp; wait $tp; echo "trap.sh exit=$?"
working, pid 8570
got TERM
cleanup: removed temp file
trap.sh exit=143
$ ps -o pid,ppid,command -p 8576
  PID  PPID COMMAND
 8576     1 sleep 300
El script limpió su archivo temporal y salió con 143, tal como estaba diseñado, pero su hijo sleep 300 siguió corriendo con PPID 1: fue re-adoptado por launchd (en Linux, init/systemd). Las señales van a un proceso, no a sus hijos. En la vida real ese hijo es un rsync, un curl o un worker de Python, y la siguiente ejecución arranca una segunda copia. (Detuvimos a ese huérfano por su PID.)
La solución es recordar el PID del hijo y detenerlo en la limpieza:
# trap2.sh
tmp=$(mktemp "${TMPDIR:-/tmp}/demo.XXXXXX")
child=""
cleanup() {
  [ -z "$child" ] || kill "$child" 2>/dev/null
  rm -f "$tmp"; echo "cleanup: removed temp file, stopped child"
}
trap cleanup EXIT
trap 'echo "got TERM"; exit 143' TERM
sleep 300 & child=$!
wait "$child"
  PID  PPID STAT COMMAND
99609 99607 SN   bash trap2.sh
99613 99609 SN   sleep 300
got TERM
cleanup: removed temp file, stopped child
trap2.sh exit=143
child still alive? no
¿Por qué sleep 300 & wait $! en vez de un simple sleep 300? Porque bash ejecuta un trap solo después de que termina el comando en primer plano actual. Un TERM enviado durante un sleep en primer plano espera a que el sleep termine; wait se interrumpe de inmediato. La clase 6 lo mide: 4 s de demora con un sleep 5 en primer plano, 0 s con & wait.
nohup, SIGHUP y cerrar la terminal
Cuando se cierra una terminal o una sesión SSH, sus procesos reciben SIGHUP. nohup lanza un comando con SIGHUP ignorado:
# hup.sh
sleep 300 & plain=$!
nohup sleep 300 & guarded=$!
sleep 0.3
kill -HUP "$plain" "$guarded"; sleep 0.3
for p in "$plain" "$guarded"; do
  if kill -0 "$p" 2>/dev/null; then echo "$p alive after HUP"; else wait "$p"; echo "$p died, status $?"; fi
done
kill "$guarded"; wait "$guarded"; echo "guarded after TERM: $?"
ls nohup.out
hup.sh: line 4: 20654 Hangup: 1               sleep 300
20654 died, status 129
20655 alive after HUP
hup.sh: line 8: 20655 Terminated: 15          nohup sleep 300
guarded after TERM: 143
ls: nohup.out: No such file or directory
Dos detalles: nohup solo protege contra HUP (TERM igual lo mató, 143), y crea nohup.out solo cuando stdout es una terminal. En un script cuya salida ya estaba redirigida no aparece ningún archivo, así que redirige de forma explícita: nohup cmd > job.log 2>&1 &. Para cualquier cosa que tenga que sobrevivir a un reinicio, usa un gestor de servicios de verdad (launchd en macOS, systemd en Linux) en lugar de nohup.
SIGPIPE, 141 y pipefail
Una señal más que te encuentras sin haberla mandado:
$ bash -c 'yes | head -1; echo "PIPESTATUS=${PIPESTATUS[*]}"'
y
PIPESTATUS=141 0
$ bash -c 'set -o pipefail; yes | head -1 >/dev/null; echo "pipefail rc=$?"'
pipefail rc=141
head sale después de una línea; yes entonces escribe en un pipe cerrado y muere por SIGPIPE (141). Es normal e inofensivo, pero con set -o pipefail (clase 4) todo el pipeline ahora "falla" con 141. Si un script en modo estricto muere en ... | head, esta es la razón; revisa PIPESTATUS (bash) o pipestatus (zsh, que también imprimió 141 0) y acepta 141 para el productor.
Medido: cuánto acelera xargs -P
xargs -P N ejecuta hasta N comandos a la vez. Comprimimos 16 archivos de log generados (unos 11 MB cada uno, 176 MB en total, creados con awk y srand(42)) con gzip -9, y por separado ejecutamos 16 tareas que solo hacen sleep 0.5:
printf '%s\0' in/*.log | xargs -0 -P "$P" -n 1 sh -c 'gzip -9 -c "$1" > /dev/null' _
| -P | gzip -9 ×16 (mediana de 3) | aceleración | sleep 0.5 ×16 (1 ejecución) |
|---|---|---|---|
| 1 | 15.59 s | 1.0× | 8.19 s |
| 2 | 7.86 s | 2.0× | — |
| 4 | 4.19 s | 3.7× | 2.05 s |
| 8 | 3.89 s | 4.0× | — |
| 16 | 3.96 s | 3.9× | 0.54 s |
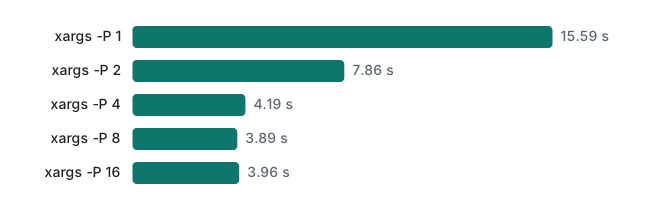
Lo que dicen los números:
- El trabajo que espera (llamadas de red, sleeps) escala casi perfecto: 16 a la vez tardaron 0.54 s, unas 15× más rápido.
- El trabajo de CPU escaló bien hasta 4 y luego se aplanó. La M1 Pro tiene 8 núcleos (6 de rendimiento y 2 de eficiencia), y la máquina también estaba corriendo otros trabajos (load average de 8.6–12.8 durante estas ejecuciones), así que 8 gzip en paralelo no consiguieron 8 núcleos libres. Las ejecuciones con -P 8 fueron de 2.53 s a 4.64 s en seis intentos (los tres primeros pasaron los nombres con
ls in/*.log | xargs -P 8 -n 1 ..., los tres últimos con la formaprintf ... -0de arriba; los nombres no tienen espacios, así que ambas pasan los mismos argumentos). En una máquina sin carga espera más, pero nunca más que la cantidad de núcleos. - Subir por encima de la cantidad de núcleos (16) no ayudó y solo agregó uso de memoria.
Un detalle para el manejo de errores: cuando una de las 16 tareas falló, el xargs de BSD en macOS salió con 1 (según su página man: 1 para "cualquier otro error"). GNU xargs usa 123 para "un comando salió con 1–125" (no ejecutado aquí). Si un script revisa 123, no va a ver los fallos en una Mac.
Qué señal y qué herramienta usar
| Quieres… | Usa | Por qué |
|---|---|---|
| pedirle a un proceso que se detenga y limpie | kill -TERM PID |
se puede atrapar; es lo que mandan los gestores de servicios |
| detenerlo cuando TERM no funcionó después de unos segundos | kill -KILL PID |
no se puede atrapar; no se ejecuta ninguna limpieza (137) |
| revisar si un PID sigue vivo | kill -0 PID |
no manda nada |
| pausar / reanudar | kill -STOP / kill -CONT |
ps muestra T mientras está detenido |
| sobrevivir al cierre de la terminal | nohup cmd > log 2>&1 & |
solo ignora HUP |
| ejecutar N jobs a la vez | xargs -0 -P N, o & + wait PID |
wait PID conserva cada código de salida |
| encontrar tus propios hijos | pgrep -P $$ |
sin buscar por nombre |
Límites honestos y notas de versión
- Solo se ejecutó en macOS (bash 3.2.57, zsh 5.9).
timeout,setsidyflockno vienen instalados en macOS (command -vno encontró ninguno); en Linuxtimeout 10 cmddevuelve 124 cuando se agota el tiempo (no ejecutado aquí). - Los códigos de salida 128+N son lo que reportan bash y zsh. Algunas herramientas imprimen sus propios códigos; el "137" de Docker/Kubernetes significa que el proceso principal del contenedor recibió SIGKILL, muchas veces del OOM killer, pero esa es su convención (no ejecutado aquí).
wait -n(bash 4.3) yBASHPID(bash 4.0) no existen en bash 3.2; vimos los errores. Los números de versión vienen del archivo NEWS de bash; no ejecutamos bash 4/5.- La máquina del benchmark estaba compartida con otro trabajo. Reportamos medianas y el rango, y la prueba con sleep no se ve afectada por la carga de CPU.
Ejercicios
- Un script lanza
./worker.sh &y más tarde ejecutakill -INT $!para detenerlo, pero el worker sigue corriendo. ¿Por qué, y qué debería mandar en su lugar? - Un paso de CI reporta
exit code 143y otro reporta137. ¿Qué pasó en cada caso, y cuál de los dos pudo ejecutar un trap de limpieza?
Respuestas
- Los jobs en segundo plano de una shell no interactiva ignoran SIGINT, así que la señal se descarta. Manda
kill -TERM "$pid"ywait "$pid"(espera 143 si no tenía handler). - 143 = 128 + 15: el paso recibió SIGTERM (una detención educada, por ejemplo un timeout o un job cancelado); un
trap ... TERMotrap ... EXITpudo ejecutarse. 137 = 128 + 9: SIGKILL, muchas veces después de que TERM fue ignorado o por una muerte por falta de memoria; no se ejecuta ningún trap.
Lo que sigue
La clase 6 junta todo en scripts robustos: locks, cron y logging, y mide la demora del trap con sleep en primer plano que mencionamos arriba.
Anterior: Clase 4: variables, comillas y códigos de salida · Siguiente: Clase 6: scripts robustos, cron y logging (en inglés) · Antes: Clase 3: find, xargs, sed y awk
Preguntas frecuentes
¿Qué significan los códigos de salida 130, 137 y 143?
Son 128 más el número de una señal: 130 es SIGINT (2, normalmente Ctrl-C), 137 es SIGKILL (9, kill -9 o el OOM killer que mata procesos por falta de memoria) y 143 es SIGTERM (15, un kill educado). Produjimos los tres con wait después de mandar cada señal a un sleep en segundo plano. 129 (SIGHUP) y 141 (SIGPIPE) siguen la misma regla.
¿Por qué kill -INT no detiene un proceso en segundo plano lanzado desde un script?
Una shell no interactiva lanza los jobs en segundo plano con SIGINT y SIGQUIT ignorados, así que Ctrl-C en la terminal no les llega. Un kill -INT enviado 0.2 s después de lanzar el job lo dejó vivo en los tres intentos. Enviado justo después del fork, lo mató, porque el hijo todavía no había activado el ignore. Usa SIGTERM para los jobs en segundo plano.
¿Cuánto más rápido es xargs -P para trabajo en paralelo?
Con 16 trabajos de gzip -9 de unos 11 MB cada uno, la mediana pasó de 15.59 s con -P 1 a 7.86 s con -P 2, 4.19 s con -P 4 y 3.89 s con -P 8, en una M1 Pro de 8 núcleos que además estaba corriendo otras cosas. Con trabajos que sobre todo esperan (sleep 0.5), -P 16 fue 15 veces más rápido que -P 1.