Índices SQL y EXPLAIN QUERY PLAN con 1M de filas
Lee EXPLAIN QUERY PLAN, mide con y sin índice en 1,000,000 de filas (46.6 ms vs 0.024 ms), elige el orden del índice compuesto y evita sus trampas.
Serie: curso de SQL 4/6 (intermedio). Para quienes ya escriben SELECT, JOIN y GROUP BY y ahora tienen una consulta que de repente se volvió lenta. Al terminar esta clase vas a saber leer EXPLAIN QUERY PLAN, decidir qué índice crear y en qué orden van sus columnas, y reconocer los cuatro patrones que hacen que una base de datos ignore un índice.
Si la página de historial de pedidos de tu app se puso lenta cuando la tabla pasó de unos cientos de miles de filas, o si en un code review te preguntaron "¿esa columna tiene índice?" y no supiste cómo comprobarlo, este artículo es para ti. Pasa mucho en el primer proyecto real después de un bootcamp: en desarrollo todo vuela con 50 filas, y en producción el mismo endpoint tarda segundos. Los índices son la palanca de rendimiento más grande de SQL y también la más fácil de usar mal: un índice puede hacer una consulta 1,900 veces más rápida, y el índice equivocado puede hacer otra diez veces más lenta. Todos los números de abajo vienen de una tabla de 1,000,000 de filas que generamos con una fórmula fija, así que puedes reconstruir exactamente los mismos datos.
Entorno: SQLite 3.51.0 (la CLI sqlite3 y el SQLite incluido en Python 3.9.6, también 3.51.0), Mac con Apple Silicon (M1 Pro), macOS. Los tiempos son medianas; la tabla y su contenido son deterministas.
Una tabla de 1,000,000 de filas en un segundo
El random() de SQLite no admite semilla, así que los datos salen de un generador congruencial lineal (LCG, una fórmula determinista sencilla: siguiente = anterior × 1103515245 + 12345, módulo 2³¹) alimentado por una CTE recursiva. Guarda esto como make_orders.sql:
-- 1,000,000 shop orders, deterministic (no random(): an LCG on the row number)
CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  status      TEXT    NOT NULL,
  amount      INTEGER NOT NULL,   -- yen
  email       TEXT    NOT NULL,
  created_at  TEXT    NOT NULL    -- 'YYYY-MM-DD HH:MM:SS'
);
WITH RECURSIVE n(i, r) AS (
  SELECT 1, 42
  UNION ALL
  SELECT i + 1, (r * 1103515245 + 12345) % 2147483648 FROM n WHERE i < 1000000
)
INSERT INTO orders (id, customer_id, status, amount, email, created_at)
SELECT i,
       1 + r % 50000,
       CASE (r / 7) % 20 WHEN 0 THEN 'cancelled' WHEN 1 THEN 'refunded'
                         WHEN 2 THEN 'pending' ELSE 'paid' END,
       100 + (r / 13) % 20000,
       'User' || (1 + r % 50000) || '@example.com',
       datetime('2025-01-01', '+' || ((r / 17) % 31536000) || ' seconds')
FROM n;
$ time sqlite3 shop.db < make_orders.sql
sqlite3 shop.db < make_orders.sql  0.73s user 0.08s system 99% cpu 0.824 total
$ sqlite3 shop.db "SELECT count(*), count(DISTINCT customer_id), min(created_at), max(created_at) FROM orders;"
1000000|50000|2025-01-01 00:00:00|2025-12-31 23:59:44
Un millón de pedidos de 50,000 clientes a lo largo de 2025, en un archivo de 62.6 MB. (Las CTE recursivas son tema de la clase 6; aquí solo usamos una como generador de filas.)
Cómo leer EXPLAIN QUERY PLAN: SCAN contra SEARCH
Un índice es una copia aparte y ordenada de una o más columnas, en la que cada entrada apunta de vuelta a su fila (en SQLite, mediante el rowid). Como está ordenado, la base de datos puede hacer una búsqueda binaria en él en lugar de leer todas las filas. EXPLAIN QUERY PLAN (EQP) le pregunta a la base de datos cómo piensa ejecutar una consulta, sin ejecutarla.
sqlite> .timer on
sqlite> EXPLAIN QUERY PLAN SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
QUERY PLAN
`--SCAN orders
sqlite> SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
17|212448
Run Time: real 0.052 user 0.036612 sys 0.013766
SCAN orders significa "leer toda la tabla". Ahora crea un índice y vuelve a preguntar:
sqlite> CREATE INDEX idx_orders_customer ON orders(customer_id);
sqlite> EXPLAIN QUERY PLAN SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
QUERY PLAN
`--SEARCH orders USING INDEX idx_orders_customer (customer_id=?)
sqlite> SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
17|212448
Run Time: real 0.000 user 0.000018 sys 0.000006
Las palabras que tienes que buscar:
| EQP dice | Significado | Normalmente |
|---|---|---|
SCAN orders |
lee todas las filas de la tabla | lento en tablas grandes, bien en las pequeñas |
SEARCH orders USING INDEX x (col=?) |
búsqueda binaria en el índice x y luego trae cada fila | lo que quieres para filtros selectivos |
SEARCH … USING COVERING INDEX x |
el índice solo ya tiene todas las columnas necesarias; no toca la tabla | lo más rápido |
SCAN orders USING COVERING INDEX x |
lee todo el índice en lugar de la tabla | sigue siendo un recorrido completo, solo que más angosto |
USE TEMP B-TREE FOR ORDER BY |
ordena el resultado aparte | un índice podría darte el orden gratis |
MULTI-INDEX OR |
cada lado de un OR usa su propio índice | bien |
La cuarta fila engaña a mucha gente: "USING COVERING INDEX" suena bien, pero el SCAN delante significa que igual se lee cada entrada.
El .timer de la CLI tiene una resolución de 1 ms, demasiado gruesa aquí, así que los tiempos del resto del artículo vienen de un pequeño script de Python sobre la misma versión de SQLite. Ejecuta cada consulta unas cuantas veces sin medir para calentar la caché de páginas y luego reporta la mediana:
import sqlite3, statistics, time
con = sqlite3.connect("shop.db")
def med(sql, params_list, reps=5):
    for p in params_list[:3]:
        con.execute(sql, p).fetchall()                    # warm-up
    ts = []
    for _ in range(reps):
        for p in params_list:
            t = time.perf_counter(); con.execute(sql, p).fetchall()
            ts.append((time.perf_counter() - t) * 1000)
    return statistics.median(ts)                          # ms
Veinte ids de cliente de random.Random(42), cinco repeticiones cada uno:
| Consulta | Mediana |
|---|---|
WHERE customer_id = ?, sin índice |
46.595 ms |
lo mismo, con índice en customer_id |
0.024 ms |
el propio CREATE INDEX |
459.7 ms, archivo de 62.6 MB → 74.0 MB |
Unas 1,900 veces más rápido a cambio de medio segundo de construcción y 11 MB de disco.
Índices compuestos: el orden de las columnas lo decide todo
Un índice compuesto sobre (customer_id, created_at) está ordenado como un directorio telefónico: primero por cliente y, dentro de cada cliente, por fecha. Puede encontrar directamente "cliente 5, de diciembre en adelante". Un índice sobre (created_at, customer_id) está ordenado primero por fecha; para la misma pregunta solo puede saltar a diciembre y luego revisar cada fila de diciembre buscando al cliente.
(customer_id, created_at):    0.010 ms   SEARCH orders USING INDEX i (customer_id=? AND created_at>?)
(created_at, customer_id):    3.219 ms   SEARCH orders USING INDEX i (created_at>?)
Los dos planes dicen SEARCH, así que "usa un índice" no basta. Lee lo que hay dentro de los paréntesis: el segundo índice solo usa created_at>?. La regla práctica es primero las columnas de igualdad, después la columna de rango o de orden.
El índice compuesto también reemplaza al de una sola columna, porque una consulta puede usar cualquier prefijo por la izquierda del índice. Después de borrar idx_orders_customer:
sqlite> EXPLAIN QUERY PLAN SELECT count(*) FROM orders WHERE customer_id = 5;
`--SEARCH orders USING COVERING INDEX idx_orders_cust_created (customer_id=?)
sqlite> EXPLAIN QUERY PLAN SELECT count(*) FROM orders WHERE created_at >= '2025-12-01';
`--SCAN orders USING COVERING INDEX idx_orders_cust_created
La segunda consulta se salta la primera columna, así que recorre todo. El mismo índice también elimina el ordenamiento:
-- index on (customer_id) only
SELECT id, amount, created_at FROM orders WHERE customer_id = 5 ORDER BY created_at DESC LIMIT 5;
|--SEARCH orders USING INDEX idx_orders_customer (customer_id=?)
`--USE TEMP B-TREE FOR ORDER BY
-- index on (customer_id, created_at)
`--SEARCH orders USING INDEX idx_orders_cust_created (customer_id=?)
Si no quieres adivinar, la CLI tiene un asesor de índices, .expert, que propuso exactamente esto:
sqlite> .expert
sqlite> SELECT sum(amount) FROM orders WHERE customer_id = 12345 AND created_at >= '2025-06-01' ORDER BY created_at;
CREATE INDEX orders_idx_30ddf7e6 ON orders(customer_id, created_at);

SEARCH orders USING INDEX orders_idx_30ddf7e6 (customer_id=? AND created_at>?)
Error común: el índice existe, pero la consulta no puede usarlo
Todo esto se ejecutó con índices en customer_id, email y created_at ya creados.
1. Una función alrededor de la columna. Escribiste date(created_at) = '2025-03-01'. Lo que pasa: el índice está ordenado por created_at, no por date(created_at), así que SQLite recorre todo: 86.4 ms. Solución: reescríbelo como un rango sobre la columna original: 0.069 ms.
-- SCAN orders USING COVERING INDEX idx_orders_created     86.407 ms
SELECT count(*) FROM orders WHERE date(created_at) = '2025-03-01';
-- SEARCH ... (created_at>? AND created_at<?)                0.069 ms
SELECT count(*) FROM orders WHERE created_at >= '2025-03-01' AND created_at < '2025-03-02';
Cuando de verdad necesitas la función (buscar un e-mail sin distinguir mayúsculas), indexa la expresión misma:
sqlite> SELECT count(*), sum(amount) FROM orders WHERE lower(email) = 'user123@example.com';
`--SCAN orders
Run Time: real 0.160 user 0.138400 sys 0.013989
sqlite> CREATE INDEX idx_orders_email_lower ON orders(lower(email));
sqlite> SELECT count(*), sum(amount) FROM orders WHERE lower(email) = 'user123@example.com';
`--SEARCH orders USING INDEX idx_orders_email_lower (<expr>=?)
Run Time: real 0.000 user 0.000098 sys 0.000058
2. LIKE sobre un índice normal. LIKE 'User123@%' parece una búsqueda por prefijo, pero igual recorrió la tabla. Por defecto, el LIKE de SQLite no distingue mayúsculas en ASCII, mientras que un índice normal está ordenado distinguiéndolas (collation BINARY), así que el índice no puede responder. GLOB (que sí distingue mayúsculas) puede, y también un índice declarado con COLLATE NOCASE (resumido: consulta, plan y tiempo real de .timer):
WHERE email LIKE 'User123@%'             `--SCAN orders                                    0.081 s
WHERE email GLOB 'User123@*'             `--SEARCH ... idx_orders_email (email>? AND email<?)
-- after CREATE INDEX idx_orders_email_nocase ON orders(email COLLATE NOCASE);
WHERE email LIKE 'user123@%'             `--SEARCH ... idx_orders_email_nocase (email>? AND email<?)
WHERE email LIKE '%123@example.com'      `--SCAN orders                                    0.103 s
La última línea es el límite duro: con un % al principio ningún índice B-tree puede ayudar, porque el índice está ordenado por el comienzo del texto. Para eso necesitas un índice de texto completo (SQLite FTS5) o una columna con el texto invertido.
3. OR entre columnas. customer_id = 7 OR email = 'User8@example.com' dio un MULTI-INDEX OR porque ambas columnas tienen índice. customer_id = 7 OR amount = 500 dio SCAN orders: un solo lado sin índice obliga a recorrer toda la tabla para la condición completa.
4. Saltarse la primera columna de un índice compuesto, como vimos arriba.
Algo que en SQLite no rompe el índice: WHERE customer_id = '7' siguió mostrando SEARCH, porque la afinidad de tipo de la columna INTEGER convierte el texto. En MySQL, comparar una columna de texto con un número es un asesino de índices bien conocido (no se ejecutó aquí).
Cuando un índice vuelve más lenta la consulta
Esta es la medición que nos sorprendió. Con un índice en created_at, sumamos amount sobre rangos de fechas cada vez más grandes, forzando cada estrategia con NOT INDEXED / INDEXED BY (7 ejecuciones cada una, mediana):
| Rango | Filas encontradas | Recorrido completo | Índice en created_at |
Índice cubriente (created_at, amount) |
|---|---|---|---|---|
| 1 día | 2,792 | 74.92 ms | 4.40 ms | 0.14 ms |
| 1 mes | 84,728 | 78.96 ms | 152.54 ms | 3.34 ms |
| 6 meses | 497,165 | 93.55 ms | 965.40 ms | 22.68 ms |
| 12 meses | 1,000,000 | 94.53 ms | 2,174.05 ms | 44.25 ms |
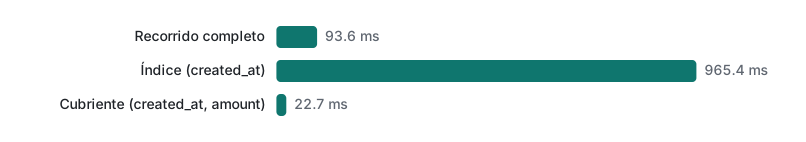
Con un índice simple, cada entrada que coincide implica una búsqueda aparte en la tabla para traer amount, en orden aleatorio. Con cerca del 8% de la tabla (un mes) eso ya era el doble de lento que leer toda la tabla en orden. Y SQLite eligió ese plan lento por su cuenta, incluso después de ANALYZE:
sqlite> EXPLAIN QUERY PLAN SELECT count(*), sum(amount) FROM orders WHERE created_at >= '2025-01-01' AND created_at < '2025-07-01';
`--SEARCH orders USING INDEX idx_orders_created (created_at>? AND created_at<?)
497165|5022432858
Run Time: real 1.186 user 0.536726 sys 0.474209
sqlite> ANALYZE;
sqlite> SELECT * FROM sqlite_stat1;
orders|idx_orders_created|1000000 1
-- EQP again: same SEARCH ... USING INDEX idx_orders_created
Run Time: real 1.071 user 0.497285 sys 0.439523
sqlite_stat1 solo guarda "filas por clave", no la distribución de las fechas, así que el planificador no puede saber que seis meses son media tabla (la compilación que usamos no tenía SQLITE_ENABLE_STAT4, que guardaría muestras). Dos soluciones: hacer que el índice sea cubriente (22.7 ms), o decirle a SQLite que no use el índice para esa condición con un más unario:
sqlite> SELECT count(*), sum(amount) FROM orders WHERE +created_at >= '2025-01-01' AND +created_at < '2025-07-01';
`--SCAN orders
Run Time: real 0.095 user 0.077709 sys 0.013404
Lo que cuesta un índice al escribir
Cada INSERT también tiene que insertar en cada índice. Agregamos 100,000 filas a la tabla de 1,000,000 en una sola transacción (3 ejecuciones cada una):
| Índices secundarios | Tiempo de inserción (mediana) | Tamaño del archivo después |
|---|---|---|
| 0 | 71.3 ms | 68.8 MB |
1 (customer_id) |
213.6 ms | 82.8 MB |
3 (+ email, + created_at) |
584.2 ms | 151.3 MB |
Tres índices hicieron las inserciones unas ocho veces más lentas y más que duplicaron el archivo. Los índices de texto (email, created_at) son los caros. Los índices no son gratis: créalos para las consultas que de verdad ejecutas.
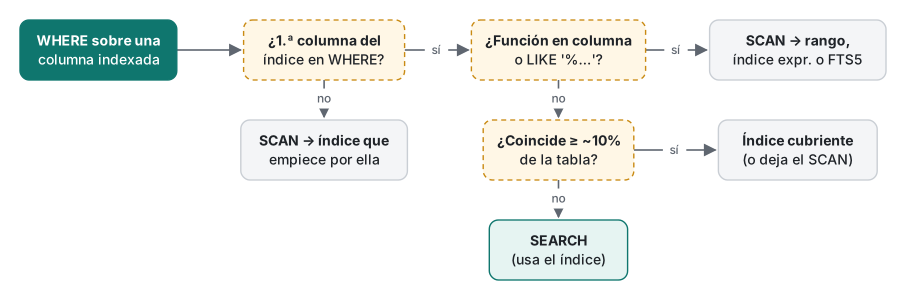
¿Qué índice debería crear?
| Tu consulta | Índice | Por qué |
|---|---|---|
WHERE a = ? |
(a) |
SEARCH básico |
WHERE a = ? AND b = ? |
(a, b) o (b, a); pon primero la más selectiva |
ambas son igualdad |
WHERE a = ? AND b > ? |
(a, b) |
igualdad antes que rango |
WHERE a = ? ORDER BY b |
(a, b) |
elimina el ordenamiento con TEMP B-TREE |
SELECT sum(c) … WHERE a BETWEEN … sobre muchas filas |
(a, c) cubriente |
evita una búsqueda en la tabla por fila |
WHERE lower(x) = ? |
índice de expresión (lower(x)) |
la función debe coincidir exactamente |
WHERE x LIKE 'abc%' |
(x COLLATE NOCASE), o usa GLOB |
LIKE no distingue mayúsculas |
WHERE x LIKE '%abc' |
ninguno; FTS5 o una columna invertida | los B-tree ordenan por prefijo |
WHERE status = 'paid' (85% de las filas) |
normalmente ninguno | un recorrido es más rápido que 850,000 búsquedas |
Ejercicios
- Una página ejecuta
SELECT id, amount, created_at FROM orders WHERE status = 'paid' AND customer_id = ? ORDER BY created_at DESC LIMIT 3. ¿Qué índice único da un plan sinUSE TEMP B-TREE? WHERE substr(email, 1, 7) = 'User123'recorre toda la tabla aunqueemailtiene índice. Reescríbelo para que use el índice, sin crear uno nuevo.
Respuestas
CREATE INDEX idx_orders_cust_status_created ON orders(customer_id, status, created_at);Las dos columnas de igualdad primero y la de orden al final. Nuestro plan:SEARCH orders USING INDEX idx_orders_cust_status_created (customer_id=? AND status=?), sin temp B-tree, y los tres pedidos pagados más recientes del cliente 5 salieron ya ordenados.WHERE email >= 'User123' AND email < 'User124'. Todo texto que empieza conUser123queda ordenado entre esos dos valores. Ambas versiones devolvieron 2,276 filas; el plan pasó deSCAN … USING COVERING INDEX idx_orders_emailaSEARCH … (email>? AND email<?).
Límites honestos y notas de versión
- Todo se ejecutó solo en SQLite 3.51.0. El formato de salida de EQP cambió con el tiempo (el dibujo de árbol con
`--es de la 3.24); las versiones anteriores imprimen una tabla plana..expertes una función de la CLI y puede faltar en compilaciones mínimas. - Los índices de expresión necesitan SQLite 3.9 o posterior;
NOT INDEXED,INDEXED BYy el truco del más unario son propios de SQLite. MySQL tieneUSE INDEX/IGNORE INDEX, y PostgreSQL no tiene pistas de índice (no se ejecutó aquí). - PostgreSQL y MySQL guardan histogramas, así que probablemente evitarían el índice simple para seis meses de datos; no los probamos. El punto de cruce del 8% depende del ancho de fila, la caché y el almacenamiento, así que mide tu propia tabla.
- Los datos son sintéticos: un LCG no es un buen generador aleatorio y los montos se repiten dentro de un mismo cliente. Eso no cambia el comportamiento de los índices, pero no uses esta tabla para estadísticas.
- Los tiempos son medianas en una sola máquina mientras corría otro trabajo; toma las proporciones como significativas y los milisegundos absolutos como aproximados.
¿Quieres ver por qué una consulta parametrizada importa tanto como un índice? Lee PDO + SQLite e inyección SQL (en inglés). Para ver dónde encaja SQL en una ruta de aprendizaje, revisa la ruta de estudio de programación.
Anterior: Clase 3: JOIN, GROUP BY y subconsultas · Siguiente: Clase 5: transacciones, aislamiento y bloqueos
Preguntas frecuentes
¿Cuánto más rápida es una consulta con índice en SQL?
Con 1,000,000 de filas en SQLite 3.51, buscar los pedidos de un cliente tardó una mediana de 46.6 ms recorriendo toda la tabla y 0.024 ms con un índice en customer_id (Apple M1 Pro). Crear ese índice tardó 0.46 s y el archivo pasó de 62.6 MB a 74.0 MB.
¿Importa el orden de las columnas en un índice compuesto?
Sí. Pon primero las columnas que comparas con = y al final la columna de rango o de ORDER BY. Para customer_id = ? AND created_at >= ?, un índice en (customer_id, created_at) respondió en 0.010 ms, mientras que (created_at, customer_id) tardó 3.2 ms porque SQLite solo pudo usar la parte del rango.
¿Por qué SQLite no usa mi índice?
Las causas habituales son una función alrededor de la columna (date(created_at), lower(email)), un LIKE que empieza con %, un LIKE sobre un índice normal sensible a mayúsculas, un OR con una columna sin índice o un índice compuesto cuya primera columna no está en el WHERE. En todos estos casos EXPLAIN QUERY PLAN muestra SCAN en lugar de SEARCH.