SQL JOIN, GROUP BY y subconsultas: trampas medidas
Curso de SQL 3 en SQLite 3.51: INNER vs LEFT JOIN, la explosión de filas que triplica totales, HAVING vs WHERE y una subconsulta 100× más lenta sin índice.
Serie: curso de SQL 3/6 (intermedio). Ya sabes escribir consultas sobre una sola tabla (clases 1 y 2) y ahora te piden respuestas que cruzan tablas: "ventas por cliente", "clientes que nunca compraron". Es el típico encargo de la primera semana como analista junior en una startup, o el reporte que un cliente le pide a su freelancer el viernes por la tarde. Al terminar esta clase vas a elegir el JOIN correcto, agrupar y filtrar bien, y detectar los tres errores que hacen que los números de un reporte salgan mal sin que nadie se dé cuenta.
Las consultas de esta clase no fallan: devuelven números creíbles pero equivocados. Un total por cliente que es exactamente el triple de lo real, un conteo de "clientes por ciudad" que coincide con el número de pedidos, un LEFT JOIN que en silencio pierde a los clientes que querías ver. Cada uno viene de un tipo real de bug en reportes, y aquí los reproducimos con un conjunto de datos diminuto que puedes contar a mano. Todo se ejecutó con sqlite3 3.51.0 en una Mac con Apple Silicon (M1 Pro); las salidas están copiadas de la ejecución real.
Los datos de ejemplo: clientes, pedidos y pagos
Tres tablas. Un cliente tiene cero o más pedidos (orders) y cero o más pagos (payments): son relaciones uno a muchos. Dos filas son incómodas a propósito: Dan no tiene pedidos, y el pedido 107 no tiene cliente (customer_id es NULL, una compra como invitado).
CREATE TABLE customers (id INTEGER PRIMARY KEY, name TEXT NOT NULL, city TEXT);
CREATE TABLE orders (
  id INTEGER PRIMARY KEY, customer_id INTEGER REFERENCES customers(id),
  amount INTEGER NOT NULL, ordered_on TEXT NOT NULL
);
CREATE TABLE payments (
  id INTEGER PRIMARY KEY, customer_id INTEGER REFERENCES customers(id),
  paid INTEGER NOT NULL
);
INSERT INTO customers (id, name, city) VALUES
  (1, 'Aoi', 'Osaka'), (2, 'Ben', 'Seoul'), (3, 'Chloe', 'Osaka'), (4, 'Dan', NULL);
INSERT INTO orders (id, customer_id, amount, ordered_on) VALUES
  (101, 1, 3000, '2026-10-01'), (102, 1, 1200, '2026-10-15'),
  (103, 2,  800, '2026-10-20'), (104, 3, 5000, '2026-11-02'),
  (105, 3,  700, '2026-11-03'), (106, 3, 2500, '2026-11-05'),
  (107, NULL, 999, '2026-11-06');
INSERT INTO payments (customer_id, paid) VALUES (1, 2000), (1, 1000), (1, 1200), (3, 8200);
Ejecútalo con sqlite3 shop.db < shop.sql y luego usa .headers on, .mode table y .nullvalue NULL en la shell.
INNER JOIN contra LEFT JOIN
Un JOIN empareja filas de dos tablas usando una condición en ON. JOIN (abreviatura de INNER JOIN) conserva solo los pares que coinciden; LEFT JOIN conserva todas las filas de la tabla izquierda y rellena el lado derecho con NULL cuando no hay coincidencia:
SELECT c.name, o.id AS order_id, o.amount
FROM customers AS c JOIN orders AS o ON o.customer_id = c.id;
+-------+----------+--------+
| name  | order_id | amount |
+-------+----------+--------+
| Aoi   | 101      | 3000   |
| Aoi   | 102      | 1200   |
| Ben   | 103      | 800    |
| Chloe | 104      | 5000   |
| Chloe | 105      | 700    |
| Chloe | 106      | 2500   |
+-------+----------+--------+
Con LEFT JOIN en su lugar obtuvimos 7 filas: las mismas 6 más Dan | NULL | NULL. El pedido 107 no aparece en ninguna de las dos, porque no tiene un cliente con quien emparejarse. RIGHT JOIN y FULL JOIN existen en SQLite desde la versión 3.39.0; FULL JOIN devolvió 8 filas, incluida 107 | 999 | NULL. Eso lo convierte en una forma rápida de encontrar huérfanos en ambos lados.
Hay algo que vale la pena notar en la ejecución del LEFT JOIN: las filas salieron como 102, 101 para Aoi y 105, 106, 104 para Chloe. EXPLAIN QUERY PLAN explica por qué:
QUERY PLAN
|--SCAN c
|--BLOOM FILTER ON o (customer_id=?)
`--SEARCH o USING AUTOMATIC COVERING INDEX (customer_id=?) LEFT-JOIN
SQLite construyó un índice temporal sobre orders.customer_id solo para esta consulta y leyó los pedidos en el orden de ese índice. El inner join, por casualidad, recorrió la tabla en orden de inserción. Ninguno de los dos es una promesa: sin ORDER BY, el orden es el que produzca el plan, y el plan puede cambiar cuando crecen los datos.
GROUP BY, HAVING y los tres COUNT
GROUP BY colapsa las filas que comparten un valor en una fila por grupo; las funciones de agregación (count, sum, avg, min, max) resumen cada grupo. Pedidos por cliente, incluidos los clientes sin pedidos:
SELECT c.name, count(*) AS rows_, count(o.id) AS orders_, coalesce(sum(o.amount), 0) AS total
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
GROUP BY c.id ORDER BY total DESC;
+-------+-------+---------+-------+
| name  | rows_ | orders_ | total |
+-------+-------+---------+-------+
| Chloe | 3     | 3       | 8200  |
| Aoi   | 2     | 2       | 4200  |
| Ben   | 1     | 1       | 800   |
| Dan   | 1     | 0       | 0     |
+-------+-------+---------+-------+
Fíjate en Dan: count(*) dice 1 y count(o.id) dice 0. count(*) cuenta filas, y el LEFT JOIN produjo una fila para él (llena de NULL). count(columna) cuenta valores que no son NULL. Solo sobre la tabla de pedidos: count(*) = 7, count(customer_id) = 6 (el pedido 107 es NULL), count(DISTINCT customer_id) = 3.
WHERE filtra filas antes de agrupar; HAVING filtra grupos después. Dan respuestas distintas:
| Consulta | Resultado |
|---|---|
… GROUP BY c.id HAVING sum(o.amount) >= 1000 |
Chloe 8200, Aoi 4200 (se descarta el grupo de Ben, 800) |
… WHERE o.amount >= 1000 GROUP BY c.id |
Chloe 7500, Aoi 4200 (primero se descartan el pedido de 700 de Chloe y el de 800 de Ben) |
Si pones una función de agregación en WHERE, SQLite se niega:
Parse error near line 16: misuse of aggregate: count()
  ers c JOIN orders o ON o.customer_id = c.id WHERE count(o.id) > 1 GROUP BY c.i
                                      error here ---^
Error común: LEFT JOIN + WHERE se convierte en INNER JOIN sin avisar
Objetivo: todos los clientes con su número de pedidos de noviembre, incluidos los ceros. El primer intento natural:
SELECT c.name, count(o.id) AS nov_orders
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
WHERE o.ordered_on >= '2026-11-01'
GROUP BY c.id ORDER BY c.id;
+-------+------------+
| name  | nov_orders |
+-------+------------+
| Chloe | 3          |
+-------+------------+
Lo que pasa en realidad: el LEFT JOIN sí conservó a Aoi, Ben y Dan, pero WHERE se ejecuta después del join. Para Dan, o.ordered_on es NULL, y NULL >= '2026-11-01' no es verdadero, así que su fila se elimina. Los pedidos de Aoi y Ben son todos de octubre, así que sus filas también se eliminan. Solución: pon la condición en ON, para que decida qué pedidos se adjuntan y no qué clientes sobreviven:
SELECT c.name, count(o.id) AS nov_orders
FROM customers c LEFT JOIN orders o
  ON o.customer_id = c.id AND o.ordered_on >= '2026-11-01'
GROUP BY c.id ORDER BY c.id;
+-------+------------+
| name  | nov_orders |
+-------+------------+
| Aoi   | 0          |
| Ben   | 0          |
| Chloe | 3          |
| Dan   | 0          |
+-------+------------+
Regla: con un LEFT JOIN, las condiciones sobre la tabla de la derecha van en ON; las condiciones sobre la tabla de la izquierda van en WHERE.
Error común: explosión de filas al unir dos tablas uno a muchos
Objetivo: por cliente, el total pedido y el total pagado. Aoi pidió 4,200 y pagó 4,200. La consulta tentadora:
SELECT c.name, sum(o.amount) AS ordered, sum(p.paid) AS paid
FROM customers c
JOIN orders o   ON o.customer_id = c.id
JOIN payments p ON p.customer_id = c.id
GROUP BY c.id;
+-------+---------+-------+
| name  | ordered | paid  |
+-------+---------+-------+
| Aoi   | 12600   | 8400  |
| Chloe | 8200    | 24600 |
+-------+---------+-------+
Los pedidos de Aoi salen triplicados, sus pagos duplicados, el pago de Chloe triplicado, y Ben desapareció porque no tiene pagos. Si quitas el GROUP BY ves por qué. Los 2 pedidos × 3 pagos de Aoi se convirtieron en 6 filas:
+------+----------+--------+------+
| name | order_id | amount | paid |
+------+----------+--------+------+
| Aoi  | 101      | 3000   | 1000 |
| Aoi  | 101      | 3000   | 1200 |
| Aoi  | 101      | 3000   | 2000 |
| Aoi  | 102      | 1200   | 1000 |
| Aoi  | 102      | 1200   | 1200 |
| Aoi  | 102      | 1200   | 2000 |
+------+----------+--------+------+
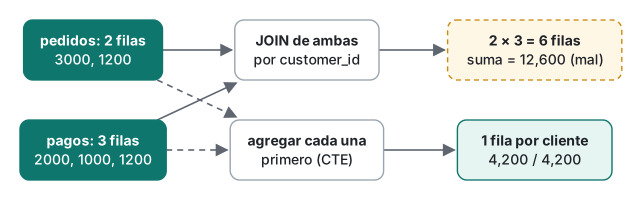
Los pedidos y los pagos no tienen relación entre sí, solo con el cliente, así que el join produce todas las combinaciones. Solución: agrega cada tabla hija por separado y luego une una fila por cliente:
WITH o AS (SELECT customer_id, sum(amount) AS ordered FROM orders GROUP BY customer_id),
     p AS (SELECT customer_id, sum(paid)   AS paid    FROM payments GROUP BY customer_id)
SELECT c.name, o.ordered, p.paid
FROM customers c
LEFT JOIN o ON o.customer_id = c.id
LEFT JOIN p ON p.customer_id = c.id
ORDER BY c.id;
+-------+---------+------+
| name  | ordered | paid |
+-------+---------+------+
| Aoi   | 4200    | 4200 |
| Ben   | 800     | NULL |
| Chloe | 8200    | 8200 |
| Dan   | NULL    | NULL |
+-------+---------+------+
(WITH define una subconsulta con nombre, una CTE; la clase 6 profundiza en esto.) Dos subconsultas escalares, (SELECT sum(amount) FROM orders o WHERE o.customer_id = c.id), dieron exactamente la misma tabla. Una autoverificación rápida para cualquier reporte: compara el count(*) de las filas unidas con lo que esperas. Si es mayor que el número de filas de la tabla más grande, algo explotó.
La misma explosión se esconde en "clientes por ciudad". count(*) sobre customers LEFT JOIN orders dio 5 para Osaka (ese es el número de pedidos); count(DISTINCT c.id) dio el 2 correcto.
Errores y sorpresas silenciosas en GROUP BY
Dos errores que vas a ver en tu primera semana:
Parse error near line 17: ambiguous column name: id
  SELECT id, name FROM customers c JOIN orders o ON o.customer_id = c.id;
         ^--- error here
Las dos tablas tienen un id, así que califícalo: c.id u o.id. Usa siempre alias de tabla en cuanto haya más de una tabla.
El silencioso: SQLite te deja seleccionar una columna que no está agrupada ni agregada (una bare column, columna "suelta"):
SELECT c.name, o.ordered_on, sum(o.amount)
FROM customers c JOIN orders o ON o.customer_id = c.id GROUP BY c.id;
+-------+------------+---------------+
| name  | ordered_on | sum(o.amount) |
+-------+------------+---------------+
| Aoi   | 2026-10-01 | 4200          |
| Ben   | 2026-10-20 | 800           |
| Chloe | 2026-11-02 | 8200          |
+-------+------------+---------------+
¿Cuál de las tres fechas de Chloe es esa? La de la fila que SQLite vio por casualidad; no significa nada. PostgreSQL rechaza esta consulta, y MySQL también con su modo por defecto ONLY_FULL_GROUP_BY (ninguno de los dos se ejecutó aquí), así que un código que funciona en SQLite puede romperse cuando lo migras. Hay una excepción documentada en SQLite: con exactamente un max() o min(), las columnas sueltas vienen de la fila que contiene ese máximo o mínimo. SELECT c.name, o.id, max(o.amount) … GROUP BY c.id devolvió Aoi | 101 | 3000, Ben | 103 | 800, Chloe | 104 | 5000, lo cual es correcto, pero solo funciona en SQLite. El código portable usa una función de ventana (clase 6) o una subconsulta.
Subconsulta, JOIN o EXISTS: cuál usar
Una subconsulta es un SELECT dentro de otra sentencia. Tres preguntas, tres herramientas:
"Clientes con al menos un pedido de 2,500 o más."
SELECT name FROM customers WHERE id IN (SELECT customer_id FROM orders WHERE amount >= 2500);
-- Aoi, Chloe
SELECT c.name FROM customers c JOIN orders o ON o.customer_id = c.id WHERE o.amount >= 2500;
-- Aoi, Chloe, Chloe
El JOIN devolvió a Chloe dos veces (tiene dos pedidos que califican). IN o EXISTS responden "¿hay al menos uno?" sin duplicados; un JOIN responde "lista los pares que coinciden".
"Clientes que nunca hicieron un pedido." Aquí es donde NOT IN muerde, porque el pedido 107 tiene un customer_id NULL:
| Consulta | Filas |
|---|---|
WHERE id NOT IN (SELECT customer_id FROM orders) |
0 |
WHERE NOT EXISTS (SELECT 1 FROM orders o WHERE o.customer_id = c.id) |
Dan |
WHERE id NOT IN (SELECT customer_id FROM orders WHERE customer_id IS NOT NULL) |
Dan |
Es la misma lógica de NULL de la clase 1: 4 NOT IN (1, 2, 3, NULL) es NULL, no verdadero. Prefiere NOT EXISTS; a ese no le importan los NULL.
| Quieres | Usa | Cuidado con |
|---|---|---|
| Columnas de ambas tablas | JOIN |
Duplicados cuando el lado derecho tiene muchas coincidencias |
| Conservar filas sin coincidencia | LEFT JOIN |
Las condiciones de la tabla derecha van en ON |
| "Tiene al menos uno" | EXISTS / IN |
Nada grave; sin duplicados |
| "No tiene ninguno" | NOT EXISTS |
NOT IN devuelve 0 filas si la subconsulta tiene un NULL |
| Totales de dos tablas hijas | Agregar cada una primero (CTE) y luego unir | El join directo multiplica las sumas |
| Un valor por fila | Subconsulta escalar en SELECT |
Necesita un índice en la columna interna (ver abajo) |
Una medición: subconsulta correlacionada contra JOIN, con y sin índice
"Las subconsultas son lentas" es una verdad a medias. Armamos 2,000 clientes y 200,000 pedidos (los ids de cliente se asignaron con una fórmula fija, (i * 7919) % 2000 + 1, sin aleatoriedad) y calculamos el total de pedidos de cada cliente de tres maneras. Verificamos que las tres devolvieran filas idénticas. Tiempos medidos desde el módulo sqlite3 de Python (SQLite 3.51.0) en la M1 Pro: mediana de 3 ejecuciones sin índice y de 7 con índice.
-- A: correlated subquery
SELECT c.id, (SELECT sum(o.amount) FROM orders o WHERE o.customer_id = c.id) FROM customers c ORDER BY c.id;
-- B: LEFT JOIN + GROUP BY
SELECT c.id, sum(o.amount) FROM customers c LEFT JOIN orders o ON o.customer_id = c.id GROUP BY c.id ORDER BY c.id;
-- C: aggregate first, then join
SELECT c.id, t.total FROM customers c
LEFT JOIN (SELECT customer_id, sum(amount) AS total FROM orders GROUP BY customer_id) t
  ON t.customer_id = c.id ORDER BY c.id;
| A: correlacionada | B: JOIN + GROUP BY | C: agregar y luego unir | |
|---|---|---|---|
| Sin índice (ejecución 1) | 13,389.6 ms | 183.5 ms | 117.4 ms |
| Sin índice (ejecución 2) | 12,649.4 ms | 120.7 ms | 42.2 ms |
CREATE INDEX ON orders(customer_id) (ejecución 2) |
88.9 ms | 93.4 ms | 86.1 ms |
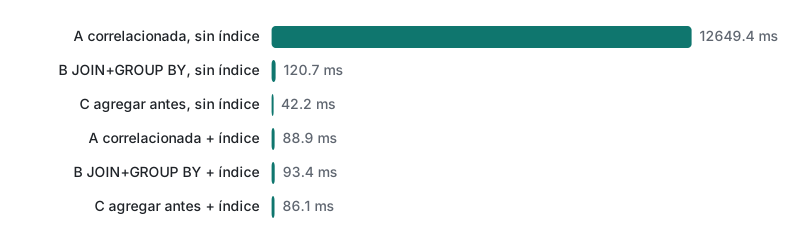
Sin índice, el plan de A fue CORRELATED SCALAR SUBQUERY 1 → SCAN o: una lectura completa de 200,000 pedidos por cada uno de los 2,000 clientes, unas 400 millones de visitas a filas. B y C fueron rápidas incluso sin índice, porque SQLite construyó un AUTOMATIC COVERING INDEX para el join (visible en el plan de arriba), cosa que no hizo para la subconsulta correlacionada. Con un índice real, el plan pasó a ser SEARCH o USING INDEX idx_orders_customer (customer_id=?) y las tres formas quedaron a menos de un 10% entre sí.
Así que la lección no es "nunca uses subconsultas". Es: lee el plan y busca un SCAN dentro de cualquier cosa que se ejecute una vez por fila. Los números pequeños (B y C) variaron hasta 3× entre nuestras dos ejecuciones. La brecha de 100× de A no cambió.
Límites honestos y notas de versión
- Solo se ejecutó en SQLite 3.51.0 (la CLI y el módulo
sqlite3de Python 3.9, ambos 3.51.0). Según las notas de versión de SQLite,RIGHTyFULL OUTER JOINllegaron en la 3.39.0 y las CTE (WITH) en la 3.8.3. El pasoBLOOM FILTERde los planes es una optimización más reciente; solo lo comprobamos en la 3.51. - Los índices automáticos son una función de SQLite (activada por defecto,
PRAGMA automatic_index). MySQL y PostgreSQL usan hash joins u otras estrategias, así que B y C podrían compararse distinto allí (no se ejecutó aquí). - Columnas sueltas: PostgreSQL da error, MySQL da error con
ONLY_FULL_GROUP_BY(por defecto desde la 5.7), SQLite las acepta (solo se ejecutó SQLite). - Los tiempos vienen de una sola laptop con todos los datos en caché. El costo de la subconsulta correlacionada crece con clientes × pedidos, así que con 10× más datos espera unas 100× más de tiempo sin índice.
Ejercicios
- Lista los clientes de Osaka cuyo total pedido sea de 5,000 o más.
- Para cada ciudad, muestra el número de clientes y el número de pedidos en una sola consulta. (Cuidado: uno de los conteos obvios está mal.)
Respuestas
1.
SELECT c.name, sum(o.amount) AS total
FROM customers c JOIN orders o ON o.customer_id = c.id
WHERE c.city = 'Osaka'
GROUP BY c.id HAVING total >= 5000;
Salida real: Chloe | 8200. La prueba de la ciudad es una condición de fila (WHERE); el total es una condición de grupo (HAVING). SQLite permite el alias total en HAVING; PostgreSQL no (escribe sum(o.amount); no se ejecutó aquí).
2.
SELECT c.city, count(DISTINCT c.id) AS customers, count(o.id) AS orders
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
GROUP BY c.city ORDER BY c.city;
Salida: NULL | 1 | 0, Osaka | 2 | 5, Seoul | 1 | 1. Con count(*) en lugar de count(DISTINCT c.id), Osaka mostraba 5 clientes: el join generó una fila por pedido. El pedido 107 (sin cliente) no está en ninguna ciudad, por diseño del LEFT JOIN desde customers.
Siguiente clase
La clase 4 trata sobre velocidad: EXPLAIN QUERY PLAN a fondo, una tabla de un millón de filas medida con y sin índices, el orden de las columnas en un índice compuesto y los casos en que un índice que creaste se ignora.
Preguntas frecuentes
¿Por qué mis totales con SUM salen duplicados o triplicados al agregar un JOIN?
Uniste dos tablas uno a muchos (por ejemplo pedidos y pagos) al mismo padre. Cada fila de pedido se empareja con cada fila de pago, así que cada monto se cuenta una vez por pago. En nuestra prueba, una clienta con 2 pedidos y 3 pagos salió con 12,600 pedidos en lugar de 4,200. Agrega primero cada tabla por separado (subconsulta o CTE) y luego une los totales.
¿Por qué mi LEFT JOIN se comporta como un INNER JOIN?
Una condición sobre la tabla de la derecha en el WHERE elimina las filas donde esa tabla es NULL, que son justo las filas que agregó el LEFT JOIN. Mueve la condición a la cláusula ON. Nuestra consulta de pedidos de noviembre devolvió 1 cliente con la condición en WHERE y los 4 (tres con 0) con la condición en ON.
¿Una subconsulta es más lenta que un JOIN?
No por sí misma. Una subconsulta correlacionada sin índice en la columna interna tardó 12.6 segundos con 2,000 clientes y 200,000 pedidos, mientras que LEFT JOIN + GROUP BY tardó 121 ms. Con un índice en orders(customer_id), las tres formas tardaron entre 86 y 93 ms. Busca SCAN dentro de un CORRELATED SUBQUERY en EXPLAIN QUERY PLAN.