Funciones de ventana SQL y CTE para reportes reales
ROW_NUMBER, RANK, LAG, totales acumulados, top N por grupo, CTE recursivas y JSON en SQLite: la trampa del frame, un NULL que sale 0.0% y velocidad medida.
Serie: curso de SQL 6/6 (avanzado). Para quienes escriben JOIN y GROUP BY con soltura pero todavía exportan los datos a una hoja de cálculo para sacar rankings, variaciones mes a mes o totales acumulados. Al terminar esta clase vas a hacer todo eso en una sola consulta SQL, recorrer un árbol con una CTE recursiva, sacar valores de columnas JSON y evitar las tres trampas que hacen que esos reportes salgan mal sin avisar.
Las consultas de reportes son donde SQL más rinde y donde las respuestas equivocadas menos se notan: un total acumulado un poco desviado o una columna de variación mensual que muestra 0.0% en lugar de "sin datos" se ven perfectamente creíbles en un dashboard. Si armas paneles de administración, correos de KPI para tu jefe o exportaciones para el equipo de analítica, este artículo es para ti. Cada consulta de abajo se ejecutó, cada salida está copiada tal como se imprimió, y una de las trampas solo la notamos porque la salida se veía demasiado ordenada.
Entorno: CLI de SQLite 3.51.0 (modo de salida -header -column), más el módulo sqlite3 de Python 3.9.6 (con SQLite incluido, también 3.51.0) para los tiempos, Mac con Apple Silicon (M1 Pro), macOS.
Los datos y las funciones de ventana en un minuto
Ventas diarias de tres tiendas en octubre. Los días sin ventas simplemente no aparecen, y eso importa más adelante. Guárdalo como shop.sql:
CREATE TABLE sales (
  id      INTEGER PRIMARY KEY,
  shop    TEXT    NOT NULL,
  day     TEXT    NOT NULL,      -- 'YYYY-MM-DD'
  amount  INTEGER NOT NULL
);
INSERT INTO sales (shop, day, amount) VALUES
 ('Shibuya','2026-10-01',120),('Shibuya','2026-10-02', 80),('Shibuya','2026-10-04',150),
 ('Shibuya','2026-10-05',150),('Shibuya','2026-10-06', 90),
 ('Umeda',  '2026-10-01',200),('Umeda',  '2026-10-02',200),('Umeda',  '2026-10-03', 60),
 ('Umeda',  '2026-10-05',110),
 ('Tenjin', '2026-10-02', 70),('Tenjin', '2026-10-03', 95);
Una función de ventana (window function) calcula un valor a partir de un conjunto de filas relacionadas con la fila actual (su ventana), pero, a diferencia de GROUP BY, conserva todas las filas. PARTITION BY divide las filas en grupos y ORDER BY las ordena dentro de cada grupo. Las tres funciones de ranking solo se diferencian en los empates:
SELECT shop, day, amount,
       ROW_NUMBER() OVER w AS row_number,
       RANK()       OVER w AS rank,
       DENSE_RANK() OVER w AS dense_rank
FROM sales
WINDOW w AS (PARTITION BY shop ORDER BY amount DESC)
ORDER BY shop, row_number;
shop     day         amount  row_number  rank  dense_rank
-------  ----------  ------  ----------  ----  ----------
Shibuya  2026-10-04  150     1           1     1
Shibuya  2026-10-05  150     2           1     1
Shibuya  2026-10-01  120     3           3     2
Shibuya  2026-10-06  90      4           4     3
Shibuya  2026-10-02  80      5           5     4
Tenjin   2026-10-03  95      1           1     1
Tenjin   2026-10-02  70      2           2     2
Umeda    2026-10-01  200     1           1     1
Umeda    2026-10-02  200     2           1     1
Umeda    2026-10-05  110     3           3     2
Umeda    2026-10-03  60      4           4     3
ROW_NUMBER siempre cuenta 1, 2, 3; RANK les da el mismo número a los empates y luego salta (1, 1, 3); DENSE_RANK no salta (1, 1, 2). Fíjate en que esta consulta no define cuál de las dos filas con 150 recibe el número 1; agrega un desempate como , day cuando importe.
Los N primeros de cada grupo
"Los dos mejores días de cada tienda" es la pregunta clásica. El intento obvio falla:
sqlite> SELECT shop, day, amount FROM sales WHERE ROW_NUMBER() OVER (PARTITION BY shop ORDER BY amount DESC) <= 2;
Parse error near line 13: misuse of window function ROW_NUMBER()
  SELECT shop, day, amount FROM sales WHERE ROW_NUMBER() OVER (PARTITION BY shop
                              error here ---^
Las funciones de ventana se calculan después del WHERE, así que no se pueden usar dentro de él. Calcúlalas en una CTE (common table expression: una subconsulta con nombre que se introduce con WITH) y filtra afuera:
WITH ranked AS (
  SELECT shop, day, amount,
         ROW_NUMBER() OVER (PARTITION BY shop ORDER BY amount DESC, day) AS rn,
         RANK()       OVER (PARTITION BY shop ORDER BY amount DESC)      AS rnk
  FROM sales
)
SELECT shop, day, amount, rn, rnk FROM ranked WHERE rn <= 2 ORDER BY shop, rn;
shop     day         amount  rn  rnk
-------  ----------  ------  --  ---
Shibuya  2026-10-04  150     1   1
Shibuya  2026-10-05  150     2   1
Tenjin   2026-10-03  95      1   1
Tenjin   2026-10-02  70      2   2
Umeda    2026-10-01  200     1   1
Umeda    2026-10-02  200     2   1
Filtra por rn para obtener "exactamente N filas" y por rnk para "N, más quien empate con el último".
Error común: el total acumulado que salta
El error. Un total acumulado de toda la empresa por día, escrito de la forma natural: SUM(amount) OVER (ORDER BY day).
Lo que pasa en realidad. Todas las filas del mismo día muestran el mismo número, que ya incluye las filas de abajo:
SELECT day, shop, amount,
       SUM(amount) OVER (ORDER BY day)                     AS default_frame,
       SUM(amount) OVER (ORDER BY day, id
                         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS rows_frame
FROM sales ORDER BY day, id;
day         shop     amount  default_frame  rows_frame
----------  -------  ------  -------------  ----------
2026-10-01  Shibuya  120     320            120
2026-10-01  Umeda    200     320            320
2026-10-02  Shibuya  80      670            400
2026-10-02  Umeda    200     670            600
2026-10-02  Tenjin   70      670            670
2026-10-03  Umeda    60      825            730
2026-10-03  Tenjin   95      825            825
2026-10-04  Shibuya  150     975            975
2026-10-05  Shibuya  150     1235           1125
2026-10-05  Umeda    110     1235           1235
2026-10-06  Shibuya  90      1325           1325
El frame (marco) es la parte de la ventana que mira una función de agregación. Con ORDER BY y sin cláusula de frame, el valor por defecto es RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, y RANGE incluye a todos los peers, las filas con un valor de ORDER BY igual. La solución: un desempate único más ROWS, como en la columna rows_frame. Las dos columnas terminan en 1,325, así que revisar el total final no detecta el problema; solo están mal las filas del medio.
LAG, días faltantes y un calendario con una CTE recursiva
LAG(x) devuelve x de la fila anterior de la ventana (LEAD, de la siguiente). Variación diaria de Shibuya:
shop     day         amount  prev_amount  prev_day    diff
-------  ----------  ------  -----------  ----------  ----
Shibuya  2026-10-01  120
Shibuya  2026-10-02  80      120          2026-10-01  -40
Shibuya  2026-10-04  150     80           2026-10-02  70
Shibuya  2026-10-05  150     150          2026-10-04  0
Shibuya  2026-10-06  90      150          2026-10-05  -60
La fila del 10-04 se compara con el 10-02: "fila anterior" no es lo mismo que "día anterior". La solución es generar todos los días con una CTE recursiva, una CTE que se refiere a sí misma. Tiene una fila inicial, luego UNION ALL y un paso que se ejecuta sobre el resultado anterior hasta que el WHERE lo detiene:
WITH RECURSIVE cal(day) AS (
  SELECT '2026-10-01'
  UNION ALL
  SELECT date(day, '+1 day') FROM cal WHERE day < '2026-10-06'
),
daily AS (
  SELECT cal.day, COALESCE(s.amount, 0) AS amount
  FROM cal LEFT JOIN sales s ON s.day = cal.day AND s.shop = 'Shibuya'
)
SELECT day, amount,
       LAG(amount) OVER (ORDER BY day) AS prev_day_amount,
       ROUND(AVG(amount) OVER (ORDER BY day ROWS BETWEEN 2 PRECEDING AND CURRENT ROW), 1) AS avg_3d
FROM daily;
day         amount  prev_day_amount  avg_3d
----------  ------  ---------------  ------
2026-10-01  120                      120.0
2026-10-02  80      120              100.0
2026-10-03  0       80               66.7
2026-10-04  150     0                76.7
2026-10-05  150     150              100.0
2026-10-06  90      150              130.0
Ahora el 10-03 existe con 0, y el promedio móvil de 3 días es un promedio real de 3 días (las dos primeras filas promedian menos días; decide si tu reporte debe mostrarlas).
CTE recursivas para árboles, y la consulta que nunca termina
Un árbol de categorías guardado con parent_id es el otro uso cotidiano:
CREATE TABLE categories (id INTEGER PRIMARY KEY, parent_id INTEGER, name TEXT NOT NULL);
INSERT INTO categories VALUES
 (1, NULL, 'Electronics'), (2, 1, 'Computers'), (3, 2, 'Laptops'), (4, 2, 'Desktops'),
 (5, 1, 'Audio'), (6, 5, 'Headphones'), (7, NULL, 'Books'), (8, 7, 'Programming');
WITH RECURSIVE tree(id, name, depth, path) AS (
  SELECT id, name, 0, name FROM categories WHERE parent_id IS NULL
  UNION ALL
  SELECT c.id, c.name, t.depth + 1, t.path || ' > ' || c.name
  FROM categories c JOIN tree t ON c.parent_id = t.id
)
SELECT substr('        ', 1, depth * 2) || name AS indented, depth, path FROM tree ORDER BY path;
indented        depth  path
--------------  -----  ----------------------------------
Books           0      Books
  Programming   1      Books > Programming
Electronics     0      Electronics
  Audio         1      Electronics > Audio
    Headphones  2      Electronics > Audio > Headphones
  Computers     1      Electronics > Computers
    Desktops    2      Electronics > Computers > Desktops
    Laptops     2      Electronics > Computers > Laptops
Entonces alguien pone por error a "Laptops" como padre de "Electronics" (UPDATE categories SET parent_id = 3 WHERE id = 1) y crea un ciclo 1 → 2 → 3 → 1. La misma recursión, empezando desde Computers, nunca termina. La dejamos correr 5 segundos y la matamos:
  PID STAT      TIME    RSS COMMAND
37366 RN     0:04.95   2896 sqlite3 :memory:
exit=143
Usó un núcleo de CPU completo y casi nada de memoria, así que nada te avisa, salvo una petición que nunca responde. El código de salida 143 es 128 + 15 (SIGTERM). Tres protecciones, todas ejecutadas:
-- 1. LIMIT outside (for testing): returned 100000 rows, max depth 50000, in 0.040 s
-- 2. depth limit in the recursive step: UNION + WHERE t.depth < 20  -> 40 rows, max depth 20
-- 3. remember the path, skip ids already on it:
WITH RECURSIVE tree(id, path) AS (
  SELECT 2, '/2/'
  UNION ALL
  SELECT c.id, t.path || c.id || '/' FROM categories c JOIN tree t ON c.parent_id = t.id
  WHERE instr(t.path, '/' || c.id || '/') = 0
)
SELECT id, path FROM tree;
id  path
--  -----------
2   /2/
3   /2/3/
4   /2/4/
1   /2/3/1/
5   /2/3/1/5/
6   /2/3/1/5/6/
(En español: 1. LIMIT afuera, para pruebas; 2. límite de profundidad en el paso recursivo; 3. guardar la ruta y saltar los ids que ya están en ella.) La protección 3 es la que conviene dejar en producción: devuelve cada nodo una sola vez y hace visible el ciclo en la ruta.
Columnas JSON en reportes
Los pedidos muchas veces llegan como JSON desde una API. SQLite puede leerlos directamente: -> devuelve JSON, ->> devuelve un valor SQL y json_each convierte un arreglo en filas:
CREATE TABLE orders (id INTEGER PRIMARY KEY, shop TEXT, payload TEXT);
INSERT INTO orders VALUES
 (1, 'Shibuya', '{"customer":"c-01","items":[{"sku":"A1","qty":2,"price":300},{"sku":"B7","qty":1,"price":1200}],"coupon":null}'),
 (2, 'Umeda',   '{"customer":"c-02","items":[{"sku":"A1","qty":1,"price":300}],"coupon":"OCT10"}'),
 (3, 'Shibuya', '{"customer":"c-01","items":[{"sku":"C3","qty":3,"price":450}]}');
SELECT id, payload ->> '$.customer' AS customer, payload -> '$.coupon' AS coupon_json,
       payload ->> '$.coupon' AS coupon_sql, json_array_length(payload, '$.items') AS n_items
FROM orders;
SELECT i.value ->> 'sku' AS sku, SUM((i.value ->> 'qty') * (i.value ->> 'price')) AS revenue,
       json_group_array(DISTINCT o.shop) AS shops
FROM orders o, json_each(o.payload, '$.items') AS i GROUP BY sku ORDER BY revenue DESC;
id  customer  coupon_json  coupon_sql  n_items
--  --------  -----------  ----------  -------
1   c-01      null                     2
2   c-02      "OCT10"      OCT10       1
3   c-01                               1
sku  revenue  shops
---  -------  -------------------
C3   1350     ["Shibuya"]
B7   1200     ["Shibuya"]
A1   900      ["Shibuya","Umeda"]
La fila 1 frente a la fila 3 es un punto sutil: un null de JSON da el texto null con -> pero NULL de SQL con ->>, y una clave que no existe da NULL de SQL con ambos.
Mensajes de error que vas a ver:
sqlite> SELECT json_extract('{"a": 1,', '$.a');
Runtime error near line 2: malformed JSON
sqlite> SELECT json_extract('{"a": 1}', 'a');
Runtime error near line 3: bad JSON path: 'a'
Y uno que no da error: {"customer": "c-03", items: []} (clave sin comillas) no es JSON válido, y sin embargo json_extract(payload, '$.customer') devolvió c-03, porque SQLite también lee JSON5. json_valid(payload) devolvió 0 para esa fila. Si el contrato de una API dice "JSON válido", verifícalo con json_valid, no viendo si la extracción funciona.
Un reporte mensual sobre 1,000,000 de filas, y un NULL que se volvió 0.0%
Usando la tabla orders de 1,000,000 de filas de la clase 4: ingresos pagados por mes, variación contra el mes anterior, acumulado del año y participación en el año, en una sola consulta. Las funciones de ventana se ejecutan después de GROUP BY, así que pueden trabajar sobre agregados:
WITH monthly AS (
  SELECT substr(created_at, 1, 7) AS month, count(*) AS orders, sum(amount) AS revenue
  FROM orders WHERE status = 'paid' GROUP BY month
)
SELECT month, orders, revenue,
       revenue - LAG(revenue) OVER (ORDER BY month)                          AS diff,
       printf('%.1f%%', 100.0 * revenue / LAG(revenue) OVER (ORDER BY month) - 100) AS mom,
       sum(revenue) OVER (ORDER BY month)                                    AS ytd,
       printf('%.1f%%', 100.0 * revenue / sum(revenue) OVER ())              AS share
FROM monthly ORDER BY month;
month    orders  revenue    diff       mom     ytd         share
-------  ------  ---------  ---------  ------  ----------  -----
2025-01  73160   737992278             0.0%    737992278   8.6%
2025-02  65317   659562716  -78429562  -10.6%  1397554994  7.7%
2025-03  72047   728849528  69286812   10.5%   2126404522  8.5%
…
2025-12  72379   730238892  30203404   4.3%    8584287069  8.5%
Run Time: real 0.422 user 0.346108 sys 0.058657
Mira el mom (variación mensual) de enero: 0.0%. No hay mes anterior, diff está correctamente vacío, pero printf convierte NULL en 0. Quien lea el reporte concluiría que enero estuvo plano. printf('%.1f%%', NULL) devuelve 0.0%, mientras que round(NULL, 1) || '%' sigue siendo NULL. Formatea los números en la aplicación, o mantén visible el NULL con CASE WHEN … IS NULL.
Medido: función de ventana contra subconsulta correlacionada
Antes de las funciones de ventana (SQLite 3.25), el top N por grupo se escribía con una subconsulta correlacionada: para cada fila, contar cuántas filas del mismo grupo la superan. Comparamos ambas sobre los primeros 5,000 clientes de la tabla de la clase 4 (100,212 filas), con resultados idénticos (lo verificamos comparando los conjuntos de resultados). Medianas de 5 ejecuciones, salvo la consulta correlacionada sin índice, que se ejecutó una vez:
| Consulta | Sin índice | Con índice |
|---|---|---|
Top 3 por cliente, ROW_NUMBER |
79.9 ms | 48.5 ms |
Top 3 por cliente, count(*) correlacionado |
350,554 ms (5.8 min) | 125.6 ms |
Total acumulado por cliente, SUM() OVER |
127.5 ms | 87.6 ms |
Total acumulado por cliente, SUM correlacionado |
no se ejecutó | 253.8 ms |
Índices: (customer_id, amount DESC, id) para el top N y (customer_id, created_at, id, amount) para los totales acumulados.
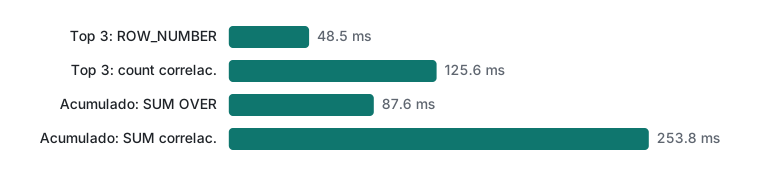
La función de ventana lee los datos una vez y los ordena; la subconsulta correlacionada ejecuta una consulta interna por fila. Con índice, esa consulta interna es un SEARCH corto, así que la diferencia es de 2.6× y 2.9×. Sin índice, cada consulta interna es un recorrido completo de 100,212 filas, unas 10 mil millones de visitas a filas, y la diferencia supera las 4,000×. La versión con ventana ni siquiera necesitó el índice.
Qué herramienta usar para cada pregunta de un reporte
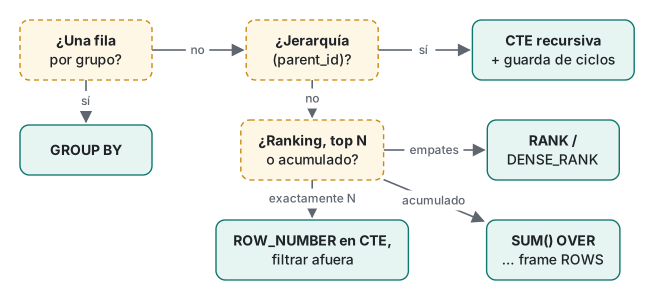
| Pregunta | Herramienta |
|---|---|
| Una fila por grupo (total por tienda) | GROUP BY |
| Cada fila más un valor del grupo (participación en el total de la tienda) | SUM(x) OVER (PARTITION BY g) |
| Ranking donde los empates comparten lugar | RANK / DENSE_RANK |
| Exactamente N por grupo | ROW_NUMBER en una CTE, filtrar afuera |
| Variación contra la fila anterior | LAG / LEAD |
| Variación contra el día anterior cuando faltan días | calendario con CTE recursiva + LEFT JOIN, luego LAG |
| Total acumulado | SUM() OVER (ORDER BY … desempate único ROWS …) |
| Conteo condicional en una pasada | count(*) FILTER (WHERE …) |
| Jerarquías (categorías, organigrama, comentarios) | CTE recursiva con protección por ruta o profundidad |
| Valores dentro de JSON | ->>, json_each, json_group_array |
FILTER en acción, para completar: count(*) FILTER (WHERE amount >= 100) devolvió 3, 0 y 3 días grandes para Shibuya, Tenjin y Umeda.
Ejercicios
- Para cada tienda, encuentra el día registrado con el mayor aumento respecto del día registrado anterior.
- Genera el primer día de cada mes de 2026 con una CTE recursiva. ¿Por qué no deberías empezar desde
'2026-01-31'y sumar'+1 month'para obtener "fines de mes"?
Respuestas
- Calcula la diferencia con
LAGy luego elige la primera fila de cada tienda conROW_NUMBER:
WITH d AS (
  SELECT shop, day, amount - LAG(amount) OVER (PARTITION BY shop ORDER BY day) AS diff
  FROM sales
), r AS (
  SELECT shop, day, diff, ROW_NUMBER() OVER (PARTITION BY shop ORDER BY diff DESC) AS rn
  FROM d WHERE diff IS NOT NULL
)
SELECT shop, day, diff FROM r WHERE rn = 1 ORDER BY shop;
shop     day         diff
-------  ----------  ----
Shibuya  2026-10-04  70
Tenjin   2026-10-03  25
Umeda    2026-10-05  50
El filtro diff IS NOT NULL importa: en SQLite, NULL va primero en orden ascendente y al final en orden descendente, así que aquí no ganaría, pero en una consulta ascendente de "la mayor caída" sí.
WITH RECURSIVE m(d) AS (SELECT '2026-01-01' UNION ALL SELECT date(d, '+1 month') FROM m WHERE d < '2026-12-01') SELECT count(*), min(d), max(d) FROM m;devolvió12|2026-01-01|2026-12-01. Empezar desde el día 31 falla:date('2026-01-31', '+1 month')devolvió2026-03-03, porque el 31 de febrero se desborda. Para fines de mes usadate(d, 'start of month', '+1 month', '-1 day').
Límites honestos y notas de versión
- Todo se ejecutó solo en SQLite 3.51.0. Las funciones de ventana llegaron en SQLite 3.25.0, las opciones de frame como
GROUPSyEXCLUDEen la 3.28.0,FILTERen agregados comunes en la 3.30.0, las CTE recursivas en la 3.8.3, los operadores->y->>en la 3.38.0 y la lectura de JSON5 en la 3.42.0. Un SQLite viejo, como el de versiones antiguas de Android o servidores sin actualizar, va a rechazar partes de este artículo. - La consulta correlacionada sin índice se ejecutó una vez (5.8 minutos); su mediana de 5 no valía otra media hora. "No se ejecutó" en la tabla significa que no la ejecutamos para nada.
- PostgreSQL y MySQL 8 soportan las mismas funciones de ventana y CTE recursivas, pero MySQL limita la profundidad de recursión con
cte_max_recursion_depth(1000 por defecto) y PostgreSQL usa sus propios operadores JSON con una semántica distinta (no se ejecutó aquí). - La tabla de ventas es diminuta a propósito; la tabla de tiempos usa datos sintéticos con montos repetidos. Tus proporciones van a variar según la forma de tus datos.
Esta es la última clase de SQL. Siguientes pasos: la ruta de estudio de programación para ver qué aprender junto con SQL, o PDO + SQLite e inyección SQL (en inglés) para poner estas consultas de forma segura detrás de una página web.
Anterior: Clase 5: transacciones, aislamiento y bloqueos · Volver al inicio: Clase 1: SELECT, WHERE y ORDER BY
Preguntas frecuentes
¿Cómo obtengo los N primeros registros por grupo en SQL?
Numera las filas dentro de cada grupo con ROW_NUMBER() OVER (PARTITION BY grupo ORDER BY valor DESC) en una CTE y luego filtra rn <= N en la consulta externa. No puedes filtrar una función de ventana directamente en el WHERE; SQLite responde con 'misuse of window function ROW_NUMBER()'. Con 100,212 filas la versión con ventana tardó 48.5 ms, una subconsulta correlacionada 125.6 ms con índice y 350.6 segundos sin índice.
¿Por qué mi total acumulado salta en las filas con la misma fecha?
Con ORDER BY y sin cláusula de frame, el frame por defecto es RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, que incluye todas las filas con el mismo valor de ORDER BY (sus pares o peers). Por eso todas las filas del mismo día muestran el total final del día. Agrega un desempate único y ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW.
¿Cómo evito que una CTE recursiva se ejecute para siempre?
Un ciclo en los datos (una categoría que es su propio ancestro) hace que la recursión con UNION ALL no termine nunca; nuestro ejemplo seguía corriendo después de 5 segundos y tuvimos que matarlo. Agrega un límite de profundidad en el WHERE recursivo, guarda una ruta y salta los ids que ya están en ella, o usa LIMIT mientras pruebas.