ナイーブベイズを標準ライブラリだけで実装し、ブログ86記事を分類した
Python標準ライブラリだけで多項ナイーブベイズを約70行で実装し、自分のブログ86記事の本文からカテゴリを当てた。LOO正解率84.9%、平滑化なしで全記事が確率0になる様子、float のアンダーフロー、日本語の文字バイグラム比較まで実測。
日本語のテキスト分類を試そうとすると、まず「MeCab を入れて、辞書を入れて…」という準備でつまずきがちです。この記事は、その手前の段階、つまり依存ライブラリなしでどこまで分類できるかを知りたい人向けに、Python 標準ライブラリだけで多項ナイーブベイズを約70行で実装し、このブログ自身の記事86本でカテゴリを当てた記録です。結果は leave-one-out で正解率84.9%(多数派クラスを答えるだけなら43.0%)、日本語版の記事では文字バイグラムで81.4%でした。
数字よりも役に立つのは、どこで0点になったかと、その原因が「the」という1単語だったことです。
この記事はシリーズ「標準ライブラリだけで作る機械学習」の第3回です。第1回は線形回帰と勾配降下法、第2回はk-means クラスタリング。次回はパーセプトロンから小さなニューラルネットへ、最終回は同じ記事群で作る TF-IDF と BM25 の検索エンジンです。
実行環境はすべて Python 3.9 標準ライブラリ、Apple Silicon Mac(M1 Pro)。numpy も scikit-learn も使っていません。非推奨 API は避けているので、3.12 以降でもそのまま動きます。
データ:自分のブログ記事86本、偏った9カテゴリ
このブログは、YAML フロントマター付きの Markdown から生成しています(仕組みは多言語ブログ用の静的サイトジェネレーターを参照)。各ファイルの category: が正解ラベルです。入力は本文だけで、タイトル・説明文・FAQ は使いません。slug から答えを読まれないようにするためです。
執筆時点の content/en/*.md(英語版)を固定したスナップショットで、記事数は86本でした。
| カテゴリ | 記事数 | カテゴリ | 記事数 |
|---|---|---|---|
| csharp | 37 | app-ops | 4 |
| algorithm | 15 | web | 4 |
| regex | 9 | ai | 2 |
| server | 7 | flutter | 2 |
| winapi | 6 | 合計 | 86 |
かなり意地の悪い形です。全部「csharp」と答えるだけで43.0%取れます。4カテゴリは2〜4本しかありません。しかもこの記事と同じ日に公開する兄弟記事は ai に入るので、後で同じコードを走らせると件数は変わります。
86本を 70/30 に分けるとテストは26本で、2本しかないカテゴリはテストに1本入るかどうかです。そこで主な評価は leave-one-out(LOO)、つまり85本で学習して残り1本を当てる、を86回繰り返す方法にしました。確認用に、シード0〜9で層化 70/30 分割も回しています(結果は後述)。
分類器の全体:約70行
多項ナイーブベイズは、文書 d のクラス c に対するスコアを
log P(c) + Σ count(w, d) · log P(w | c)
で計算し、最大のクラスを選びます。P(c) はそのクラスの記事の割合、P(w | c) はクラス c の全単語のうち単語 w が占める割合で、全単語に疑似カウント alpha を足します(ラプラス平滑化)。「ナイーブ」とは、クラスが決まれば単語どうしは独立だと仮定することです。実際には独立ではありませんが、順位はたいてい合っています。
次のコードを nb.py として保存します。
"""Multinomial naive Bayes: predict a blog post's category from its body.
Python standard library only. Usage: python nb.py content/en [--keep-code]
"""
import math, re, sys, time
from collections import Counter, defaultdict
from pathlib import Path

FENCE = re.compile(r"^```.*?^```", re.S | re.M)
WORD = re.compile(r"[a-z][a-z0-9_]*[#+]*")

def load(folder):
    docs = []
    for p in sorted(Path(folder).glob("*.md")):
        _, front, body = p.read_text(encoding="utf-8").split("---", 2)
        cat = re.search(r"^category:\s*(\S+)", front, re.M).group(1)
        docs.append((p.stem, cat, body))
    return docs

def tokenize(body, keep_code=False):
    if not keep_code:
        body = FENCE.sub(" ", body)
    body = re.sub(r"https?://\S+|\[\[fig:[^\]]*\]\]", " ", body)
    return WORD.findall(body.lower())

class NaiveBayes:
    def __init__(self, alpha=1.0):
        self.alpha = alpha

    def fit(self, X, y):                      # X: list of Counter, y: labels
        self.n_docs = Counter(y)
        self.words = defaultdict(Counter)     # class -> word counts
        for counts, c in zip(X, y):
            self.words[c].update(counts)
        self.vocab = set().union(*X)
        self.total = {c: sum(w.values()) for c, w in self.words.items()}
        return self

    def log_scores(self, counts):
        N, V, a = sum(self.n_docs.values()), len(self.vocab), self.alpha
        out = {}
        for c in self.n_docs:
            s = math.log(self.n_docs[c] / N)
            denom = self.total[c] + a * V
            for w, k in counts.items():
                if w not in self.vocab:
                    continue                  # unseen in training: skip
                num = self.words[c][w] + a
                if num == 0:                  # only possible when alpha == 0
                    s = -math.inf
                    break
                s += k * math.log(num / denom)
            out[c] = s
        return out

    def predict(self, counts):
        sc = self.log_scores(counts)
        return max(sc, key=sc.get)

def leave_one_out(X, y, alpha=1.0):
    preds, dead = [], 0
    for i in range(len(X)):
        m = NaiveBayes(alpha).fit(X[:i] + X[i+1:], y[:i] + y[i+1:])
        sc = m.log_scores(X[i])
        if all(v == -math.inf for v in sc.values()):
            dead += 1                         # every class has probability 0
        preds.append(max(sc, key=sc.get))
    return preds, dead

if __name__ == "__main__":
    folder, keep = sys.argv[1], "--keep-code" in sys.argv
    docs = load(folder)
    y = [c for _, c, _ in docs]
    X = [Counter(tokenize(b, keep)) for _, _, b in docs]
    print("docs", len(docs), dict(Counter(y).most_common()))
    t = time.perf_counter()
    preds, dead = leave_one_out(X, y)
    el = time.perf_counter() - t
    acc = sum(p == t_ for p, t_ in zip(preds, y)) / len(y)
    print(f"LOO accuracy {acc:.3f} ({sum(p == t_ for p, t_ in zip(preds, y))}/{len(y)})"
          f"  {el:.2f}s for {len(y)} fits")
$ python3 nb.py content/en
docs 86 {'csharp': 37, 'algorithm': 15, 'regex': 9, 'server': 7, 'winapi': 6, 'app-ops': 4, 'web': 4, 'ai': 2, 'flutter': 2}
LOO accuracy 0.849 (73/86)  0.74s for 86 fits
語彙は学習側の記事だけから作り、学習に出てこない単語は読み飛ばします。読み飛ばしはどのクラスにも同じように効くので、順位は変わりません。
トークン化:コードブロックを消すか残すか
技術ブログは半分が文章、半分がコードです。トークナイザーは小文字化し、c# や c++ を1トークンとして残し([#+]* の部分)、URL と図のマーカーを消します。迷ったのはコードフェンスです。using System; は C# の強い手がかりですが、i、x、printf のようにどのカテゴリにも出るノイズも増えます。
| 設定 | トークン数 | 語彙数 | LOO 正解率 |
|---|---|---|---|
| コードブロックを除去 | 107,381 | 6,174 | 73/86 = 84.9% |
| コードブロックを残す | 137,271 | 7,378 | 73/86 = 84.9% |
正解率は同じですが、間違え方は違いました。コードを残すと winapi-getcurrentdirectory-getmodulefilename(csharp と誤判定されていた)が直り、代わりに server の記事 litespeed-htaccess-rewrite-non-ascii-urls が差75.6で web になりました。リライトルールのコードから html、index、htaccess といったトークンが増え、これが web カテゴリの WordPress 移行記事にも出てくるためです。結果は相殺なので、以降は説明しやすい「コード除去」で進めます。カテゴリごとにプログラミング言語がはっきり分かれているブログなら、残したほうが勝つはずです。
ラプラス平滑化なし:全記事が確率0になる
alpha=0 にすると、そのクラスが一度も使っていない単語の P(w | c) は0です。そういう単語が1つあるだけで積全体が0、対数では -inf です。同じ leave_one_out で alpha を変えて回しました。
for a in (0, 1e-6, 0.01, 0.1, 0.5, 1, 2, 5):
    preds, dead = leave_one_out(X, y, a)
    ok = sum(p == t for p, t in zip(preds, y))
    print(f"  alpha={a:<6} acc={ok}/{len(y)}={ok/len(y):.3f} all-classes-zero={dead}")
  alpha=0      acc=3/86=0.035 all-classes-zero=86
  alpha=1e-06  acc=70/86=0.814 all-classes-zero=0
  alpha=0.01   acc=73/86=0.849 all-classes-zero=0
  alpha=0.1    acc=74/86=0.860 all-classes-zero=0
  alpha=0.5    acc=73/86=0.849 all-classes-zero=0
  alpha=1      acc=73/86=0.849 all-classes-zero=0
  alpha=2      acc=65/86=0.756 all-classes-zero=0
  alpha=5      acc=54/86=0.628 all-classes-zero=0
「一部の記事で」ではありません。86本すべてで、全カテゴリの確率が0でした。3本「正解」しているのは、全スコアが -inf で並んだときに max() が先頭のキーを返しただけです。regex-lookaround では、正解の regex クラス自体が、他の regex 記事8本が使っていない普通の単語35個(ahead、behind、think、colon など)で潰されていました。記事中の lookahead のような強い単語も、0が1つあれば勝てません。
alpha が100万分の1でもこの失敗は消えます(81.4%)。逆に大きすぎると、alpha=5 で疑似カウントが本物の回数を押し流して62.8%まで落ちます。これは後のエラー分析で効いてきます。
対数確率:約175語で積が 0.0 になる
教科書の「アンダーフローを避けるために対数を使う」を実際に見てみます。algorithm-sorting の記事(コード除去後923トークン)で、生の確率を float で掛け続け、0 になる位置を記録しました。
    for j, w in enumerate(toks, 1):
        q = (m.words[c][w] + 1) / denom
        p *= q
        logp += math.log(q)
        if p == 0.0 and zero_at is None:
            zero_at = j
underflow doc tokens 923
  algorithm: product=0.0 zero after token 175  log-sum=-5934.6
  csharp: product=0.0 zero after token 174  log-sum=-6605.2
  min positive float 5e-324 log10 = -323.3062153431158
  token count min/median/max 609 1277 2428
単語1つの確率は1e-3〜1e-4程度なので、175個掛けると double の最小の正の値(約10^-323.3)を下回ります。本当の値 e^-5934.6 は約10^-2577 です。最短の記事でも609トークンあるので、対数なしでは全記事がアンダーフローし、全クラスが0.0で並びます。対数なら2クラスの差は670.6で、float の積では決して付けられない判定です。
正解率と混同行列
LOO、alpha=1、コード除去。行が正解、列が予測で、順序は csharp, algorithm, regex, server, winapi, app-ops, web, ai, flutter です。
  csharp     [37, 0, 0, 0, 0, 0, 0, 0, 0]
  algorithm  [0, 15, 0, 0, 0, 0, 0, 0, 0]
  regex      [0, 0, 9, 0, 0, 0, 0, 0, 0]
  server     [0, 0, 0, 7, 0, 0, 0, 0, 0]
  winapi     [1, 0, 0, 0, 5, 0, 0, 0, 0]
  app-ops    [0, 0, 0, 3, 0, 0, 1, 0, 0]
  web        [0, 0, 0, 4, 0, 0, 0, 0, 0]
  ai         [0, 0, 0, 2, 0, 0, 0, 0, 0]
  flutter    [0, 0, 0, 2, 0, 0, 0, 0, 0]
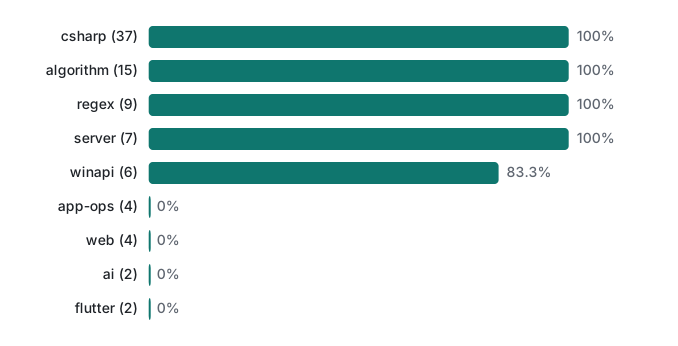
全体の84.9%は、結果が真っ二つに割れていることを隠しています。大きい5カテゴリは74本中73本正解。小さい4カテゴリは12本中0本で、そのうち11本が server に吸い込まれました。カテゴリ別正解率の平均(balanced accuracy)は53.7%で、このデータにはこちらが公平な数字です。
層化 70/30 分割も LOO と同じ傾向でした。シード0〜9でテスト正解率は80.8%〜88.5%、平均84.2%(シード0は学習60本・テスト26本で21本正解)。テストが26本だと1本で3.8ポイント動くので、主な数字は LOO にしています。
カテゴリごとの特徴語
各カテゴリで3回以上出た単語を log P(w | c) - log P(w | c 以外) で並べました。
  csharp     csharp, linq, ref, lambda, dialogresult, func, goto, collections
  algorithm  nodes, dfs, linked, tail, bfs, asan, algorithm, vertex
  regex      quantifier, pcre2, w+, regexp, backreferences, regexoptions, regex, backreference
  server     localhost, hostname, connection, evening, sql, clients, prepared, budget
  winapi     mingw, sendmessage, getkeystate, w64, findwindow, getasynckeystate, winapi, gcc
  app-ops    landing, fcm, ua, ping, cooldown, token, admob, ctr
  web        wp, category, pillow, ini, noto, hreflang, sans, particle
  ai         human, schema, claude, tasks, agent, verifier, mcp, duration
  flutter    consent, slashed, signboard, curl, …
大きいカテゴリでは、特徴語がそのままトピックです。小さいカテゴリでは記事1本の単語です。pillow と noto は OG 画像カードの記事、evening と budget は MySQL 接続数制限の記事から来ています。2〜4本しかないと「特徴的」は「その1本で珍しい」という意味になります。トピックを学んだのではなく、記事を覚えただけです。
エラー分析:「the」が server に投票していた
誤判定は話題の単語にだまされたのだろう、と予想していました。flutter-migration-16-apps-what-broke はサーバーの話もするから server に行った、という具合です。外れでした。スコアを単語ごとの寄与に分解すると(flutter と server の比較、正の値が server 寄り)こうなります。
flutter-migration-16-apps-what-broke: flutter=-9309.5 server=-8449.2 margin=860.3
  pushes to server [('the', 83, 122.9), ('and', 34, 44.4), ('a', 30, 33.8), ('on', 15, 27.3), …]
  pushes to flutter [('android', 7, -5.1), ('ios', 6, -4.4), ('dart', 2, -3.6), ('debug', 2, -3.6), …]
  train docs flutter 1 tokens 852 | server 7 tokens 8271
83回出てくる the だけで、Flutter 関連の単語すべてより重いのです。原因は話題ではなく平滑化でした。このときの語彙は6,101語。flutter クラスは学習記事1本・852トークンなので、alpha=1 の分母は 852 + 6,101 で、確率の88%が疑似カウントです。
| 本文中の the の割合 | P(the | クラス), α=1 | α=0.1 | |
|---|---|---|---|
| flutter(852トークン) | 8.0% | 0.0099 | 0.047 |
| server(8,271トークン) | 7.6% | 0.0436 | 0.070 |
どちらも the の使用頻度はほぼ同じなのに、平滑化のせいで server 側が4.4倍ありそうに見えます。よく出る単語すべてで同じことが起こるので、小さいクラスはトピックの単語が数えられる前に「文法」で負けます。分解した他の誤判定も同じ形でした。ai-coding-agent-live-server-guardrails は agent(19回)が逆方向に強く押しても server に892.2差で負け、winapi-getcurrentdirectory-getmodulefilename は buffer、getcurrentdirectory、getmodulefilename がすべて winapi を指していても csharp に143.2差で負けました。
試した対策(すべて LOO):
| 変更 | 正解率 | Balanced | 小カテゴリの正解 |
|---|---|---|---|
| 基準(α=1) | 84.9% | 53.7% | 0/12 |
| 事前確率を一様に(P(c) を除く) | 84.9% | 53.7% | 0/12 |
| α=0.1 | 86.0% | 57.9% | 2/12(web) |
| ストップワード66語除去 + α=0.1 | 86.0% | 57.9% | 2/12 |
| 二値カウント(出現の有無だけ) | 74.4% | 38.9% | 0/12 |
事前確率はまったく効きませんでした。1,000語の文書では尤度の合計が数千のオーダーなのに、log P(c) は -0.8〜-4.4 しかありません。alpha を下げると少し良くなりました。それでも ai と flutter は1本も当たりません。学習例1本はクラスとは呼べないからです。
学習・予測にかかる時間
  fit on 86 docs: 6.50 ms
  predict: 1.651 ms/doc
  tokenize all: 34.6 ms
学習は数えるだけなので86本で6.5ms。86回の LOO 全体でも0.74秒です。予測が1本1.65msかかるのは、純 Python のループが9クラスそれぞれで全ての異なり語を回るためです。いちばん遅いのはトークン化でした。ブログ規模なら、どれも気にする必要はありません。
日本語:単語ではなく文字バイグラムで
日本語は分かち書きをしないので、split() はフレーズ丸ごとを返します。同じ86本の日本語版を2通りで試しました。どちらも英字の単語はそのまま1トークンにしています。
def bigrams(body):
    out = []
    for run in re.findall(r"[^\s\W\d_a-z]+|[a-z][a-z0-9_]*[#+]*", ja_clean(body)):
        if run[0].isascii():
            out.append(run)                   # keep latin words whole
        else:
            out += [run[i:i+2] for i in range(len(run) - 1)] or [run]
    return out
sample bigrams: ['ナイ', 'イー', 'ーブ', 'ブベ', 'ベイ', 'イズ', 'ズで', 'で記', '記事', '事を', 'を分', '分類']
sample split  : ['ナイーブベイズで記事を分類する', 'c#', 'の例']
ja whitespace split          acc 54/86=0.628 balanced=0.281
ja char bigrams              acc 70/86=0.814 balanced=0.481
バイグラムで62.8%から81.4%に上がり、英語(84.9%)に近づきました。空白分割では server が0/7、winapi が0/6 でした。上の例のような長いフレーズは二度と同じ形で出てこないからです。バイグラムにすると server は7/7に戻りましたが、winapi は2/6に落ち、外れた4本はすべて csharp でした。WinAPI の記事は C 言語で、日本語の説明部分(変数、関数、配列など)は C# 講座とよく似ています。区別の決め手になる API 名(英字)は1語1トークンなのに、説明文は1文字ずつずれたバイグラムで何倍ものトークンになるので、日本語版では説明文の票が API 名の票を上回ってしまうのだと考えています。
MeCab や Sudachi のような形態素解析器を使えば本物の単語が取れますが、それは依存関係を1つ増やすことです。「ナイーブ」「ベイズ」のような語の境界を知らなくても、2文字ずつ切るだけで差はかなり縮まる、というのが今回の実測です。
ナイーブベイズで十分か、ロジスティック回帰か、埋め込みか
| 状況 | 選ぶもの | 理由 |
|---|---|---|
| ラベル付き文書が数百本以下、カテゴリごとに固有の語彙がある | ナイーブベイズ | 学習は数ミリ秒、今回84.9%、単語単位で説明できる |
| まずベースラインがほしい | ナイーブベイズ | 大きいモデルがこれに勝てないなら、問題はラベル側 |
| クラスが極端に偏り、よく出る単語が支配する | TF-IDF + ロジスティック回帰 | 重みを同時に学ぶので the の重みは0に近づき、4.4倍の偏りが出ない |
| カテゴリの違いがキーワードでなく意味にある(今回の server / web / app-ops) | 文埋め込み + ロジスティック回帰や k-NN | 話題の単語は共有されていても、意味は共有されていない |
| 1クラスに1〜2例しかない | モデル以前。統合するかラベルを見直す | 上のどれも1本からクラスは学べない |
| ラベルが頻繁に変わり、すぐ再学習したい | ナイーブベイズ | 文書の追加は回数を足すだけ |
次の一手がロジスティック回帰なのは、ナイーブベイズが各単語を独立した証拠として扱うからです。今回の誤りはまさにそれで、何十もの文法語が少しずつ同じ方向に足し込まれていました。ロジスティック回帰は全ての重みを同時に合わせるので、the はほぼ0に押し下げられます。パーセプトロンの回では、同じ種類の線形モデルを手で組み立てます。
正直な限界
- データが少ない。 86本で、4カテゴリは2〜4本。LOO では
aiとflutterは1本だけで学習します。これはどの手法でも直りません。1本の正誤で全体の正解率が1.2ポイント動きます。 - カテゴリが重なっている。 server・web・app-ops・ai・flutter の19本は3日のうちに書かれ、ほとんどが同じサイトとアプリの移行の話です。この5つを1つの
opsラベルにまとめると、LOO 正解率は 98.8%(85/86) になりました。残った誤りは例の winapi 記事1本だけです。分類器が弱かったのではありません。ラベルは編集上の判断で、本文だけではほとんど区別できないのです。 - テストが完全に独立ではない。 シリーズ記事はテンプレートを共有しています(C# 講座37本は同じ構成)。だから csharp と algorithm は簡単でした。毛色の違う C# 記事なら結果は下がるはずです。
- スナップショットは動く。 この記事も兄弟記事も
aiなので、最新のフォルダで再実行すると件数が変わります。 - この偏りでは正解率1つでは足りない。 balanced accuracy かカテゴリ別の再現率を一緒に出してください。
次回は単語の袋(bag of words)はそのままに、数えるかわりに重みを学習させます:パーセプトロンから小さなニューラルネットへ。
よくある質問
ラプラス平滑化をしないとどうなる?
86記事すべてで、全カテゴリの確率が0になりました。どの記事にも「あるカテゴリが一度も使っていない単語」が含まれるためです。正解率は3.5%(3/86)で、これはスコアが全部 -inf で並んだときに辞書順で先頭のクラスが選ばれただけです。
なぜ確率を掛けずに対数を足すのか?
生の確率を float で掛けていくと、174〜175語目でちょうど 0.0 になりました。最も短い記事でも609語あるので、対数を使わなければ全記事がアンダーフローします。対数の合計は約 -6,000 で、double の最小値(約1e-323)よりはるかに小さい値です。
日本語の記事はどう分類する?
空白で分割すると正解率62.8%でしたが、文字バイグラム(2文字ずつ)にすると81.4%になり、英語の84.9%に近づきました。形態素解析器なしで、10行ほどのコードで済みます。