나이브 베이즈 텍스트 분류기를 표준 라이브러리로: 블로그 글 86개 실측
Python 표준 라이브러리만으로 다항 나이브 베이즈를 약 70줄로 만들어 블로그 글 86개의 카테고리를 맞혔다. LOO 정확도 84.9%, 평활화 없이 전부 0이 되는 모습, 언더플로 실측, 한국어 조사와 바이그램 비교.
텍스트 분류를 배우려고 하면 보통 scikit-learn 의 MultinomialNB 한 줄로 끝나고, 그 안에서 무슨 일이 일어나는지는 보지 못한 채 넘어갑니다. 이 글은 나이브 베이즈가 언제 충분하고 언제 부족한지 직접 확인하고 싶은 분을 위해, Python 표준 라이브러리만으로 다항 나이브 베이즈를 약 70줄로 구현하고 이 블로그 자신의 글 86개로 카테고리를 맞혀 본 기록입니다. 결과는 leave-one-out 정확도 84.9%(가장 많은 클래스만 찍으면 43.0%), 학습 시간 6.5ms 였습니다.
숫자보다 쓸모 있는 건 어디서 0점을 받았는지, 그리고 그 원인이 "the" 라는 단어 하나였다는 사실입니다. 한국어판 글로도 돌려 봤는데, 띄어쓰기로 나누면 조사 때문에 손해를 본다는 것도 숫자로 확인했습니다.
이 글은 시리즈 「표준 라이브러리로 밑바닥부터 만드는 머신러닝」의 3강입니다. 1강은 선형 회귀와 경사 하강법, 2강은 k-means 군집화였습니다. 다음은 퍼셉트론에서 작은 신경망까지, 마지막은 같은 글들로 만드는 TF-IDF·BM25 검색 엔진입니다.
모든 수치의 실행 환경은 Python 3.9 표준 라이브러리, Apple Silicon Mac(M1 Pro)입니다. numpy 도 scikit-learn 도 쓰지 않았습니다. 폐지 예정 API 를 피했으므로 3.12 이상에서도 그대로 돌아갑니다.
데이터: 이 블로그의 글 86개, 불균형한 9개 카테고리
이 블로그는 YAML 프론트매터가 붙은 Markdown 에서 생성합니다(구조는 다국어 블로그용 정적 사이트 생성기 참고). 각 파일의 category: 가 정답 레이블입니다. 입력은 본문만 쓰고, 제목·설명·FAQ 는 넣지 않았습니다. slug 에서 답을 읽어 버리지 못하게 하려는 것입니다.
글을 쓰는 시점의 content/en/*.md(영어판)를 스냅숏으로 고정했고, 86개였습니다.
| 카테고리 | 글 수 | 카테고리 | 글 수 |
|---|---|---|---|
| csharp | 37 | app-ops | 4 |
| algorithm | 15 | web | 4 |
| regex | 9 | ai | 2 |
| server | 7 | flutter | 2 |
| winapi | 6 | 합계 | 86 |
분류기에는 꽤 고약한 모양입니다. 전부 "csharp" 이라고 답해도 43.0% 가 나옵니다. 카테고리 4개는 글이 2~4개뿐입니다. 게다가 이 글과 같은 날 올라가는 시리즈 글은 ai 에 들어가므로, 나중에 같은 코드를 돌리면 개수가 달라집니다.
86개를 70/30 으로 나누면 테스트는 26개이고, 글이 2개뿐인 카테고리는 테스트에 1개 들어갈까 말까입니다. 그래서 주된 평가는 leave-one-out(LOO), 즉 85개로 학습하고 남은 1개를 맞히는 것을 86번 반복하는 방법으로 했습니다. 교차 확인용으로 시드 0~9 의 층화 70/30 분할도 돌렸습니다(결과는 아래).
분류기 전체: 약 70줄
다항 나이브 베이즈는 문서 d 의 클래스 c 점수를
log P(c) + Σ count(w, d) · log P(w | c)
로 계산하고 가장 큰 클래스를 고릅니다. P(c) 는 학습 글 중 그 클래스의 비율, P(w | c) 는 클래스 c 의 전체 단어 중 단어 w 의 비율이며, 모든 단어에 가상 횟수 alpha 를 더합니다(라플라스 평활화). "나이브"는 클래스가 정해지면 단어끼리 독립이라고 가정한다는 뜻입니다. 실제로는 독립이 아니지만 순위는 대체로 맞습니다.
아래 코드를 nb.py 로 저장합니다.
"""Multinomial naive Bayes: predict a blog post's category from its body.
Python standard library only. Usage: python nb.py content/en [--keep-code]
"""
import math, re, sys, time
from collections import Counter, defaultdict
from pathlib import Path

FENCE = re.compile(r"^```.*?^```", re.S | re.M)
WORD = re.compile(r"[a-z][a-z0-9_]*[#+]*")

def load(folder):
    docs = []
    for p in sorted(Path(folder).glob("*.md")):
        _, front, body = p.read_text(encoding="utf-8").split("---", 2)
        cat = re.search(r"^category:\s*(\S+)", front, re.M).group(1)
        docs.append((p.stem, cat, body))
    return docs

def tokenize(body, keep_code=False):
    if not keep_code:
        body = FENCE.sub(" ", body)
    body = re.sub(r"https?://\S+|\[\[fig:[^\]]*\]\]", " ", body)
    return WORD.findall(body.lower())

class NaiveBayes:
    def __init__(self, alpha=1.0):
        self.alpha = alpha

    def fit(self, X, y):                      # X: list of Counter, y: labels
        self.n_docs = Counter(y)
        self.words = defaultdict(Counter)     # class -> word counts
        for counts, c in zip(X, y):
            self.words[c].update(counts)
        self.vocab = set().union(*X)
        self.total = {c: sum(w.values()) for c, w in self.words.items()}
        return self

    def log_scores(self, counts):
        N, V, a = sum(self.n_docs.values()), len(self.vocab), self.alpha
        out = {}
        for c in self.n_docs:
            s = math.log(self.n_docs[c] / N)
            denom = self.total[c] + a * V
            for w, k in counts.items():
                if w not in self.vocab:
                    continue                  # unseen in training: skip
                num = self.words[c][w] + a
                if num == 0:                  # only possible when alpha == 0
                    s = -math.inf
                    break
                s += k * math.log(num / denom)
            out[c] = s
        return out

    def predict(self, counts):
        sc = self.log_scores(counts)
        return max(sc, key=sc.get)

def leave_one_out(X, y, alpha=1.0):
    preds, dead = [], 0
    for i in range(len(X)):
        m = NaiveBayes(alpha).fit(X[:i] + X[i+1:], y[:i] + y[i+1:])
        sc = m.log_scores(X[i])
        if all(v == -math.inf for v in sc.values()):
            dead += 1                         # every class has probability 0
        preds.append(max(sc, key=sc.get))
    return preds, dead

if __name__ == "__main__":
    folder, keep = sys.argv[1], "--keep-code" in sys.argv
    docs = load(folder)
    y = [c for _, c, _ in docs]
    X = [Counter(tokenize(b, keep)) for _, _, b in docs]
    print("docs", len(docs), dict(Counter(y).most_common()))
    t = time.perf_counter()
    preds, dead = leave_one_out(X, y)
    el = time.perf_counter() - t
    acc = sum(p == t_ for p, t_ in zip(preds, y)) / len(y)
    print(f"LOO accuracy {acc:.3f} ({sum(p == t_ for p, t_ in zip(preds, y))}/{len(y)})"
          f"  {el:.2f}s for {len(y)} fits")
$ python3 nb.py content/en
docs 86 {'csharp': 37, 'algorithm': 15, 'regex': 9, 'server': 7, 'winapi': 6, 'app-ops': 4, 'web': 4, 'ai': 2, 'flutter': 2}
LOO accuracy 0.849 (73/86)  0.74s for 86 fits
어휘는 학습 쪽 글로만 만들고, 학습에 없던 단어는 건너뜁니다. 건너뛰기는 모든 클래스에 똑같이 작용하므로 순위에 영향이 없습니다.
토큰화: 코드 블록을 지울까, 남길까
기술 블로그는 절반이 글이고 절반이 코드입니다. 토크나이저는 소문자로 바꾸고, c#·c++ 를 한 토큰으로 남기고([#+]* 부분), URL 과 그림 표시를 지웁니다. 고민한 건 코드 펜스입니다. using System; 은 C# 의 강력한 단서지만, i, x, printf 처럼 어느 카테고리에나 나오는 잡음도 늘어납니다.
| 설정 | 토큰 수 | 어휘 수 | LOO 정확도 |
|---|---|---|---|
| 코드 블록 제거 | 107,381 | 6,174 | 73/86 = 84.9% |
| 코드 블록 유지 | 137,271 | 7,378 | 73/86 = 84.9% |
정확도는 같지만 틀리는 글은 달랐습니다. 코드를 남기면 winapi-getcurrentdirectory-getmodulefilename(csharp 로 오판)이 고쳐지는 대신, server 글인 litespeed-htaccess-rewrite-non-ascii-urls 가 75.6 차이로 web 이 됐습니다. 리라이트 규칙 코드에서 html, index, htaccess 같은 토큰이 늘어나는데, 이것들이 web 카테고리의 WordPress 이전 글에도 나오기 때문입니다. 결과가 상쇄되므로 이후로는 설명하기 쉬운 "코드 제거"로 갑니다. 카테고리마다 프로그래밍 언어가 뚜렷이 갈리는 블로그라면 남기는 쪽이 이길 겁니다.
라플라스 평활화가 없으면 모든 글의 확률이 0
alpha=0 이면, 그 클래스가 한 번도 쓰지 않은 단어의 P(w | c) 는 0 입니다. 그런 단어가 하나만 있어도 곱 전체가 0, 로그로는 -inf 입니다. 같은 leave_one_out 으로 alpha 를 바꿔 가며 돌렸습니다.
for a in (0, 1e-6, 0.01, 0.1, 0.5, 1, 2, 5):
    preds, dead = leave_one_out(X, y, a)
    ok = sum(p == t for p, t in zip(preds, y))
    print(f"  alpha={a:<6} acc={ok}/{len(y)}={ok/len(y):.3f} all-classes-zero={dead}")
  alpha=0      acc=3/86=0.035 all-classes-zero=86
  alpha=1e-06  acc=70/86=0.814 all-classes-zero=0
  alpha=0.01   acc=73/86=0.849 all-classes-zero=0
  alpha=0.1    acc=74/86=0.860 all-classes-zero=0
  alpha=0.5    acc=73/86=0.849 all-classes-zero=0
  alpha=1      acc=73/86=0.849 all-classes-zero=0
  alpha=2      acc=65/86=0.756 all-classes-zero=0
  alpha=5      acc=54/86=0.628 all-classes-zero=0
"일부 글에서"가 아닙니다. 86개 전부가 모든 카테고리에서 확률 0 이었습니다. 3개가 "정답"인 것은 점수가 모두 -inf 로 같을 때 max() 가 첫 번째 키를 돌려준 결과일 뿐입니다. regex-lookaround 에서는 정답인 regex 클래스 자체가, 다른 regex 글 8개가 쓰지 않은 평범한 단어 35개(ahead, behind, think, colon 등) 때문에 0 이 됐습니다. 글에 lookahead 같은 강한 단어가 있어도 0 하나를 이기지 못합니다.
alpha 가 100만분의 1 이어도 이 실패는 사라집니다(81.4%). 반대로 너무 크면, alpha=5 에서는 가상 횟수가 실제 횟수를 덮어 버려 62.8% 까지 떨어집니다. 이 점이 뒤의 오류 분석에서 중요해집니다.
로그 확률: 약 175단어에서 곱이 0.0 이 된다
교과서의 "언더플로를 피하려고 로그를 쓴다"를 실제로 봤습니다. algorithm-sorting 글(코드 제거 후 923토큰)에서 실제 확률을 float 로 계속 곱하면서 0 이 되는 위치를 기록했습니다.
    for j, w in enumerate(toks, 1):
        q = (m.words[c][w] + 1) / denom
        p *= q
        logp += math.log(q)
        if p == 0.0 and zero_at is None:
            zero_at = j
underflow doc tokens 923
  algorithm: product=0.0 zero after token 175  log-sum=-5934.6
  csharp: product=0.0 zero after token 174  log-sum=-6605.2
  min positive float 5e-324 log10 = -323.3062153431158
  token count min/median/max 609 1277 2428
단어 하나의 확률은 1e-3~1e-4 정도라서, 175개를 곱하면 double 의 가장 작은 양수(약 10^-323.3) 아래로 내려갑니다. 진짜 값 e^-5934.6 은 약 10^-2577 입니다. 가장 짧은 글도 609토큰이므로 로그 없이는 모든 글이 언더플로하고 모든 클래스가 0.0 으로 같아집니다. 로그로는 두 클래스의 차이가 670.6 으로, float 곱으로는 절대 낼 수 없는 판정입니다.
정확도와 혼동 행렬
LOO, alpha=1, 코드 제거. 행이 정답, 열이 예측이며 순서는 csharp, algorithm, regex, server, winapi, app-ops, web, ai, flutter 입니다.
  csharp     [37, 0, 0, 0, 0, 0, 0, 0, 0]
  algorithm  [0, 15, 0, 0, 0, 0, 0, 0, 0]
  regex      [0, 0, 9, 0, 0, 0, 0, 0, 0]
  server     [0, 0, 0, 7, 0, 0, 0, 0, 0]
  winapi     [1, 0, 0, 0, 5, 0, 0, 0, 0]
  app-ops    [0, 0, 0, 3, 0, 0, 1, 0, 0]
  web        [0, 0, 0, 4, 0, 0, 0, 0, 0]
  ai         [0, 0, 0, 2, 0, 0, 0, 0, 0]
  flutter    [0, 0, 0, 2, 0, 0, 0, 0, 0]
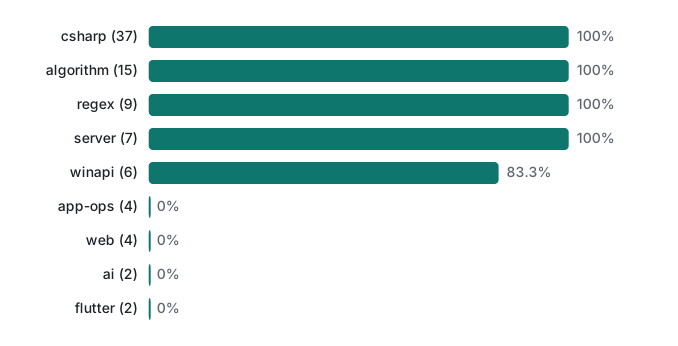
전체 84.9% 는 결과가 둘로 갈렸다는 사실을 가립니다. 큰 카테고리 5개는 74개 중 73개 정답, 작은 카테고리 4개는 12개 중 0개이고 그중 11개가 server 로 빨려 들어갔습니다. 카테고리별 정확도의 평균(balanced accuracy)은 53.7% 로, 이 데이터에는 이쪽이 공정한 숫자입니다.
층화 70/30 분할도 LOO 와 같은 경향이었습니다. 시드 0~9 에서 테스트 정확도는 80.8%~88.5%, 평균 84.2%(시드 0: 학습 60개, 테스트 26개 중 21개 정답). 테스트가 26개면 글 1개로 3.8%p 가 움직이므로 주된 숫자는 LOO 로 잡았습니다.
카테고리별 특징 단어
카테고리마다 3번 이상 나온 단어를 log P(w | c) - log P(w | c 이외) 로 정렬했습니다.
  csharp     csharp, linq, ref, lambda, dialogresult, func, goto, collections
  algorithm  nodes, dfs, linked, tail, bfs, asan, algorithm, vertex
  regex      quantifier, pcre2, w+, regexp, backreferences, regexoptions, regex, backreference
  server     localhost, hostname, connection, evening, sql, clients, prepared, budget
  winapi     mingw, sendmessage, getkeystate, w64, findwindow, getasynckeystate, winapi, gcc
  app-ops    landing, fcm, ua, ping, cooldown, token, admob, ctr
  web        wp, category, pillow, ini, noto, hreflang, sans, particle
  ai         human, schema, claude, tasks, agent, verifier, mcp, duration
  flutter    consent, slashed, signboard, curl, …
큰 카테고리의 특징 단어는 그 자체가 주제입니다. 작은 카테고리의 특징 단어는 글 한 편의 단어입니다. pillow 와 noto 는 OG 이미지 카드 글, evening 과 budget 은 MySQL 시간당 접속 한도 글에서 왔습니다. 글이 2~4개뿐이면 "특징적"은 "그 한 편에서 드물다"는 뜻이 됩니다. 주제를 배운 게 아니라 글을 외운 것입니다.
오류 분석: "the" 가 server 에 표를 던지고 있었다
오분류된 글은 주제 단어에 속았을 거라고 예상했습니다. flutter-migration-16-apps-what-broke 는 서버 얘기도 하니까 server 로 갔겠지, 하는 식으로요. 틀렸습니다. 점수를 단어별 기여도로 쪼개 보면(flutter 대 server, 양수가 server 쪽) 이렇습니다.
flutter-migration-16-apps-what-broke: flutter=-9309.5 server=-8449.2 margin=860.3
  pushes to server [('the', 83, 122.9), ('and', 34, 44.4), ('a', 30, 33.8), ('on', 15, 27.3), …]
  pushes to flutter [('android', 7, -5.1), ('ios', 6, -4.4), ('dart', 2, -3.6), ('debug', 2, -3.6), …]
  train docs flutter 1 tokens 852 | server 7 tokens 8271
83번 나오는 the 하나가 Flutter 관련 단어를 전부 합친 것보다 무겁습니다. 원인은 주제가 아니라 평활화였습니다. 이 회차의 어휘는 6,101개. flutter 클래스는 학습 글 1개, 852토큰이라 alpha=1 의 분모가 852 + 6,101 이고, 확률 질량의 88% 가 가상 횟수입니다.
| 본문 중 the 비율 | P(the | 클래스), α=1 | α=0.1 | |
|---|---|---|---|
| flutter(852토큰) | 8.0% | 0.0099 | 0.047 |
| server(8,271토큰) | 7.6% | 0.0436 | 0.070 |
두 클래스 모두 the 를 거의 같은 빈도로 쓰는데, 평활화 때문에 server 쪽이 4.4배 그럴듯해 보입니다. 자주 나오는 단어마다 같은 일이 생기니, 작은 클래스는 주제 단어를 세기도 전에 "문법"에서 집니다. 쪼개 본 다른 오분류도 같은 모양이었습니다. ai-coding-agent-live-server-guardrails 는 agent(19회)가 반대 방향으로 세게 밀었는데도 server 에 892.2 차이로 졌고, winapi-getcurrentdirectory-getmodulefilename 은 buffer, getcurrentdirectory, getmodulefilename 이 모두 winapi 를 가리켰는데도 csharp 에 143.2 차이로 졌습니다.
시도한 대책(모두 LOO):
| 변경 | 정확도 | Balanced | 작은 카테고리 정답 |
|---|---|---|---|
| 기준(α=1) | 84.9% | 53.7% | 0/12 |
| 사전 확률을 균등하게(P(c) 제외) | 84.9% | 53.7% | 0/12 |
| α=0.1 | 86.0% | 57.9% | 2/12(web) |
| 불용어 66개 제거 + α=0.1 | 86.0% | 57.9% | 2/12 |
| 이진 횟수(나왔는지 여부만) | 74.4% | 38.9% | 0/12 |
사전 확률은 전혀 효과가 없었습니다. 1,000단어짜리 문서에서 우도 합은 수천 단위인데 log P(c) 는 -0.8~-4.4 에 불과합니다. alpha 를 낮추니 조금 나아졌습니다. 그래도 ai 와 flutter 는 하나도 못 맞혔습니다. 학습 예가 1개뿐인 것은 클래스라고 할 수 없기 때문입니다.
학습·예측 시간
  fit on 86 docs: 6.50 ms
  predict: 1.651 ms/doc
  tokenize all: 34.6 ms
학습은 세기만 하면 되므로 86개에 6.5ms, 86번의 LOO 전체도 0.74초입니다. 예측에 글 하나당 1.65ms 가 드는 건 순수 Python 루프가 9개 클래스마다 모든 서로 다른 단어를 돌기 때문입니다. 가장 느린 단계는 토큰화였습니다. 블로그 규모라면 어느 것도 신경 쓸 필요가 없습니다.
한국어: 어절로 자르면 조사가 발목을 잡는다
한국어는 띄어쓰기가 있으니 split() 으로 충분할 것 같지만, 어절에는 조사가 붙어 있습니다. "분류기를"과 "분류기가"는 다른 토큰이 되고, 같은 단어의 횟수가 여러 칸으로 흩어집니다. 같은 86개 글의 한국어판(일부는 2021년 원고를 보강한 글)으로 어절 분할과 글자 바이그램을 비교했습니다. 두 방식 모두 영문 단어는 통째로 한 토큰으로 둡니다.
RUN = r"[^\s\W\d_a-z]+|[a-z][a-z0-9_]*[#+]*"
def eojeol(b): return re.findall(RUN, clean(b))
def bigrams(b):
    out = []
    for run in re.findall(RUN, clean(b)):
        if run[0].isascii(): out.append(run)
        else: out += [run[i:i+2] for i in range(len(run) - 1)] or [run]
    return out
['분류기를', '만들고', '분류기가', '틀린', '글을', '본다'] ['분류', '류기', '기를', '만들', '들고', '분류', '류기', '기가']
ko eojeol   vocab 15361 acc 69/86 {'app-ops': (0, 4), 'ai': (0, 2), 'server': (5, 7), 'flutter': (0, 2), 'web': (0, 4), …, 'winapi': (3, 6)}
ko bigrams  vocab 11011 acc 74/86 {'app-ops': (0, 4), 'ai': (0, 2), 'server': (7, 7), 'flutter': (0, 2), 'web': (1, 4), …, 'winapi': (5, 6)}
어절 분할 80.2%(69/86), 바이그램 86.0%(74/86). 바이그램은 "분류기를"과 "분류기가"에서 "분류"와 "류기"를 공유하게 해 주므로, 어휘가 15,361개에서 11,011개로 줄어드는데도 정확도는 오릅니다. server 는 5/7 에서 7/7, winapi 는 3/6 에서 5/6 이 됐습니다. 띄어쓰기가 없는 일본어판에서도 같은 실험을 했는데, 공백 분할 62.8% 가 바이그램으로 81.4% 가 됐습니다. 한국어는 어절이 있어서 출발점이 높지만, 조사를 떼어 내는 효과는 분명했습니다.
형태소 분석기(KoNLPy 의 Okt, Mecab-ko 등)를 쓰면 조사를 정확히 떼어 낼 수 있지만, 그건 의존성을 하나 늘리는 일입니다. 두 글자씩 자르는 10줄로 대부분의 이득을 얻었다는 게 이번 실측입니다.
나이브 베이즈로 충분한가, 로지스틱 회귀인가, 임베딩인가
| 상황 | 선택 | 이유 |
|---|---|---|
| 레이블이 붙은 문서가 수백 개 이하, 카테고리마다 고유한 어휘가 있다 | 나이브 베이즈 | 학습 수 ms, 이번 84.9%, 단어 단위로 설명 가능 |
| 일단 기준선이 필요하다 | 나이브 베이즈 | 큰 모델이 이걸 못 이기면 문제는 레이블 쪽 |
| 클래스가 심하게 불균형하고 흔한 단어가 지배한다 | TF-IDF + 로지스틱 회귀 | 가중치를 함께 학습하므로 the 의 가중치가 0 에 가까워지고 4.4배 편향이 생기지 않는다 |
| 카테고리 차이가 키워드가 아니라 의미에 있다(이번 server / web / app-ops) | 문장 임베딩 + 로지스틱 회귀나 k-NN | 주제 단어는 겹쳐도 의미는 겹치지 않는다 |
| 클래스 하나에 예가 1~2개뿐 | 모델 이전의 문제. 합치거나 레이블을 재검토 | 위의 어느 것도 글 1개로 클래스를 배우지 못한다 |
| 레이블이 자주 바뀌어 바로 재학습해야 한다 | 나이브 베이즈 | 문서 추가는 횟수를 더하는 것뿐 |
다음 단계가 로지스틱 회귀인 이유는 나이브 베이즈가 각 단어를 독립된 증거로 다루기 때문입니다. 이번 오류가 정확히 그랬습니다. 수십 개의 문법 단어가 조금씩 같은 방향으로 더해졌습니다. 로지스틱 회귀는 모든 가중치를 함께 맞추므로 the 를 거의 0 으로 눌러 버립니다. 퍼셉트론 강의에서 같은 종류의 선형 모델을 손으로 만들어 봅니다.
솔직한 한계
- 데이터가 작습니다. 86개이고, 카테고리 4개는 2~4개입니다. LOO 에서
ai와flutter는 글 1개로 학습합니다. 어떤 기법으로도 고칠 수 없습니다. 글 하나의 정오로 전체 정확도가 1.2%p 움직입니다. - 카테고리가 겹칩니다. server·web·app-ops·ai·flutter 의 19개 글은 사흘 사이에 쓰였고, 대부분 같은 사이트와 앱 이전 이야기입니다. 이 다섯을
ops하나로 합치면 LOO 정확도가 98.8%(85/86) 가 됐습니다. 남은 오류는 앞의 winapi 글 하나뿐입니다. 분류기가 약했던 게 아닙니다. 레이블이 편집상의 선택이라 본문만으로는 거의 구별되지 않는 것입니다. - 테스트가 완전히 독립적이지 않습니다. 시리즈 글은 템플릿을 공유합니다(C# 강좌 37개는 같은 구성). 그래서 csharp 과 algorithm 이 쉬웠습니다. 결이 다른 C# 글이라면 결과가 떨어질 겁니다.
- 스냅숏은 움직입니다. 이 글도 시리즈 글도
ai이므로, 최신 폴더로 다시 돌리면 개수가 달라집니다. - 이런 불균형에서는 정확도 하나로 부족합니다. balanced accuracy 나 카테고리별 재현율을 함께 보고하세요.
다음 강의는 단어 주머니(bag of words)는 그대로 두고, 세는 대신 가중치를 학습합니다: 퍼셉트론에서 작은 신경망까지.
자주 묻는 질문
라플라스 평활화를 안 하면 어떻게 되나요?
글 86개 모두에서 모든 카테고리의 확률이 0이 됐습니다. 어느 글이든 '어떤 카테고리가 한 번도 쓰지 않은 단어'가 들어 있기 때문입니다. 정확도는 3.5%(3/86)였고, 이것도 점수가 전부 -inf 로 같을 때 사전 순서상 첫 클래스가 뽑힌 것뿐입니다.
확률을 곱하지 않고 로그를 더하는 이유는?
실제 확률을 float 로 곱해 보니 174~175번째 단어에서 정확히 0.0 이 됐습니다. 가장 짧은 글도 609단어라서, 로그를 쓰지 않으면 모든 글이 언더플로합니다. 로그 합은 약 -6,000 으로, double 최솟값(약 1e-323)보다 훨씬 작습니다.
한국어 글은 띄어쓰기로 나누면 안 되나요?
어절 단위로 나누면 '분류기를'과 '분류기가'가 다른 단어가 됩니다. 같은 86개 글의 한국어판에서 어절 분할은 80.2%, 글자 바이그램은 86.0%였습니다. 형태소 분석기 없이 10줄 정도로 됩니다.