k-means を標準ライブラリだけで実装:局所解・k-means++・k の決め方
Python 標準ライブラリだけで k-means を書き、各条件200回実行。最良解に届いたのはランダム初期化79回、k-means++127回。空クラスタ、スケーリング、ブログ記事のクラスタリングまで実測。
scikit-learn の KMeans を何となく使っていて、「実行するたびにクラスタが入れ替わる」「k はいくつが正解なのか」で手が止まった人向けの記事です。k-means を Python 標準ライブラリだけで約60行で書き、条件ごとに200回ずつ回して、失敗の仕方を数字で確かめました。結論から言うと、ランダム初期化で最良のクラスタリングに届いたのは 200回中79回、k-means++ でも 127回 で、k-means++ は収束までの反復も平均10.0回から7.3回に減りました。
この記事は連載「ゼロから作る機械学習(Python 標準ライブラリのみ)」の第2回です。第1回の線形回帰と勾配降下法では「損失・ループ・停止条件」の3点セットを扱いました。k-means も同じ3点でできていますが、正解ラベルも勾配もありません。このあとナイーブベイズ、パーセプトロンから小さなニューラルネットへ、TF-IDF/BM25 検索エンジンと続きます。
実行環境: Python 3.9.6 標準ライブラリのみ(math, random, statistics, collections, re)、Apple Silicon Mac(M1 Pro)。非推奨 API は使っていないので Python 3.12 以降でもそのまま動くはずです。乱数はすべてシード固定の random.Random なので、以下の数字はそのまま再現できます。
ロイドのアルゴリズムを60行で
k-means は、k 個の代表点(重心)を置いて イナーシャ、つまり各点から最も近い重心までの距離の2乗の合計を最小にしようとします。標準的な解き方がロイドのアルゴリズムで、次の2ステップを何も変わらなくなるまで繰り返します。
- 割り当て:各点を最も近い重心のクラスタに入れる
- 更新:各重心を、そのクラスタに入った点の平均に動かす
どちらのステップもイナーシャを増やさないので、ループは必ず止まります。ただし止まるのは「どちらのステップでもこれ以上良くならない所」で、それは全体の最小とは限りません。この記事の大半は、この差の話です。
以下が kmeans.py の全文です。他のスクリプトはこれを import します。
import math, random

def make_blobs(centers, n_each, spread, seed):
    rng = random.Random(seed)
    X, y = [], []
    for label, (cx, cy) in enumerate(centers):
        for _ in range(n_each):
            X.append((rng.gauss(cx, spread), rng.gauss(cy, spread)))
            y.append(label)
    return X, y

def d2(a, b):
    return sum((p - q) ** 2 for p, q in zip(a, b))

def mean(points):
    n = len(points)
    return tuple(sum(c) / n for c in zip(*points))

def init_random(X, k, rng):            # Forgy: k distinct data points
    return [X[i] for i in rng.sample(range(len(X)), k)]

def init_plusplus(X, k, rng):          # k-means++ (Arthur & Vassilvitskii 2007)
    C = [X[rng.randrange(len(X))]]
    D = [d2(x, C[0]) for x in X]
    while len(C) < k:
        r, acc = rng.random() * sum(D), 0.0
        for i, w in enumerate(D):
            acc += w
            if acc >= r:
                break
        C.append(X[i])
        D = [min(D[j], d2(X[j], X[i])) for j in range(len(X))]
    return C

def kmeans(X, k, init="++", seed=0, max_iter=300, C=None):
    rng = random.Random(seed)
    if C is None:
        C = (init_plusplus if init == "++" else init_random)(X, k, rng)
    empty_fixes = 0
    for it in range(1, max_iter + 1):
        # 1) assignment step
        labels = [min(range(k), key=lambda j: d2(x, C[j])) for x in X]
        # 2) update step
        groups = [[] for _ in range(k)]
        for x, j in zip(X, labels):
            groups[j].append(x)
        newC = []
        for j in range(k):
            if groups[j]:
                newC.append(mean(groups[j]))
            else:   # empty cluster: move it to the worst-served point
                far = max(range(len(X)), key=lambda i: d2(X[i], C[labels[i]]))
                newC.append(X[far])
                empty_fixes += 1
        if newC == C:
            break
        C = newC
    inertia = sum(d2(x, C[j]) for x, j in zip(X, labels))
    return C, labels, inertia, it, empty_fixes
反復回数 it には「何も動かなかったことを確認した最後の1回」も含みます。テストデータは、間隔6の格子上に置いた8つのガウス分布の塊(各75点、σ = 1.0、シード42)の計600点です。人間が散布図を見れば一目で8つに分けられる、わざと易しいデータです。だからこそ、この先の失敗がはっきり見えます。
失敗その1:ランダム初期化は悪い局所解に落ちる
1回だけ実行して「うまくいった」と判断するのは危険です。シード0〜199で200回ずつ回し、最終イナーシャの分布を見ました。
import statistics as st, time
from kmeans import make_blobs, kmeans

CENTERS = [(0,0),(6,0),(12,0),(0,6),(6,6),(12,6),(3,12),(9,12)]
X, y = make_blobs(CENTERS, n_each=75, spread=1.0, seed=42)

for init in ("random", "++"):
    t = time.perf_counter()
    runs = [kmeans(X, 8, init=init, seed=s) for s in range(200)]
    sec = time.perf_counter() - t
    inert = [r[2] for r in runs]; iters = [r[3] for r in runs]
    best = min(inert)
    q = st.quantiles(inert, n=4)
    print(f"{init:>6}: inertia best {best:.1f} | Q1 {q[0]:.1f} median {q[1]:.1f} "
          f"Q3 {q[2]:.1f} worst {max(inert):.1f}")
    print(f"        runs at best {sum(i < best * 1.001 for i in inert)}/200, "
          f"distinct end states {len({round(i) for i in inert})}, "
          f"iterations mean {st.mean(iters):.1f} max {max(iters)}, {sec:.2f}s")
    tens = [min(inert[i:i + 10]) for i in range(0, 200, 10)]
    print(f"        best-of-10 restarts reached the best in "
          f"{sum(b < best * 1.001 for b in tens)}/20 groups")
random: inertia best 1170.9 | Q1 1170.9 median 2275.3 Q3 2413.8 worst 3765.7
        runs at best 79/200, distinct end states 81, iterations mean 10.0 max 29, 5.35s
        best-of-10 restarts reached the best in 20/20 groups
    ++: inertia best 1170.9 | Q1 1170.9 median 1170.9 Q3 2289.9 worst 2592.9
        runs at best 127/200, distinct end states 57, iterations mean 7.3 max 23, 4.44s
        best-of-10 restarts reached the best in 20/20 groups
ランダム初期化では 中央値が最良の約2倍(2,275 対 1,171)で、200回の終わり方は81通りに散らばりました。悪い回の中身を調べると、パターンはいつも同じです。たとえばシード2では、隣り合う塊6と7を1つの重心がまとめて抱え(144点)、その代わり塊2が42点と33点の2つに割れていました。ロイドの2ステップではこれを直せません。重心を隣の塊へ移すには一度イナーシャを悪化させる必要があり、アルゴリズムはそういう一歩を決して踏まないからです。
k-means++ は、最初の重心だけランダムに選び、2つ目以降は「すでに選んだ重心から遠い点ほど選ばれやすい」確率(距離の2乗に比例)で選びます。離れた塊に重心が1つずつ行き渡りやすくなるわけです。結果は200回中127回で最良、平均反復は2.7回少なく、最悪の回(2,593)もランダムの最悪(3,766)よりかなりましでした。それでも 73回は失敗 しています。「良いスタート」であって「保証」ではありません。
どちらの方法でも効く対策は地味で、「何回か回してイナーシャ最小を採る」ことです。200回を10回ずつ20グループに分けると、各グループの最良は両方式とも20/20で全体の最良に一致しました。scikit-learn の n_init はこのためのオプションですが、現在の既定値 n_init="auto" は k-means++ のとき 1回しか 実行しません。今回のデータでは k-means++ 1回だと36.5%の確率で最良を外したので、結果が大事な場面では n_init を明示しておくのが安全です。
図の真ん中の棒は、次の節で扱う3つ目の初期化(データの範囲内に完全ランダムな座標を k 個置く)の結果です。
失敗その2:空クラスタと、Python ならではの静かな罠
どの点からも「一番近い重心」に選ばれなかったクラスタは空になります。初期重心をデータ点から選ぶ方式(ランダム、k-means++)なら、最初の割り当てで少なくともその点自身は残るので、今回の計400回では一度も起きませんでした。ところが、範囲内のランダム座標から始めると、塊と塊の間の何もない場所に重心が置かれることがあります。
教科書どおりのループなら ZeroDivisionError で落ちるだろう、と思って試したところ、落ちませんでした。
import random
from kmeans import make_blobs, kmeans, mean, d2
CENTERS = [(0,0),(6,0),(12,0),(0,6),(6,6),(12,6),(3,12),(9,12)]
X, _ = make_blobs(CENTERS, n_each=75, spread=1.0, seed=42)
lo = [min(c) for c in zip(*X)]; hi = [max(c) for c in zip(*X)]

def box_init(seed, k=8):        # k random points anywhere in the bounding box
    rng = random.Random(seed)
    return [tuple(rng.uniform(a, b) for a, b in zip(lo, hi)) for _ in range(k)]

print("mean([]) =", mean([]), "  d2((3, 4), ()) =", d2((3.0, 4.0), ()))

def naive(C, k=8):              # textbook loop, no empty-cluster handling
    for it in range(1, 301):
        labels = [min(range(k), key=lambda j: d2(x, C[j])) for x in X]
        newC = [mean([x for x, l in zip(X, labels) if l == j]) for j in range(k)]
        if newC == C: break
        C = newC
    return C, it
…
mean([]) = ()   d2((3, 4), ()) = 0
naive: no exception, ghost centroid in 36 of 200 runs
  iterations of those runs: [300] | real centroids left: [1]
with reseeding: 36 runs needed a fix, 101 of 200 reached inertia 1170.9
zip(*[]) は何も返さないので、空クラスタの平均は割り算が一度も実行されないまま空タプル () になります。さらに zip(点, ()) も空なので、すべての点からこの「幽霊重心」までの距離が0 になります。次の反復で幽霊が600点すべてを吸い込み、他の重心が空になって次々と幽霊になり、300回の上限まで状態を行き来し続けました。影響を受けた36回すべてで、まともな重心は1つしか残りませんでした。例外は一度も出ていません。NumPy で書けば症状は別で、空配列の平均は警告付きの nan になります(今回は実行していません)。どちらにしても、空クラスタは明示的に処理すべきです。
修復方法を2つ、空クラスタが出たこの36回で比べました。
| 処理 | 空クラスタが出た36回での結果 |
|---|---|
| 何もしない(素朴なループ) | 例外なし。幽霊重心、300回反復、実重心は1つ |
| 空の重心を捨てる | 収束はするが k が 6 か 7 に減る。イナーシャ中央値 2,422.2 |
| 自分の重心から最も遠い点へ移す | k = 8 を維持。イナーシャ中央値 1,170.9(最良) |
kmeans.py は3つ目の方法を採っています。イナーシャを最も稼いでいる点に重心を回すので、理にかなっています。黙って重心を捨てる方法は、指定した k がいつの間にか変わっているので、エラーより始末が悪いと言えます。意外だったのは、修復付きなら範囲内ランダム初期化が200回中101回で最良に届き、データ点ランダム(79回)より良かったことです。ただ、データ1種類での結果なので一般化はしません。k-means++ が一番良いという順位は、今回のどの比較でも変わりませんでした。
失敗その3:特徴量のスケールがそろっていない
k-means はただのユークリッド距離を使うので、数値の幅が大きい特徴量が勝ってしまいます。アプリのユーザー600人を想定し、「1回の利用時間」(2分台と8分台の2グループ、σ 0.7)という本物の違いと、「ダウンロードバイト数」(平均50,000、σ 15,000、グループと無関係なノイズ)という2列を作りました。
def ari(a, b):                         # adjusted Rand index, stdlib only
    c2 = lambda n: n * (n - 1) / 2
    nij = sum(c2(v) for v in Counter(zip(a, b)).values())
    ai = sum(c2(v) for v in Counter(a).values())
    bj = sum(c2(v) for v in Counter(b).values())
    exp = ai * bj / c2(len(a))
    return (nij - exp) / ((ai + bj) / 2 - exp)

rng = random.Random(7)
X, y = [], []
for label, minutes in enumerate((2.0, 8.0)):    # two real user groups
    for _ in range(300):
        X.append((rng.gauss(minutes, 0.7),       # session minutes: the signal
                  rng.gauss(50000, 15000)))      # bytes downloaded: pure noise
        y.append(label)

def zscore(X):
    cols = list(zip(*X))
    mu = [st.mean(c) for c in cols]; sd = [st.pstdev(c) for c in cols]
    return [tuple((v - m) / s for v, m, s in zip(x, mu, sd)) for x in X]
…
     raw: ARI vs truth -0.001  sizes [247, 353]
 z-score: ARI vs truth 0.005  sizes [248, 352]
--- 50 seeds each ---
     raw: ARI>0.9 in 0/50 seeds, lowest-inertia run ARI -0.001
 z-score: ARI>0.9 in 46/50 seeds, lowest-inertia run ARI 1.000
     raw: inertia of true groups 1.394e+11, k-means best 5.423e+10
 z-score: inertia of true groups 630.7, k-means best 630.7
ARI(調整ランド指数)は本当のグループと完全一致で1、でたらめな分け方で0前後になる指標です。生データでは50シードすべてで ノイズの列を真っ二つにしただけ でした。最後の2行が理由で、生データの上では本当のグループ分けのほうがイナーシャが2.6倍大きいのです。つまり k-means は目的関数を正しく最小化していて、目的関数のほうが間違っていた ことになります。何回やり直しても直りません。
列ごとに標準化(zスコア)すると、本当の分け方が全体の最小になります。ただし1行目に注目してください。シード0は標準化後でもノイズ側に割れていました(ARI 0.005)。50シード中46回が正解で、イナーシャ最小の回を採れば正解が選ばれます。スケーリングとやり直しは別々の問題を解いているので、両方必要です。また、標準化はノイズしかない列にもシグナル列と同じ重みを与えます。今回はシグナルが強かったので助かりましたが、ノイズ列が5本あったらどうなるかは分かりません。その場合に必要なのは k-means の調整ではなく特徴量選びです。
k の決め方:エルボー法とシルエット係数
イナーシャは k を増やせば必ず下がるので、最小値で k は選べません。よく使う目安は2つです。
- エルボー法:k ごとのイナーシャを並べ、それ以上増やしても下がり方が鈍る「肘」を探す
- シルエット係数:各点について、同じクラスタの他の点までの平均距離 a と、最も近い別クラスタまでの平均距離 b から s = (b − a) / max(a, b) を計算し、全点で平均する。−1〜1で、高いほどまとまりが良く分離もはっきりしている
def silhouette(X, labels):
    k = max(labels) + 1
    total = 0.0
    for i, x in enumerate(X):
        sums, cnt = [0.0] * k, [0] * k
        for p, l in zip(X, labels):
            sums[l] += math.dist(x, p); cnt[l] += 1
        own = labels[i]
        if cnt[own] == 1:
            continue                      # singleton: s = 0 by convention
        a = sums[own] / (cnt[own] - 1)    # distance to itself is 0, not counted
        b = min(sums[j] / cnt[j] for j in range(k) if j != own and cnt[j])
        total += (b - a) / max(a, b)
    return total / len(X)

for k in range(2, 11):
    best = min((kmeans(X, k, seed=s) for s in range(10)), key=lambda r: r[2])
    …
k= 2 inertia  16057.9 drop         silhouette 0.357
k= 3 inertia   8662.2 drop  46.1%  silhouette 0.437
…
k= 7 inertia   2319.1 drop  36.3%  silhouette 0.584
k= 8 inertia   1170.9 drop  49.5%  silhouette 0.661
k= 9 inertia   1102.9 drop   5.8%  silhouette 0.619
k=10 inertia   1049.7 drop   4.8%  silhouette 0.567
2.3s
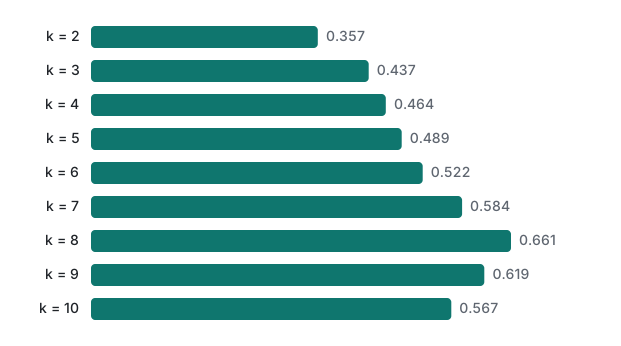
このデータでは両者の意見が一致しました。7→8でイナーシャが49.5%減り、8→9では5.8%しか減らないので肘は8。シルエットも k = 8 の 0.661 が最高です。シルエットは k ごとに O(n²) の距離計算が要ります。600点なら k = 2〜10 のクラスタリング込みで2.3秒ですが、5万点になると重くなります。
次に、他は同じまま塊の広がりを σ = 2.0 にしました。
k= 2 inertia  18150.6 drop         silhouette 0.344
k= 3 inertia  10271.1 drop  43.4%  silhouette 0.407
k= 4 inertia   7917.2 drop  22.9%  silhouette 0.377
…
k= 8 inertia   3468.8 drop  17.2%  silhouette 0.399
k= 9 inertia   3174.6 drop   8.5%  silhouette 0.390
k=10 inertia   2908.6 drop   8.4%  silhouette 0.373
生成元は相変わらず8つの塊なのに、シルエットは k = 3(0.407)を選び、減少率も23%、22%、20%、16%、17%とだらだら続いて肘が見えません。ここまで重なると、2つの指標が測っているのは「分け方の分離の良さ」であって「元の塊の数」ではありません。実務では、この2つで候補を2〜3個に絞り、最後はクラスタの中身を見て決めるのが現実的です。
おまけ:このブログ自身の記事をクラスタリングする
きれいな塊ではない実データとして、このブログの英語記事86本(content/en/*.md、この連載を追加する前のスナップショット)を使いました。各記事を単語の出現回数ベクトル(bag of words)にして長さ1に正規化します。単位ベクトル同士ではユークリッド距離の2乗 = 2 − 2·cos なので、最寄り重心への割り当てはほぼコサイン類似度で決まります。k はフロントマターの category の種類数と同じ9にし、k-means++ を20シード回してイナーシャ最小の結果を採りました。
def load(folder, drop_code):
    docs = []
    for f in sorted(Path(folder).glob("*.md")):
        text = f.read_text(encoding="utf-8")
        _, fm, body = text.split("---", 2)
        cat = re.search(r"^category:\s*([\w-]+)", fm, re.M).group(1)
        if drop_code:
            body = re.sub(r"```.*?```", " ", body, flags=re.S)
        words = [w for w in re.findall(r"[a-z][a-z0-9+#]{2,}", body.lower()) if w not in STOP]
        docs.append((f.stem, cat, Counter(words)))
    return docs

def vectors(docs, idf):
    N = len(docs)
    df = Counter(w for _, _, c in docs for w in c)
    vocab = sorted(w for w, n in df.items() if 2 <= n <= N // 2)
    vecs = []
    for _, _, c in docs:
        v = [c[w] * (math.log(N / df[w]) if idf else 1.0) for w in vocab]
        norm = math.sqrt(sum(x * x for x in v)) or 1.0
        vecs.append(tuple(x / norm for x in v))      # unit length -> cosine
    return vecs, len(vocab)
…
code kept    idf=False docs=86 vocab=3521 k=9 ARI=0.387 purity=0.779 (18.6s)
code kept    idf=True  docs=86 vocab=3521 k=9 ARI=0.380 purity=0.756 (15.4s)
code dropped idf=False docs=86 vocab=3195 k=9 ARI=0.331 purity=0.791 (17.0s)
code dropped idf=True  docs=86 vocab=3195 k=9 ARI=0.361 purity=0.744 (13.4s)
純度(purity)は各クラスタの多数派カテゴリを「正解」とみなした割合で、全記事を1つにまとめるだけでも 37/86 = 0.43 になります(C# 記事が37本あるため)。正直にまとめると、カテゴリとの一致は中程度(ARI 0.33〜0.39) です。IDF 重み付けやコードブロック除去も一貫した改善にはなりませんでした。1つ目の設定で20シードの ARI は0.17〜0.45とばらつき、イナーシャ最小の回(0.387)が一番カテゴリに近い回でもありませんでした。イナーシャは、私たちのカテゴリ分けを知らないからです。
イナーシャ最小の回で何が同じクラスタに入ったかを抜粋します。
| クラスタ | 本数 | 中身のカテゴリ | 例 |
|---|---|---|---|
| A | 18 | csharp 17, algorithm 1 | csharp-linq-basics, csharp-generics, …, algorithm-sorting |
| B | 16 | server 6, app-ops 4, web 3, flutter 2, ai 1 | mysql-max-connections-per-hour-shared-hosting, flutter-migration-16-apps-what-broke, … |
| C | 12 | csharp 12 | csharp-class, csharp-interface, csharp-event, … |
| D | 9 | regex 9 | 正規表現の記事9本だけ |
| E | 9 | algorithm 9 | data-structure-heap, data-structure-tree, … |
| F | 7 | winapi 5, csharp 1, algorithm 1 | winapi-sendmessage, csharp-registry, algorithm-binary-search |
| G | 7 | csharp 5, winapi 1, algorithm 1 | winforms-modal-modeless-form, csharp-file-io, … |
| H | 5 | algorithm 3, csharp 2 | csharp-collection-basics, data-structure-linked-queue, … |
| I | 3 | server 1, web 1, ai 1 | og-image-cards-pillow-cjk-line-breaking, hosting-account-migration-what-broke, … |
「間違い」のいくつかは、むしろ私たちのカテゴリより筋が通っています。C# の37本は「文法と LINQ」(A)と「オブジェクト指向の機能」(C)に分かれました。WinForms の記事はカテゴリ上 csharp ですが、ウィンドウ操作という語彙で Win32 の記事と同じ側(F、G)に寄りました。キューやコレクションの記事(H)は、言語が違っても語彙が共通です。逆に、サーバー・アプリ運用・Web・Flutter の16本(B)は語彙がほとんど重なるため、1つの塊になってしまいました。これはナイーブベイズの回で、ラベルを使って学習しても小さい4カテゴリが12本中0本しか当たらなかったのと同じ構図です。カテゴリを当てたいなら分類器を学習させるべきで、k-means は「ラベルが隠している構造」を安く覗くための道具だと考えるのがよさそうです。
k-means を使うべき場面、使わないほうがいい場面
| 状況 | 選ぶもの | 理由 |
|---|---|---|
| 丸くて大きさが近いクラスタ、数値特徴量、k が分かるか候補を絞れる | k-means(k-means++、複数回実行) | 速く単純で、結果の重心を説明しやすい |
| リング状・三日月状・細長いクラスタ | DBSCAN、HDBSCAN、スペクトラルクラスタリング | k-means は重心の中間に直線の境界を引くので、曲がった形を切ってしまう |
| 除けない外れ値が多い | k-medoids(PAM)、DBSCAN(ノイズとして扱える) | 平均は極端な1点に引っ張られるが、メドイドは引っ張られない |
| k が分からず密度もばらばら | HDBSCAN | 密度からクラスタ数を決める |
| クラスタごとに広がりや大きさが大きく違う | 混合ガウスモデル(GMM) | k-means は同じ丸い広がりを前提にする。GMM はクラスタごとの形を学習する |
| 「A に70%、B に30%」のような所属度が欲しい | 混合ガウスモデル、ファジィ c-means | k-means は必ずどれか1つに割り当てる |
| 国・プラン・OS などカテゴリ列 | k-modes、k-prototypes | カテゴリの番号の平均には意味がない |
| 数百万行 | ミニバッチ k-means | 毎回全点ではなくサンプルで更新する |
| テキスト | TF-IDF や埋め込みに対する球面 k-means、トピックモデル | ベクトルの長さより向きが大事 |
代替手法はここで名前を挙げただけで、本記事では実装も計測もしていません。
正直な限界
- 合成データは1種類だけ。 79回対127回という差は、σ = 1.0 の8つの塊という今回の条件での数字です。塊が少なく離れていればランダム初期化でもかなり当たりますし、近い塊が多ければどちらも悪化します。「k-means++ は平均的に良いが、それでも失敗する」という傾向は広く知られていますが、比率そのものは今回限りの値です。
- 収束判定は重心タプルの完全一致(
newC == C)です。この規模では浮動小数点でもちゃんと止まりますが、本番では移動量がしきい値以下で止めるべきで、max_iterは安全網です。 - 空クラスタの修復は単純です。 同じ反復で2つ空になると、両方が同じ「最も遠い点」へ行きます。今回は一度も起きていませんが、堅牢にするなら別々の点を選ぶ必要があります。
- 純 Python は遅いです。 86記事(3,521次元の密ベクトル)で1回あたり約0.9秒、シルエットは O(n²) です。仕組みを理解するためのコードで、実データには疎ベクトル対応のライブラリを使ってください。
- ブログ記事の実験は小さく、人が付けたラベルが基準です。 86本、カテゴリごとに2〜37本しかないので、1本動くだけで ARI が目に見えて変わります。それに「カテゴリと一致する」ことは「良いクラスタ」と同じではありません。上の F と G がその例です。
- エルボー法とシルエットは目安です。 σ = 2.0 では、8つの塊から作ったデータにシルエットが k = 3 を選びました。どちらもクラスタの中身を見る作業の代わりにはなりません。
次回: 同じ86記事を、今度はラベル付きで分類するナイーブベイズ分類器です。比較回数や反復回数を数えるスタイルが気に入った方は、C で計測したソートアルゴリズムの比較もどうぞ。
よくある質問
k-means の結果が実行するたびに変わるのはなぜですか?
k-means が見つけるのは局所解で、どの解に落ちるかは初期重心で決まるからです。8つの塊からなる600点で試すと、データ点をランダムに選ぶ初期化で最良のイナーシャ(1,170.9)に届いたのは200シード中79回、終わり方は81通りありました。k-means++ では200回中127回です。10回実行して最良を取れば、どちらの方法でも20グループ中20グループで最良解に届きました。
クラスタが空になったらどうすればよいですか?
放置せずに修復します。たとえば、その重心を「自分の重心から最も遠い点」へ移します。Python では空リストの平均がエラーにならず空タプルを返すことがあり、今回の実験ではその「幽霊重心」が200回中36回で全点を吸い込み、300回の上限まで収束しませんでした。
k はどうやって決めればよいですか?
k を変えながらイナーシャ(エルボー法)と平均シルエット係数を計算し、両方を見ます。塊がはっきり分かれたデータではどちらも正解の k = 8 を示しました(シルエット 0.661)。塊を広げると肘が消え、シルエットは k = 3 を選んだので、どちらも目安として扱うべきです。