文字列の「長さ」は言語で違う:絵文字・書記素・バイトを8言語で実測
𠮷野家・ガイド・👍🏽・👨👩👧 の長さを Python・JS・Swift・Dart・Java・C#・PHP・SQLite で実測。絵文字を壊す切り詰めバグと DB の文字数制限も。
シリーズ:文字コード講座 5/6(上級)。 ユーザー入力の文字数チェック、切り詰め、DB 保存を書いていて、「10文字まで」が層ごとに違う意味になって困った人向けです。読み終えると、各言語の API がどの「長さ」を返すのか、絵文字を壊さずに文字列を切る方法、画面・DB・通信のそれぞれでどの数え方を使うべきかが分かります。
問い合わせフォームで「お名前は10文字以内」にしたら、ブラウザでは通った名前が API で弾かれた。プッシュ通知のプレビューが「?」で終わっていた。「続きを読む…」で切ったら家族の絵文字が夫婦になっていた。こうした不具合の原因はひとつで、文字列の長さはひとつではありません。UTF-8 のバイト数、UTF-16 のコード単位数、コードポイント数、書記素クラスタ数の4つがあり、言語ごとに既定の「長さ」が違います。この記事では同じ文字列を Python・JavaScript・Swift・Dart・Java・C#・PHP・SQLite に通し、すべての数字を実行結果から取りました。
実行環境:Apple Silicon Mac(M1 Pro)、macOS 26.6、Python 3.9.6(Unicode 13.0 のデータベース)、macOS 付属の JavaScriptCore jsc、Swift 6.4.2、Dart 3.11.5、OpenJDK 26、.NET 10.0.403(C#)、PHP 8.5.6 + intl(ICU 78.3)、SQLite 3.51.0。Node.js・ブラウザ・MySQL・Windows は動かしていません。
ひとつの文字列に4つの「長さ」
第1回で文字・コードポイント・バイトを分けました。言語を比べるにはもう1層必要です。JavaScript や Java は内部で UTF-16 を使うからです。
- UTF-8 のバイト数:ファイルや通信で実際に流れる量。PHP の
strlen、Swift のutf8.count、SQLite のoctet_length()。 - UTF-16 のコード単位数:16ビット単位。U+FFFF を超える文字(ほとんどの絵文字、𠮷 のような CJK 統合漢字拡張 B の漢字)は2単位必要で、これをサロゲートペアと呼びます。JavaScript の
.length、Java のlength()、C# のLength、Dart の.length。 - コードポイント数:Unicode の番号が付いた文字(
U+00E9)の数。Python のlen()、PHP のmb_strlen、SQLite のlength()。 - 書記素クラスタ数:人間が「1文字」と思う単位。国旗は2コードポイント、👍🏽 は親指と肌の色の修飾子、👨👩👧 は3人を見えない ZERO WIDTH JOINER(U+200D)2つでつないだものです。Unicode ではこれを拡張書記素クラスタ(UAX #29)と定義しています。
大きな表:14 の文字列を実測
エディタが勝手に正規化しないよう、どの言語でも文字列はエスケープ("é"、"\u{1F468}…")で書きました。同じ単位を返す API 同士は完全に一致したので、列は単位ごとにまとめています。
| 文字列(コードポイント) | UTF-8 バイト | UTF-16 単位 | コードポイント | 書記素 |
|---|---|---|---|---|
| é NFC(U+00E9) | 2 | 1 | 1 | 1 |
| é NFD(U+0065 U+0301) | 3 | 2 | 2 | 1 |
| 한 NFC(U+D55C) | 3 | 1 | 1 | 1 |
| 한 NFD(字母3つ) | 9 | 3 | 3 | 1 |
| 👍 | 4 | 2 | 1 | 1 |
| 👍🏽(親指 + 肌の色) | 8 | 4 | 2 | 1 |
| 👨👩👧(3人 + ZWJ 2つ) | 18 | 8 | 5 | 1 |
| 🇯🇵(地域指示記号2つ) | 8 | 4 | 2 | 1 |
| 𠮷(U+20BB7) | 4 | 2 | 1 | 1 |
| ガ NFD(カ + U+3099) | 6 | 2 | 2 | 1 |
| año | 4 | 3 | 3 | 3 |
| 文字化け | 12 | 4 | 4 | 4 |
| 한글 | 6 | 2 | 2 | 2 |
| café | 5 | 4 | 4 | 4 |
日本語の現場でよく出てくる文字列も測りました。
| 文字列 | UTF-8 バイト | UTF-16 単位 | コードポイント | 書記素 |
|---|---|---|---|---|
| 𠮷野家(つちよし) | 10 | 4 | 3 | 3 |
| ガイド(半角カナ) | 15 | 5 | 5 | 3 |
| ガ(Mac のファイル名で多い NFD) | 6 | 2 | 2 | 1 |
𠮷野家 は人の目には3文字、Python でも3文字、JavaScript では4文字です。しかも 𠮷 は CP932(Windows の Shift_JIS)にも JIS X 0213 系の Shift_JIS_2004 にも存在せず(Python の codec で確認)、encode('cp932', errors='replace') は b'?\x96\xec\x89\xc6'、つまり「?野家」を返しました。基幹システムに渡した時点で名前が変わります(変換の話は第2回)。半角カナの濁点 ゙(U+FF9E)は独立したコードポイントですが、書記素としては前の カ にくっつくため、ガイド は書記素で3、コードポイントで5です。NFKC で全角にすると ガイド の3コードポイントになります(第3回)。
どの API がどの単位を返すか
| 言語 | UTF-8 バイト | UTF-16 単位 | コードポイント | 書記素 |
|---|---|---|---|---|
| Python 3.9 | len(s.encode()) |
len(s.encode('utf-16-le'))//2 |
len(s) |
標準ライブラリになし |
| JavaScript(jsc) | jsc に TextEncoder なし |
s.length |
[...s].length |
Intl.Segmenter |
| Swift | s.utf8.count |
s.utf16.count |
s.unicodeScalars.count |
s.count |
| Dart | (utf8.encode) |
s.length |
s.runes.length |
コアになし |
| Java 26 | getBytes(UTF_8).length |
s.length() |
codePointCount |
BreakIterator、正規表現 \X |
| C#(.NET 10) | Encoding.UTF8.GetByteCount |
s.Length |
EnumerateRunes().Count() |
StringInfo.LengthInTextElements |
| PHP 8.5 | strlen |
— | mb_strlen |
grapheme_strlen |
| SQLite 3.51 | octet_length() |
— | length() |
なし |
表に入りきらない、実際に確かめた点です。
- この jsc には
Intl.Segmenterがある(typeof Intl.Segmenterはfunction)。一方TextEncoderはundefinedで、jsc でバイト数を出すには自前のループが要ります。 - Python 3.9 には書記素の機能がない:
re.compile(r'\X')はre.error: bad escape \X at position 0で失敗します。外部のregexモジュールなら\Xが使えますが、今回は何もインストールしていません。 - Swift は比較も書記素単位:
"\u{00E9}" == "e\u{0301}"は Swift でtrue、Dart でfalse、C# の==でFalseでした。C# でもstring.Compare(..., StringComparison.InvariantCulture)は0(等しい)を返しました。 - PHP の
mb_strwidthは第5の答え:全角を2桁と数えるので、文字化けは 8、ガイドは 5 でした。帳票や固定長ファイルの桁合わせ用で、入力制限に使うものではありません。
切り詰めバグを実際に起こす
数え間違いは不便で済みますが、切り間違いはデータを壊します。各言語の既定の単位で切るとこうなりました。
JavaScript:サロゲートの片割れ。 "OK👍".slice(0, 3) はサロゲートペアの前半だけを残します。
"OK\ud83d" 3 false OK�
URIError: String contained an illegal UTF-16 sequence.
出力は順に JSON.stringify(cut)、cut.length、cut.isWellFormed()、cut.toWellFormed() です。壊れていても JS の文字列としては有効なので、外に出す瞬間まで何も起きません。encodeURIComponent で初めて上の URIError が出ます。「絵文字を入れた人だけ検索が落ちる」不具合の正体です。
JavaScript その2:家族から子どもが消える。 家族の絵文字を5コード単位で切ると "👨👩" になります。エラーは出ず、意味だけが変わります。コードポイントで切っても([...s].slice(0, 3))同じ2人です。安全なのは書記素で切る方法だけです。
const seg = new Intl.Segmenter("ja", {granularity: "grapheme"});
function truncate(str, n) {
let out = "", i = 0;
for (const {segment} of seg.segment(str)) {
if (i++ === n) return out + "…";
out += segment;
}
return out;
}
print(truncate("家族\u{1F468}\u{1F469}\u{1F467}旅行", 3)); // 家族👨👩👧…
Java と C#:半分の絵文字は出口で ? か � になる。 Java の "OK👍".substring(0, 3) を UTF-8 にすると 4f 4b 3f で、DB には半角の「?」が届きます。C# の Substring(0, 3) は 4F4BEFBFBD、つまり U+FFFD(�)でした。厳格なエンコーダ(new UTF8Encoding(false, true))なら .NET は例外を投げます。
EncoderFallbackException: Unable to translate Unicode character \\uD83D at index 2 to specified code page.
Java ではコードポイント境界(s.offsetByCodePoints(0, n))か、できれば BreakIterator の境界で切ります。C# では new StringInfo(s).SubstringByTextElements(0, 3) が 가족👨👩👧 を丸ごと返しました。
Python と PHP:バイトで切る。 本当に痛いのはバイト制限です。プロトコルやカラムはバイトで測るからです。Python では:
>>> "文字化け".encode()[:10].decode()
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xe3 in position 9: unexpected end of data
errors="ignore" を付けると途中の文字が落ちて 文字化 になり、直ったように見えます。ところが "OK👍🏽" を7バイトで切ると OK👍 になりました。肌の色の修飾子が黙って消え、ユーザーの絵文字が変わっています。PHP では substr("한글 깨짐", 0, 4) がバイト列 ed959cea を返し、それを json_encode すると false(Malformed UTF-8 characters, possibly incorrectly encoded)。API の応答が丸ごと空になるのはこのパターンです。mb_substr はコードポイントで切るので、mb_substr("가족👨👩👧", 0, 4) は末尾に ZWJ がぶら下がりました(…f09f91a8e2808d)。
PHP の intl にはちょうどいい関数があります。grapheme_extract に GRAPHEME_EXTR_MAXBYTES を渡すと、N バイトに収まる範囲で書記素単位の最長の先頭部分を返します。
$s = "가족👨👩👧!"; // 6 + 18 + 1 = 25 バイト
foreach ([23, 24] as $max) {
$next = 0;
var_dump(grapheme_extract($s, $max, GRAPHEME_EXTR_MAXBYTES, 0, $next), $next);
}
// string(6) "가족" int(6) (家族は24バイト必要)
// string(24) "가족👨👩👧" int(24)
よくある間違い:同じ「最大文字数」を3つの層で別々に数える
間違い。 仕様は「表示名は10文字まで」。フォームは value.length <= 10(UTF-16)、API は len(name) <= 10(コードポイント)、カラムは VARCHAR(10)。
実際に起きること。 𠮷野家 はフォームでは4、API では3です。国旗を5つ(🇲🇽🇯🇵🇰🇷🇪🇸🇺🇸)並べると、書記素5、コードポイント10、UTF-16 で20になり、見た目5文字なのにフォームが「長すぎます」と言います。API 側で name[:10] と切った名前は ZWJ の途中で終わることがあります。
直し方。 層ごとに意図して決めます。
| 何を制限するか | 数え方 | 理由 |
|---|---|---|
| ユーザーに見える「10文字」 | 書記素 | 画面と一致し、絵文字を割らない |
| バイト予算(カラムのバイト、ヘッダ、通知ペイロード) | UTF-8 バイト、書記素の境界で切る | 制限が物理的 |
MySQL の VARCHAR(n)、SQLite の length() |
コードポイント | DB がそう数える |
| JS・Java・C# の文字列インデックスやカーソル位置 | UTF-16 単位 | API がその単位で添字を取る |
| 帳票や固定長ファイルの桁 | 表示幅(全角 = 2) | mb_strwidth / mb_strimwidth |
サーバーでは最も厳しい制限を守り、UI ではユーザー向けの数え方を表示します。Flutter アプリなら、公式ドキュメントによると TextField.maxLength は書記素クラスタで数え、Android の従来の maxLength フィルタは UTF-16 の char で数えます(どちらもドキュメントからの説明で、今回は実行していません)。
DB のカラム:SQLite は実測、MySQL は説明のみ
SQLite は宣言した長さを飾りとして扱います。
sqlite> create table u(name varchar(5));
sqlite> insert into u values ('abcdefghijklmnop');
sqlite> select name, length(name), octet_length(name) from u;
abcdefghijklmnop|16|16
👨👩👧|5|18
制限が必要なら自分で書きます。ただし length() はコードポイント数です。check (length(name) <= 4) にすると 文字化け は通り、家族の絵文字は画面上1文字なのに CHECK constraint failed: length(name) <= 4 (19) で拒否されました。substr(fam, 1, 2) はバイト列 F09F91A8E2808D、つまり男性 + ぶら下がった ZWJ でした。SQLite は正規化もしないので char(0xe9) = 'e' || char(0x301) は 0 です。
MySQL(今回は実行していません。MySQL リファレンスマニュアルに基づく説明):VARCHAR(n) は文字(コードポイント)を数えます。utf8 という文字セットは utf8mb3 の別名で、1文字最大3バイトしか保存できません。そのため4バイト文字(すべての絵文字と 𠮷)は strict モードでエラー 1366「Incorrect string value」になります。utf8mb4 を使いましょう。MySQL 8.0 からは既定値です。文字数の下にはバイト制限も残っていて、行は 65,535 バイトまで、インデックスのキー長は行フォーマットによって 767 か 3,072 バイトまでです。utf8mb4 の VARCHAR(255) はインデックス上で最大 1,020 バイトになり得ます。クエリ自体は SQL 入門で扱っています。
計測:書記素を数えるコスト
書記素の数え方はタダではありません。文字列を先頭から走査して UAX #29 の規則を当てはめる必要があります。"文字化けcafé한글👍🏽 " を10万回繰り返した文字列(書記素120万、コードポイント130万、UTF-16 150万単位、320万バイト)で、5回の中央値を取りました。
| 言語 | 呼び出し | 結果 | 中央値 |
|---|---|---|---|
| jsc | s.length |
1,500,000 | 0.0 ms |
| jsc | [...s].length |
1,300,000 | 22.1 ms |
| jsc | Intl.Segmenter のループ |
1,200,000 | 84.2 ms |
| PHP 8.5 | strlen |
3,200,000 | 0.00 ms |
| PHP 8.5 | mb_strlen |
1,300,000 | 2.99 ms |
| PHP 8.5 | grapheme_strlen |
1,200,000 | 25.20 ms |
Swift -O |
s.unicodeScalars.count |
1,300,000 | 5.37 ms |
Swift -O |
s.count |
1,200,000 | 17.69 ms |
| Python 3.9 | len(s.encode()) |
3,200,000 | 1.61 ms |
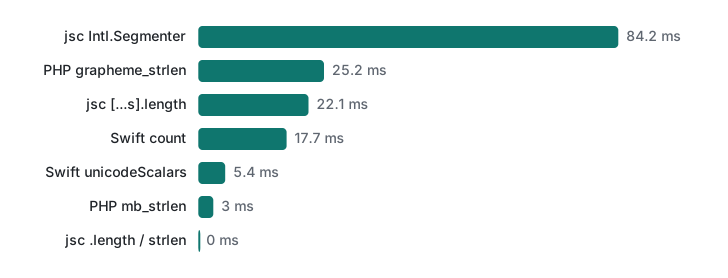
教訓は2つです。保持済みの長さ(.length、strlen、Python の len)は O(1)。書記素の数は O(n) で、jsc の Intl.Segmenter は1書記素あたり約70ns、ICU を使う PHP の grapheme_strlen は約21ns でした。30文字の名前なら誤差ですが、10MB のログをループで回すなら効いてきます。書記素は入力チェックや表示用の切り詰めといった「端」で数え、重いループの中では数えないことです。
正直な限界とバージョンの注意
Intl.Segmenterは ECMA-402(2022年版)の機能です。確認したのはこの macOS の jsc にあることだけです。isWellFormed/toWellFormedは ES2024 で、これもこの jsc にありました。- Java の
BreakIteratorはリリースノートによると JDK 20 から拡張書記素クラスタに従います。確認は 26 のみです。正規表現の\Xは Java 9 からあります。 - .NET の
StringInfoは .NET 5 で拡張書記素クラスタに切り替わりました(文書化された破壊的変更)。実行は .NET 10 です。 grapheme_strlenの結果は PHP に組み込まれた ICU のバージョン(今回は 78.3)に依存します。古い ICU では新しい絵文字の区切りが変わることがあります。Python 3.9 のunicodedataは Unicode 13.0 で、ICU 78 より古いデータです。- Dart で書記素を扱うのは
charactersパッケージ(Flutter が使っているもの)ですが、何もインストールできないため今回は実行していません。 - MySQL・Node.js・ブラウザ・Android は動かしておらず、上の説明はそれぞれのドキュメントに基づきます。
練習問題
1. 予想してから確かめてください。日本の国旗 🇯🇵 ではなく韓国の国旗 🇰🇷 について、JS の .length、Python の len、Swift の count、PHP の strlen はいくつか。
2. 書記素を絶対に割らない PHP 関数 cut_for_column(string $s, int $maxBytes): string を書き、"가족👨👩👧!" に 23 と 24 で試してください。
解答
1. 実測で 4、2、1、8。4バイト・2単位のコードポイント(地域指示記号 U+1F1F0 と U+1F1F7)2つで、1つの書記素になります。
2. function cut_for_column(string $s, int $maxBytes): string { $next = 0; return grapheme_extract($s, $maxBytes, GRAPHEME_EXTR_MAXBYTES, 0, $next) ?: ""; } は、23 で 가족(6バイト)、24 で24バイトの 가족👨👩👧 を返しました(上の実行結果のとおり)。?: "" は、入力が正しい UTF-8 でないときに grapheme_extract が返す false への備えです。
次回
最終回は、古いシステムからのデータ取り込みで必ず出てくる疑問を扱います。エンコーディングの宣言がないファイルを、プログラムは推測できるのか。当たる確率、変換の速さを測り、第1回で触れた「チャンク境界で文字が割れる」バグを直します。
よくある質問
JavaScript で「𠮷野家」の length が 4 になるのはなぜですか?
.length は UTF-16 のコード単位を数えるためです。𠮷(U+20BB7)は BMP の外にあるのでサロゲートペア2単位になり、𠮷野家 は 4 になります。[...s].length はコードポイント数で 3、Intl.Segmenter は見た目の文字数で 3 でした(macOS 26 の JavaScriptCore で実測)。
見た目どおりの文字数を数えるにはどうすればいいですか?
拡張書記素クラスタを数えます。Swift の String.count、JavaScript の Intl.Segmenter、Java の BreakIterator と正規表現 \X、C# の StringInfo.LengthInTextElements、PHP の grapheme_strlen は、👨👩👧 と 🇯🇵 をどれも 1 と数えました。Python 3.9 の標準ライブラリと Dart のコアには書記素の API がありません。
半角カナの「ガイド」は何文字ですか?
数え方次第です。コードポイントでは 5(濁点 ゙ が独立した文字)、UTF-8 では 15 バイト、書記素では 3 でした。濁点 U+FF9E は前の文字にくっつく扱いなので、grapheme_strlen や Intl.Segmenter は ガ を1文字と数えます。NFKC で全角にすると ガイド の 3 コードポイントになります。