Longitud de strings en 8 lenguajes: emoji y grafemas
Cuánto mide «José Muñoz», 👍🏽, 👨👩👧 o 🇲🇽 en Python, JS, Swift, Dart, Java, C#, PHP y SQLite, medido, con bugs al recortar y límites de columnas.
Serie: curso de texto y codificación 5/6 (avanzado). Para quien valida, recorta o guarda texto de usuarios y descubrió que un "máximo de 10 caracteres" significa algo distinto en cada capa. Al terminar vas a saber cuál de las cuatro "longitudes" devuelve cada API, cómo cortar un string sin romper un emoji y qué conteo usar en la interfaz, en la base de datos y en un protocolo.
Esta clase es para ti si el formulario de registro aceptó mia_🇲🇽🌮 y la API lo rechazó, si una notificación push terminaba en ?, o si un "Leer más…" convirtió a la familia del emoji en una pareja. La respuesta corta: un string no tiene una sola longitud. Tiene bytes UTF-8, unidades de código UTF-16, puntos de código y grupos de grafemas, y cada lenguaje elige uno como su "length" por defecto. Aquí pasamos los mismos strings por Python, JavaScript, Swift, Dart, Java, C#, PHP y SQLite, y cada número sale de una ejecución real.
Entorno de todas las salidas: Mac con Apple Silicon (M1 Pro), macOS 26.6, Python 3.9.6 (base de datos Unicode 13.0), JavaScriptCore jsc de macOS, Swift 6.4.2, Dart 3.11.5, OpenJDK 26, .NET 10.0.403 (C#), PHP 8.5.6 con intl (ICU 78.3) y SQLite 3.51.0. No se ejecutaron Node.js, navegadores, MySQL ni Windows.
Las cuatro "longitudes" de un string
En la clase 1 separamos caracteres, puntos de código y bytes. Para comparar lenguajes hace falta una capa más, porque JavaScript y Java guardan el texto en UTF-16:
- Bytes UTF-8: lo que viaja por la red y se guarda en disco.
strlende PHP,utf8.countde Swift,octet_length()de SQLite. - Unidades de código UTF-16: bloques de 16 bits. Los caracteres por encima de U+FFFF (casi todos los emoji, CJK poco común) necesitan dos, y a esa pareja se le llama par sustituto (surrogate pair).
.lengthde JavaScript,length()de Java,Lengthde C#,.lengthde Dart. - Puntos de código: los caracteres numerados de Unicode (
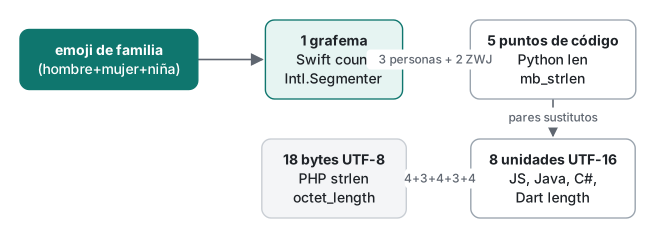
U+00F1es ñ).len()de Python,mb_strlende PHP,length()de SQLite. - Grupos de grafemas: lo que una persona llama "una letra". Una bandera son dos puntos de código, 👍🏽 es un pulgar más un modificador de tono de piel, y 👨👩👧 son tres personas unidas por dos ZERO WIDTH JOINER (U+200D) invisibles. Una ñ en NFD (n + tilde combinable) también es un solo grafema. Unicode lo define como extended grapheme cluster (UAX #29).
La gran tabla: 14 strings medidos
En cada lenguaje escribimos los strings con escapes ("ñ", "\u{1F468}…") para que ningún editor los normalizara. Dentro de cada unidad, todas las API coincidieron exactamente; la tabla siguiente dice qué API alimentó cada columna.
| String (puntos de código) | Bytes UTF-8 | Unidades UTF-16 | Puntos de código | Grafemas |
|---|---|---|---|---|
| é NFC (U+00E9) | 2 | 1 | 1 | 1 |
| é NFD (U+0065 U+0301) | 3 | 2 | 2 | 1 |
| 한 NFC (U+D55C) | 3 | 1 | 1 | 1 |
| 한 NFD (3 jamo) | 9 | 3 | 3 | 1 |
| 👍 | 4 | 2 | 1 | 1 |
| 👍🏽 (pulgar + tono de piel) | 8 | 4 | 2 | 1 |
| 👨👩👧 (3 personas + 2 ZWJ) | 18 | 8 | 5 | 1 |
| 🇯🇵 (2 indicadores regionales) | 8 | 4 | 2 | 1 |
| 𠮷 (U+20BB7) | 4 | 2 | 1 | 1 |
| ガ NFD (カ + U+3099) | 6 | 2 | 2 | 1 |
| año | 4 | 3 | 3 | 3 |
| 文字化け | 12 | 4 | 4 | 4 |
| 한글 | 6 | 2 | 2 | 2 |
| café | 5 | 4 | 4 | 4 |
Y los strings que de verdad llegan a un formulario en español:
| String | Bytes UTF-8 | Unidades UTF-16 | Puntos de código | Grafemas |
|---|---|---|---|---|
| José Muñoz (NFC, tecleado) | 12 | 10 | 10 | 10 |
| José Muñoz (NFD, copiado de un PDF) | 14 | 12 | 12 | 10 |
| ¿Qué tal, señor? | 19 | 16 | 16 | 16 |
mia_🇲🇽🌮 |
16 | 10 | 7 | 6 |
Las dos versiones de José Muñoz se ven idénticas en pantalla, pero una mide 10 y la otra 12 en Python, y la NFD convertida a Windows-1252 con errors='replace' quedó como b'Jose? Mun?oz': los acentos sueltos no existen en esa codificación. La normalización NFC/NFD se explica en la clase 3. Y mia_🇲🇽🌮 son 6 caracteres para el usuario, 7 para Python, 10 para JavaScript y 16 bytes para la base de datos.
Qué API devuelve qué unidad
| Lenguaje | Bytes UTF-8 | Unidades UTF-16 | Puntos de código | Grafemas |
|---|---|---|---|---|
| Python 3.9 | len(s.encode()) |
len(s.encode('utf-16-le'))//2 |
len(s) |
no hay en la stdlib |
| JavaScript (jsc) | jsc no tiene TextEncoder |
s.length |
[...s].length |
Intl.Segmenter |
| Swift | s.utf8.count |
s.utf16.count |
s.unicodeScalars.count |
s.count |
| Dart | (utf8.encode) |
s.length |
s.runes.length |
no hay en el core |
| Java 26 | getBytes(UTF_8).length |
s.length() |
codePointCount |
BreakIterator, regex \X |
| C# (.NET 10) | Encoding.UTF8.GetByteCount |
s.Length |
EnumerateRunes().Count() |
StringInfo.LengthInTextElements |
| PHP 8.5 | strlen |
— | mb_strlen |
grapheme_strlen |
| SQLite 3.51 | octet_length() |
— | length() |
no hay |
Lo que la tabla no muestra y comprobamos directamente:
- Este jsc sí tiene
Intl.Segmenter(typeof Intl.Segmenterimprimiófunction), pero noTextEncoder(undefined), así que contar bytes en jsc requiere un bucle propio. - Python 3.9 no sabe de grafemas:
re.compile(r'\X')falla conre.error: bad escape \X at position 0. El módulo externoregexsí soporta\X, pero en esta clase no se instaló nada. - Swift también compara por grafemas:
"\u{00E9}" == "e\u{0301}"imprimiótrueen Swift,falseen Dart yFalseen C# con==. En C#,string.Compare(..., StringComparison.InvariantCulture)devolvió0(iguales). - SQLite no sabe de acentos:
upper('José Muñoz')devolvióJOSé MUñOZ, porque suupper()integrado solo convierte ASCII. Si buscas sin distinguir mayúsculas, hazlo en la aplicación o con una extensión ICU.
Bugs al recortar, con salidas reales
Contar mal es molesto; cortar mal corrompe datos. Esto pasa al cortar con la unidad por defecto de cada lenguaje.
JavaScript: un sustituto huérfano. "OK👍".slice(0, 3) conserva solo la primera mitad del par:
"OK\ud83d" 3 false OK�
URIError: String contained an illegal UTF-16 sequence.
Los valores son JSON.stringify(cut), cut.length, cut.isWellFormed() y cut.toWellFormed(). El string roto sigue siendo un string JS válido, así que nada falla hasta que sale del programa: encodeURIComponent lanzó el URIError de arriba. Es el bug de "la búsqueda funciona para todos menos para quien puso un emoji".
JavaScript otra vez: la familia pierde a la hija. Cortar el emoji de familia en 5 unidades da "👨👩": string válido, sin error, con otro significado. Cortar por puntos de código ([...s].slice(0, 3)) deja a las mismas dos personas. Solo cortar por grafemas es seguro:
const seg = new Intl.Segmenter("es", {granularity: "grapheme"});
function truncate(str, n) {
  let out = "", i = 0;
  for (const {segment} of seg.segment(str)) {
    if (i++ === n) return out + "…";
    out += segment;
  }
  return out;
}
print(truncate("Hola \u{1F1F2}\u{1F1FD}!", 6));   // Hola 🇲🇽…
Java y C#: medio emoji se vuelve ? o � al salir. En Java, "OK👍".substring(0, 3) codificado a UTF-8 da 4f 4b 3f, así que a la base de datos le llega un signo de interrogación literal. En C#, Substring(0, 3) se codificó como 4F4BEFBFBD, que es U+FFFD (�). Con un codificador estricto (new UTF8Encoding(false, true)), .NET se niega:
EncoderFallbackException: Unable to translate Unicode character \\uD83D at index 2 to specified code page.
En Java, corta en un límite de punto de código (s.offsetByCodePoints(0, n)) o, mejor, en un límite de BreakIterator; en C#, new StringInfo(s).SubstringByTextElements(0, 3) devolvió 가족👨👩👧 completo.
Python y PHP: cortar bytes. Los límites en bytes son los que más duelen, porque los protocolos y las columnas miden bytes. En Python:
>>> "año".encode()[:2].decode()
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc3 in position 1: unexpected end of data
Con errors="ignore" se descarta el carácter partido y queda a, lo que parece una solución. No lo es: "OK👍🏽" cortado a 7 bytes quedó como OK👍. El modificador de tono de piel desapareció en silencio y el emoji del usuario cambió. En PHP, substr("한글 깨짐", 0, 4) devolvió los bytes ed959cea y json_encode de eso devolvió false con Malformed UTF-8 characters, possibly incorrectly encoded: así es como una respuesta de API entera queda vacía. mb_substr corta por punto de código, así que mb_substr("가족👨👩👧", 0, 4) terminó con un ZWJ colgando (…f09f91a8e2808d).
La extensión intl de PHP tiene la herramienta correcta: grapheme_extract con GRAPHEME_EXTR_MAXBYTES devuelve el tramo más largo de grafemas completos que cabe en N bytes:
$s = "가족👨👩👧!"; // 6 + 18 + 1 = 25 bytes
foreach ([23, 24] as $max) {
$next = 0;
var_dump(grapheme_extract($s, $max, GRAPHEME_EXTR_MAXBYTES, 0, $next), $next);
}
// string(6) "가족" int(6) (la familia necesita 24 bytes)
// string(24) "가족👨👩👧" int(24)
Error común: un "largo máximo" contado en tres capas
El error. La regla de producto dice "nombre visible de hasta 10 caracteres". El formulario web comprueba value.length <= 10 (UTF-16), la API comprueba len(name) <= 10 (puntos de código) y la columna es VARCHAR(10).
Lo que pasa en realidad. Cinco banderas 🇲🇽🇯🇵🇰🇷🇪🇸🇺🇸 son 5 grafemas, 10 puntos de código y 20 unidades UTF-16: el formulario dice "demasiado largo" ante algo que se ve como cinco caracteres. Un "José Muñoz" en NFD cuenta 12 en la API. Y un nombre cortado con name[:10] en la API puede terminar a mitad de una secuencia ZWJ.
Solución. Decide por capa, a propósito:
| Qué limitas | Qué cuentas | Por qué |
|---|---|---|
| Lo que ve el usuario ("10 caracteres") | grafemas | coincide con la pantalla; nunca parte un emoji |
| Un presupuesto en bytes (columna, header, payload de push) | bytes UTF-8, cortando en límites de grafema | el límite es físico |
VARCHAR(n) en MySQL, length() en SQLite |
puntos de código (tras normalizar a NFC) | es lo que cuenta la base de datos |
| Índices de string y posición del cursor en JS, Java, C# | unidades UTF-16 | es lo que indexa la API |
Luego aplica el límite más estricto en el servidor y muestra el del usuario en la interfaz. Si haces apps con Flutter: según su documentación, TextField.maxLength cuenta grupos de grafemas, mientras que el filtro clásico maxLength de Android cuenta chars UTF-16 (ambos descritos según la documentación, no ejecutados aquí).
Columnas de base de datos: SQLite medido, MySQL descrito
SQLite trata el largo declarado como decoración:
sqlite> create table u(name varchar(5));
sqlite> insert into u values ('abcdefghijklmnop');
sqlite> select name, length(name), octet_length(name) from u;
abcdefghijklmnop|16|16
👨👩👧|5|18
Si necesitas un límite, escríbelo tú, y recuerda que length() cuenta puntos de código: con check (length(name) <= 4), 文字化け se aceptó y el emoji de familia se rechazó con CHECK constraint failed: length(name) <= 4 (19), aunque en pantalla sea un solo carácter. substr(fam, 1, 2) devolvió los bytes F09F91A8E2808D: un hombre más un unificador colgando. SQLite tampoco normaliza: char(0xe9) = 'e' || char(0x301) devolvió 0. Lo básico de las consultas está en el curso de SQL.
MySQL (no se ejecutó aquí; según el manual de referencia de MySQL): VARCHAR(n) cuenta caracteres (puntos de código), no bytes. El charset llamado utf8 es un alias de utf8mb3, que guarda como máximo 3 bytes por carácter, así que cualquier carácter de 4 bytes (todos los emoji, y 𠮷) se rechaza en modo estricto con el error 1366 "Incorrect string value". Usa utf8mb4, el valor por defecto desde MySQL 8.0. Por debajo del límite en caracteres siguen existiendo límites en bytes: una fila admite hasta 65,535 bytes y la clave de un índice tiene un tope en bytes (767 o 3,072 según el formato de fila), así que un VARCHAR(255) en utf8mb4 puede necesitar hasta 1,020 bytes en un índice.
Medición: cuánto cuesta contar grafemas
Contar grafemas no es gratis: hay que recorrer el string aplicando las reglas de UAX #29. Repetimos "文字化けcafé한글👍🏽 " 100,000 veces (1,200,000 grafemas, 1,300,000 puntos de código, 1,500,000 unidades UTF-16, 3,200,000 bytes) y tomamos la mediana de 5 ejecuciones:
| Lenguaje | Llamada | Resultado | Mediana |
|---|---|---|---|
| jsc | s.length |
1,500,000 | 0.0 ms |
| jsc | [...s].length |
1,300,000 | 22.1 ms |
| jsc | bucle con Intl.Segmenter |
1,200,000 | 84.2 ms |
| PHP 8.5 | strlen |
3,200,000 | 0.00 ms |
| PHP 8.5 | mb_strlen |
1,300,000 | 2.99 ms |
| PHP 8.5 | grapheme_strlen |
1,200,000 | 25.20 ms |
Swift -O |
s.unicodeScalars.count |
1,300,000 | 5.37 ms |
Swift -O |
s.count |
1,200,000 | 17.69 ms |
| Python 3.9 | len(s.encode()) |
3,200,000 | 1.61 ms |
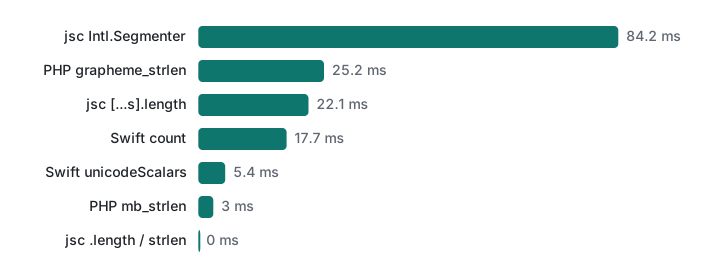
Dos lecciones. Las longitudes guardadas (.length, strlen, len de Python) son O(1). Contar grafemas es O(n): unos 70 ns por grafema con Intl.Segmenter en jsc y 21 ns con grapheme_strlen de PHP, que usa ICU. Para un nombre de 30 caracteres no importa; dentro de un bucle sobre un log de 10 MB, sí. Cuenta grafemas en los bordes (validación, recorte para mostrar), no en bucles críticos.
Límites honestos y notas de versión
Intl.Segmenterestá en ECMA-402 (edición 2022); solo comprobamos que este jsc de macOS lo tiene.isWellFormed/toWellFormedson de ES2024 y también existen aquí.- Según sus notas de versión,
BreakIteratorde Java sigue los grupos de grafemas extendidos desde JDK 20; solo lo comprobamos en 26. La regex\Xexiste desde Java 9. StringInfode .NET pasó a grupos de grafemas extendidos en .NET 5 (un cambio incompatible documentado); se ejecutó en .NET 10.grapheme_strlendepende de la versión de ICU incluida en PHP (aquí 78.3). Con un ICU más viejo, los emoji nuevos pueden segmentarse distinto; elunicodedatade Python 3.9 es Unicode 13.0, más antiguo que ICU 78.- En Dart, los grafemas se manejan con el paquete
characters(el que usa Flutter); no se ejecutó porque no se podía instalar nada. - MySQL, Node.js, navegadores y Android no se ejecutaron; lo dicho sobre ellos viene de su documentación.
Ejercicios
1. Predice y luego comprueba: la bandera de México 🇲🇽 en .length de JS, len de Python, count de Swift y strlen de PHP.
2. Escribe en PHP una función cut_for_column(string $s, int $maxBytes): string que nunca parta un grafema, y pruébala con "가족👨👩👧!" usando 23 y 24.
Respuestas
1. Medido: 4, 2, 1, 8. Son dos indicadores regionales (U+1F1F2 y U+1F1FD), cada uno de 4 bytes y 2 unidades UTF-16, que forman un solo grafema.
2. function cut_for_column(string $s, int $maxBytes): string { $next = 0; return grapheme_extract($s, $maxBytes, GRAPHEME_EXTR_MAXBYTES, 0, $next) ?: ""; } devolvió 가족 (6 bytes) con 23 y el 가족👨👩👧 de 24 bytes con 24, como se ve arriba. El ?: "" cubre el false que devuelve grapheme_extract cuando la entrada no es UTF-8 válido.
Lo que sigue
La última clase responde la pregunta con la que termina toda importación de un sistema viejo: el archivo no declara su codificación, ¿puede adivinarla un programa? Medimos cuántas veces acierta, qué tan rápida es la conversión, y corregimos el bug de lectura por bloques de la clase 1.
- Anterior: curso de texto y codificación 4/6: CSV, el BOM y Excel
- Siguiente: curso de texto y codificación 6/6: detectar la codificación es adivinar
- Antes en la serie: caracteres, puntos de código y bytes UTF-8, mojibake: por qué aparece «Ã±» y cómo arreglarlo, normalización Unicode y nombres de archivo
- Relacionado: JavaScript desde cero: tipos e igualdad, PHP: tipos, strings y arrays, strings en C y desbordamientos de búfer (en inglés), y la hoja de ruta para aprender a programar
Preguntas frecuentes
¿Por qué en JavaScript un emoji tiene length 2?
Porque .length cuenta unidades de código UTF-16, y todo emoji fuera del plano básico necesita dos (un par sustituto). 👍 mide 2, 👍🏽 mide 4 y el emoji de familia 👨👩👧 mide 8. [...s].length cuenta puntos de código (1, 2, 5) e Intl.Segmenter cuenta lo que ve el usuario (1, 1, 1); lo medimos en JavaScriptCore sobre macOS 26.
¿Por qué «José Muñoz» a veces mide 12 en vez de 10?
Porque está en forma NFD: la é es una e más un acento combinable (U+0301) y la ñ es una n más una tilde (U+0303). Son 12 puntos de código pero 10 grafemas. Pasa con texto copiado de un PDF o con nombres de archivo creados en Mac. Normaliza a NFC antes de contar o comparar.
¿Cabe un emoji en una columna VARCHAR de MySQL con utf8?
No. En MySQL, utf8 es un alias de utf8mb3, que guarda como máximo 3 bytes por carácter, y todo emoji ocupa 4 bytes en UTF-8; en modo estricto da el error 1366 Incorrect string value. Usa utf8mb4, el valor por defecto desde MySQL 8.0. Esta parte se describe según la documentación de MySQL; no se ejecutó aquí. SQLite, en cambio, ni siquiera respeta el largo: VARCHAR(5) aceptó 16 caracteres.