문자열 길이는 언어마다 다르다: 이모지·그래핌·바이트 8개 언어 실측
한글 NFD, 👍🏽, 👨👩👧, 🇰🇷 의 길이를 Python·JS·Swift·Dart·Java·C#·PHP·SQLite 로 실측. 이모지를 깨뜨리는 자르기 버그와 DB 글자 수 제한까지.
시리즈: 문자 인코딩 강좌 5/6 (고급). 사용자 입력의 글자 수 검사, 자르기, DB 저장을 짜다가 "10자 제한" 이 계층마다 다른 뜻이 되어 곤란했던 개발자를 위한 글입니다. 다 읽으면 각 언어의 API 가 네 가지 "길이" 중 무엇을 돌려주는지, 이모지를 깨뜨리지 않고 문자열을 자르는 법, 화면·DB·통신에서 각각 어떤 기준으로 세야 하는지 알 수 있습니다.
회원 가입 화면에서 닉네임을 10자로 제한했더니 이모지를 넣은 사용자가 다섯 글자만 입력해도 오류가 났다는 문의가 왔다. 맥에서 올린 파일 이름 "한글.txt" 가 서버에서 10글자로 계산됐다. 알림 미리보기가 "?" 로 끝났다. 원인은 하나입니다. 문자열 길이는 하나가 아닙니다. UTF-8 바이트 수, UTF-16 코드 유닛 수, 코드 포인트 수, 그래핌 클러스터 수 네 가지가 있고 언어마다 기본 "길이" 가 다릅니다. 이 글에서는 같은 문자열을 Python·JavaScript·Swift·Dart·Java·C#·PHP·SQLite 에 넣어 보고, 모든 숫자를 실제 실행 결과에서 가져왔습니다.
실행 환경: Apple Silicon Mac(M1 Pro), macOS 26.6, Python 3.9.6(Unicode 13.0 데이터베이스), macOS 기본 JavaScriptCore jsc, Swift 6.4.2, Dart 3.11.5, OpenJDK 26, .NET 10.0.403(C#), PHP 8.5.6 + intl(ICU 78.3), SQLite 3.51.0. Node.js·브라우저·MySQL·Windows 는 실행하지 않았습니다.
문자열 하나에 "길이" 가 네 개
1강에서 문자·코드 포인트·바이트를 나눴습니다. 언어를 비교하려면 한 층이 더 필요합니다. JavaScript 와 Java 는 내부적으로 UTF-16 을 쓰기 때문입니다.
- UTF-8 바이트 수: 파일과 네트워크로 실제 흐르는 양. PHP
strlen, Swiftutf8.count, SQLiteoctet_length(). - UTF-16 코드 유닛 수: 16비트 단위. U+FFFF 를 넘는 문자(대부분의 이모지, 희귀 한자)는 2유닛이 필요하며 이를 서로게이트 쌍이라 합니다. JavaScript
.length, Javalength(), C#Length, Dart.length. - 코드 포인트 수: 유니코드 번호가 붙은 문자(
U+D55C)의 개수. Pythonlen(), PHPmb_strlen, SQLitelength(). - 그래핌 클러스터 수: 사람이 "한 글자" 라고 느끼는 단위. 국기는 코드 포인트 2개, 👍🏽 는 엄지와 피부색 수식자, 👨👩👧 는 세 사람을 보이지 않는 ZERO WIDTH JOINER(U+200D) 두 개로 이은 것입니다. 유니코드는 이를 확장 그래핌 클러스터(UAX #29)로 정의합니다. 자모 분리된 한(ㅎ+ㅏ+ㄴ)도 그래핌으로는 한 글자입니다.
큰 표: 문자열 14개 실측
에디터가 멋대로 정규화하지 못하도록 모든 언어에서 문자열을 이스케이프("한", "\u{1F468}…")로 썼습니다. 같은 단위를 돌려주는 API 끼리는 완전히 일치해서 열을 단위별로 묶었습니다.
| 문자열(코드 포인트) | UTF-8 바이트 | UTF-16 유닛 | 코드 포인트 | 그래핌 |
|---|---|---|---|---|
| é NFC(U+00E9) | 2 | 1 | 1 | 1 |
| é NFD(U+0065 U+0301) | 3 | 2 | 2 | 1 |
| 한 NFC(U+D55C) | 3 | 1 | 1 | 1 |
| 한 NFD(자모 3개) | 9 | 3 | 3 | 1 |
| 👍 | 4 | 2 | 1 | 1 |
| 👍🏽(엄지 + 피부색) | 8 | 4 | 2 | 1 |
| 👨👩👧(3명 + ZWJ 2개) | 18 | 8 | 5 | 1 |
| 🇯🇵(지역 표시 기호 2개) | 8 | 4 | 2 | 1 |
| 𠮷(U+20BB7) | 4 | 2 | 1 | 1 |
| ガ NFD(カ + U+3099) | 6 | 2 | 2 | 1 |
| año | 4 | 3 | 3 | 3 |
| 文字化け | 12 | 4 | 4 | 4 |
| 한글 | 6 | 2 | 2 | 2 |
| café | 5 | 4 | 4 | 4 |
한국어 현장에서 자주 만나는 경우도 쟀습니다.
| 문자열 | UTF-8 바이트 | UTF-16 유닛 | 코드 포인트 | 그래핌 |
|---|---|---|---|---|
| 한글(NFC, 일반 입력) | 6 | 2 | 2 | 2 |
| 한글(NFD, 맥 파일 이름) | 18 | 6 | 6 | 2 |
| 한글.txt(NFD) | 22 | 10 | 10 | 6 |
맥에서 압축하거나 업로드한 파일 이름은 NFD 로 들어오는 경우가 많고, 그대로 len() 으로 세면 "한글" 이 6 글자, UTF-8 로 18바이트가 됩니다. 화면에는 똑같이 보이니 원인을 찾기 어렵습니다. NFC/NFD 정규화 자체는 3강에서 다뤘습니다.
인코딩에 따라 바이트 수도 달라집니다. 문자 메시지 문구 내일 오전 10시 회의실 변경되었습니다 는 21글자인데 CP949 로 36바이트, UTF-8 로 51바이트였습니다. 한글 한 글자가 CP949 에서는 2바이트, UTF-8 에서는 3바이트이기 때문입니다. 단문 메시지처럼 "80바이트(한글 40자)" 로 안내되는 제한은 2바이트 한글을 전제로 한 계산이라, UTF-8 바이트로 세면 기준이 어긋납니다(통신사 규격은 이번에 실행해 확인하지 않았습니다). 그리고 '확인했습니다👍'.encode('cp949') 는 'cp949' codec can't encode character '\U0001f44d' in position 6: illegal multibyte sequence 로 실패했습니다. CP949 에는 이모지가 없습니다.
어떤 API 가 어떤 단위를 돌려주나
| 언어 | UTF-8 바이트 | UTF-16 유닛 | 코드 포인트 | 그래핌 |
|---|---|---|---|---|
| Python 3.9 | len(s.encode()) |
len(s.encode('utf-16-le'))//2 |
len(s) |
표준 라이브러리에 없음 |
| JavaScript(jsc) | jsc 에 TextEncoder 없음 |
s.length |
[...s].length |
Intl.Segmenter |
| Swift | s.utf8.count |
s.utf16.count |
s.unicodeScalars.count |
s.count |
| Dart | (utf8.encode) |
s.length |
s.runes.length |
코어에 없음 |
| Java 26 | getBytes(UTF_8).length |
s.length() |
codePointCount |
BreakIterator, 정규식 \X |
| C#(.NET 10) | Encoding.UTF8.GetByteCount |
s.Length |
EnumerateRunes().Count() |
StringInfo.LengthInTextElements |
| PHP 8.5 | strlen |
— | mb_strlen |
grapheme_strlen |
| SQLite 3.51 | octet_length() |
— | length() |
없음 |
표에 다 담지 못한, 직접 확인한 사항입니다.
- 이 jsc 에는
Intl.Segmenter가 있습니다(typeof Intl.Segmenter가function). 반면TextEncoder는undefined라서 jsc 에서 바이트 수를 내려면 직접 루프를 짜야 합니다. - Python 3.9 에는 그래핌 기능이 없습니다:
re.compile(r'\X')는re.error: bad escape \X at position 0으로 실패합니다. 외부regex모듈은\X를 지원하지만 이번에는 아무것도 설치하지 않았습니다. - Swift 는 비교도 그래핌 단위입니다: 자모 분리된 한과 완성형 한(
"\u{D55C}" == "\u{1112}\u{1161}\u{11AB}")이 Swift 에서는true였습니다. é 의 두 형태도 Swifttrue, Dartfalse, C#==는False였고, C# 의string.Compare(..., StringComparison.InvariantCulture)는0(같음)을 돌려줬습니다. - PHP
mb_strwidth는 다섯 번째 답입니다: 전각 문자를 2칸으로 세서한은 2, NFD한글은 8 이었습니다. 터미널 정렬용이지 입력 제한용이 아닙니다.
자르기 버그를 실제로 일으켜 보기
잘못 세면 불편한 정도지만, 잘못 자르면 데이터가 깨집니다. 각 언어의 기본 단위로 자르면 이렇게 됩니다.
JavaScript: 서로게이트 반쪽. "OK👍".slice(0, 3) 은 서로게이트 쌍의 앞쪽만 남깁니다.
"OK\ud83d" 3 false OK�
URIError: String contained an illegal UTF-16 sequence.
출력은 차례로 JSON.stringify(cut), cut.length, cut.isWellFormed(), cut.toWellFormed() 입니다. 깨진 문자열도 JS 문자열로서는 유효해서 프로그램 밖으로 나가기 전까지는 아무 일도 없습니다. encodeURIComponent 에서 비로소 위의 URIError 가 납니다. "이모지를 넣은 사람만 검색이 실패한다" 는 버그의 정체입니다.
JavaScript 두 번째: 가족에서 아이가 사라진다. 가족 이모지를 5 코드 유닛에서 자르면 "👨👩" 가 됩니다. 오류 없이 뜻만 바뀝니다. 코드 포인트로 잘라도([...s].slice(0, 3)) 같은 두 사람입니다. 안전한 것은 그래핌 단위로 자르는 방법뿐입니다.
const seg = new Intl.Segmenter("ko", {granularity: "grapheme"});
function truncate(str, n) {
let out = "", i = 0;
for (const {segment} of seg.segment(str)) {
if (i++ === n) return out + "…";
out += segment;
}
return out;
}
print(truncate("가족\u{1F468}\u{1F469}\u{1F467}여행", 3)); // 가족👨👩👧…
Java 와 C#: 반쪽 이모지는 출구에서 ? 나 � 가 된다. Java 의 "OK👍".substring(0, 3) 을 UTF-8 로 바꾸면 4f 4b 3f 라서 DB 에는 물음표가 들어갑니다. C# 의 Substring(0, 3) 은 4F4BEFBFBD, 즉 U+FFFD(�)였습니다. 엄격한 인코더(new UTF8Encoding(false, true))를 쓰면 .NET 은 예외를 던집니다.
EncoderFallbackException: Unable to translate Unicode character \\uD83D at index 2 to specified code page.
Java 에서는 코드 포인트 경계(s.offsetByCodePoints(0, n))나, 가능하면 BreakIterator 경계에서 자릅니다. C# 에서는 new StringInfo(s).SubstringByTextElements(0, 3) 이 가족👨👩👧 를 통째로 돌려줬습니다.
Python 과 PHP: 바이트로 자르기. 정말 아픈 곳은 바이트 제한입니다. 프로토콜과 컬럼은 바이트로 재기 때문입니다. Python 에서:
>>> "한글 깨짐".encode()[:4].decode()
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xea in position 3: unexpected end of data
errors="ignore" 를 붙이면 반쪽 글자가 버려지고 한 이 되어 고쳐진 것처럼 보입니다. 그런데 "OK👍🏽" 를 7바이트로 자르니 OK👍 가 됐습니다. 피부색 수식자가 조용히 사라져 사용자의 이모지가 바뀐 것입니다. PHP 에서는 substr("한글 깨짐", 0, 4) 가 바이트열 ed959cea 를 돌려주고, 이것을 json_encode 하면 false(Malformed UTF-8 characters, possibly incorrectly encoded)가 됩니다. API 응답 전체가 빈 값이 되는 전형적인 패턴입니다. mb_substr 는 코드 포인트로 자르므로 mb_substr("가족👨👩👧", 0, 4) 끝에 ZWJ 가 매달렸습니다(…f09f91a8e2808d).
PHP intl 에는 딱 맞는 함수가 있습니다. grapheme_extract 에 GRAPHEME_EXTR_MAXBYTES 를 주면 N바이트 안에 들어가는 가장 긴 그래핌 단위 앞부분을 돌려줍니다.
$s = "가족👨👩👧!"; // 6 + 18 + 1 = 25바이트
foreach ([23, 24] as $max) {
$next = 0;
var_dump(grapheme_extract($s, $max, GRAPHEME_EXTR_MAXBYTES, 0, $next), $next);
}
// string(6) "가족" int(6) (가족 이모지는 24바이트가 필요)
// string(24) "가족👨👩👧" int(24)
흔한 실수: 같은 "최대 글자 수" 를 세 계층에서 따로 세기
실수. 기획은 "닉네임 10자까지". 웹 폼은 value.length <= 10(UTF-16), API 는 len(name) <= 10(코드 포인트), 컬럼은 VARCHAR(10).
실제로 일어나는 일. 국기 다섯 개(🇲🇽🇯🇵🇰🇷🇪🇸🇺🇸)는 그래핌 5, 코드 포인트 10, UTF-16 20 이라서 눈으로는 다섯 글자인데 폼이 "너무 깁니다" 라고 합니다. 맥에서 온 NFD 닉네임 "한글" 은 API 에서 6 글자로 셉니다. API 에서 name[:10] 으로 자른 이름은 ZWJ 중간에서 끝날 수 있습니다.
고치는 법. 계층마다 의도적으로 정합니다.
| 무엇을 제한하나 | 세는 단위 | 이유 |
|---|---|---|
| 사용자에게 보이는 "10자" | 그래핌 | 화면과 일치하고 이모지를 쪼개지 않음 |
| 바이트 예산(컬럼 바이트, 헤더, 알림 페이로드, 문자 메시지) | 해당 인코딩의 바이트, 그래핌 경계에서 자르기 | 제한이 물리적임 |
MySQL VARCHAR(n), SQLite length() |
코드 포인트(NFC 로 정규화한 뒤) | DB 가 그렇게 셈 |
| JS·Java·C# 문자열 인덱스, 커서 위치 | UTF-16 유닛 | API 가 그 단위로 인덱싱 |
서버에서는 가장 엄격한 제한을 지키고, UI 에는 사용자 기준 글자 수를 보여 줍니다. Flutter 앱이라면 공식 문서상 TextField.maxLength 는 그래핌 클러스터로, 안드로이드의 전통적인 maxLength 필터는 UTF-16 char 로 셉니다(둘 다 문서 기반 설명이며 이번에 실행하지 않았습니다).
DB 컬럼: SQLite 는 실측, MySQL 은 설명만
SQLite 는 선언된 길이를 장식으로 취급합니다.
sqlite> create table u(name varchar(5));
sqlite> insert into u values ('abcdefghijklmnop');
sqlite> select name, length(name), octet_length(name) from u;
abcdefghijklmnop|16|16
👨👩👧|5|18
제한이 필요하면 직접 써야 하는데, length() 는 코드 포인트 수입니다. check (length(name) <= 4) 로 하면 文字化け 는 통과하고, 가족 이모지는 화면에서 한 글자인데도 CHECK constraint failed: length(name) <= 4 (19) 로 거부됐습니다. substr(fam, 1, 2) 는 바이트열 F09F91A8E2808D, 즉 남자 + 매달린 ZWJ 였습니다. SQLite 는 정규화도 하지 않아서 char(0xe9) = 'e' || char(0x301) 이 0 입니다. NFD 한글과 NFC 한글도 다른 값으로 저장되고 비교됩니다.
MySQL(이번에 실행하지 않음, MySQL 레퍼런스 매뉴얼 기반 설명): VARCHAR(n) 은 문자(코드 포인트)를 셉니다. utf8 이라는 문자 집합은 utf8mb3 의 별칭으로 한 글자에 최대 3바이트만 저장하므로, 4바이트 문자(모든 이모지와 𠮷)는 strict 모드에서 오류 1366 "Incorrect string value" 가 납니다. utf8mb4 를 쓰세요. MySQL 8.0 부터 기본값입니다. 글자 수 아래에는 바이트 제한도 남아 있습니다. 한 행은 65,535바이트까지, 인덱스 키 길이는 행 포맷에 따라 767 또는 3,072바이트까지라서 utf8mb4 의 VARCHAR(255) 는 인덱스에서 최대 1,020바이트가 될 수 있습니다. 쿼리 자체는 SQL 기초 강좌에서 다룹니다.
측정: 그래핌을 세는 비용
그래핌 세기는 공짜가 아닙니다. 문자열을 처음부터 훑으며 UAX #29 규칙을 적용해야 합니다. "文字化けcafé한글👍🏽 " 를 10만 번 반복한 문자열(그래핌 120만, 코드 포인트 130만, UTF-16 150만 유닛, 320만 바이트)로 5회 중앙값을 냈습니다.
| 언어 | 호출 | 결과 | 중앙값 |
|---|---|---|---|
| jsc | s.length |
1,500,000 | 0.0 ms |
| jsc | [...s].length |
1,300,000 | 22.1 ms |
| jsc | Intl.Segmenter 루프 |
1,200,000 | 84.2 ms |
| PHP 8.5 | strlen |
3,200,000 | 0.00 ms |
| PHP 8.5 | mb_strlen |
1,300,000 | 2.99 ms |
| PHP 8.5 | grapheme_strlen |
1,200,000 | 25.20 ms |
Swift -O |
s.unicodeScalars.count |
1,300,000 | 5.37 ms |
Swift -O |
s.count |
1,200,000 | 17.69 ms |
| Python 3.9 | len(s.encode()) |
3,200,000 | 1.61 ms |
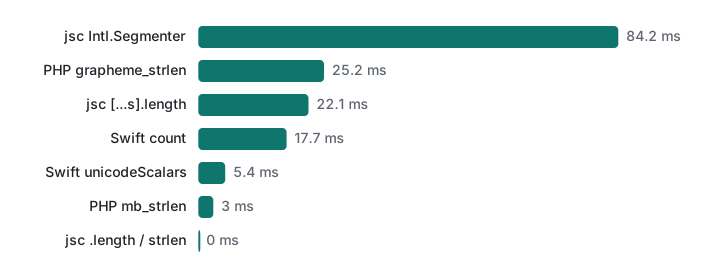
교훈은 두 가지입니다. 저장된 길이(.length, strlen, Python len)는 O(1)입니다. 그래핌 수는 O(n)이라서 jsc Intl.Segmenter 는 그래핌당 약 70ns, ICU 기반 PHP grapheme_strlen 은 약 21ns 였습니다. 30자짜리 닉네임이면 무시할 수준이지만 10MB 로그를 루프로 돌리면 체감됩니다. 그래핌은 입력 검증이나 표시용 자르기 같은 "가장자리" 에서 세고, 무거운 루프 안에서는 세지 않는 것이 좋습니다.
솔직한 한계와 버전 메모
Intl.Segmenter는 ECMA-402(2022년판) 기능입니다. 확인한 것은 이 macOS jsc 에 있다는 사실뿐입니다.isWellFormed/toWellFormed는 ES2024 이고 역시 이 jsc 에 있었습니다.- Java 의
BreakIterator는 릴리스 노트에 따르면 JDK 20 부터 확장 그래핌 클러스터를 따릅니다. 확인은 26 에서만 했습니다. 정규식\X는 Java 9 부터 있습니다. - .NET 의
StringInfo는 .NET 5 에서 확장 그래핌 클러스터로 바뀌었습니다(문서화된 호환성 변경). 실행은 .NET 10 입니다. grapheme_strlen결과는 PHP 에 묶인 ICU 버전(이번에는 78.3)에 따라 달라집니다. 오래된 ICU 에서는 새 이모지의 경계가 다르게 나올 수 있습니다. Python 3.9 의unicodedata는 Unicode 13.0 으로 ICU 78 보다 오래된 데이터입니다.- Dart 에서 그래핌을 다루는 것은
characters패키지(Flutter 가 쓰는 것)인데, 아무것도 설치할 수 없어서 이번에는 실행하지 않았습니다. - MySQL·Node.js·브라우저·안드로이드는 실행하지 않았고, 위 설명은 각 문서에 근거합니다.
연습 문제
1. 먼저 예상한 뒤 확인해 보세요. 태극기 🇰🇷 의 JS .length, Python len, Swift count, PHP strlen 은?
2. 그래핌을 절대 쪼개지 않는 PHP 함수 cut_for_column(string $s, int $maxBytes): string 을 짜서 "가족👨👩👧!" 에 23 과 24 로 시험해 보세요.
정답
1. 실측 4, 2, 1, 8. 4바이트·2유닛짜리 코드 포인트(지역 표시 기호 U+1F1F0, U+1F1F7) 두 개가 그래핌 하나를 이룹니다.
2. function cut_for_column(string $s, int $maxBytes): string { $next = 0; return grapheme_extract($s, $maxBytes, GRAPHEME_EXTR_MAXBYTES, 0, $next) ?: ""; } 는 23 에서 가족(6바이트), 24 에서 24바이트 가족👨👩👧 를 돌려줬습니다(위 실행 결과 그대로). ?: "" 는 입력이 올바른 UTF-8 이 아닐 때 grapheme_extract 가 돌려주는 false 에 대한 대비입니다.
다음 강의
마지막 강의는 오래된 시스템의 데이터를 옮길 때 꼭 나오는 질문을 다룹니다. 인코딩 선언이 없는 파일을 프로그램이 알아맞힐 수 있을까? 맞힐 확률과 변환 속도를 재고, 1강에서 언급한 "청크 경계에서 글자가 잘리는" 버그를 고칩니다.
자주 묻는 질문
자바스크립트에서 이모지 하나의 length 가 2 인 이유는?
.length 는 UTF-16 코드 유닛을 세기 때문입니다. BMP 밖의 이모지는 서로게이트 쌍 2유닛이 필요해서 👍 는 2, 👍🏽 는 4, 가족 이모지 👨👩👧 는 8 입니다. [...s].length 는 코드 포인트(1, 2, 5), Intl.Segmenter 는 눈에 보이는 글자 수(1, 1, 1)를 셉니다. macOS 26 의 JavaScriptCore 에서 실측했습니다.
맥에서 만든 파일 이름 '한글' 의 길이가 6 으로 나오는 이유는?
NFD(자모 분리) 형태라서입니다. 한 은 ㅎ·ㅏ·ㄴ 세 개의 조합형 자모(U+1112 U+1161 U+11AB)로 저장되어, 한글 은 코드 포인트 6, UTF-16 6유닛, UTF-8 18바이트가 됩니다. 그래핌으로 세면 2 입니다. 비교 전에 NFC 로 정규화해야 합니다.
VARCHAR(10) 컬럼에 이모지 10개가 들어가나요?
DB 가 무엇을 세는지에 달렸습니다. SQLite 는 선언된 길이를 무시해서 VARCHAR(5) 에 16글자가 들어갔습니다. MySQL 의 VARCHAR(n) 은 코드 포인트를 세므로 가족 이모지 10개는 50 이고, 옛 utf8(utf8mb3)은 4바이트 문자를 아예 저장하지 못하니 utf8mb4 를 써야 합니다. MySQL 부분은 문서 기반 설명이며 실행하지 않았습니다.