k-means 표준 라이브러리로 직접 구현: 지역 최솟값·k-means++·k 고르기
파이썬 표준 라이브러리만으로 k-means 를 짜고 조건마다 200번 실행. 최선의 결과에 도달한 건 무작위 초기화 79번, k-means++ 127번. 빈 클러스터, 스케일링, 블로그 글 군집화까지 실측.
고객 세분화나 로그 분석 과제에서 KMeans(n_clusters=5) 를 일단 돌려 봤는데, 돌릴 때마다 묶음이 바뀌고 k 를 몇으로 해야 할지 근거가 없어서 막혔던 분을 위한 글입니다. k-means 를 파이썬 표준 라이브러리만으로 약 60줄로 짜고, 조건마다 200번씩 돌려서 어떻게 실패하는지를 숫자로 확인했습니다. 결론부터 말하면 무작위 초기화가 최선의 군집에 도달한 건 200번 중 79번, k-means++ 도 127번이었고, k-means++ 는 수렴까지 반복 횟수를 평균 10.0회에서 7.3회로 줄였습니다.
이 글은 연재 「밑바닥부터 머신러닝 (파이썬 표준 라이브러리만)」의 2강입니다. 1강 선형 회귀와 경사 하강법에서는 손실, 루프, 멈춤 조건을 다뤘습니다. k-means 도 이 세 가지로 이루어져 있지만 정답 라벨도, 기울기도 없습니다. 이어서 나이브 베이즈, 퍼셉트론에서 작은 신경망까지, TF-IDF/BM25 검색 엔진으로 이어집니다.
실행 환경: Python 3.9.6 표준 라이브러리만 사용(math, random, statistics, collections, re), Apple Silicon Mac(M1 Pro). 지원 중단 API 는 쓰지 않았으니 Python 3.12 이상에서도 그대로 돌아갈 겁니다. 난수는 전부 시드를 고정한 random.Random 이라 아래 숫자는 그대로 재현됩니다.
로이드 알고리즘 60줄
k-means 는 대표점(중심) k개를 놓고 관성(inertia), 즉 각 점에서 가장 가까운 중심까지 거리 제곱의 합을 최소로 만들려고 합니다. 표준적인 방법이 로이드 알고리즘이고, 다음 두 단계를 아무것도 바뀌지 않을 때까지 반복합니다.
- 할당: 각 점을 가장 가까운 중심의 클러스터에 넣는다
- 갱신: 각 중심을 그 클러스터에 들어온 점들의 평균으로 옮긴다
두 단계 모두 관성을 늘리지 않으므로 루프는 반드시 멈춥니다. 하지만 멈추는 곳은 "두 단계 어느 쪽으로도 더 나아지지 않는 곳"이고, 그게 전체 최솟값이라는 보장은 없습니다. 이 글의 대부분이 그 차이에 관한 이야기입니다.
아래가 kmeans.py 전체입니다. 다른 스크립트는 이 파일을 import 합니다.
import math, random

def make_blobs(centers, n_each, spread, seed):
    rng = random.Random(seed)
    X, y = [], []
    for label, (cx, cy) in enumerate(centers):
        for _ in range(n_each):
            X.append((rng.gauss(cx, spread), rng.gauss(cy, spread)))
            y.append(label)
    return X, y

def d2(a, b):
    return sum((p - q) ** 2 for p, q in zip(a, b))

def mean(points):
    n = len(points)
    return tuple(sum(c) / n for c in zip(*points))

def init_random(X, k, rng):            # Forgy: k distinct data points
    return [X[i] for i in rng.sample(range(len(X)), k)]

def init_plusplus(X, k, rng):          # k-means++ (Arthur & Vassilvitskii 2007)
    C = [X[rng.randrange(len(X))]]
    D = [d2(x, C[0]) for x in X]
    while len(C) < k:
        r, acc = rng.random() * sum(D), 0.0
        for i, w in enumerate(D):
            acc += w
            if acc >= r:
                break
        C.append(X[i])
        D = [min(D[j], d2(X[j], X[i])) for j in range(len(X))]
    return C

def kmeans(X, k, init="++", seed=0, max_iter=300, C=None):
    rng = random.Random(seed)
    if C is None:
        C = (init_plusplus if init == "++" else init_random)(X, k, rng)
    empty_fixes = 0
    for it in range(1, max_iter + 1):
        # 1) assignment step
        labels = [min(range(k), key=lambda j: d2(x, C[j])) for x in X]
        # 2) update step
        groups = [[] for _ in range(k)]
        for x, j in zip(X, labels):
            groups[j].append(x)
        newC = []
        for j in range(k):
            if groups[j]:
                newC.append(mean(groups[j]))
            else:   # empty cluster: move it to the worst-served point
                far = max(range(len(X)), key=lambda i: d2(X[i], C[labels[i]]))
                newC.append(X[far])
                empty_fixes += 1
        if newC == C:
            break
        C = newC
    inertia = sum(d2(x, C[j]) for x, j in zip(X, labels))
    return C, labels, inertia, it, empty_fixes
반복 횟수 it 에는 "아무것도 안 움직였음을 확인한 마지막 1회"도 들어갑니다. 실험 데이터는 간격 6인 격자 위에 놓은 가우스 덩어리 8개(각 75점, σ = 1.0, 시드 42), 모두 600점입니다. 산점도를 사람이 보면 한눈에 8개로 나눌 수 있는 일부러 쉬운 데이터입니다. 그래서 아래의 실패가 더 또렷하게 보입니다.
실패 1: 무작위 초기화는 나쁜 지역 최솟값에 빠진다
한 번 돌려 보고 "잘 됐다"고 판단하면 위험합니다. 시드 0~199로 200번씩 돌리고 최종 관성의 분포를 봤습니다.
import statistics as st, time
from kmeans import make_blobs, kmeans

CENTERS = [(0,0),(6,0),(12,0),(0,6),(6,6),(12,6),(3,12),(9,12)]
X, y = make_blobs(CENTERS, n_each=75, spread=1.0, seed=42)

for init in ("random", "++"):
    t = time.perf_counter()
    runs = [kmeans(X, 8, init=init, seed=s) for s in range(200)]
    sec = time.perf_counter() - t
    inert = [r[2] for r in runs]; iters = [r[3] for r in runs]
    best = min(inert)
    q = st.quantiles(inert, n=4)
    print(f"{init:>6}: inertia best {best:.1f} | Q1 {q[0]:.1f} median {q[1]:.1f} "
          f"Q3 {q[2]:.1f} worst {max(inert):.1f}")
    print(f"        runs at best {sum(i < best * 1.001 for i in inert)}/200, "
          f"distinct end states {len({round(i) for i in inert})}, "
          f"iterations mean {st.mean(iters):.1f} max {max(iters)}, {sec:.2f}s")
    tens = [min(inert[i:i + 10]) for i in range(0, 200, 10)]
    print(f"        best-of-10 restarts reached the best in "
          f"{sum(b < best * 1.001 for b in tens)}/20 groups")
random: inertia best 1170.9 | Q1 1170.9 median 2275.3 Q3 2413.8 worst 3765.7
        runs at best 79/200, distinct end states 81, iterations mean 10.0 max 29, 5.35s
        best-of-10 restarts reached the best in 20/20 groups
    ++: inertia best 1170.9 | Q1 1170.9 median 1170.9 Q3 2289.9 worst 2592.9
        runs at best 127/200, distinct end states 57, iterations mean 7.3 max 23, 4.44s
        best-of-10 restarts reached the best in 20/20 groups
무작위 초기화는 중앙값이 최선의 약 2배(2,275 대 1,171)이고, 200번의 결과가 81가지 상태로 흩어졌습니다. 나쁜 결과를 열어 보면 모양이 늘 같습니다. 예를 들어 시드 2는 이웃한 덩어리 6과 7을 중심 하나가 같이 떠안고(144점), 대신 덩어리 2를 42점과 33점으로 쪼갰습니다. 로이드의 두 단계로는 이걸 못 고칩니다. 중심 하나를 옆 덩어리로 넘기려면 관성이 일단 나빠져야 하는데, 이 알고리즘은 그런 걸음을 절대 내딛지 않기 때문입니다.
k-means++ 는 첫 중심만 무작위로 고르고, 두 번째부터는 "이미 고른 중심에서 먼 점일수록 잘 뽑히는" 확률(거리 제곱에 비례)로 고릅니다. 멀리 떨어진 덩어리마다 중심이 하나씩 돌아가기 쉬워집니다. 결과는 200번 중 127번이 최선이었고, 평균 반복은 2.7회 적었으며, 최악의 경우(2,593)도 무작위의 최악(3,766)보다 훨씬 나았습니다. 그래도 73번은 실패했습니다. 더 좋은 출발점일 뿐, 보장은 아닙니다.
어느 방법이든 통하는 해결책은 단순합니다. 여러 번 돌리고 관성이 가장 낮은 결과를 고르는 겁니다. 200번을 10번씩 20개 그룹으로 나누면, 각 그룹의 최선은 두 방법 모두 20/20 으로 전체 최선과 같았습니다. scikit-learn 의 n_init 이 바로 이 옵션인데, 현재 기본값 n_init="auto" 는 k-means++ 일 때 딱 1번만 돌립니다. 이 데이터에서 k-means++ 1번은 36.5% 확률로 최선을 놓쳤으니, 결과가 중요하다면 n_init 을 직접 지정하는 편이 안전합니다.
그림 가운데 막대는 다음 절에서 다루는 세 번째 초기화(데이터 범위 안의 완전히 무작위인 좌표 k개)의 결과입니다.
실패 2: 빈 클러스터, 그리고 파이썬의 조용한 함정
어떤 점에게도 "가장 가까운 중심"으로 뽑히지 못한 클러스터는 비게 됩니다. 초기 중심을 데이터 점에서 고르면(무작위, k-means++) 첫 할당에서 최소한 그 점 자신은 남으므로, 두 방법 합계 400번 중 한 번도 생기지 않았습니다. 그런데 범위 안의 무작위 좌표에서 시작하면, 덩어리 사이 빈 공간에 중심이 놓이는 경우가 생깁니다.
교과서식 루프라면 ZeroDivisionError 로 죽겠지 싶어 돌려 봤는데, 죽지 않았습니다.
import random
from kmeans import make_blobs, kmeans, mean, d2
CENTERS = [(0,0),(6,0),(12,0),(0,6),(6,6),(12,6),(3,12),(9,12)]
X, _ = make_blobs(CENTERS, n_each=75, spread=1.0, seed=42)
lo = [min(c) for c in zip(*X)]; hi = [max(c) for c in zip(*X)]

def box_init(seed, k=8):        # k random points anywhere in the bounding box
    rng = random.Random(seed)
    return [tuple(rng.uniform(a, b) for a, b in zip(lo, hi)) for _ in range(k)]

print("mean([]) =", mean([]), "  d2((3, 4), ()) =", d2((3.0, 4.0), ()))

def naive(C, k=8):              # textbook loop, no empty-cluster handling
    for it in range(1, 301):
        labels = [min(range(k), key=lambda j: d2(x, C[j])) for x in X]
        newC = [mean([x for x, l in zip(X, labels) if l == j]) for j in range(k)]
        if newC == C: break
        C = newC
    return C, it
…
mean([]) = ()   d2((3, 4), ()) = 0
naive: no exception, ghost centroid in 36 of 200 runs
  iterations of those runs: [300] | real centroids left: [1]
with reseeding: 36 runs needed a fix, 101 of 200 reached inertia 1170.9
zip(*[]) 는 아무것도 내놓지 않으므로, 빈 클러스터의 평균은 나눗셈이 한 번도 실행되지 않은 채 빈 튜플 () 이 됩니다. 게다가 zip(점, ()) 도 비어 있으니 모든 점에서 이 '유령 중심'까지의 거리가 0 이 됩니다. 다음 반복에서 유령이 600점을 전부 가져가고, 다른 중심들이 비면서 차례로 유령이 되고, 300회 상한까지 상태를 오갔습니다. 문제가 생긴 36번 모두 제대로 된 중심은 하나만 남았고, 예외는 한 번도 나지 않았습니다. NumPy 로 짜면 증상이 달라서 빈 배열의 평균이 경고와 함께 nan 이 됩니다(여기서는 돌려 보지 않았습니다). 어느 쪽이든 빈 클러스터는 명시적으로 처리해야 합니다.
빈 클러스터가 생긴 이 36번으로 처리 방법을 비교했습니다.
| 처리 | 빈 클러스터가 생긴 36번의 결과 |
|---|---|
| 아무것도 안 함(순진한 루프) | 예외 없음. 유령 중심, 300회 반복, 실제 중심 1개 |
| 빈 중심을 버림 | 수렴은 하지만 k 가 6이나 7로 줄어듦. 관성 중앙값 2,422.2 |
| 자기 중심에서 가장 먼 점으로 옮김 | k = 8 유지. 관성 중앙값 1,170.9(최선) |
kmeans.py 는 세 번째 방법을 씁니다. 관성을 가장 많이 만드는 점에 중심을 보내니 이치에 맞습니다. 중심을 조용히 버리면 지정한 k 가 몰래 바뀌는 셈이라 오히려 오류보다 나쁩니다. 의외였던 점은, 복구를 넣으면 범위 안 무작위 초기화가 200번 중 101번 최선에 도달해 데이터 점 무작위(79번)보다 나았다는 겁니다. 데이터 한 종류의 결과라 일반화하지는 않겠습니다. k-means++ 가 가장 낫다는 순서는 이번 모든 비교에서 바뀌지 않았습니다.
실패 3: 특성마다 스케일이 다르다
k-means 는 그냥 유클리드 거리를 쓰기 때문에 숫자 범위가 큰 특성이 이깁니다. 앱 사용자 600명을 가정해서 두 열을 만들었습니다. 하나는 실제 차이가 있는 "1회 사용 시간"(2분대와 8분대 두 그룹, σ 0.7)이고, 다른 하나는 그룹과 무관한 잡음인 "다운로드 바이트 수"(평균 50,000, σ 15,000)입니다.
def ari(a, b):                         # adjusted Rand index, stdlib only
    c2 = lambda n: n * (n - 1) / 2
    nij = sum(c2(v) for v in Counter(zip(a, b)).values())
    ai = sum(c2(v) for v in Counter(a).values())
    bj = sum(c2(v) for v in Counter(b).values())
    exp = ai * bj / c2(len(a))
    return (nij - exp) / ((ai + bj) / 2 - exp)

rng = random.Random(7)
X, y = [], []
for label, minutes in enumerate((2.0, 8.0)):    # two real user groups
    for _ in range(300):
        X.append((rng.gauss(minutes, 0.7),       # session minutes: the signal
                  rng.gauss(50000, 15000)))      # bytes downloaded: pure noise
        y.append(label)

def zscore(X):
    cols = list(zip(*X))
    mu = [st.mean(c) for c in cols]; sd = [st.pstdev(c) for c in cols]
    return [tuple((v - m) / s for v, m, s in zip(x, mu, sd)) for x in X]
…
     raw: ARI vs truth -0.001  sizes [247, 353]
 z-score: ARI vs truth 0.005  sizes [248, 352]
--- 50 seeds each ---
     raw: ARI>0.9 in 0/50 seeds, lowest-inertia run ARI -0.001
 z-score: ARI>0.9 in 46/50 seeds, lowest-inertia run ARI 1.000
     raw: inertia of true groups 1.394e+11, k-means best 5.423e+10
 z-score: inertia of true groups 630.7, k-means best 630.7
ARI(조정 랜드 지수)는 실제 그룹과 완전히 같으면 1, 아무렇게나 나누면 0 근처인 지표입니다. 원본 데이터에서는 시드 50개 전부가 잡음 열을 반으로 갈랐을 뿐입니다. 마지막 두 줄이 이유를 보여 줍니다. 원본 데이터에서는 실제 그룹으로 나눈 쪽의 관성이 2.6배 더 큽니다. k-means 는 목적 함수를 제대로 최소화했고, 틀린 건 목적 함수였습니다. 몇 번을 다시 돌려도 고쳐지지 않습니다.
열마다 표준화(z-score)를 하면 실제 그룹이 전체 최솟값이 됩니다. 그런데 첫 줄을 보세요. 시드 0은 표준화 뒤에도 잡음 쪽으로 갈랐습니다(ARI 0.005). 50개 중 46개가 정답이었고, 관성이 가장 낮은 결과를 고르면 정답이 뽑힙니다. 스케일링과 재시작은 서로 다른 문제를 풀기 때문에 둘 다 필요합니다. 또 표준화는 잡음뿐인 열에도 신호 열과 같은 무게를 줍니다. 이번에는 신호가 강해서 괜찮았지만, 잡음 열이 5개였다면 장담할 수 없습니다. 그때 필요한 건 k-means 튜닝이 아니라 특성 선택입니다.
k 고르기: 엘보 방법과 실루엣 점수
관성은 k 를 늘리면 무조건 줄어들기 때문에 최솟값으로는 k 를 고를 수 없습니다. 많이 쓰는 기준은 두 가지입니다.
- 엘보 방법: k 별 관성을 늘어놓고, 더 늘려도 줄어드는 폭이 둔해지는 "팔꿈치"를 찾는다
- 실루엣 점수: 각 점에 대해 같은 클러스터 다른 점까지의 평균 거리 a, 가장 가까운 다른 클러스터까지의 평균 거리 b 로 s = (b − a) / max(a, b) 를 구해 전체 평균을 낸다. −1~1 이고 높을수록 잘 뭉치고 잘 떨어져 있다
def silhouette(X, labels):
    k = max(labels) + 1
    total = 0.0
    for i, x in enumerate(X):
        sums, cnt = [0.0] * k, [0] * k
        for p, l in zip(X, labels):
            sums[l] += math.dist(x, p); cnt[l] += 1
        own = labels[i]
        if cnt[own] == 1:
            continue                      # singleton: s = 0 by convention
        a = sums[own] / (cnt[own] - 1)    # distance to itself is 0, not counted
        b = min(sums[j] / cnt[j] for j in range(k) if j != own and cnt[j])
        total += (b - a) / max(a, b)
    return total / len(X)

for k in range(2, 11):
    best = min((kmeans(X, k, seed=s) for s in range(10)), key=lambda r: r[2])
    …
k= 2 inertia  16057.9 drop         silhouette 0.357
k= 3 inertia   8662.2 drop  46.1%  silhouette 0.437
…
k= 7 inertia   2319.1 drop  36.3%  silhouette 0.584
k= 8 inertia   1170.9 drop  49.5%  silhouette 0.661
k= 9 inertia   1102.9 drop   5.8%  silhouette 0.619
k=10 inertia   1049.7 drop   4.8%  silhouette 0.567
2.3s
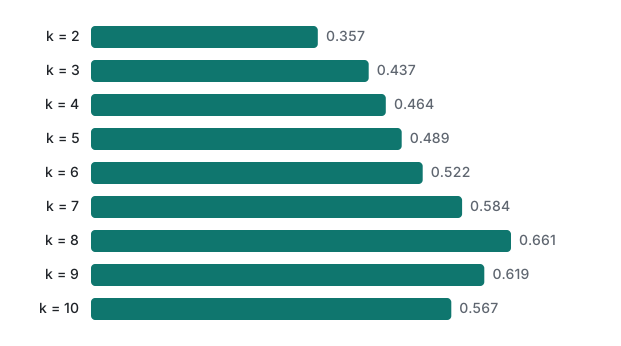
이 데이터에서는 둘의 의견이 같았습니다. 7→8 에서 관성이 49.5% 줄고 8→9 에서는 5.8% 만 줄어드니 팔꿈치는 8이고, 실루엣도 k = 8 의 0.661 이 가장 높습니다. 실루엣은 k 마다 O(n²) 번의 거리 계산이 필요합니다. 600점이면 k = 2~10 군집화를 포함해 2.3초지만, 5만 점이면 무거워집니다.
이번에는 나머지는 그대로 두고 덩어리 퍼짐만 σ = 2.0 으로 넓혔습니다.
k= 2 inertia  18150.6 drop         silhouette 0.344
k= 3 inertia  10271.1 drop  43.4%  silhouette 0.407
k= 4 inertia   7917.2 drop  22.9%  silhouette 0.377
…
k= 8 inertia   3468.8 drop  17.2%  silhouette 0.399
k= 9 inertia   3174.6 drop   8.5%  silhouette 0.390
k=10 inertia   2908.6 drop   8.4%  silhouette 0.373
데이터는 여전히 덩어리 8개에서 만들었는데 실루엣은 k = 3(0.407)을 골랐고, 감소율도 23%, 22%, 20%, 16%, 17% 로 밋밋하게 이어져 팔꿈치가 보이지 않습니다. 이 정도로 겹치면 두 지표가 재는 건 "나눈 결과가 얼마나 잘 떨어져 있나"이지 "원래 덩어리가 몇 개였나"가 아닙니다. 실무에서는 두 지표로 후보를 2~3개로 좁힌 뒤, 클러스터 안에 실제로 뭐가 들었는지 보고 정하는 게 현실적입니다.
보너스: 이 블로그의 글을 직접 군집화해 보기
깔끔한 덩어리가 아닌 실제 데이터로, 이 블로그의 영어 글 86편(content/en/*.md, 이 연재를 올리기 전 스냅샷)을 썼습니다. 각 글을 단어 빈도 벡터(bag of words)로 만들고 길이 1로 정규화합니다. 단위 벡터끼리는 유클리드 거리 제곱 = 2 − 2·cos 이므로, 가장 가까운 중심 배정은 거의 코사인 유사도로 정해집니다. k 는 프론트매터 category 종류 수와 같은 9로 하고, k-means++ 를 시드 20개로 돌려 관성이 가장 낮은 결과를 골랐습니다.
def load(folder, drop_code):
    docs = []
    for f in sorted(Path(folder).glob("*.md")):
        text = f.read_text(encoding="utf-8")
        _, fm, body = text.split("---", 2)
        cat = re.search(r"^category:\s*([\w-]+)", fm, re.M).group(1)
        if drop_code:
            body = re.sub(r"```.*?```", " ", body, flags=re.S)
        words = [w for w in re.findall(r"[a-z][a-z0-9+#]{2,}", body.lower()) if w not in STOP]
        docs.append((f.stem, cat, Counter(words)))
    return docs

def vectors(docs, idf):
    N = len(docs)
    df = Counter(w for _, _, c in docs for w in c)
    vocab = sorted(w for w, n in df.items() if 2 <= n <= N // 2)
    vecs = []
    for _, _, c in docs:
        v = [c[w] * (math.log(N / df[w]) if idf else 1.0) for w in vocab]
        norm = math.sqrt(sum(x * x for x in v)) or 1.0
        vecs.append(tuple(x / norm for x in v))      # unit length -> cosine
    return vecs, len(vocab)
…
code kept    idf=False docs=86 vocab=3521 k=9 ARI=0.387 purity=0.779 (18.6s)
code kept    idf=True  docs=86 vocab=3521 k=9 ARI=0.380 purity=0.756 (15.4s)
code dropped idf=False docs=86 vocab=3195 k=9 ARI=0.331 purity=0.791 (17.0s)
code dropped idf=True  docs=86 vocab=3195 k=9 ARI=0.361 purity=0.744 (13.4s)
순도(purity)는 클러스터마다 가장 많은 카테고리를 "정답"으로 쳤을 때의 비율인데, 모든 글을 한 클러스터에 넣기만 해도 37/86 = 0.43 이 나옵니다(C# 글이 37편이라서). 솔직히 정리하면 카테고리와의 일치는 중간 수준(ARI 0.33~0.39) 입니다. IDF 가중치나 코드 블록 제거도 일관된 개선은 아니었습니다. 첫 번째 설정에서 시드 20개의 ARI 는 0.17~0.45 로 흔들렸고, 관성이 가장 낮은 결과(0.387)가 카테고리와 가장 잘 맞는 결과도 아니었습니다. 관성은 우리가 정한 카테고리를 모르니까요.
관성이 가장 낮은 결과에서 무엇이 같이 묶였는지 추려 봤습니다.
| 클러스터 | 편수 | 안에 든 카테고리 | 예 |
|---|---|---|---|
| A | 18 | csharp 17, algorithm 1 | csharp-linq-basics, csharp-generics, …, algorithm-sorting |
| B | 16 | server 6, app-ops 4, web 3, flutter 2, ai 1 | mysql-max-connections-per-hour-shared-hosting, flutter-migration-16-apps-what-broke, … |
| C | 12 | csharp 12 | csharp-class, csharp-interface, csharp-event, … |
| D | 9 | regex 9 | 정규식 글 9편만 |
| E | 9 | algorithm 9 | data-structure-heap, data-structure-tree, … |
| F | 7 | winapi 5, csharp 1, algorithm 1 | winapi-sendmessage, csharp-registry, algorithm-binary-search |
| G | 7 | csharp 5, winapi 1, algorithm 1 | winforms-modal-modeless-form, csharp-file-io, … |
| H | 5 | algorithm 3, csharp 2 | csharp-collection-basics, data-structure-linked-queue, … |
| I | 3 | server 1, web 1, ai 1 | og-image-cards-pillow-cjk-line-breaking, hosting-account-migration-what-broke, … |
"틀린" 묶음 중 몇 개는 오히려 우리 카테고리보다 말이 됩니다. C# 37편은 "문법과 LINQ"(A)와 "객체 지향 기능"(C)으로 갈라졌습니다. WinForms 글은 카테고리상 csharp 이지만 창 다루기라는 어휘 때문에 Win32 글 쪽(F, G)에 붙었습니다. 큐·컬렉션 글(H)은 언어가 달라도 어휘가 겹칩니다. 반대로 서버·앱 운영·웹·Flutter 16편(B)은 어휘가 거의 같아서 한 덩어리가 됐습니다. 나이브 베이즈 강의에서 라벨로 학습하고도 작은 카테고리 4개를 12편 중 0편 맞혔던 것과 같은 구도입니다. 카테고리를 맞히고 싶다면 분류기를 학습시켜야 하고, k-means 는 "라벨이 가리고 있는 구조"를 싸게 들여다보는 도구로 보는 게 맞겠습니다.
k-means 를 쓸 때와 쓰지 말아야 할 때
| 상황 | 선택 | 이유 |
|---|---|---|
| 둥글고 크기가 비슷한 클러스터, 수치형 특성, k 를 알거나 후보를 좁힐 수 있음 | k-means(k-means++, 여러 번 실행) | 빠르고 단순하며 결과 중심을 설명하기 쉽다 |
| 고리·초승달·길쭉한 모양 클러스터 | DBSCAN, HDBSCAN, 스펙트럴 군집화 | k-means 는 중심 사이에 직선 경계를 그어 휘어진 모양을 자른다 |
| 뺄 수 없는 이상치가 많음 | k-medoids(PAM), DBSCAN(잡음으로 표시) | 평균은 극단적인 점 하나에 끌려가지만 메도이드는 아니다 |
| k 를 모르고 밀도도 제각각 | HDBSCAN | 밀도로 클러스터 수를 정한다 |
| 클러스터마다 퍼짐이나 크기가 크게 다름 | 가우스 혼합 모델(GMM) | k-means 는 같은 둥근 퍼짐을 가정하고, GMM 은 클러스터마다 모양을 배운다 |
| "A 70%, B 30%" 같은 소속 정도가 필요 | 가우스 혼합 모델, 퍼지 c-means | k-means 는 반드시 하나에만 배정한다 |
| 국가·요금제·OS 같은 범주형 열 | k-modes, k-prototypes | 범주 번호의 평균은 의미가 없다 |
| 수백만 행 | 미니배치 k-means | 매번 전체가 아니라 표본으로 갱신한다 |
| 텍스트 | TF-IDF 나 임베딩 위의 구면 k-means, 토픽 모델 | 벡터의 길이보다 방향이 중요하다 |
대안 기법은 이름만 소개했고, 이 글에서 구현하거나 측정하지는 않았습니다.
솔직한 한계
- 합성 데이터는 한 종류뿐입니다. 79번 대 127번이라는 차이는 σ = 1.0 인 덩어리 8개라는 이번 조건의 숫자입니다. 덩어리가 적고 멀리 떨어져 있으면 무작위 초기화도 꽤 맞히고, 가까운 덩어리가 많으면 둘 다 나빠집니다. "k-means++ 가 평균적으로 낫지만 그래도 실패한다"는 경향은 잘 알려져 있지만, 비율 자체는 이번 실험에만 해당합니다.
- 수렴 판정은 중심 튜플의 완전 일치(
newC == C)입니다. 이 정도 규모에서는 부동소수점이어도 잘 멈추지만, 실제 서비스에서는 이동량이 임계값 아래면 멈춰야 하고max_iter는 안전망입니다. - 빈 클러스터 복구는 단순합니다. 같은 반복에서 두 개가 비면 둘 다 같은 "가장 먼 점"으로 갑니다. 이번에는 한 번도 없었지만, 튼튼하게 만들려면 서로 다른 점을 골라야 합니다.
- 순수 파이썬은 느립니다. 86편(3,521차원 밀집 벡터)에서 1회 약 0.9초, 실루엣은 O(n²) 입니다. 원리를 이해하기 위한 코드이니 실제 데이터에는 희소 벡터를 지원하는 라이브러리를 쓰세요.
- 블로그 글 실험은 작고, 사람이 붙인 라벨이 기준입니다. 86편, 카테고리당 2~37편뿐이라 한 편만 옮겨 가도 ARI 가 눈에 띄게 변합니다. 게다가 "카테고리와 일치한다"는 것과 "좋은 클러스터"는 같은 말이 아닙니다. 위의 F, G 가 그 예입니다.
- 엘보 방법과 실루엣은 참고 지표입니다. σ = 2.0 에서는 덩어리 8개로 만든 데이터에 실루엣이 k = 3 을 골랐습니다. 어느 쪽도 클러스터 내용을 직접 보는 일을 대신하지 못합니다.
다음 강의: 같은 86편을 이번에는 라벨을 써서 분류하는 나이브 베이즈 분류기입니다. 비교 횟수나 반복 횟수를 세어 보는 방식이 마음에 들었다면 C 정렬 알고리즘 실측도 같은 접근입니다.
자주 묻는 질문
k-means 결과가 실행할 때마다 달라지는 이유는 무엇인가요?
k-means 는 지역 최솟값을 찾을 뿐이고, 어느 최솟값에 빠질지는 초기 중심이 정하기 때문입니다. 8개 덩어리로 된 600점에서 데이터 점을 무작위로 고르는 초기화는 시드 200개 중 79번만 최선의 관성(1,170.9)에 도달했고, 끝난 상태가 81가지였습니다. k-means++ 는 200번 중 127번입니다. 10번 돌려 가장 좋은 결과를 고르면 두 방법 모두 20개 그룹 중 20개에서 최선에 도달했습니다.
클러스터가 비면 어떻게 처리해야 하나요?
그대로 두지 말고 복구해야 합니다. 예를 들어 그 중심을 자기 중심에서 가장 먼 점으로 옮깁니다. 파이썬에서는 빈 리스트의 평균이 오류 없이 빈 튜플을 돌려줄 수 있는데, 실험에서는 이 '유령 중심'이 200번 중 36번 모든 점을 빨아들였고 300회 상한까지 수렴하지 않았습니다.
k 값은 어떻게 정하나요?
k 를 바꿔 가며 관성(엘보 방법)과 평균 실루엣 점수를 계산하고 둘 다 봅니다. 덩어리가 잘 떨어진 데이터에서는 둘 다 정답인 k = 8 을 가리켰습니다(실루엣 0.661). 덩어리를 넓히자 팔꿈치가 사라지고 실루엣은 k = 3 을 골랐으니, 둘 다 참고용으로만 쓰는 게 맞습니다.