Parsear HTML con html.parser: extractor de 40 líneas
Curso de web scraping 2: extrae productos con html.parser, arregla URLs relativas con urljoin, limpia espacios y entidades, y mira fallar una regex.
Serie: curso de web scraping 2/6 (principiante). Para ti si ya sabes descargar una página (clase 1) y ahora necesitas los datos que tiene adentro. Al terminar vas a tener un extractor de 40 líneas hecho con html.parser de la biblioteca estándar, vas a saber cuándo leer texto y cuándo leer atributos, y vas a armar links que no den 404.
Todo monitor de precios de una tienda en línea, todo reporte que un cliente freelance quiere "sacado de esa web", tiene un parser en el centro. La mayoría lo escribe la primera vez con str.find o con una expresión regular; funciona en la primera página y se rompe en silencio la semana en que el sitio cambia. Esta clase arma el parser como se debe, solo con la biblioteca estándar, muestra la versión con regex fallando sobre salida real y mide qué tan rápido es cada uno. Todo se ejecutó en una Mac con Apple Silicon (M1 Pro, macOS 26.6) con Python 3.9.6, comparado con Python 3.12.14, contra la tienda de práctica de la clase 1 corriendo en 127.0.0.1:18160 con PHP 8.5.6.
Si todavía no levantaste la tienda, hazlo primero: es un archivo PHP y un comando, en la clase 1.
Qué significa parsear aquí
Una página HTML es texto hecho de etiquetas o tags (<li>, <a>), atributos dentro de las etiquetas (class="product", href="product/101") y texto entre etiquetas (Cable USB-C 1 m). Un par de etiquetas con todo lo que hay adentro es un elemento. Un producto de nuestra tienda se ve así:
  <li class="product" data-id="101">
    <a href="product/101">
      Cable USB-C 1 m
    </a>
    <span class="price">MX$149.00</span>
    <span class="stock out">0</span>
  </li>
Un parser lee ese texto y te dice su estructura. html.parser.HTMLParser es un parser basado en eventos: recorre la página una vez y llama a tus métodos a medida que encuentra cosas. handle_starttag(tag, attrs) para <li ...>, handle_data(text) para el texto, handle_endtag(tag) para </li>. No arma un árbol que puedas consultar después, así que tu código tiene que recordar dónde está: "estoy dentro de un producto", "el texto que viene es el precio".
Suena primitivo al lado de BeautifulSoup, pero viene con cualquier Python, tolera HTML desordenado y alcanza para la mayoría de las páginas de listado.
El extractor de 40 líneas
Guarda esto como extract.py junto a la tienda. La clase del parser más los imports son 39 líneas; main() descarga una página e imprime el resultado.
import sys
import urllib.request
from html.parser import HTMLParser
from urllib.parse import urljoin

UA = "PracticeShopBot/0.1 (+https://example.com/bot-contact)"

class ProductParser(HTMLParser):
    def __init__(self, base_url):
        super().__init__()                      # convert_charrefs=True by default
        self.base_url = base_url
        self.items, self.next_url = [], None
        self.cur, self.field = None, None

    def handle_starttag(self, tag, attrs):
        a = dict(attrs)
        classes = (a.get("class") or "").split()
        if tag == "li" and "product" in classes:
            self.cur = {"id": a.get("data-id"), "name": "", "price": "", "url": None}
        elif self.cur is not None and tag == "a":
            self.cur["url"] = urljoin(self.base_url, a.get("href", ""))
            self.field = "name"
        elif self.cur is not None and tag == "span" and "price" in classes:
            self.field = "price"
        elif tag == "a" and a.get("rel") == "next":
            self.next_url = urljoin(self.base_url, a["href"])

    def handle_endtag(self, tag):
        if tag in ("a", "span"):
            self.field = None
        elif tag == "li" and self.cur is not None:
            self.cur = {k: " ".join(v.split()) if isinstance(v, str) else v
                        for k, v in self.cur.items()}
            self.items.append(self.cur)
            self.cur = None

    def handle_data(self, data):
        if self.cur is not None and self.field:
            self.cur[self.field] += data

def main():
    url = sys.argv[1] if len(sys.argv) > 1 else "http://127.0.0.1:18160/es/products"
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    with urllib.request.urlopen(req, timeout=10) as resp:
        html = resp.read().decode(resp.headers.get_content_charset() or "utf-8")
    p = ProductParser(resp.url)
    p.feed(html)
    p.close()
    for item in p.items:
        print(item)
    print("next:", p.next_url)

if __name__ == "__main__":
    main()
$ python3 extract.py
{'id': '101', 'name': 'Cable USB-C 1 m', 'price': 'MX$149.00', 'url': 'http://127.0.0.1:18160/es/product/101'}
{'id': '102', 'name': 'Mouse inalámbrico', 'price': 'MX$399.00', 'url': 'http://127.0.0.1:18160/es/product/102'}
{'id': '103', 'name': 'Soporte para laptop', 'price': 'MX$549.00', 'url': 'http://127.0.0.1:18160/es/product/103'}
{'id': '104', 'name': 'Teclado mecánico', 'price': 'MX$1,299.00', 'url': 'http://127.0.0.1:18160/es/product/104'}
next: http://127.0.0.1:18160/es/products?page=2
$ python3 extract.py 'http://127.0.0.1:18160/es/products?page=2'
{'id': '105', 'name': 'Monitor de 27"', 'price': 'MX$3,999.00', 'url': 'http://127.0.0.1:18160/es/product/105'}
{'id': '106', 'name': 'Cámara web HD', 'price': 'MX$699.00', 'url': 'http://127.0.0.1:18160/es/product/106'}
{'id': '107', 'name': 'Lámpara de escritorio', 'price': 'MX$329.00', 'url': 'http://127.0.0.1:18160/es/product/107'}
{'id': '108', 'name': 'Audífonos con cancelación de ruido', 'price': 'MX$2,499.00', 'url': 'http://127.0.0.1:18160/es/product/108'}
next: None
Pon la URL entre comillas en la shell: un ? sin comillas es un comodín de archivos, y zsh respondió no matches found cuando lo olvidamos.
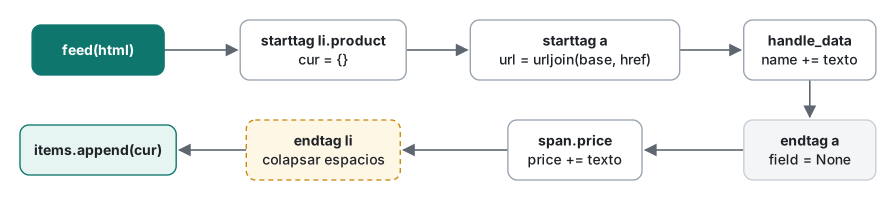
El patrón siempre es el mismo: handle_starttag decide "esto me interesa" y levanta una marca (self.cur, self.field), handle_data junta texto solo mientras la marca está arriba, y handle_endtag baja la marca y guarda el resultado. Si puedes escribir este, puedes escribir un parser para cualquier página de listado.
Texto contra atributos
Algunos datos viven en el texto entre etiquetas (el nombre, el precio) y otros en atributos (el id del producto en data-id, el link en href). attrs llega como una lista de pares, por eso el extractor lo convierte primero en dict. Tres detalles que comprobamos:
li [('class', 'product featured'), ('data-id', '109')] {'class': 'product featured', 'data-id': '109'}
input [('disabled', None), ('value', '3')] {'disabled': None, 'value': '3'}
a [('href', 'x'), ('href', 'y')] {'href': 'y'}
classes un solo string con espacios.<li class="product featured">da'product featured', así quea.get("class") == "product"es False. Sepáralo y pregunta si contiene la clase, como hace el extractor.- Un atributo sin valor da
None. Por eso el código escribe(a.get("class") or "")antes de.split();None.split()se rompería. - Un atributo repetido se queda con el último en
dict(). Es raro, pero pasa en páginas editadas a mano.
Los nombres de atributo llegan en minúsculas, así que HREF y href salen ambos como href. Los valores no se tocan.
Links relativos y urljoin
La tienda escribe los links como href="product/101", una URL relativa: "product/101, a partir de la carpeta de la página actual". Para descargarla necesitas una URL absoluta, y urllib.parse.urljoin la arma igual que un navegador:
http://127.0.0.1:18160/es/products         + product/101              -> http://127.0.0.1:18160/es/product/101
http://127.0.0.1:18160/es/products/        + product/101              -> http://127.0.0.1:18160/es/products/product/101
http://127.0.0.1:18160/                    + product/101              -> http://127.0.0.1:18160/product/101
http://127.0.0.1:18160/es/products?page=1  + ?page=2                  -> http://127.0.0.1:18160/es/products?page=2
http://127.0.0.1:18160/es/products         + /static/101.png          -> http://127.0.0.1:18160/static/101.png
http://127.0.0.1:18160/es/products         + //cdn.example.com/a.png  -> http://cdn.example.com/a.png
http://127.0.0.1:18160/es/products         + https://example.com/     -> https://example.com/
Nunca pegues URLs con + o f-strings: la segunda línea muestra cómo una barra final cambia el resultado. Y la base tiene que ser la página que realmente recibiste. Este es el extractor corrido sobre /, que la tienda redirige a /es/products, con cada base posible:
base=http://127.0.0.1:18160/                -> http://127.0.0.1:18160/product/101  404
base=http://127.0.0.1:18160/es/products     -> http://127.0.0.1:18160/es/product/101  200
Por eso main() pasa resp.url y no la URL que pidió. (Una página también puede declarar <base href="...">, que cambia la base otra vez. Nuestro extractor lo ignora; revísalo si los links salen mal.)
Espacios y entidades
Sin la línea de limpieza en handle_endtag, el nombre conserva cada salto de línea y sangría del código fuente:
{'id': '105', 'name': '\n Monitor de 27"\n ', 'price': 'MX$3,999.00', 'url': 'http://127.0.0.1:18160/es/product/105'}
" ".join(v.split()) lo arregla, y como str.split() sin argumentos corta en cualquier espacio Unicode, también resuelve el espacio de no separación y el espacio de ancho completo:
'27" & HD' -> '27" & HD' -> '27" & HD'
'¥980 (税込)' -> '¥980\xa0(税込)' -> '¥980 (税込)'
'ノートPC スタンド' -> 'ノートPC スタンド' -> 'ノートPC スタンド'
'₩8,900' -> '₩8,900' -> '₩8,900'
'café' -> 'café' -> 'café'
Eso es html.unescape(s) y luego el split y join. Las entidades como &, " o é son la forma en que HTML escribe caracteres que de otro modo lo confundirían; muchos sitios viejos en español todavía escriben á o ñ en lugar de la letra. El código de la tienda tiene Monitor de 27", y nuestro extractor imprimió Monitor de 27" porque HTMLParser las decodifica por defecto. Apágalo y mira lo que pasa:
convert_charrefs = True
  data: 'Practice Shop & Co.'
  data: 'Next »'
convert_charrefs = False
  data: 'Practice Shop '
  entityref: 'amp'
  data: ' Co.'
  data: 'Next '
  entityref: 'raquo'
Con False, el texto llega en pedazos y la entidad va a otro método. Un extractor que solo implementa handle_data pierde el & sin avisar; nuestro extractor de productos con convert_charrefs=False devolvió Monitor de 27 para el producto 105. Deja el valor por defecto.
La trampa de la regex sobre HTML
Esta es la versión que casi todos escriben primero, corrida sobre la página 2 de la tienda:
import re, urllib.request

html = urllib.request.urlopen("http://127.0.0.1:18160/es/products?page=2", timeout=10).read().decode()

# attempt 1: "simple" regex
print("1:", re.findall(r'<a href="(.*?)">(.*?)</a>', html))
# attempt 2: let . match newlines
print("2:", re.findall(r'<a href="(.*?)">(.*?)</a>', html, re.S)[:2])
# attempt 3: greedy by accident
m = re.search(r'<a href="(.*)">', html, re.S)
print("3:", len(m.group(1)), "chars captured as one href")
# attempt 4: the site adds one attribute (same data, same browser view)
v2 = html.replace('<a href=', '<a class="p-link" href=')
print("4:", re.findall(r'<a href="(.*?)">(.*?)</a>', v2, re.S))
1: []
2: [('product/105', '\n      Monitor de 27"\n    '), ('product/106', '\n      Cámara web HD\n    ')]
3: 683 chars captured as one href
4: []
- Nada, porque
.no coincide con un salto de línea y el nombre está en su propia línea. - Con
re.Scoincide, pero te llevas la sangría y el"crudo, y todavía tienes que limpiar las dos cosas. - Quita un
?y.*se traga 683 caracteres, del primer link al último. - El sitio agrega
class="p-link", un cambio que ningún visitante notaría, y la regex encuentra cero links, sin ningún error.
El extractor con html.parser sobre la misma página v2:
v2: ['Monitor de 27"', 'Cámara web HD', 'Lámpara de escritorio', 'Audífonos con cancelación de ruido']
Lee los atributos por nombre, así que su orden y los atributos extra no importan. La regex sigue siendo la herramienta correcta dentro de un campo que ya extrajiste (sacar 1299.00 de MX$1,299.00), pero no para encontrar el campo. Si quieres repasar, mira qué es una expresión regular (en inglés).
Errores comunes y lo que realmente pasa
| Error | Lo que pasó aquí | Arreglo |
|---|---|---|
| Unir los links a la URL pedida | /product/101, 404 |
urljoin(resp.url, href) |
a.get("class") == "product" |
Se salta class="product featured" |
Separar y luego "product" in classes |
convert_charrefs=False con solo handle_data |
Monitor de 27" quedó como Monitor de 27 |
Dejar el valor por defecto |
La página tiene <li> sin </li> |
0 items, no error |
Contar resultados y alarmar con cero (clase 6) |
URL con ? sin comillas en zsh |
no matches found |
Poner la URL entre comillas |
La cuarta fila merece una segunda mirada. Los navegadores cierran el <li> por ti, así que la página rota se ve bien en pantalla, pero html.parser no es un navegador: solo reporta las etiquetas tal como están escritas. Nuestro extractor espera el </li> para guardar un ítem, así que no guardó ninguno y no lanzó nada. Un scraper que devuelve una lista vacía es la forma más peligrosa de estar roto, sobre todo si le entregas el resultado a un cliente.
Qué herramienta para qué página
| Página | Usa | ¿Se ejecutó aquí? |
|---|---|---|
El sitio ofrece JSON (una API, o JSON dentro de un <script>) |
json.loads |
Sí (clase 1) |
| Páginas normales de listado o detalle | html.parser, como en esta clase |
Sí |
| HTML muy desordenado, o quieres selectores CSS | BeautifulSoup o lxml | No, no están instalados |
| Un valor dentro de un texto que ya extrajiste | re |
Sí |
| Contenido armado con JavaScript después de cargar | Busca la petición JSON que hace la página (clase 6) | Solo descrito |
Con BeautifulSoup escribirías soup.select("li.product") en lugar de llevar el estado tú. Es buena opción cuando puedes instalar paquetes; las ideas de esta clase (texto contra atributos, urljoin, espacios) son las mismas.
Medido: velocidad de parseo contra tamaño de página
La tienda puede devolver una página con cualquier cantidad de productos (?per_page=N). Descargamos páginas de 10 a 10,000 productos una vez, parseamos cada una 5 veces y tomamos la mediana (Apple M1 Pro, time.perf_counter, catálogo en español):
| Productos | Tamaño | html.parser 3.9.6 | html.parser 3.12.14 | regex 3.9.6 |
|---|---|---|---|---|
| 10 | 2,062 B | 0.48 ms | 0.31 ms | 0.01 ms |
| 100 | 19,272 B | 4.23 ms | 2.61 ms | 0.07 ms |
| 1,000 | 192,449 B | 41.23 ms | 26.94 ms | 0.68 ms |
| 10,000 | 1,949,209 B | 423.79 ms | 266.26 ms | 7.45 ms |
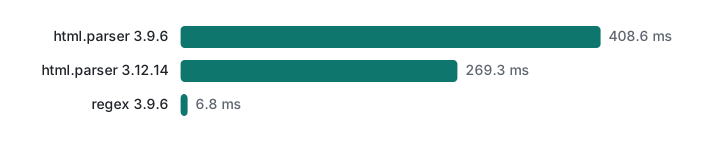
La figura se midió con la página del catálogo en inglés; la del español tiene la misma forma. Tres conclusiones:
- El tiempo crece en línea recta con el tamaño de la página. Unos 24,000 productos (4.6 MB) por segundo en 3.9.6 y unos 37,000 (7 MB) por segundo en 3.12.14, en todos los tamaños.
- El Python más nuevo es unas 1.6 veces más rápido con el mismo código, sin cambiar nada.
- Parsear no es tu cuello de botella. Una página normal de 10 productos tardó medio milisegundo. Con la pausa de 1 segundo de la clase 1 entre peticiones, parsear es el 0.05% de la corrida. Escribe el parser que sobrevive a los rediseños, no el más rápido.
Límites honestos y notas de versión
- Ejecutado en Python 3.9.6 y comparado en 3.12.14; los dos extrajeron los mismos datos.
convert_charrefsvale True por defecto desde Python 3.5. html.parserno arma un árbol, no corrige el anidamiento roto como lo hacen los navegadores (el algoritmo de parseo de HTML5) y no ejecuta JavaScript.- No ejecutamos BeautifulSoup, lxml ni html5lib; no están instalados aquí. Lo que decimos de ellos viene de su documentación, no de una medición.
- Los tamaños de página los genera nuestra tienda. Las páginas reales llevan mucho más marcado por producto, así que se parsean más lento por producto; lo que se mantiene es la forma lineal.
- Las codificaciones distintas de UTF-8 (Windows-1252, ISO-8859-1, comunes en sitios viejos en español) vuelven en la clase 6; mientras tanto, mira cómo detectar la codificación de un texto.
Ejercicios
1. Agrega la cantidad en stock (<span class="stock ...">) a cada ítem sin editar ProductParser.
2. Escribe to_number(text) que convierta los precios de la tienda en números, y haz que funcione con un precio escrito $ 1.299,00, como lo muestran muchas tiendas de Argentina, Colombia, Chile o Brasil.
3. Usando next_url, junta todos los productos de todas las páginas, con una pausa de 1 segundo entre páginas.
Respuestas
1. Hereda de la clase y levanta un campo para el span de stock:
class StockParser(ProductParser):
    def handle_starttag(self, tag, attrs):
        super().handle_starttag(tag, attrs)
        a = dict(attrs)
        if self.cur is not None and tag == "span" and "stock" in (a.get("class") or "").split():
            self.cur.setdefault("stock", "")
            self.field = "stock"
En la página 1 imprimió [('101', 0), ('102', 5), ('103', 9), ('104', 4)] después de convertir con int().
2. Deja solo los dígitos y la marca decimal, y convierte:
import re

def to_number(text, decimal="."):
    s = re.sub(r"[^\d" + re.escape(decimal) + "]", "", text)
    return float(s.replace(decimal, ".")) if s else None

for t in ["MX$1,299.00", "$ 1.299,00", "R$ 1.299,00"]:
    print(t, "->", to_number(t), "| decimal=',' ->", to_number(t, decimal=","))
MX$1,299.00 -> 1299.0 | decimal=',' -> 1.299
$ 1.299,00 -> 1.299 | decimal=',' -> 1299.0
R$ 1.299,00 -> 1.299 | decimal=',' -> 1299.0
La trampa está en las dos columnas: con la marca decimal equivocada el precio queda 1,000 veces más chico, sin ningún error. Si tu cliente compara precios entre México y Argentina, decide el formato por sitio, no por valor. (Para dinero, decimal.Decimal es mejor que float cuando lo guardes.)
3.
import time, urllib.request
from extract import ProductParser, UA

url, items = "http://127.0.0.1:18160/es/products", []
while url:
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    with urllib.request.urlopen(req, timeout=10) as resp:
        p = ProductParser(resp.url)
        p.feed(resp.read().decode())
    items += p.items
    print(url, len(p.items))
    url = p.next_url
    if url:
        time.sleep(1)
print("total", len(items))
http://127.0.0.1:18160/es/products 4
http://127.0.0.1:18160/es/products?page=2 4
total 8
La clase 3 agrega lo que le falta a este bucle: un máximo de páginas, el manejo de respuestas 429 y los reintentos.
Lo que sigue
- Anterior: curso de web scraping 1/6: robots.txt y urllib
- Siguiente: curso de web scraping 3/6: paginación, rate limits y reintentos
- Más adelante: sesiones, formularios, cookies y CSRF, detectar cambios con SQLite, robustez y cambios de diseño
- Cuando el texto sale con caracteres raros: cómo arreglar el mojibake
- Todas las series de clases: la hoja de ruta para aprender a programar
Preguntas frecuentes
¿Por qué los links que saqué dan 404 si se ven bien?
Seguramente los uniste a la URL base equivocada. La tienda redirigió / a /es/products; al unir href="product/101" con la URL que pedimos salió /product/101 (404), y al unirlo con resp.url, la URL a la que realmente llegamos, salió /es/product/101 (200). Pásale siempre la URL final a urljoin.
¿De verdad es tan malo usar regex para scrapear HTML?
En una página exacta puede funcionar y es rápida: unas 60 veces más que html.parser en nuestra medición. Pero el patrón simple no encontró nada hasta agregar re.S, luego capturó los espacios y el " sin decodificar, y no encontró ningún link en cuanto el sitio agregó class="p-link" antes de href. html.parser siguió funcionando con ese cambio.
¿Qué hace convert_charrefs en html.parser?
Con el valor por defecto, convert_charrefs=True, las entidades como & y " se decodifican dentro del texto que recibe handle_data. Con False, el texto se parte y la entidad va a handle_entityref, así que un extractor que solo implementa handle_data pierde caracteres sin avisar: Monitor de 27" salió como Monitor de 27.