Detectar cambios al hacer scraping: SQLite y hashes
Guarda precios en SQLite, detecta cambios reales con hashes de campos, haz upserts idempotentes y programa cron en UTC. Espacio y costo de commit medidos.
Serie: curso de web scraping 5/6 (avanzado). Esta clase es para ti si ya sabes descargar, parsear y paginar con cortesía, y ahora necesitas un scraper que corra todos los días y responda "¿qué cambió desde ayer?". Al terminar vas a guardar snapshots en SQLite, detectar cambios reales de precio y stock con hashes de contenido, lograr que correr el script dos veces no rompa nada, y programarlo con cron usando timestamps en UTC.
El caso típico: un cliente te contrata como freelancer y te dice "scrapeame esta tienda", y unos días después agrega "¿y lo puedes dejar corriendo todas las mañanas para ver cuándo baja el precio?". Seguir precios en tiendas en línea de Latinoamérica es un pedido muy común. Un script que imprime los precios de hoy es fácil; uno que recuerda ayer, avisa solo de cambios reales, aguanta correr dos veces y no llena el disco es otro trabajo, y casi todo ese trabajo es de base de datos.
Todo lo que sigue se ejecutó en una Mac con Apple Silicon (M1 Pro) con Python 3.9.6 (solo biblioteca estándar), SQLite 3.51.0 (la que trae ese Python y la CLI sqlite3) y PHP 8.5.6 sirviendo la tienda de práctica de la serie en 127.0.0.1:18172. Las rutas se acortaron a ~/demo/. Solo scrapeamos nuestro propio sitio de práctica.
Antes de guardar nada: ¿el scraping sigue siendo la herramienta correcta?
Un trabajo diario lo multiplica todo: cada petición que haces la haces 365 veces al año. Por eso lo que vimos en la clase 1 pesa más ahora, no menos.
- Primero la API oficial o el feed. Muchas tiendas y marketplaces ofrecen un feed de productos o una API de afiliados. Es más estable que el HTML y su uso suele estar permitido de forma explícita. Pregúntale al cliente si la tienda es suya o de un socio: a veces basta con pedir un export.
- robots.txt y Crawl-delay. El
robots.txtde la tienda de práctica diceCrawl-delay: 1, así que el monitor espera un segundo entre páginas. Diez páginas tardan unos 9 segundos. Una vez al día es perfectamente razonable; es el precio de ser un buen invitado. - Términos y datos personales. Precios y stock normalmente no son datos personales, pero las reseñas con nombre sí lo son. Si guardas datos de personas en Europa aplica el RGPD (GDPR), y muchos países de la región tienen leyes de protección de datos parecidas. Revisa los términos del sitio y la ley local antes de guardar nada, y guarda solo los campos que necesitas. Esto no es asesoría legal.
- Un User-Agent honesto. Nuestro monitor envía
shopwatch/1.0 (+https://example.com/bot-contact): un nombre y un lugar donde el dueño del sitio puede contactarte.
El modelo de datos: products y snapshots
La tienda de práctica tiene 200 productos en 10 páginas de listado. Cada producto se ve así en el HTML:
<li class="product" data-sku="SKU-0020"><a href="/product/SKU-0020">Cable clip 2</a>
  <span class="price">$66.79</span> <span class="stock">In stock</span></li>
Un archivo de estado en el servidor simula el paso de los días: cada "día" cambia cerca del 4% de los precios y cerca del 3% de los productos entra o sale de stock (generado una vez con random.seed(42)).
Usamos dos tablas. products tiene una fila por producto con lo último que vimos. snapshots tiene una fila solo cuando algo cambió: es el historial de precios.
CREATE TABLE IF NOT EXISTS products (
  sku TEXT PRIMARY KEY, name TEXT NOT NULL, url TEXT NOT NULL,
  first_seen TEXT NOT NULL, last_seen TEXT NOT NULL, last_hash TEXT NOT NULL);
CREATE TABLE IF NOT EXISTS snapshots (
  sku TEXT NOT NULL REFERENCES products(sku), seen_at TEXT NOT NULL,
  price_cents INTEGER NOT NULL, in_stock INTEGER NOT NULL, hash TEXT NOT NULL,
  PRIMARY KEY (sku, seen_at));
Ahí hay tres decisiones escondidas:
- Dinero en centavos enteros.
$66.79se guarda como6679. Los floats y el dinero no se llevan; abajo vas a ver el bug. Si la tienda muestra$ 1.299,90con punto de miles y coma decimal, normaliza ese formato antes de convertir. - Timestamps como texto UTC en ISO 8601 con
Z, por ejemplo2026-10-02T03:00:00Z. En este formato el texto se ordena y se compara bien, y se lee fácil en la CLI desqlite3. - Una clave natural (
sku) en lugar de un id inventado. Es lo que hace posible el upsert. Si el sitio no tiene un id estable, la URL del producto es la siguiente mejor opción.
El monitor: descargar, normalizar, hash, upsert
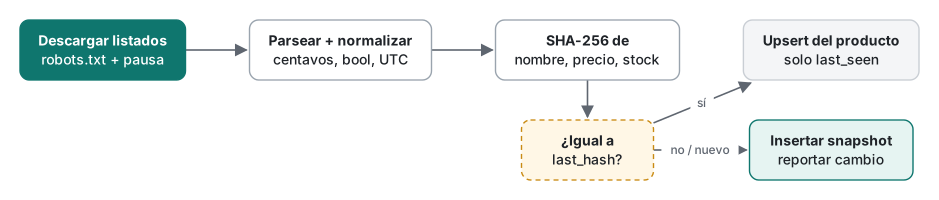
Este es el script completo. Reutiliza el enfoque de html.parser de la clase 2 y el bucle de paginación cortés de la clase 3.
"""shopwatch.py - snapshot a practice shop into SQLite and report price/stock changes.
Python 3.9+ stdlib only. Point it ONLY at a site you run yourself (php -S 127.0.0.1:18172).
"""
import hashlib, json, os, sqlite3, sys, time
import urllib.request, urllib.robotparser
from datetime import datetime, timezone
from html.parser import HTMLParser
from urllib.parse import urljoin

BASE = os.environ.get("SHOP", "http://127.0.0.1:18172")
UA = "shopwatch/1.0 (+https://example.com/bot-contact)"   # honest name + contact page

SCHEMA = """
CREATE TABLE IF NOT EXISTS products (
  sku TEXT PRIMARY KEY, name TEXT NOT NULL, url TEXT NOT NULL,
  first_seen TEXT NOT NULL, last_seen TEXT NOT NULL, last_hash TEXT NOT NULL);
CREATE TABLE IF NOT EXISTS snapshots (
  sku TEXT NOT NULL REFERENCES products(sku), seen_at TEXT NOT NULL,
  price_cents INTEGER NOT NULL, in_stock INTEGER NOT NULL, hash TEXT NOT NULL,
  PRIMARY KEY (sku, seen_at));
"""

class ListParser(HTMLParser):
    def __init__(self):
        super().__init__(); self.items, self.next, self.cur, self.field = [], None, None, None
    def handle_starttag(self, tag, attrs):
        a = dict(attrs)
        if tag == "li" and a.get("class") == "product":
            self.cur = {"sku": a.get("data-sku"), "name": "", "price": None, "stock": None, "url": None}
        elif self.cur is not None and tag == "a":
            self.cur["url"], self.field = a.get("href"), "name"
        elif self.cur is not None and tag == "span":
            self.field = a.get("class")
        elif tag == "a" and a.get("rel") == "next":
            self.next = a.get("href")
    def handle_data(self, data):
        if self.cur is not None and self.field in ("name", "price", "stock"):
            self.cur[self.field] = (self.cur[self.field] or "") + data
    def handle_endtag(self, tag):
        if tag in ("a", "span"): self.field = None
        if tag == "li" and self.cur is not None:
            self.items.append(self.cur); self.cur = None

def normalize(raw, page_url):
    price = raw["price"].strip().lstrip("$").replace(",", "")
    return {"sku": raw["sku"], "name": " ".join(raw["name"].split()),
            "url": urljoin(page_url, raw["url"]),
            "price_cents": round(float(price) * 100),          # money as integer cents
            "in_stock": raw["stock"].strip() == "In stock"}

def content_hash(item):
    # hash only the fields we care about, in a fixed order - never the raw HTML
    key = json.dumps([item["name"], item["price_cents"], item["in_stock"]], separators=(",", ":"))
    return hashlib.sha256(key.encode()).hexdigest()[:16]

def fetch(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    with urllib.request.urlopen(req, timeout=10) as r:
        return r.read().decode(r.headers.get_content_charset() or "utf-8")

def crawl(delay=None):
    rp = urllib.robotparser.RobotFileParser(BASE + "/robots.txt"); rp.read()
    delay = (rp.crawl_delay(UA) or 1) if delay is None else delay
    url, items, pages = BASE + "/products?page=1", [], 0
    while url:
        if not rp.can_fetch(UA, url):
            print("robots.txt disallows", url, file=sys.stderr); break
        p = ListParser(); p.feed(fetch(url)); pages += 1
        items += [normalize(i, url) for i in p.items]
        url = urljoin(url, p.next) if p.next else None
        if url: time.sleep(delay)
    return items, pages

def utc_now():
    fake = os.environ.get("SHOPWATCH_NOW")       # for tests and the 30-day simulation
    return fake or datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")

def store(db, items, now):
    changes = []
    with db:                                      # one transaction per run
        for it in items:
            h = content_hash(it)
            old = db.execute("SELECT last_hash FROM products WHERE sku=?", (it["sku"],)).fetchone()
            db.execute("""INSERT INTO products (sku, name, url, first_seen, last_seen, last_hash)
                          VALUES (?, ?, ?, ?, ?, ?)
                          ON CONFLICT(sku) DO UPDATE SET name=excluded.name, url=excluded.url,
                            last_seen=excluded.last_seen, last_hash=excluded.last_hash""",
                       (it["sku"], it["name"], it["url"], now, now, h))
            if old is None or old[0] != h:        # new product or something changed
                prev = db.execute("""SELECT price_cents, in_stock FROM snapshots WHERE sku=?
                                     ORDER BY seen_at DESC LIMIT 1""", (it["sku"],)).fetchone()
                db.execute("INSERT OR IGNORE INTO snapshots VALUES (?, ?, ?, ?, ?)",
                           (it["sku"], now, it["price_cents"], int(it["in_stock"]), h))
                if prev: changes.append((it["sku"], prev, (it["price_cents"], int(it["in_stock"]))))
    return changes

if __name__ == "__main__":
    db = sqlite3.connect(os.environ.get("SHOPWATCH_DB", "shop.db"), timeout=5)
    db.executescript(SCHEMA)
    t0 = time.perf_counter()
    items, pages = crawl()
    changes = store(db, items, utc_now())
    for sku, (p0, s0), (p1, s1) in changes:
        what = f"price {p0/100:.2f} -> {p1/100:.2f}" if p0 != p1 else f"stock {s0} -> {s1}"
        print(f"CHANGE {sku} {what}")
    print(f"{utc_now()} pages={pages} items={len(items)} changes={len(changes)} "
          f"secs={time.perf_counter() - t0:.1f}")
Lo corrimos dos veces seguidas para el "día 0" y luego para el "día 1":
$ SHOPWATCH_NOW=2026-11-01T03:00:00Z python3 shopwatch.py
2026-11-01T03:00:00Z pages=10 items=200 changes=0 secs=9.2
$ SHOPWATCH_NOW=2026-11-01T03:00:00Z python3 shopwatch.py
2026-11-01T03:00:00Z pages=10 items=200 changes=0 secs=9.1
$ echo 1 > ~/demo/shop/state/day
$ SHOPWATCH_NOW=2026-11-02T03:00:00Z python3 shopwatch.py
CHANGE SKU-0020 price 66.79 -> 63.49
CHANGE SKU-0029 price 84.09 -> 88.29
CHANGE SKU-0036 price 74.89 -> 67.39
CHANGE SKU-0039 stock 1 -> 0
...
CHANGE SKU-0170 price 56.79 -> 53.99
2026-11-02T03:00:00Z pages=10 items=200 changes=10 secs=9.1
$ sqlite3 shop.db "select count(*) from products; select count(*) from snapshots;"
200
210
La segunda corrida del día 0 no cambió nada: ni filas duplicadas ni falsas alertas. Esa propiedad se llama idempotencia: correr el mismo trabajo dos veces tiene el mismo efecto que correrlo una vez. cron reintenta, las laptops se despiertan y se ponen al día, la gente vuelve a apretar el botón; con un trabajo idempotente nada de eso hace daño.
Errores comunes y lo que pasa de verdad
Error 1: sacar el hash del HTML completo. Parece astuto: un hash por página, alerta cuando cambia. Pero nuestra tienda, como la mayoría de los sitios reales, imprime una hora de generación y un id de petición en cada página. En la corrida de 30 días de más abajo, el hash del HTML completo cambió en 290 de 290 descargas. Solo 217 de esas páginas tenían un producto con precio o stock realmente distinto. Solución: hash de los campos normalizados, como hace content_hash(). Un orden fijo de campos (una lista JSON, no un dict armado en cualquier orden) mantiene el hash estable.
Error 2: un INSERT simple para la fila del producto. La segunda corrida se cae:
IntegrityError: UNIQUE constraint failed: products.sku
Error 3: "arreglarlo" con INSERT OR REPLACE. Corre, pero REPLACE significa borra la fila vieja e inserta una nueva. En nuestra prueba insertamos SKU-0001 el 1 de octubre y lo reemplazamos el 2:
after OR REPLACE: (2, 'SKU-0001', 'Desk lamp 1', '2026-10-02T03:00:00Z', '2026-10-02T03:00:00Z')
after upsert:     (2, 'SKU-0001', 'Desk lamp 1', '2026-10-02T03:00:00Z', '2026-10-03T03:00:00Z')
El rowid saltó de 1 a 2 y first_seen ahora dice 2 de octubre: el historial quedó mal sin ningún aviso. Con claves foráneas activas, el borrado además puede propagarse o fallar. Solución: INSERT ... ON CONFLICT(sku) DO UPDATE SET ... (SQLite 3.24 o posterior), nombrando solo las columnas que deben cambiar. first_seen no se toca.
Error 4: dinero con int(float(...)). int(float("4.35") * 100) da 434, porque 4.35 * 100 es 434.99999999999994 e int() trunca. Probamos todos los precios de 1.00 a 99.99: 570 de 9,900 quedaron un centavo abajo. Solución: round(), como arriba, o decimal.Decimal si además haces cuentas.
Error 5: hora local en la base. Con la zona horaria del proceso fijada en un desfase de 5 horas (TZ=EST5), tres relojes no coinciden:
python datetime.now()          : 2026-11-14 18:16:36 (naive local)
python datetime.now(utc)       : 2026-11-14T23:16:36Z
sqlite datetime('now')         : 2026-11-14 23:16:36
El datetime('now') de SQLite está en UTC. Mézclalo con horas locales sin zona de Python y "cambió en las últimas 24 horas" se corre varias horas, y en servidores con horario de verano, dos veces al año un poco más. Solución: escribe UTC con Z en todas partes y convierte a hora local solo para mostrar.
Consultar el historial
Un historial de solo cambios responde cualquier pregunta, porque el estado de un producto en el momento T es su último snapshot en T o antes:
SELECT price_cents, in_stock, seen_at FROM snapshots
WHERE sku='SKU-0020' AND seen_at <= '2026-10-20T23:59:59Z'
ORDER BY seen_at DESC LIMIT 1;
-- 4589 | 1 | 2026-10-17T03:00:00Z
Y "las mayores bajas de precio de la corrida de hoy" es una función de ventana (SQLite 3.25+):
WITH ordered AS (
  SELECT sku, seen_at, price_cents,
         LAG(price_cents) OVER (PARTITION BY sku ORDER BY seen_at) AS before
  FROM snapshots)
SELECT sku, before, price_cents AS now, ROUND(100.0*(price_cents-before)/before,1) AS pct
FROM ordered WHERE seen_at = '2026-10-30T03:00:00Z' AND price_cents < before
ORDER BY pct LIMIT 3;
sku       before  now   pct
--------  ------  ----  -----
SKU-0036  5439    4619  -15.1
SKU-0162  8629    7329  -15.1
SKU-0111  5469    4649  -15.0
Esto es justo lo que el cliente quiere ver en su reporte semanal. Si WHERE, ORDER BY y LIMIT son nuevos para ti, empieza por SQL desde cero: SELECT, WHERE y ORDER BY.
Medido: crecimiento del archivo, deduplicación y costo del commit
30 días contra la tienda de práctica. Corrimos el monitor una vez por día simulado durante 30 días (crawl delay de 1 segundo, unos 9 segundos por corrida) y, con los mismos datos parseados, escribimos además una segunda base que guarda todos los productos en cada corrida. Tras 30 corridas:
| Almacenamiento | filas de snapshot | tamaño del archivo |
|---|---|---|
| solo cambios (el monitor) | 594 | 110,592 bytes |
| todos los productos, cada corrida | 6,000 | 577,536 bytes |
Las 594 filas son los 200 primeros avistamientos más 394 cambios reales.
Un año, sin HTTP. Para ver el crecimiento a escala insertamos directo 2,000 productos × 365 corridas diarias (7% de cambio por día, random.seed(7)):
| después de | cada corrida: filas / MB | solo cambios: filas / MB |
|---|---|---|
| 30 días | 60,000 / 6.13 | 6,095 / 0.62 |
| 90 días | 180,000 / 18.50 | 14,544 / 1.48 |
| 365 días | 730,000 / 77.05 | 52,940 / 5.44 |
La vista dbstat mostró que 33.6 MB de los 77 MB eran el índice automático detrás de PRIMARY KEY (sku, seen_at), porque una tabla normal guarda la clave dos veces (en el índice y en la tabla). Declarar la tabla WITHOUT ROWID guarda las filas directamente en el orden de la clave:

Costo del commit. El otro número que sorprende: 10,000 upserts en una base en archivo, mediana de 5 corridas.
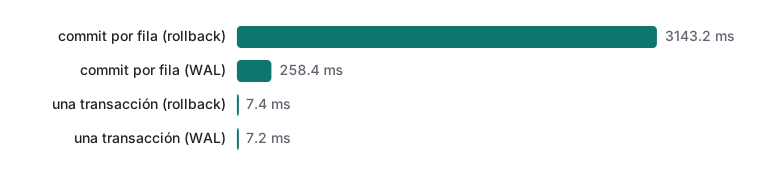
Hacer commit después de cada fila tardó 3,143.2 ms con el journal de rollback por defecto y 258.4 ms en modo WAL; una sola transacción tardó 7.4 ms y 7.2 ms. Cada commit tiene que llegar al disco; uno por corrida alcanza. Por eso store() envuelve toda la corrida en with db:, lo que además significa que si el proceso se cae a la mitad quedan intactos los datos de ayer, no la mitad de los de hoy.
Programar con cron, en UTC
No instalamos nada en la máquina de prueba; esta es la línea que agregarías con crontab -e en un servidor Linux o una Mac que administres:
15 3 * * * cd "$HOME/demo/shopwatch" && /usr/bin/python3 shopwatch.py >> logs/shopwatch.log 2>&1
- Ruta absoluta al intérprete. cron corre con un
PATHmínimo;python3a secas puede no encontrarse. - Registra todo.
>> ... 2>&1guarda también los tracebacks. Scripts de shell robustos, cron y logs (en inglés) cubre la rotación y los códigos de salida. - cron usa la hora local de la máquina para el horario. Algunas implementaciones (cronie en muchas distribuciones Linux) aceptan
CRON_TZ=UTC; aquí no lo corrimos. De cualquier forma, los datos quedan en UTC porque los escribe el script. - Corridas que se pisan. Si una corrida se alarga y arranca la siguiente, se encuentran dos escritores. Lo reprodujimos: una conexión con una transacción de escritura abierta y otra intentando insertar.
timeout=0: OperationalError: database is locked after 0.00 s
timeout=2: OperationalError: database is locked after 2.11 s
El argumento timeout hace que SQLite espere el lock; no elimina el conflicto. Programa el trabajo con un intervalo bastante mayor que lo que tarda, agrega un lock (por ejemplo mkdir "$HOME/demo/shopwatch/.lock" al inicio y rmdir al final, saltando la corrida si mkdir falla) y mantén el trabajo idempotente para que una corrida saltada o doble no haga daño.
Qué opción de almacenamiento y cuándo
| Situación | Elección |
|---|---|
| Necesitas historial de precios y alertas | products + snapshots de solo cambios, como arriba |
| Debes demostrar cómo se veía la página en una fecha | guarda también el HTML comprimido, pero nunca lo uses para el hash |
| Pocos productos, prototipo rápido | una tabla, todo en cada corrida; cámbiala antes de que crezca |
| Muchos lectores, un escritor | SQLite en modo WAL alcanza |
| Varias máquinas escriben a la vez | una base de servidor (PostgreSQL, MySQL); SQLite es una base de un solo archivo |
| El sitio envía ETag o Last-Modified | peticiones condicionales para saltar páginas sin cambios; ver caché HTTP |
Límites honestos y notas de versión
- Verificado con Python 3.9.6 y SQLite 3.51.0.
ON CONFLICT ... DO UPDATErequiere SQLite 3.24 (2018) yLAG()requiere 3.25; revisasqlite3.sqlite_versionen tu servidor, que puede ser más viejo que tu laptop. - La tienda de práctica tiene SKUs estables. Los sitios reales cambian ids, juntan variantes y muestran precios distintos según región o sesión. Elegir la clave es la parte más difícil.
requestsestaba instalado por casualidad en esta máquina, pero el script usa solo la biblioteca estándar. Conrequestsla descarga seríarequests.get(url, headers=..., timeout=10).text; no se ejecutó aquí.- Los tamaños dependen del tamaño de página, el largo de la clave y la versión de SQLite. Vuelve a medir con tus propios datos antes de planificar el disco.
- Un SHA-256 truncado a 16 dígitos hex (64 bits) sobra para detectar cambios en miles de filas; no es una medida de seguridad.
Ejercicios
- Agrega un reporte de
removed: un producto que estaba enproductspero no apareció en la corrida de hoy. ¿Qué columna ya te lo dice? - Escribe el SQL que lista los productos que se quedaron sin stock en la corrida de
2026-10-23T03:00:00Z.
Respuestas
last_seen. Después destore(),SELECT sku FROM products WHERE last_seen < ?con el timestamp de hoy lista los productos que no se vieron en esta corrida. No los borres: un producto que falta un día suele ser una página que falló (clase 6).- Usa
LAG(in_stock)igual que en la consulta de precios:WITH o AS (SELECT sku, seen_at, in_stock, LAG(in_stock) OVER (PARTITION BY sku ORDER BY seen_at) AS before FROM snapshots) SELECT sku FROM o WHERE seen_at='2026-10-23T03:00:00Z' AND before=1 AND in_stock=0;. En nuestros datos devuelveSKU-0020ySKU-0136.
Navegación de la serie
- Anterior: curso de web scraping 4/6: sesiones, formularios, cookies y CSRF
- Siguiente: curso de web scraping 6/6: robustez, monitoreo y cambios de diseño
- Inicio de la serie: clase 1/6: robots.txt y urllib
- Probar código que depende del tiempo: tests inestables: tiempo, aleatoriedad y concurrencia
- Todas las series: la hoja de ruta para aprender a programar
Preguntas frecuentes
¿Conviene sacar el hash del HTML completo para detectar cambios?
No. Casi toda página trae algo que cambia en cada petición, como la hora de generación, un id de petición o un token CSRF. En nuestra corrida de 30 días el hash del HTML completo cambió en las 290 descargas de página, mientras que solo 217 de esas páginas tenían un producto que de verdad cambió. Calcula el hash solo de los campos normalizados que te importan: nombre, precio en centavos y stock.
¿INSERT OR REPLACE es lo mismo que un upsert en SQLite?
No. INSERT OR REPLACE borra la fila vieja e inserta una nueva, así que toda columna que no pases se reinicia y el rowid cambia. En nuestra prueba first_seen se sobrescribió y el rowid pasó de 1 a 2. INSERT ... ON CONFLICT(sku) DO UPDATE actualiza solo las columnas que nombras y conserva la fila.
¿Cuánto espacio ocupan los snapshots diarios de precios en SQLite?
Depende de si guardas todas las filas o solo los cambios. Con 2,000 productos durante 365 corridas diarias y 7% de cambios por día, guardar todo ocupó 77.05 MB y guardar solo cambios 5.44 MB; una tabla WITHOUT ROWID los bajó a 48.67 MB y 3.31 MB.