Iteradores y generadores en Python: memoria medida
__iter__/__next__ a mano, generadores, yield from, itertools y la trampa del iterador agotado: una lista ocupó 390 MiB y un generador 0.3 KiB.
Serie: curso de Python 3/6 (intermedio). Para quien ya escribe funciones y bucles y ahora tiene que procesar datos que no caben cómodos en memoria. Al terminar vas a poder escribir tus propios iteradores, armar pipelines de generadores y demostrar la diferencia de memoria con un número, no con una corazonada.
Quizás te pasó en tu primer trabajo en una startup: un script que procesa el log del servidor muere a la mitad del archivo, o un bucle sobre "los mismos" datos no imprime nada la segunda vez y pierdes la tarde buscando el porqué. Las dos cosas vienen de una sola idea, el protocolo de iteración, y las dos se arreglan fácil cuando la ves. Todas las mediciones de abajo se hicieron en Python 3.9 sobre una Mac con Apple Silicon (M1 Pro), y las salidas están pegadas sin editar, salvo las rutas locales, que acortamos a ~/demo/.
La versión corta: una expresión generadora que suma diez millones de cuadrados tuvo un pico de 0.3 KiB de memoria rastreada; la comprensión de listas equivalente, 390 MiB, y el tiempo fue el mismo con un margen de 5 %. Un procesador de logs en streaming sobre un archivo de 86 MiB tuvo un pico de 29.7 KiB; la versión con readlines() llegó a 1,027 MiB y fue tres veces más lenta.
El protocolo de iteración, escrito a mano
Un bucle for no sabe nada de listas. Llama a iter(obj), que a su vez llama a obj.__iter__() y tiene que recibir un iterador. Después llama a next() sobre ese iterador, que llama a __next__(), hasta que se lanza StopIteration. Ese es todo el protocolo.
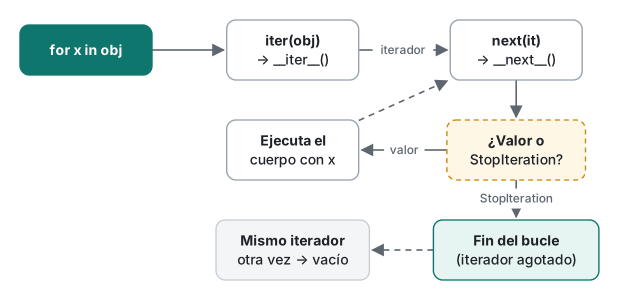
La forma más limpia de escribirlo a mano es separar el iterable (lo que puedes recorrer muchas veces) del iterador (el cursor que recuerda en qué posición va):
class Countdown:
    """Iterable: each for loop gets a fresh iterator."""
    def __init__(self, start):
        self.start = start
    def __iter__(self):
        return CountdownIter(self.start)

class CountdownIter:
    def __init__(self, n):
        self.n = n
    def __iter__(self):
        return self
    def __next__(self):
        if self.n <= 0:
            raise StopIteration
        self.n -= 1
        return self.n + 1

c = Countdown(3)
print(list(c), list(c))          # reusable
it = iter(c)
print(next(it), next(it), next(it))
try:
    next(it)
except StopIteration:
    print("StopIteration raised")
print(next(it, "default"))
[3, 2, 1] [3, 2, 1]
3 2 1
StopIteration raised
default
Fíjate en dos detalles. El __iter__ del propio iterador devuelve self, así que un iterador sirve en cualquier lugar donde se espera un iterable. Y next(it, default) devuelve el valor por defecto en vez de lanzar la excepción, algo muy práctico para "el primer resultado que coincida, o None".
Error común: el contenedor que es su propio iterador
Muchos primeros intentos ponen __next__ en el contenedor mismo y devuelven self desde __iter__:
class Bag:
    def __init__(self, items):
        self.items, self.i = items, 0
    def __iter__(self):
        return self              # BUG: the container is its own iterator
    def __next__(self):
        if self.i >= len(self.items):
            raise StopIteration
        self.i += 1
        return self.items[self.i - 1]

b = Bag(["x", "y"])
print(list(b), list(b))
print([(p, q) for p in b for q in b])
['x', 'y'] []
[]
No hay error, solo respuestas equivocadas: el segundo recorrido sale vacío, y un bucle anidado sobre el mismo objeto comparte un único cursor. Solución: devuelve un iterador nuevo desde __iter__ (como hace Countdown) o, mucho más corto, convierte __iter__ en un generador: def __iter__(self): yield from self.items.
Generadores: el protocolo gratis
Una función que contiene yield devuelve un objeto generador cuando la llamas. El cuerpo no se ejecuta hasta el primer next(). Cada yield entrega un valor y congela el estado local de la función hasta el siguiente pedido.
def countdown(n):
    while n > 0:
        yield n
        n -= 1

g = countdown(3)
print(g)
print(list(g), list(g))
<generator object countdown at 0x1030ce900>
[3, 2, 1] []
El mismo resultado que veinte líneas de clase, con la misma trampa en la última línea: un generador es un iterador, así que se usa una sola vez.
yield from delega en otro iterable. Es la forma natural de escribir generadores recursivos, y además deja pasar el valor de return del generador interno:
def walk(tree):
    for node in tree:
        if isinstance(node, list):
            yield from walk(node)
        else:
            yield node
print(list(walk([1, [2, [3, 4]], 5])))

def inner():
    yield 1
    yield 2
    return "inner done"
def outer():
    result = yield from inner()
    print("outer got:", result)
print(list(outer()))
[1, 2, 3, 4, 5]
outer got: inner done
[1, 2]
Una expresión generadora es la forma de una línea: (x * x for x in data). Cuando es el único argumento de una función, puedes quitar los paréntesis extra: sum(x * x for x in data).
Trampa: StopIteration dentro de un generador se convierte en RuntimeError
Desde Python 3.7 (PEP 479), un StopIteration que se escapa del cuerpo de un generador se convierte en RuntimeError. Esto muerde al código que llama a next() sin valor por defecto dentro de un generador:
def first_words(lines):
    it = iter(lines)
    while True:
        line = next(it)          # raises StopIteration at the end...
        yield line.split()[0]

print(list(first_words(["hello world", "good bye"])))
Traceback (most recent call last):
  File "~/demo/pep479.py", line 4, in first_words
    line = next(it)          # raises StopIteration at the end...
StopIteration

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "~/demo/pep479.py", line 7, in <module>
    print(list(first_words(["hello world", "good bye"])))
RuntimeError: generator raised StopIteration
Solución: for line in lines: yield line.split()[0], o un return explícito cuando next(it, None) devuelva None.
La trampa del iterador agotado, con salida real
Este es el bug que le cuesta una tarde a cualquiera, porque nada falla en la línea donde está el error. Parseas filas con una expresión generadora "para ahorrar memoria" y después la recorres dos veces:
rows = ["alice,30", "bob,25", "carol,41"]
parsed = (line.split(",") for line in rows)
names = [p[0] for p in parsed]
ages  = [int(p[1]) for p in parsed]
print(names, ages)
print(sum(ages) / len(ages))
['alice', 'bob', 'carol'] []
Traceback (most recent call last):
  File "~/demo/trap.py", line 6, in <module>
    print(sum(ages) / len(ages))
ZeroDivisionError: division by zero
El error aparece dos líneas después del error real, y habla de una división, no de iteración. Lo mismo pasa con map, filter, zip, los objetos de archivo y csv.reader, que en Python 3 son todos iteradores:
nums = map(int, ["3", "1", "2"])
print(max(nums))
print(min(nums))
3
Traceback (most recent call last):
  File "~/demo/trap2.py", line 3, in <module>
    print(min(nums))
ValueError: min() arg is an empty sequence
Dos sorpresas relacionadas: 3 in iter([1, 2, 3, 4]) devuelve True y consume 1, 2 y 3 (un list() posterior da [4]), y len(zip(...)) falla con TypeError: object of type 'zip' has no len(), porque un iterador no conoce su longitud sin consumirse.
Solución, según lo que necesites:
| Situación | Qué hacer |
|---|---|
| Necesitas los datos dos veces y son pocos | parsed = [line.split(",") for line in rows] (una lista) |
| Necesitas dos agregados en una sola pasada | Un solo bucle for que actualice los dos |
| Necesitas dos recorridos independientes sobre un stream | itertools.tee, pero solo si los recorridos avanzan juntos; si no, guarda todo en un buffer |
| Quieres un objeto perezoso reutilizable | Una clase cuyo __iter__ sea un generador |
Necesitas len() |
Materializa la lista, o cuenta mientras iteras |
Lo esencial de itertools
itertools es un conjunto de piezas que reciben iteradores y devuelven iteradores, así que se combinan sin crear listas intermedias. Las que vale la pena memorizar, con salida real de Python 3.9:
import itertools as it

print(list(it.islice(it.count(10, 5), 4)))
print(list(it.chain([1, 2], (3, 4), "ab")))
print(list(it.chain.from_iterable([[1], [2, 3], []])))
rows = [("ja", "tokyo"), ("ja", "osaka"), ("ko", "seoul"), ("ja", "nagoya")]
print([(k, [c for _, c in g]) for k, g in it.groupby(rows, key=lambda r: r[0])])
print([(k, [c for _, c in g]) for k, g in it.groupby(sorted(rows), key=lambda r: r[0])])
print(list(it.accumulate([3, 1, 4, 1, 5])))
print(list(it.takewhile(lambda x: x < 4, [1, 3, 5, 2])))
print(list(it.zip_longest("abc", [1], fillvalue="-")))
print(list(it.combinations([1, 2, 3], 2)))
[10, 15, 20, 25]
[1, 2, 3, 4, 'a', 'b']
[1, 2, 3]
[('ja', ['tokyo', 'osaka']), ('ko', ['seoul']), ('ja', ['nagoya'])]
[('ja', ['nagoya', 'osaka', 'tokyo']), ('ko', ['seoul'])]
[3, 4, 8, 9, 14]
[1, 3]
[('a', 1), ('b', '-'), ('c', '-')]
[(1, 2), (1, 3), (2, 3)]
Mira las dos líneas de groupby. groupby solo agrupa claves iguales consecutivas, así que con datos sin ordenar ja aparece dos veces. No es un bug de itertools: es justamente lo que le permite a groupby funcionar sobre un stream infinito. Ordena primero, o usa un dict/Counter si los datos caben en memoria.
count es infinito, así que hay que cortarlo con islice o takewhile; list(it.count()) nunca termina. Un divisor en bloques (chunker) que funciona con cualquier iterador, incluido un archivo:
def chunks(iterable, size):
    iterator = iter(iterable)
    while True:
        block = list(it.islice(iterator, size))
        if not block:
            return
        yield block
print(list(chunks(range(7), 3)))   # [[0, 1, 2], [3, 4, 5], [6]]
Python 3.12 agregó itertools.batched justo para esto, y 3.10 agregó pairwise. En nuestro Python 3.9, itertools.pairwise lanzó AttributeError: module 'itertools' has no attribute 'pairwise'; en Python 3.11 funcionó, y batched seguía sin existir. Si das soporte a 3.9, quédate con la versión escrita a mano.
Medición: comprensión de listas vs expresión generadora
La memoria se midió con tracemalloc (el pico de memoria rastreada durante la llamada) y el tiempo en una pasada aparte con el rastreo apagado, mejor de 5, porque en un primer intento el rastreo mismo hizo el código más de 10 veces más lento.
"""List vs generator: tracemalloc peak and wall time (Python 3.9)."""
import time, tracemalloc

def sum_list(n):  return sum([i * i for i in range(n)])
def sum_gen(n):   return sum(i * i for i in range(n))

def peak_kb(fn, n):
    tracemalloc.start()
    fn(n)
    _, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return peak / 1024

def best_ms(fn, n, repeat=5):
    best = float("inf")
    for _ in range(repeat):
        t0 = time.perf_counter()
        fn(n)
        best = min(best, time.perf_counter() - t0)
    return best * 1000

for n in (1_000_000, 10_000_000):
    for label, fn in (("list comp", sum_list), ("generator", sum_gen)):
        print(f"n={n:>10,}  {label:<10} peak={peak_kb(fn, n):>11,.1f} KB"
              f"  best of 5={best_ms(fn, n):8.1f} ms")
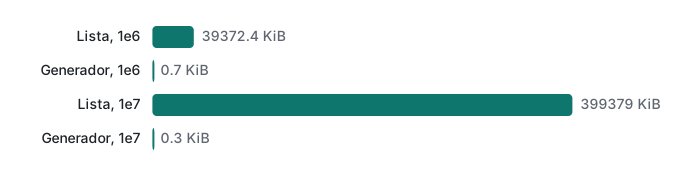
n= 1,000,000  list comp  peak=   39,372.4 KB  best of 5=    42.0 ms
n= 1,000,000  generator  peak=        0.7 KB  best of 5=    43.0 ms
n=10,000,000  list comp  peak=  399,378.7 KB  best of 5=   493.5 ms
n=10,000,000  generator  peak=        0.3 KB  best of 5=   516.5 ms
(El "KB" de la salida es KiB, porque dividimos por 1024.) Una segunda ejecución dio 40.2/43.7 ms y 503.1/522.4 ms, con cifras de memoria idénticas.
Qué dicen los números:
- La memoria de la lista crece en forma lineal: unos 40 bytes por elemento (un puntero de 8 bytes en la lista más un objeto int de 32 bytes para los cuadrados grandes). Diez millones de elementos son 390 MiB antes de hacer nada útil.
- El pico del generador se queda por debajo de 1 KiB sin importar
n, porque existe un solo valor a la vez. - En velocidad, empate. Aquí el generador fue entre 2 y 7 % más lento, porque reanudar un frame por cada elemento cuesta un poco más que agregar a una lista. Elige un generador por memoria y por la posibilidad de cortar antes, no por velocidad.
Un procesador de archivos grandes en streaming
El uso real: un archivo de log demasiado grande para cargarlo cómodo. El script de abajo escribe un log de acceso falso de 2,000,000 de líneas (86 MiB, semilla 7) y después cuenta los errores HTTP 500 por ruta de dos maneras: con un pipeline de generadores, y con readlines() más comprensiones de listas.
"""Streaming a large log file with a generator pipeline (Python 3.9 stdlib)."""
import os, random, sys, time, tracemalloc
from collections import Counter

PATH = "access.log"

def make_log(path, n=2_000_000, seed=7):
    rng = random.Random(seed)
    paths = ["/", "/api/v1/user", "/api/v1/items", "/static/app.js", "/login"]
    codes = [200] * 90 + [304] * 5 + [404] * 3 + [500] * 2
    with open(path, "w") as f:
        for i in range(n):
            f.write(f"2026-11-12T10:{i % 60:02d}:00 GET {rng.choice(paths)} "
                    f"{rng.choice(codes)} {rng.randint(80, 9000)}ms\n")

def read_lines(path):
    with open(path) as f:
        for line in f:                 # the file object is itself a lazy iterator
            yield line.rstrip("\n")

def parse(lines):
    for line in lines:
        _ts, _method, path, code, ms = line.split(" ")
        yield path, int(code), int(ms[:-2])

def only_errors(records):
    return (r for r in records if r[1] >= 500)

def streaming(path):
    return Counter(p for p, _c, _ms in only_errors(parse(read_lines(path))))

def eager(path):
    with open(path) as f:
        lines = f.readlines()                       # whole file in memory
    records = [l.rstrip("\n").split(" ") for l in lines]
    return Counter(r[2] for r in records if int(r[3]) >= 500)

def run(fn):
    tracemalloc.start()
    res = fn(PATH)
    peak = tracemalloc.get_traced_memory()[1]
    tracemalloc.stop()
    t0 = time.perf_counter(); fn(PATH); dt = time.perf_counter() - t0
    print(f"{fn.__name__:<10} peak={peak/1024:11,.1f} KiB  time(no tracing)={dt:5.2f} s  {res.most_common(2)}")

if __name__ == "__main__":
    if not os.path.exists(PATH):
        make_log(PATH)
    print(f"file: {os.path.getsize(PATH)/2**20:.1f} MiB, Python {sys.version.split()[0]}")
    run(streaming)
    run(eager)
file: 86.0 MiB, Python 3.9.6
streaming  peak=       29.7 KiB  time(no tracing)= 1.13 s  [('/', 8057), ('/static/app.js', 8044)]
eager      peak=1,051,415.9 KiB  time(no tracing)= 3.89 s  [('/', 8057), ('/static/app.js', 8044)]
En cinco ejecuciones, la versión en streaming tardó 1.11–1.37 s y la versión eager 3.55–3.89 s. Las dos encontraron los mismos 40,053 errores. En la versión eager, un archivo de 86 MiB se convirtió en 1 GiB de objetos de Python: cada línea pasa a ser un str (unos 100 bytes con su encabezado), y después una lista de cinco str más. El pipeline en streaming mantiene una sola línea a la vez, y cada etapa son unas pocas líneas que puedes probar por separado pasándole una lista común. Además deja de leer en cuanto el consumidor se detiene: si cambias Counter(...) por next(...), solo lee hasta el primer error.
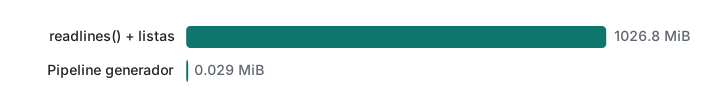
send(), en pocas palabras
Los generadores también pueden recibir valores: value = yield x entrega x y se pausa; gen.send(v) lo reanuda con value = v. Un promedio móvil:
def running_avg():
    total, count, avg = 0.0, 0, None
    while True:
        value = yield avg
        total += value
        count += 1
        avg = total / count

avg = running_avg()
print(next(avg))          # prime it: runs to the first yield
print(avg.send(10))
print(avg.send(20))
print(avg.send(60))
fresh = running_avg()
fresh.send(5)
None
10.0
15.0
30.0
Traceback (most recent call last):
  File "~/demo/send.py", line 15, in <module>
    fresh.send(5)
TypeError: can't send non-None value to a just-started generator
La última línea es el error clásico: un generador recién creado todavía no llegó a ningún yield, así que no hay dónde entregar el valor. Llama a next() una vez primero. Este mecanismo de send/yield es la base sobre la que se construyeron las corrutinas al estilo antiguo, antes de async/await; en código nuevo, una clase chica con un método suele ser más clara, y el curso 5 trata asyncio.
¿Cuál conviene usar?
| Tienes | Usa |
|---|---|
Pocos datos, que necesitas más de una vez, con len() o índices |
lista |
| Una sola pasada sobre datos grandes o sin fin | expresión generadora o función generadora |
| Varios pasos de transformación sobre un stream | un pipeline de funciones generadoras |
| Una colección propia que se recorre muchas veces | clase con __iter__ escrito como generador |
Un iterador con estado explícito al que otros llamarán con next() |
clase con __iter__ + __next__ |
| Agrupar, cortar, encadenar, combinaciones | itertools antes de escribir lo tuyo |
Límites honestos y notas de versión
- Todos los tiempos: Python 3.9.6, Mac con Apple Silicon (M1 Pro), mejor de 5 (bucle de memoria) o una ejecución repetida 5 veces (archivo de log). Semillas fijas (7 para el log). Python 3.11 se usó solo para comprobar comportamiento y mensajes de error, nunca para medir tiempos.
tracemalloccuenta la memoria asignada a través de los allocators de Python. No es la RSS: el intérprete mismo y los buffers asignados por fuera de esos allocators no aparecen en la cifra. Es la herramienta correcta para comparar dos versiones del mismo código, no para dimensionar un contenedor.- Python 3.11 agrega marcadores (
~~~~^~~~) debajo de la expresión que falla en los tracebacks; aparte de eso, los mensajes de arriba fueron idénticos en 3.9 y 3.11. - La PEP 479 (
StopIteration→RuntimeError) es el comportamiento por defecto desde 3.7.itertools.pairwisees de 3.10+ (comprobado: no existe en 3.9, sí en 3.11);itertools.batchedes de 3.12+ y no se ejecutó aquí.
Navegación de la serie: anterior: Curso de Python 2: funciones, ámbito y argumentos por defecto · siguiente: Curso de Python 4: decoradores y context managers. La misma idea de evaluación perezosa aparece como ejecución diferida en fundamentos de LINQ en C# (en inglés), y el curso 6, profiling y optimización, profundiza en cómo medir memoria y tiempo.
Preguntas frecuentes
¿Por qué mi generador en Python devuelve una lista vacía la segunda vez?
Un generador es un iterador, y un iterador se consume una sola vez. Después del primer list() o del primer for queda agotado, y cualquier recorrido posterior no produce nada, sin lanzar error. Guarda los resultados en una lista si los necesitas dos veces, o crea una clase cuyo __iter__ devuelva un iterador nuevo cada vez.
¿Cuánta memoria ahorra una expresión generadora frente a una comprensión de listas?
Para sum(i * i for i in range(10_000_000)) en Python 3.9, tracemalloc reportó un pico de 0.3 KiB con el generador y de 399,379 KiB (unos 390 MiB) con la comprensión de listas. El tiempo fue casi el mismo: 0.52 s contra 0.50 s.
¿Un generador es más rápido que una lista en Python?
No por sí solo. En nuestras pruebas el generador fue entre 2 y 7 % más lento para una suma simple. Gana cuando la lista sería tan grande que presiona la memoria, o cuando puedes cortar antes de terminar. Nuestro procesador de logs en streaming fue unas 3 veces más rápido que readlines() solo porque evitó crear 1 GiB de objetos.