Profiling en Python: qué aceleró el código de verdad
timeit, cProfile y tracemalloc sobre un contador de palabras lento: de 4.39 s a 31 ms paso a paso, y los trucos populares que, medidos, no sirvieron.
Serie: curso de Python 6/6 (avanzado). Para quien tiene código Python que funciona pero es demasiado lento, y quiere un método en vez de una lista de trucos. Al terminar vas a poder medir, encontrar el verdadero punto caliente, arreglarlo y demostrar que el arreglo funciona, y vas a saber qué "tips de velocidad" populares conviene ignorar.
Este curso resuelve el problema de quien ya reescribió tres bucles "para que vaya más rápido" y no ganó nada: el típico caso del script de análisis de datos de un trabajo práctico de la facultad, o del proceso nocturno que un cliente de tu trabajo freelance dice que "tarda demasiado". Tomamos un programa lento a propósito, lo perfilamos y lo arreglamos de a un paso, con un tiempo medido después de cada paso. El resultado: un solo cambio aceleró 78× el programa entero, y la mayoría de los micro-trucos famosos movieron el total menos que el ruido de la medición.
Todos los tiempos se tomaron en Python 3.9.6 sobre una Mac con Apple Silicon (M1 Pro). También tenemos un Python 3.11, pero corre bajo la traducción de Rosetta 2, así que no cronometramos nada con él. Más sobre eso al final.
El programa lento
Un contador de frecuencia de palabras: 200,000 palabras sacadas de un vocabulario de 5,000 palabras al azar (semilla fija 42), pasadas a minúsculas, deduplicadas en el orden en que aparecen, contadas, y con las 5 más frecuentes impresas. Está escrito como se escriben muchas primeras versiones.
# wordfreq_slow.py
import random

def make_words(n=200_000, vocab=5_000, seed=42):
    rnd = random.Random(seed)
    letters = "abcdefghijklmnopqrstuvwxyz"
    pool = ["".join(rnd.choice(letters) for _ in range(rnd.randint(3, 9))) for _ in range(vocab)]
    return [rnd.choice(pool) for _ in range(n)]

def normalize(words):
    text = ""
    for w in words:
        text += w.lower() + " "          # string concat in a loop
    return text.split()

def unique_in_order(words):
    seen = []
    for w in words:
        if w not in seen:                 # list membership: O(n)
            seen.append(w)
    return seen

def count(words):
    counts = {}
    for w in words:
        if w in counts:
            counts[w] = counts[w] + 1
        else:
            counts[w] = 1
    return counts

def top(counts, k=5):
    return sorted(counts.items(), key=lambda kv: (-kv[1], kv[0]))[:k]

def main():
    words = normalize(make_words())
    uniq = unique_in_order(words)
    counts = count(words)
    return len(words), len(uniq), top(counts)

if __name__ == "__main__":
    import time
    t = time.perf_counter()
    print(main())
    print(f"{time.perf_counter() - t:.2f} s")
(200000, 4985, [('mor', 96), ('jwc', 90), ('fyg', 89), ('tksm', 86), ('bef', 82)])
4.08 s
Antes de seguir leyendo, adivina qué parte es la lenta. La mayoría elige la concatenación de strings, porque todos los tutoriales advierten sobre ella.
Paso 1: medir bien con timeit
Envolver una ejecución completa con time.perf_counter() está bien cuando hablamos de segundos. Para cualquier cosa más chica, usa timeit: ejecuta la sentencia muchas veces, repite eso 5 veces, y tú te quedas con la mejor (el mínimo es la ejecución menos perturbada por otros procesos).
$ python3 -m timeit -s "from wordfreq_slow import make_words" "make_words()"
5 loops, best of 5: 81.7 msec per loop
Error común: cronometrar algo que modifica su propia entrada
$ S="import random; random.seed(1); data = [random.random() for _ in range(100_000)]"
$ python3 -m timeit -s "$S" "data.sort()"
1000 loops, best of 5: 215 usec per loop
$ python3 -m timeit -s "$S" "sorted(data)"
20 loops, best of 5: 12.4 msec per loop
$ python3 -m timeit -s "$S" "d = data[:]; d.sort()"
20 loops, best of 5: 12.5 msec per loop
Lo que pasa en realidad: el setup se ejecuta una sola vez. El primer data.sort() ordena la lista en su lugar, y las otras 4,999 llamadas ordenan una lista que ya está ordenada, algo que Timsort resuelve en una sola pasada lineal. El resultado, 215 µs, es 58× demasiado optimista. Solución: copia dentro de la sentencia (d = data[:]; d.sort()) y, si quieres, cronometra la copia sola (data[:] tardó 150 µs) para restarla. Cualquier benchmark que modifica su entrada (sort, pop, actualizaciones de dict, cachés) tiene este problema.
Paso 2: encontrar el punto caliente con cProfile y pstats
$ python3 -m cProfile -s tottime wordfreq_slow.py
(200000, 4985, [('mor', 96), ('jwc', 90), ('fyg', 89), ('tksm', 86), ('bef', 82)])
4.33 s
         1562316 function calls (1562289 primitive calls) in 4.335 seconds

   Ordered by: internal time

   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
        1    4.111    4.111    4.111    4.111 wordfreq_slow.py:16(unique_in_order)
   235049    0.055    0.000    0.074    0.000 random.py:237(_randbelow_with_getrandbits)
   230049    0.046    0.000    0.125    0.000 random.py:343(choice)
        1    0.024    0.024    0.037    0.037 wordfreq_slow.py:10(normalize)
        1    0.022    0.022    0.132    0.132 wordfreq_slow.py:8(<listcomp>)
        1    0.018    0.018    0.018    0.018 wordfreq_slow.py:23(count)
tottime es el tiempo pasado dentro de la función misma; cumtime incluye todo lo que esa función llamó. Una sola función, unique_in_order, se lleva 4.11 de 4.34 segundos (95 %). normalize, la concatenación de strings de la que todos sospechaban, suma 0.037 s en total. Si la hubiéramos "arreglado" primero, habríamos ahorrado como mucho unos 0.01-0.04 s de una ejecución de 4 segundos.
Para perfilar una sola función desde el código y ordenar por tiempo acumulado:
import cProfile, pstats, wordfreq_slow as m
pr = cProfile.Profile(); pr.enable(); m.main(); pr.disable()
pstats.Stats(pr).strip_dirs().sort_stats("cumulative").print_stats(8)
         1560940 function calls in 4.153 seconds

   Ordered by: cumulative time
   List reduced from 28 to 8 due to restriction <8>

   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
        1    0.000    0.000    4.153    4.153 wordfreq_slow.py:35(main)
        1    3.934    3.934    3.934    3.934 wordfreq_slow.py:16(unique_in_order)
        1    0.000    0.000    0.159    0.159 wordfreq_slow.py:4(make_words)
        1    0.022    0.022    0.131    0.131 wordfreq_slow.py:8(<listcomp>)
   230049    0.045    0.000    0.125    0.000 random.py:343(choice)
Fíjate que cProfile agrega overhead en las llamadas a nivel de Python: make_words muestra 0.159 s aquí, pero tarda 81.7 ms con timeit. Usa el profiler para encontrar dónde, y timeit para medir cuánto.
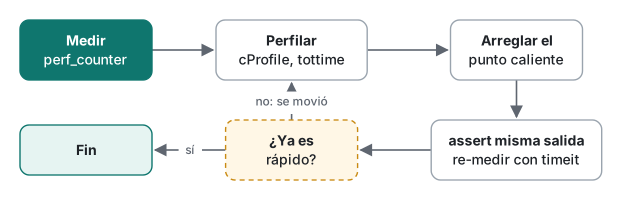
Paso 3: arreglar el punto caliente, después el resto, midiendo cada paso
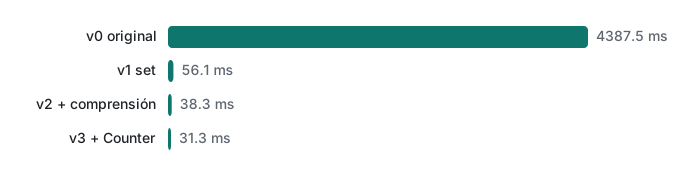
Cada versión de abajo se comprobó para que diera exactamente la misma lista de únicas y los mismos conteos que la original (un assert en el script), y después se cronometró como mediana de 5 ejecuciones (3 para v0). La generación de palabras queda afuera, así que son solo tiempos de procesamiento.
| Versión | Cambio | Tiempo | vs v0 |
|---|---|---|---|
| v0 | Original | 4,387.5 ms | 1× |
| v1 | Deduplicar con un set en vez de una lista |
56.1 ms | 78× |
| v2 | Minúsculas con una comprensión de listas, sin el string gigante | 38.3 ms | 115× |
| v3 | dict.fromkeys para deduplicar, Counter para contar |
31.3 ms | 140× |
La versión final es corta:
# wordfreq_fast.py
from collections import Counter
from wordfreq_slow import make_words

def main():
    words = [w.lower() for w in make_words()]
    uniq = list(dict.fromkeys(words))        # keeps first-seen order (3.7+)
    counts = Counter(words)
    top = sorted(counts.items(), key=lambda kv: (-kv[1], kv[0]))[:5]
    return len(words), len(uniq), top
Imprime la misma tupla en 0.12 s incluyendo la generación de palabras; ahora el costo más grande es make_words (82 ms), que es hacia donde apuntaría el profiler a continuación.
Por qué el paso 1 da 78×: w not in seen sobre una lista compara contra cada elemento, así que 200,000 palabras × hasta 4,985 palabras únicas son cientos de millones de comparaciones. Un set calcula el hash de la palabra una sola vez. Los micro-benchmarks de cada paso (timeit, mínimo de 5 repeticiones):
--- dedupe 200k words (min of 5 repeats, 1 loops each)
  list membership                     4252.94 ms   x  1.00
  set membership                         3.87 ms   x1099.67
  dict.fromkeys                          4.03 ms   x1056.10
--- build text (min of 5 repeats, 20 loops each)
  str += in loop                        29.19 ms   x  1.00
  join(generator)                       22.31 ms   x  1.31
  join([list comp])                     19.33 ms   x  1.51
--- count words (min of 5 repeats, 20 loops each)
  if w in d                             13.18 ms   x  1.00
  d.get(w, 0) + 1                       13.77 ms   x  0.96
  try/except KeyError                   12.01 ms   x  1.10
  defaultdict(int)                      10.53 ms   x  1.25
  Counter(words)                         6.27 ms   x  2.10
join([comprensión de listas]) le ganó a join(generador): str.join arma una lista a partir del generador de todas formas, así que el generador solo agrega overhead. Counter(words) ganó porque su bucle de conteo corre en C; un Counter con un bucle manual c[w] += 1 no ganaría.
Error común: += sobre un atributo es cuadrático
La concatenación de strings en normalize salió barata, y eso sorprende. CPython tiene una optimización: cuando el lado izquierdo de text += ... es una variable simple y nada más referencia ese string, lo redimensiona en su lugar. Esa optimización solo aplica cuando el destino es un nombre de variable. Asigna a un atributo y desaparece:
# concat_attr.py
import time
from wordfreq_slow import make_words

class Buf:
    def __init__(self): self.text = ""

def local_concat(words):
    text = ""
    for w in words:
        text += w + " "
    return text

def attr_concat(words):
    b = Buf()
    for w in words:
        b.text += w + " "        # attribute target: no in-place resize
    return b.text

for n in (50_000, 100_000, 200_000):
    words = make_words(n)
    for f in (local_concat, attr_concat):
        t = time.perf_counter(); f(words); dt = time.perf_counter() - t
        print(f"{f.__name__:<13} n={n:>7,}: {dt*1000:8.1f} ms")
local_concat  n= 50,000:      4.5 ms
attr_concat   n= 50,000:    203.8 ms
local_concat  n=100,000:      8.9 ms
attr_concat   n=100,000:    717.7 ms
local_concat  n=200,000:     17.7 ms
attr_concat   n=200,000:   2948.9 ms
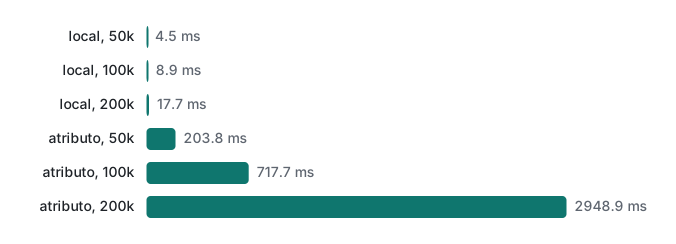
Lo que pasa en realidad: la versión local crece en forma lineal (4.5 → 8.9 → 17.7 ms). La versión con atributo más o menos se cuadruplica cada vez que la entrada se duplica (204 → 718 → 2,949 ms), porque cada += copia todo el string acumulado hasta ese momento. Solución: junta las partes en una lista y haz "".join(parts) una sola vez, o arma el string en una variable local y asígnalo al atributo al final. Por esto "usa join" sigue siendo un buen consejo: el camino rápido es un detalle de implementación de CPython, y lo pierdes apenas el código se refactoriza dentro de una clase.
Búsquedas locales, comprensiones y map
--- 1M items: len(str(i)) (min of 5 repeats, 3 loops each)
  for + out.append (globals)           162.38 ms   x  1.00
  for + local aliases                  125.72 ms   x  1.29
  list comprehension                   139.07 ms   x  1.17
  map(len, map(str, ...))               93.13 ms   x  1.74
  map(lambda ...)                      132.86 ms   x  1.22
El truco del "alias local" (append = out.append, len=len como argumento por defecto) es real: 22 % menos de tiempo en 3.9, porque buscar un nombre local es más barato que buscar uno global o builtin, y out.append ya no se vuelve a buscar en cada iteración. Una comprensión de listas obtiene parte de eso gratis y se lee mejor. map con una función builtin fue lo más rápido porque no se ejecuta ningún frame de Python por elemento; map con una lambda pierde esa ventaja. En código real usaríamos la comprensión: el truco del alias gana 13 ms por millón de elementos y cuesta legibilidad.
Trucos populares que no ayudaron (aquí)
Medidos en 3.9, los consejos que no vale la pena seguir en este tipo de código:
| Truco popular | Lo que medimos | Veredicto |
|---|---|---|
"Cambia str += por join" en un bucle local |
29 → 19 ms; 0.04 s de un programa de 4.4 s | Está bien hacerlo, pero nunca fue el cuello de botella |
"d.get(k, 0) + 1 es más rápido que if k in d" |
13.77 vs 13.18 ms | Un poco más lento; elige lo que se lea mejor |
"try/except KeyError es más rápido que preguntar antes" |
12.01 vs 13.18 ms (9 %) | Poca diferencia, y depende de qué tan seguido falta la clave |
"map(lambda …) le gana a un bucle" |
132.9 ms vs 139.1 ms de la comprensión | Dentro del ruido de la comprensión |
"join(generador) ahorra memoria, así que es más rápido" |
22.3 ms vs 19.3 ms con una lista | Más lento; join arma una lista igual |
Dos consejos que sí ayudaron, para que no concluyas que todo consejo popular está mal: i * i en vez de i ** 2 (34.97 vs 214.50 ms para un millón de cuadrados, 6.1×) y for i in range(N) en vez de un contador con while (28.68 vs 57.43 ms). Los dos evitan trabajo en el bucle del intérprete, y sum(range(N)) (10.25 ms) les gana a ambos porque hace el bucle en C. El patrón: los trucos que mueven trabajo a C ayudan; los que solo reacomodan sintaxis de Python, en general no.
Memoria: tracemalloc
El tiempo no es el único costo. normalize arma un string enorme con todas las palabras y después una lista a partir de él. tracemalloc mide lo que Python asignó:
# mem.py
import tracemalloc
from collections import Counter
from wordfreq_slow import make_words, normalize

words = make_words()

tracemalloc.start()
counts = Counter(normalize(words))            # builds one big string, then a list
cur, peak = tracemalloc.get_traced_memory()
print(f"normalize + Counter : peak {peak/1e6:5.1f} MB")
tracemalloc.stop()

tracemalloc.start()
counts2 = Counter(w.lower() for w in words)   # streams one word at a time
cur, peak = tracemalloc.get_traced_memory()
print(f"generator + Counter : peak {peak/1e6:5.1f} MB")
assert counts == counts2

snap = tracemalloc.take_snapshot()
for stat in snap.statistics("lineno")[:3]:
    print(stat)
tracemalloc.stop()
normalize + Counter : peak  14.0 MB
generator + Counter : peak   0.4 MB
~/demo/mem.py:15: size=268 KiB, count=4986, average=55 B
.../python3.9/collections/__init__.py:679: size=144 KiB, count=1, average=144 KiB
.../python3.9/abc.py:123: size=1459 B, count=16, average=91 B
La versión en streaming tiene un pico de 0.4 MB en vez de 14 MB, y el snapshot muestra lo que sigue vivo: 4,986 strings chicos (las palabras distintas guardadas como claves del Counter) y la tabla hash del Counter. Con un archivo de log de 2 GB, esa es la diferencia entre que funcione y que el sistema mate el proceso. El curso 3 trata los generadores en detalle.
Tabla de decisión
| Síntoma | Herramienta / solución | Evidencia de arriba |
|---|---|---|
| "Está lento" y no sabes dónde | python -m cProfile -s tottime script.py |
Una función era el 95 % del tiempo |
| Comparar dos fragmentos chicos | python -m timeit -s setup stmt, toma el mínimo |
Resultados al 0.1 ms |
| El benchmark modifica su entrada | Copia dentro de la sentencia cronometrada | data.sort() salió 58× demasiado optimista |
x in big_list dentro de un bucle |
set o dict |
4,253 ms → 3.9 ms |
| Deduplicar manteniendo el orden | list(dict.fromkeys(items)) |
4.03 ms, mismo orden que la versión con lista |
| Contar elementos | Counter(iterable) |
6.27 ms vs 13.18 ms escrito a mano |
| Armar un string en un atributo o contenedor | Juntar en una lista, "".join una vez |
2,949 ms → 17.7 ms |
| Bucle interno caliente sobre builtins | Comprensión o map(builtin, …) |
162 → 139 / 93 ms |
| La memoria crece con la entrada | tracemalloc, después generadores |
14.0 MB → 0.4 MB |
| Sigue lento después de todo esto | Pasar trabajo a C (NumPy, builtins) o a un pool de procesos | Ver el curso 5 |
Límites honestos y notas de versión
- Todos los tiempos son de Python 3.9.6 en un Apple M1 Pro, con otros trabajos corriendo en la máquina; mínimos de
timeitde 5 repeticiones y medianas de 5 ejecuciones. Los números absolutos van a ser otros en tu computadora; lo que hay que comparar son las proporciones. - No medimos el trabajo de "Faster CPython" de Python 3.11. Las notas de la versión 3.11 dicen que CPython 3.11 es en promedio unas 1.25× más rápido que 3.10 en la suite pyperformance. Nuestro único 3.11 es un build x86_64 que corre bajo Rosetta 2, así que cronometrarlo mediría el traductor, no el intérprete. Algunas de las diferencias de arriba (por ejemplo
i ** 2vsi * i, o el costo de buscar globales) pueden ser menores en 3.11+; no podemos decir cuánto. - La optimización de
str +=en su lugar es un detalle de implementación de CPython, observado aquí en 3.9. PyPy y otras implementaciones no la garantizan. dict.fromkeysmantiene el orden de inserción porque los dicts son ordenados (garantizado desde 3.7).- Los números de cProfile incluyen el overhead del profiler;
make_wordsmostró 0.159 s con el profiler y 81.7 ms contimeit.
Anterior: Curso 5: hilos, procesos, asyncio y el GIL · Volver al inicio: Curso 1: tipos y mutabilidad
Relacionados: Generadores y memoria (curso 3) · JIT, GC y memoria en Java (en inglés) · Algoritmos de ordenamiento (en inglés)
Preguntas frecuentes
¿Qué debo optimizar primero en un código Python lento?
Lo que diga cProfile. En nuestro contador de palabras, una sola función, una deduplicación con pertenencia en lista, se llevó 3.93 de 4.15 segundos perfilados. Cambiarla por un set bajó todo el programa de 4.39 s a 56 ms. La concatenación de strings de la que todos advierten fue 0.04 s del total.
¿Es más rápido d.get(key, 0) + 1 que 'if key in d' en Python?
No: en nuestra medición en Python 3.9 fue apenas más lento, 13.77 ms contra 13.18 ms para 200,000 palabras. defaultdict(int) tardó 10.53 ms, y Counter(words) 6.27 ms porque su bucle de conteo está escrito en C.
¿Concatenar strings con += en un bucle es de verdad cuadrático?
Para una variable local, no: CPython redimensiona el string en su lugar, y 200,000 concatenaciones tardaron 17.7 ms. Para un atributo (self.text += ...) esa optimización no se aplica, y el mismo trabajo tardó 2,949 ms, cuadruplicándose cada vez que la entrada se duplicaba.