GIL de Python: hilos, procesos y asyncio medidos
Hilos, procesos y asyncio medidos en una Mac: CPU e I/O con 1-8 workers, un contador que pierde hasta 63 % de los incrementos y un loop bloqueado 510 ms.
Serie: curso de Python 5/6 (avanzado). Para quien ya escribe funciones, generadores y decoradores con soltura y ahora necesita que un programa haga varias cosas a la vez. Al terminar vas a poder elegir entre hilos, procesos o asyncio a partir de mediciones, no de mitos de foro.
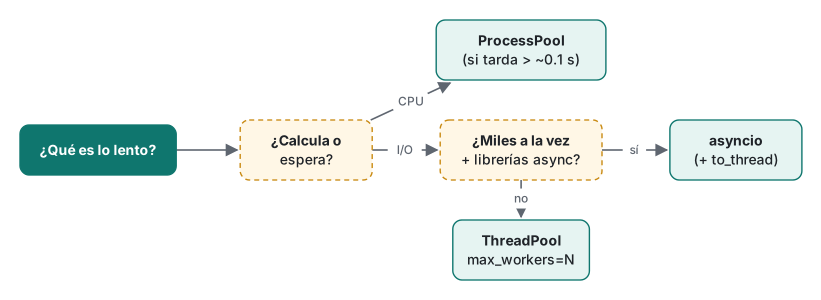
Si alguna vez le agregaste threading a un script lento de Python y viste que no ganaba nada de velocidad, este curso te explica por qué, con números. También es para quien tiene un servicio asyncio que se congela "al azar" medio segundo, y para quien tiene un script de multiprocessing que anda bien en el servidor Linux de la empresa pero revienta en la Mac de un compañero (o en tu laptop de la facultad). La respuesta corta: los hilos ayudan cuando esperas, los procesos ayudan cuando calculas, asyncio ayuda cuando esperas miles de cosas a la vez, y una sola llamada bloqueante puede arruinar asyncio.
Todo lo de abajo se ejecutó en una Mac con Apple Silicon (M1 Pro, 8 núcleos: 6 de rendimiento + 2 de eficiencia). Los tiempos son de Python 3.9. Algunas funciones que necesitan 3.11 (asyncio.TaskGroup, except*) se ejecutaron en Python 3.11, pero ese build corre bajo la traducción de Rosetta 2, así que no lo usamos para ningún tiempo. Había otros trabajos corriendo en la máquina, así que cada tiempo es la mediana de 5 ejecuciones.
El GIL en un párrafo
CPython tiene un Global Interpreter Lock (GIL): un solo hilo a la vez ejecuta bytecode de Python. Un hilo que espera I/O (un socket, un archivo, time.sleep) suelta el lock, así que otros hilos pueden avanzar mientras espera. Un hilo que ejecuta un bucle en Python puro lo retiene, y el intérprete solo le pide que lo ceda cada pocos milisegundos:
>>> import sys; sys.getswitchinterval()
0.005
Esos 5 ms son el "switch interval". Los hilos se turnan; no ejecutan código Python en paralelo. Cada proceso tiene su propio intérprete y su propio GIL, así que los procesos sí corren en paralelo, a cambio del costo de arrancarlos y de copiar (con pickle) los argumentos y resultados entre ellos.
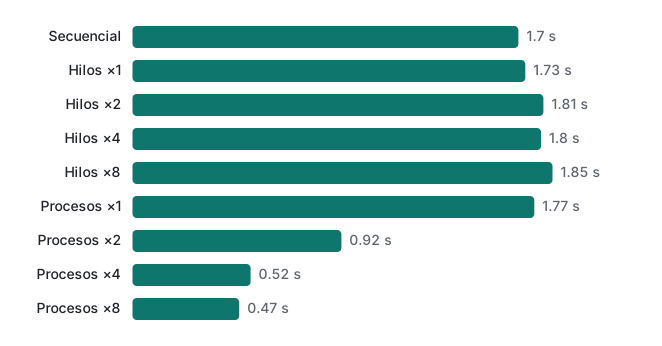
Trabajo de CPU: hilos vs procesos, con 1/2/4/8 workers
Ocho trabajos iguales, cada uno un bucle en Python puro de 3 millones de iteraciones. Los mismos trabajos se ejecutan en secuencia, en un ThreadPoolExecutor y en un ProcessPoolExecutor. El pool se crea dentro del bloque cronometrado, así que el arranque de los procesos está incluido en los números.
# cpu_bound.py
import time, sys, multiprocessing as mp
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def work(n):
    total = 0
    for i in range(n):
        total += i * i % 7
    return total

JOBS = [3_000_000] * 8   # 8 equal jobs

def timed(label, fn):
    t = time.perf_counter()
    res = fn()
    print(f"{label:<22}{time.perf_counter() - t:6.2f} s")
    return res

if __name__ == "__main__":
    print(sys.version.split()[0], "start method:", mp.get_start_method())
    expected = timed("sequential", lambda: [work(n) for n in JOBS])
    for w in (1, 2, 4, 8):
        with ThreadPoolExecutor(max_workers=w) as ex:
            assert timed(f"threads  x{w}", lambda: list(ex.map(work, JOBS))) == expected
    for w in (1, 2, 4, 8):
        with ProcessPoolExecutor(max_workers=w) as ex:
            assert timed(f"processes x{w}", lambda: list(ex.map(work, JOBS))) == expected
Primera línea de la salida: 3.9.6 start method: spawn. Medianas de 5 ejecuciones:
| Modo | 1 worker | 2 workers | 4 workers | 8 workers |
|---|---|---|---|---|
| Secuencial | 1.70 s | — | — | — |
| Hilos | 1.73 s | 1.81 s | 1.80 s | 1.85 s |
| Procesos | 1.77 s | 0.92 s | 0.52 s | 0.47 s |
Tres cosas que un resumen no te diría:
- Los hilos nunca fueron más rápidos que la versión secuencial. Más hilos la hicieron un poco más lenta, porque los hilos pierden tiempo pasándose el GIL de uno a otro. Además, las ejecuciones con hilos tuvieron mucho más ruido (una ejecución con 4 hilos tardó 2.84 s).
- Los procesos escalaron casi en forma lineal hasta 4 workers y después se aplanaron. De 4 a 8 workers solo se pasó de 0.52 s a 0.47 s. Esta Mac tiene 6 núcleos de rendimiento y 2 de eficiencia más lentos, y con 8 trabajos los últimos esperan al núcleo más lento.
- Un pool de procesos tiene un costo fijo. Arrancar 8 workers con spawn y mandarles una tarea vacía tardó una mediana de 0.099 s. Para un trabajo que en total tarda 50 ms, un pool de procesos empeora las cosas.
La trampa de macOS: spawn e if __name__ == "__main__"
En Linux, Python (hasta 3.13) arranca los workers con fork: el hijo es una copia de la memoria del padre. En macOS el valor por defecto es spawn desde Python 3.8: el hijo es un intérprete nuevo que vuelve a importar tu módulo principal para encontrar work. Todo lo que está en el nivel superior del módulo se vuelve a ejecutar en cada hijo.
Este es el error, un script sin la guarda:
# noguard.py — common mistake
from concurrent.futures import ProcessPoolExecutor

def square(x):
    return x * x

with ProcessPoolExecutor(max_workers=2) as ex:
    print(list(ex.map(square, range(5))))
Lo que pasa en realidad en Python 3.9, macOS (125 líneas de salida, recortadas):
RuntimeError:
        An attempt has been made to start a new process before the
        current process has finished its bootstrapping phase.

        This probably means that you are not using fork to start your
        child processes and you have forgotten to use the proper idiom
        in the main module:

            if __name__ == '__main__':
                freeze_support()
                ...
Traceback (most recent call last):
  File "~/demo/noguard.py", line 8, in <module>
    print(list(ex.map(square, range(5))))
  ...
concurrent.futures.process.BrokenProcessPool: A process in the process pool was terminated abruptly while the future was running or pending.
Cada hijo volvió a ejecutar la línea with ProcessPoolExecutor(...) al importar el módulo, intentó arrancar su propio pool y murió; después el padre se encontró con un pool roto. Solución: pon todo lo que arranca procesos debajo de if __name__ == "__main__":, y deja las funciones worker en el nivel superior del módulo para que el hijo pueda importarlas (una lambda o una función anidada no se pueden serializar con pickle). El mismo script que funciona en un servidor Linux puede fallar en la Mac de un desarrollador, y por eso esta trampa importa.
Python 3.14 cambia el valor por defecto de Linux de fork a forkserver; no ejecutamos 3.14, pero la guarda hace que tu código sea correcto con cualquier método de arranque.
Trabajo de I/O: hilos vs asyncio con 100 y 1,000 tareas
Aquí el trabajo es esperar. Simulamos una llamada de red con una espera de 100 ms (sin red externa de por medio), una vez con time.sleep en hilos y otra con asyncio.sleep en corrutinas.
# io_bound.py
import asyncio, time
from concurrent.futures import ThreadPoolExecutor

DELAY = 0.1  # each "request" waits 100 ms

def fetch_blocking(i):
    time.sleep(DELAY)
    return i

async def fetch_async(i):
    await asyncio.sleep(DELAY)
    return i

def with_threads(n, workers):
    with ThreadPoolExecutor(max_workers=workers) as ex:
        return list(ex.map(fetch_blocking, range(n)))

async def with_asyncio(n):
    return await asyncio.gather(*(fetch_async(i) for i in range(n)))

def timed(label, fn):
    t = time.perf_counter()
    fn()
    print(f"{label:<34}{time.perf_counter() - t:7.3f} s")

if __name__ == "__main__":
    for n in (100, 1000):
        print(f"--- {n} tasks ---")
        timed("threads, default max_workers", lambda: with_threads(n, None))
        timed(f"threads, max_workers={n}", lambda: with_threads(n, n))
        timed("asyncio.gather", lambda: asyncio.run(with_asyncio(n)))
| Tareas de 100 ms | Secuencial | Hilos, pool por defecto | Hilos, uno por tarea | asyncio |
|---|---|---|---|---|
| 100 | 10.355 s | 0.932 s | 0.113 s | 0.103 s |
| 1,000 | (≈100 s, no se ejecutó) | 8.684 s | 0.210 s | 0.110 s |
| 10,000 | — | — | 0.703 s, RSS pico 90 MB | 0.196 s, RSS pico 39 MB |
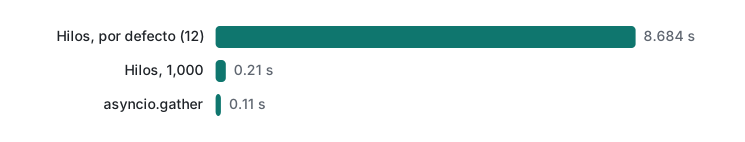
La sorpresa está en la segunda columna. ThreadPoolExecutor() sin max_workers usa min(32, os.cpu_count() + 4), que en esta Mac es 12. Mil esperas en tandas de 12 son unas 84 rondas de 100 ms, de ahí los 8.7 s. El valor por defecto está pensado para trabajo mixto, no para mil sockets abiertos. Con un hilo por tarea, los hilos quedaron cerca de asyncio con 100 tareas, siguieron bien con 1,000, y con 10,000 usaron más del doble de memoria (RSS pico tomada de resource.getrusage, cada modo en un proceso nuevo) y tardaron 3.6× más; el tiempo extra se va en crear y planificar 10,000 hilos del sistema operativo.
Lo que dicen los números: para unos cientos de esperas concurrentes, los hilos con un pool del tamaño adecuado funcionan perfecto y sirven con librerías bloqueantes. Asyncio gana cuando la cantidad llega a miles, y solo si todas las librerías del camino son async.
Condición de carrera: un contador que pierde actualizaciones
El GIL no hace que tu código sea thread-safe. counter += 1 son varios pasos de bytecode (en 3.9: LOAD_GLOBAL, LOAD_CONST, INPLACE_ADD, STORE_GLOBAL), y un cambio de hilo entre la lectura y la escritura hace perder una actualización.
# race.py
import sys, threading

N, THREADS = 1_000_000, 4
counter = 0
lock = threading.Lock()

def unsafe():
    global counter
    for _ in range(N):
        counter += 1          # read, add, write: three steps

def safe():
    global counter
    for _ in range(N):
        with lock:
            counter += 1

def run(target):
    global counter
    counter = 0
    ts = [threading.Thread(target=target) for _ in range(THREADS)]
    for t in ts: t.start()
    for t in ts: t.join()
    return counter

if __name__ == "__main__":
    print(sys.version.split()[0], "expected", N * THREADS)
    for i in range(3):
        print("unsafe:", run(unsafe))
    print("locked:", run(safe))
3.9.6 expected 4000000
unsafe: 1492419
unsafe: 2606045
unsafe: 2137778
locked: 4000000
Se perdieron más de la mitad de los incrementos, y el resultado fue distinto en cada ejecución. Ahora la parte que atrapa a desarrolladores con experiencia: el mismo archivo en Python 3.11 imprimió 4000000 tres veces. Los intérpretes más nuevos revisan si hay que cambiar de hilo en menos puntos, así que este bucle de dos líneas en particular justo no se interrumpió a mitad de la actualización. Sigue sin ser seguro. Pon una llamada a función entre la lectura y la escritura, y 3.11 también pierde actualizaciones:
def plus_one(x):
    return x + 1
...
        counter = plus_one(counter)   # a function call between read and write
3.9.6 1919199 of 4000000
3.11.4 2616204 of 4000000
O sea, que "en mi máquina funcionó" con 3.11 no demuestra nada. La solución es el Lock. Tiene un precio, que medimos en 3.9: 4 hilos × 1M de incrementos tardaron 0.23–0.26 s sin protección y 1.00–1.14 s con lock. En código real, protege con el lock una unidad de trabajo más grande, o dale a cada hilo su propio contador y súmalos al final.
La trampa de asyncio: una llamada bloqueante dentro de una corrutina
Asyncio ejecuta todas las corrutinas en un solo hilo. Cuando una corrutina llama a algo que bloquea, nada más avanza hasta que esa llamada vuelve. Para medir el bloqueo ejecutamos una tarea "heartbeat" que quiere despertar cada 10 ms y registramos el hueco más largo mientras un handler "espera" 0.5 s de tres maneras distintas:
# stall.py
import asyncio, time

async def heartbeat(stop, gaps):
    last = time.perf_counter()
    while not stop.is_set():
        await asyncio.sleep(0.01)            # wants to wake every 10 ms
        now = time.perf_counter()
        gaps.append(now - last)
        last = now

async def handler(mode):
    if mode == "time.sleep":
        time.sleep(0.5)                      # blocks the whole event loop
    elif mode == "asyncio.sleep":
        await asyncio.sleep(0.5)
    elif mode == "to_thread":
        await asyncio.to_thread(time.sleep, 0.5)   # 3.9+

async def main(mode):
    stop, gaps = asyncio.Event(), []
    hb = asyncio.create_task(heartbeat(stop, gaps))
    await asyncio.sleep(0.05)
    t = time.perf_counter()
    await handler(mode)
    took = time.perf_counter() - t
    stop.set(); await hb
    print(f"{mode:<14} handler {took:.3f} s | heartbeat max gap {max(gaps)*1000:6.1f} ms, ticks {len(gaps)}")

if __name__ == "__main__":
    for mode in ("time.sleep", "asyncio.sleep", "to_thread"):
        asyncio.run(main(mode))
time.sleep     handler 0.505 s | heartbeat max gap  510.1 ms, ticks 5
asyncio.sleep  handler 0.501 s | heartbeat max gap   11.4 ms, ticks 51
to_thread      handler 0.508 s | heartbeat max gap   30.7 ms, ticks 46
El handler tardó 0.5 s en los tres casos, así que un test que solo cronometra el handler no ve nada raro. El heartbeat dice la verdad: con time.sleep, todas las demás tareas del loop se congelaron 510 ms. En un servidor web, eso significa que se traban las peticiones de todos los demás clientes. requests.get, un driver de base de datos síncrono, open().read() sobre un disco lento y un bucle que consume mucha CPU se comportan todos aquí como time.sleep.
Para encontrarlos en un proyecto real, activa el modo debug. Con asyncio.run(handler(), debug=True) y un time.sleep de 0.3 s adentro, Python 3.9 registró:
Executing <Task finished name='Task-1' coro=<handler() done, defined at ~/demo/debugwarn.py:2> result=None created at .../asyncio/base_events.py:621> took 0.306 seconds
Se reporta cualquier callback más lento que loop.slow_callback_duration (0.1 s por defecto). Un error relacionado es llamar a una corrutina sin await: no se ejecuta nada y solo recibes RuntimeWarning: coroutine 'f' was never awaited.
asyncio.TaskGroup (3.11+): fallar todas juntas
asyncio.gather tiene un comportamiento por defecto incómodo: cuando una tarea falla, la excepción te llega, pero las demás tareas siguen corriendo en segundo plano. En Python 3.9:
  a done
caught: b: bad response after 0.20 s
  c done
main exits
La tarea c terminó cuando tú ya habías manejado el error. asyncio.TaskGroup, agregado en 3.11, cancela a las hermanas cuando una falla y lanza un ExceptionGroup, que atrapas con el nuevo except*:
# taskgroup.py — needs Python 3.11+
import asyncio, sys, time

async def fetch(name, delay, fail=False):
    try:
        await asyncio.sleep(delay)
        if fail:
            raise ValueError(f"{name}: bad response")
        print(f"  {name} done")
        return name
    except asyncio.CancelledError:
        print(f"  {name} cancelled")
        raise

async def main():
    t = time.perf_counter()
    try:
        async with asyncio.TaskGroup() as tg:
            a = tg.create_task(fetch("a", 0.1))
            b = tg.create_task(fetch("b", 0.2, fail=True))
            c = tg.create_task(fetch("c", 1.0))
    except* ValueError as eg:
        print("caught:", [str(e) for e in eg.exceptions])
    print(f"elapsed {time.perf_counter() - t:.2f} s, a={a.result()!r}, c.cancelled()={c.cancelled()}")

print(sys.version.split()[0])
asyncio.run(main())
3.11.4
  a done
  c cancelled
caught: ['b: bad response']
elapsed 0.20 s, a='a', c.cancelled()=True
En Python 3.9 el mismo archivo ni siquiera compila, porque except* es sintaxis nueva:
  File "~/demo/taskgroup.py", line 22
    except* ValueError as eg:
          ^
SyntaxError: invalid syntax
y sin el bloque except* obtendrías AttributeError: module 'asyncio' has no attribute 'TaskGroup'. Si tu código tiene que correr en 3.9 o 3.10, quédate con gather y cancela tú las tareas que queden.
Tabla de decisión
| Tu situación | Usa | Por qué (según las mediciones de arriba) |
|---|---|---|
| Trabajo de CPU en Python puro, de segundos o más | ProcessPoolExecutor |
1.70 s → 0.52 s con 4 workers; los hilos no hicieron nada |
| Trabajo de CPU de menos de 0.1 s en total | Código secuencial común | Solo arrancar 8 workers con spawn costó 0.099 s |
| Trabajo de CPU dentro de NumPy, hashlib, zlib y otro código C que suelta el GIL | Los hilos pueden ayudar | El GIL se libera dentro de esas llamadas (revisa cada librería) |
| De decenas a cientos de llamadas de I/O bloqueantes (requests, driver de BD) | ThreadPoolExecutor(max_workers=N) |
100 tareas: 0.113 s, cerca de asyncio; fija max_workers, aquí el valor por defecto es 12 |
| Miles de conexiones concurrentes, librerías async en todos lados | asyncio | 10,000 tareas: 0.196 s y 39 MB vs 0.703 s y 90 MB con hilos |
| Una llamada bloqueante dentro de código async | asyncio.to_thread (3.9+) |
Hueco del loop de 30.7 ms en vez de 510 ms |
| Estado mutable compartido entre hilos | Lock, o resultados por hilo que se combinan al final |
Sin él se perdió entre el 35 y el 63 % de las actualizaciones |
| Varias tareas que deben fallar juntas | TaskGroup en 3.11+, antes gather + cancelación manual |
Hermanas canceladas a los 0.20 s |
Límites honestos y notas de versión
- Tiempos medidos solo en Python 3.9.6. Python 3.11.4 se usó para ejecutar
TaskGroup/except*y la demo de la carrera, pero es un build x86_64 bajo Rosetta 2, así que su velocidad no dice nada de un 3.11 nativo. - Python free-threaded (3.13+), descrito, no ejecutado. La PEP 703 agregó un build opcional sin GIL (
python3.13t); en 3.13 era experimental, ysys._is_gil_enabled()te dice en tiempo de ejecución en qué modo estás. En ese build, la tabla de hilos con CPU de arriba se vería muy distinta, y la carrera derace.pyimportaría todavía más, porque no hay switch interval que la disimule. No teníamos ese build aquí y no instalamos ninguno. asyncio.to_threades de 3.9+.TaskGroupyexcept*son de 3.11+ (comprobado: 3.9 da elSyntaxErrory elAttributeErrorque se muestran).- El valor por defecto
forkserveren Linux llega con Python 3.14; no ejecutamos 3.14. - Máquina: Apple M1 Pro, macOS, con otros trabajos corriendo; medianas de 5 ejecuciones. Tus números absolutos van a ser otros; lo importante son las proporciones.
Anterior: Curso 4: decoradores y context managers · Siguiente: Curso 6: profiling y optimización
Relacionados: Generadores y memoria (curso 3) · Hilos virtuales de Java, medidos (en inglés) · Async/Await en VB.NET (en inglés)
Preguntas frecuentes
¿Los hilos (threads) de Python hacen más rápido el código que usa mucha CPU?
No en un build normal (con GIL). Ocho trabajos iguales en Python puro tardaron 1.70 s en secuencia y 1.73-1.85 s con 1, 2, 4 u 8 hilos en Python 3.9 (Apple M1 Pro). Los mismos trabajos con un pool de procesos tardaron 0.92 s con 2 workers y 0.47 s con 8.
¿Por qué mi script de multiprocessing falla con 'An attempt has been made to start a new process before the current process has finished its bootstrapping phase'?
macOS (y Windows) arrancan los procesos worker con el método spawn, que vuelve a importar tu módulo principal en cada hijo. Sin la guarda if __name__ == '__main__':, cada hijo intenta crear su propio pool, y Python lanza este RuntimeError seguido de BrokenProcessPool. Pon la creación del pool debajo de la guarda.
¿Por qué una sola petición lenta congela todo mi servidor asyncio?
Una llamada bloqueante como time.sleep o requests.get dentro de una corrutina detiene el event loop. En nuestra prueba, un time.sleep de 0.5 s produjo un hueco de 510 ms en una tarea que quería ejecutarse cada 10 ms. Usa la versión awaitable o pasa la llamada a un hilo con asyncio.to_thread.