Pythonの型とミュータブル:名前・コピー・isと==を実行結果で理解
0.1+0.2が0.3にならない理由、リストの別名と[[0]*3]*3の罠、copyとdeepcopy、isと==、本物のトレースバックと実測コストをPython 3.9・3.11で確認。
シリーズ:Python 講座 1/6(初級)。 Python を少し書けるようになったものの、「触っていないリストがなぜか変わっている」で手が止まった人向けの記事です。読み終えると、2つの変数が同じオブジェクトを共有しているかを事前に見抜き、状況に合ったコピー方法を選び、初心者が最初に出会うトレースバックを読めるようになります。
業務で Excel VBA や Java を書いてきた人が Python に移ると、最初の1週間で3回驚きます。0.1 + 0.2 が 0.30000000000000004 と表示され、触っていないリストが変わり、is と == の結果が一致したりしなかったりします。原因はどれも同じで、Python の変数は値を入れる箱ではなく、オブジェクトに貼る名札だということです。以下の出力はすべて Apple Silicon Mac(M1 Pro)上の Python 3.9 と Python 3.11 で実際に実行したもので、トレースバックのファイルパスだけ ~/demo/ に置き換えています。
名前はオブジェクトを指している
まず次のコードを実行します。
a = [1, 2, 3]
b = a
b.append(4)
print("a =", a, "| a is b:", a is b, "| id equal:", id(a) == id(b))

x = 10
y = x
y += 1
print("x =", x, "y =", y)
a = [1, 2, 3, 4] | a is b: True | id equal: True
x = 10 y = 11
b = a はリストをコピーしていません。同じリストオブジェクトに名札をもう1枚貼っただけなので、b から追加した 4 が a からも見えます。整数のほうは見た目は同じ書き方なのに結果が違います。int は変更できないオブジェクトなので、y += 1 は新しい整数オブジェクト 11 を作り、y という名札だけをそちらへ付け替えます。x は 10 を指したままです。
これがミュータブル(変更可能)とイミュータブル(変更不可)の違いのすべてです。
| 型 | 変更可能? | += の動き |
|---|---|---|
int、float、bool、None |
不可 | 新しいオブジェクトを作り、名前を付け替える |
str、tuple、frozenset、bytes |
不可 | 新しいオブジェクトを作り、名前を付け替える |
list、dict、set、bytearray |
可能 | オブジェクト自体を書き換える。すべての名前から見える |
基本の型と、2つの意外な動き
print(type(1), type(1.0), type("1"), type(True), type(None))
print(True + True, isinstance(True, int))
<class 'int'> <class 'float'> <class 'str'> <class 'bool'> <class 'NoneType'>
2 True
bool は int のサブクラスなので True + True は 2 になります。sum(x > 0 for x in data) で正の数を数えるときは便利ですが、API で数値のはずの項目が true で届いても isinstance(v, int) を通過してしまう、というバグの原因にもなります。
0.1 + 0.2 問題と、Decimal を使うべき場面
import math
from decimal import Decimal

print(0.1 + 0.2, 0.1 + 0.2 == 0.3)
print(f"{0.1:.20f}")
print(math.isclose(0.1 + 0.2, 0.3))
print(Decimal("0.1") + Decimal("0.2"), Decimal(0.1))
print(round(2.675, 2), round(0.5), round(1.5), round(2.5))
0.30000000000000004 False
0.10000000000000000555
True
0.3 0.1000000000000000055511151231257827021181583404541015625
2.67 0 2 2
float は2進数の IEEE 754 倍精度浮動小数点数です。0.1 は2進数で正確に表せないため、ごくわずかに大きい値で保存され、0.1 と 0.2 の誤差が足されてこの結果になります。Python のバグではなく、JavaScript や Java でも同じです。出力のうち特に注意したいのは次の2行です。
Decimal(0.1)は 0.1 ではありません。float を渡すと、すでにずれた2進数の値がそのまま入ります。Decimal は必ず文字列から作ります:Decimal("0.1")。round(2.675, 2)は2.68ではなく2.67です。保存されている値が 2.67499999… だからです。round(0.5)とround(2.5)が0と2なのは、Python が .5 を偶数側に丸める(銀行丸め)ためで、学校で習う四捨五入とは違います。
日本の業務コードでよく見る「小数を100倍して整数に」も危険です。
print(int(1.15 * 100), int(4.35 * 100))
114 434
1.15 * 100 は 114.99999999999999 なので、int() で切り捨てると 114 になります。消費税のように「切り捨て」のルールが決まっている計算は、Decimal で丸め方を明示します。
from decimal import Decimal, ROUND_DOWN, ROUND_HALF_UP

rate = Decimal("0.10")
for price in ("1980", "333"):
    tax = (Decimal(price) * rate).quantize(Decimal("1"), rounding=ROUND_DOWN)
    print(price, "->", tax)
print(Decimal("2.675").quantize(Decimal("0.01"), rounding=ROUND_HALF_UP))
1980 -> 198
333 -> 33
2.68
使い分けはこうなります。
| 場面 | 使うもの |
|---|---|
| 金額・消費税・請求書など、人が手で検算する数字 | 文字列から作った Decimal(丸め方も明示) |
| 計測値・グラフィックス・機械学習 | float、比較は math.isclose |
| 個数、円単位の金額 | int |
よくある失敗:[[0] * 3] * 3
3×3 のマス目(オセロ盤や座席表など)を 0 で埋めようとして、こう書きます。
grid = [[0] * 3] * 3
grid[0][0] = 9
print("trap :", grid)

grid = [[0] * 3 for _ in range(3)]
grid[0][0] = 9
print("fixed:", grid)
trap : [[9, 0, 0], [9, 0, 0], [9, 0, 0]]
fixed: [[9, 0, 0], [0, 0, 0], [0, 0, 0]]
実際に起きていること: [[0] * 3] は内側のリストを1つだけ持つリストです。これに 3 を掛けると、内側リストへの参照が3回複製され、3行とも同じオブジェクトになります。内側の [0] * 3 は問題ありません。イミュータブルな 0 を3回指しているだけで、0 はその場で書き換えられないからです。
対策: 2つ目のコードのように、内包表記で行を1つずつ別に作ります。[{}] * n や [[]] * n も同じ罠です。競技プログラミングで訪問済み配列を [[False] * w] * h で作り、BFS がおかしくなる原因の多くもこれです。
コピー:代入、copy、deepcopy
コピーには3段階あり、初心者が「1段目で十分」と思う場面で、実際には2段目や3段目が必要なことがよくあります。
import copy

orig = {"name": "app", "tags": ["a", "b"]}
sh = copy.copy(orig)       # 浅いコピー:新しい dict、内側のリストは同じ
dp = copy.deepcopy(orig)   # 深いコピー:新しい dict、新しい内側のリスト
sh["tags"].append("SH")
print("orig:", orig, "| deep:", dp)
orig: {'name': 'app', 'tags': ['a', 'b', 'SH']} | deep: {'name': 'app', 'tags': ['a', 'b']}
浅いコピーは dict 自体は新しく作りましたが、"tags" の値は元のリストを指したままなので、そこに追加すると orig も変わります。深いコピーは構造全体をたどり、中の可変オブジェクトをすべて複製しました。
イミュータブルであることも「浅い」性質です。タプル自体は変更できませんが、中のリストは変わります。
t = (1, [2, 3])
t[1].append(4)
print(t)
t[0] = 99
(1, [2, 3, 4])
TypeError: 'tuple' object does not support item assignment
文字列もタプルと同じで、s[0] = "z" は TypeError: 'str' object does not support item assignment になります。s = "z" + s[1:] や s.replace(...) で新しい文字列を作ります。
deepcopy はタダではありません。ユーザー1,000件(それぞれ小さなタグのリストを持つ)を含む設定 dict で、copy.copy は 0.25 µs、copy.deepcopy は 5.4 ms と、約2万倍の差でした(Python 3.9、5回の最速値)。深いコピーはループの中ではなく、境界で1回だけ行います。
is と ==、そして小さな整数のキャッシュ
== は「値が等しいか」、is は「同じオブジェクトか」を調べます。たまたま同じ答えになることが多いので混乱します。
a = 256; b = int("256")
c = 257; d = int("257")
print(a is b, c is d, c == d)
print(None is None)
True False True
True
CPython は -5 から 256 までの整数をあらかじめ1つずつ作って共有しています。257 はキャッシュの外なので、int("257") は新しいオブジェクトを作りました。さらに結果は、コードがどうコンパイルされたかでも変わります。対話モードで1行ずつ入力すると:
>>> a = 257
>>> b = 257
>>> a is b
False
ところが同じ内容を1つの .py ファイルに x = 257; y = 257; print(x is y) と書くと True になりました。コンパイラがモジュール内の同じ定数を1つにまとめたからです。同じコードで答えが変わるのですから、頼ってはいけません。Python 3.8 以降はコンパイル時に警告も出します。
~/demo/islit.py:5: SyntaxWarning: "is" with a literal. Did you mean "=="?
  print(n is 1000)
ルール:値の比較は ==、is はシングルトンだけ。実務では事実上 x is None と x is not None だけです。
真偽値の判定と f-string
すべてのオブジェクトは真偽値を持ちます。「空かゼロなら偽、それ以外は真」です。
for v in (0, 0.0, "", "0", [], [0], None, {}, " "):
    print(repr(v), bool(v))
0 False
0.0 False
'' False
'0' True
[] False
[0] True
None False
{} False
' ' True
"0" と " " は真です。空ではない文字列だからです。フォーム入力や CSV のセルを読むときによく間違えます。全角スペース " " も同じく真になります。また if count: は 0 を「値なし」と同じに扱うので、0 が正しい値なら if count is not None: と書きます。
f-string(3.6+)は今いちばん使われている書式指定で、{n=}(3.8+)はデバッグにとても便利です。
name, n = "lecture", 3
print(f"{name!r} {n:03d} {3.14159:.2f} {1234567:,} {n=}")
'lecture' 003 3.14 1,234,567 n=3
最初のトレースバックを読む
最初の1週間でほぼ全員が出会う2つのエラーです。まず文字列と数値の連結。
age = 30
print("Age: " + age)
Python 3.9:
Traceback (most recent call last):
  File "~/demo/age.py", line 2, in <module>
    print("Age: " + age)
TypeError: can only concatenate str (not "int") to str
Python 3.11 では、失敗した式を指す印が付きます。
    print("Age: " + age)
          ~~~~~~~~^~~~~
TypeError: can only concatenate str (not "int") to str
トレースバックは下から読みます。最後の行がエラーの種類とメッセージ、その上が発生場所です。f"Age: {age}" か "Age: " + str(age) で直します。JavaScript と違い、Python は str と int を勝手に変換しません。
次はインデントが混ざった場合です。
def total(prices):
    s = 0
    for p in prices:
        s += p
      return s          # 空白6個:4にも8にも合わない
  File "~/demo/indent.py", line 5
    return s
            ^
IndentationError: unindent does not match any outer indentation level
「Traceback」の見出しがありません。どの行も実行される前、ファイルをコンパイルする段階で出るエラーだからです。関数の本体をインデントし忘れると、3.9 は IndentationError: expected an indented block、3.11 は expected an indented block after function definition on line 1 と、より親切に教えてくれます。Web 記事からコードをコピーするとタブと空白が混ざりやすく、全角スペースが紛れ込むと SyntaxError: invalid non-printable character U+3000 という別のエラーになります(3.9・3.11 とも同じ表示)。エディタで Tab を空白4個にする設定をしておけば、この種のエラーはほぼ消えます。
実測:リストとタプル
sys.getsizeof はコンテナオブジェクト自体のサイズを返します(中の要素のサイズは含みません)。
import sys
print(sys.getsizeof([]), sys.getsizeof(()))
for n in (1, 10, 1000):
    data = list(range(n))
    print(n, sys.getsizeof(data), sys.getsizeof(tuple(data)))
| 要素数 | list(バイト) | tuple(バイト) |
|---|---|---|
| 0 | 56 | 40 |
| 1 | 64 | 48 |
| 10 | 136 | 120 |
| 1,000 | 8,056 | 8,040 |
1要素は8バイトのポインタなので、差は割合ではなく固定の16バイト(ヘッダ)です。append で伸ばしたリストは、次の追加を安くするために余裕を持って確保するので大きくなります。1つずつ20個追加する間に、サイズは 56 → 88 → 120 → 184 → 248 バイトと階段状に増えました。
生成時間はもっと面白い結果です(timeit、100万回、5回の最速値、Python 3.9。下の2行は x = 5; … で計測したので代入1回分を含みます)。
| 式 | 1回の生成時間 |
|---|---|
[1, 2, 3, 4, 5] |
36 ns |
(1, 2, 3, 4, 5) |
4.3 ns |
[1, 2, 3, 4, x] |
42 ns |
(1, 2, 3, 4, x) |
39 ns |
8倍の差は「タプルが速いから」ではありません。dis で見ると、定数だけのタプルはコンパイル時に1つの定数に畳み込まれ(LOAD_CONST ((1, 2, 3, 4, 5)))、実行時に作るものがありません。リストは毎回 BUILD_LIST + LIST_EXTEND で作られます。要素が1つでも変数なら、どちらも実行時に作るので時間はほぼ同じです。タプルとリストはこのナノ秒ではなく、意味(固定のレコードか、増えていく集まりか)で選びましょう。
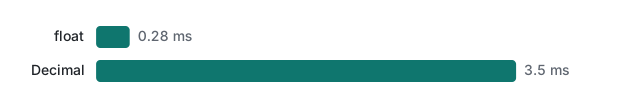
先ほどの Decimal のコストも測りました。random.Random(42) で作った価格10万件の合計は、float で 0.28 ms、Decimal で 3.5 ms でした(5回の最速値。2回目の実行では 4.5 ms)。float の合計は 5051429.01000001、Decimal の合計は 5051429.01 と表示されました。EC サイトのカート計算なら気にならない差で、数値シミュレーションなら float のままが妥当です。
正直な限界とバージョンメモ
- すべての例は Python 3.9.6 と Python 3.11.4 で実行しました。時間の計測は Python 3.9、Apple Silicon Mac(M1 Pro)だけで行ったので、別の環境では絶対値が変わります。
- 小さな整数の範囲(-5〜256)と定数の畳み込みは、言語仕様ではなく CPython の実装の詳細です。PyPy や将来の CPython では変わりうるので、数値を
isで比べてはいけない理由がもう1つ増えます。 sys.getsizeofの値は 64ビット CPython 3.9 のもので、バージョンによって少し変わります。- 3.11 のトレースバックの
~~~^~~~は PEP 657 で入りました。3.12・3.13 では「Did you mean …?」の提案などがさらに改善されていますが、この記事では実行していません。
次の講座
次は関数です。引数の渡し方、ミュータブルなデフォルト引数の罠(いま見た別名の問題が def の中に隠れたもの)、スコープとクロージャを扱います。
よくある質問
リストを1つ変更したら、別の変数まで変わってしまったのはなぜ?
b = a は何もコピーしません。同じリストオブジェクトに名前をもう1つ付けるだけなので、a.append() も b.append() も同じオブジェクトを変更します。独立したリストが必要なら a.copy() を、中にリストや辞書が入っているなら copy.deepcopy() を使います。
[[0] * 3] * 3 で作った2次元リストの1マスを変えると全行が変わるのはなぜ?
外側の * 3 が、1つの内側リストへの参照を3回複製するからです。grid[0][0] = 9 とすると [[9, 0, 0], [9, 0, 0], [9, 0, 0]] と表示されました。[[0] * 3 for _ in range(3)] のように内包表記で行を別々に作ります。
値の比較に is を使ってもいいですか?
値は == で比べ、is は None の判定(x is None)だけに使います。Python 3.9 と 3.11 で 256 is int('256') は True、257 is int('257') は False でした。小さな整数だけがキャッシュされるためです。リテラルに is を使うと SyntaxWarning も出ます。