Tipos y mutabilidad en Python: copias, is vs ==
Python desde ejecuciones reales: por qué 0.1+0.2 no da 0.3, la trampa de [[0]*3]*3, copy vs deepcopy (20,000 veces más lento), is vs == y tracebacks.
Serie: curso de Python 1/6 (principiante). Para quien ya escribe unas líneas de Python pero se sorprende cuando una lista cambia "sola". Al terminar vas a poder predecir cuándo dos variables comparten un objeto, elegir la copia correcta y leer los primeros tracebacks con los que se topa todo principiante.
Si llegaste a Python desde las macros de Excel, desde JavaScript en un bootcamp o desde C# en la universidad, tres cosas te van a morder en la primera semana: 0.1 + 0.2 imprime 0.30000000000000004, una lista que nunca tocaste cambia, y is a veces coincide con == y a veces no. Las tres vienen de una sola idea: en Python, una variable es un nombre pegado a un objeto, no una caja que guarda un valor. Cada salida de abajo se obtuvo ejecutando el código en Python 3.9 y Python 3.11 en una Mac con Apple Silicon (M1 Pro); las rutas de archivo en los tracebacks se acortaron a ~/demo/.
Los nombres apuntan a objetos
Ejecuta esto:
a = [1, 2, 3]
b = a
b.append(4)
print("a =", a, "| a is b:", a is b, "| id equal:", id(a) == id(b))

x = 10
y = x
y += 1
print("x =", x, "y =", y)
a = [1, 2, 3, 4] | a is b: True | id equal: True
x = 10 y = 11
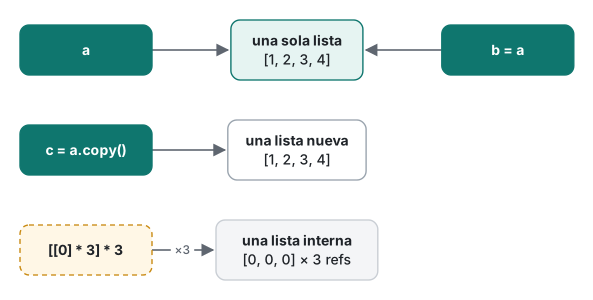
b = a no copió la lista. Le pegó un segundo nombre a la misma lista, así que agregar a través de b se ve también a través de a. Con los enteros, y += 1 parece el mismo patrón, pero se comporta distinto: un int no se puede modificar, así que y += 1 construye un nuevo objeto int 11 y mueve el nombre y hacia él. x sigue apuntando a 10.
Esa es toda la diferencia entre tipos mutables e inmutables:
| Tipo | ¿Mutable? | Qué hace += |
|---|---|---|
int, float, bool, None |
no | construye un objeto nuevo y reasigna el nombre |
str, tuple, frozenset, bytes |
no | construye un objeto nuevo y reasigna el nombre |
list, dict, set, bytearray |
sí | modifica el objeto en su lugar; todos los nombres lo ven |
Los tipos básicos y dos sorpresas
print(type(1), type(1.0), type("1"), type(True), type(None))
print(True + True, isinstance(True, int))
<class 'int'> <class 'float'> <class 'str'> <class 'bool'> <class 'NoneType'>
2 True
bool es una subclase de int, así que True + True da 2. A veces es útil (sum(x > 0 for x in data) cuenta los positivos) y a veces es un bug, por ejemplo cuando un campo JSON que debería ser un número llega como true y aun así pasa isinstance(v, int).
0.1 + 0.2, y cuándo usar Decimal
import math
from decimal import Decimal

print(0.1 + 0.2, 0.1 + 0.2 == 0.3)
print(f"{0.1:.20f}")
print(math.isclose(0.1 + 0.2, 0.3))
print(Decimal("0.1") + Decimal("0.2"), Decimal(0.1))
print(round(2.675, 2), round(0.5), round(1.5), round(2.5))
0.30000000000000004 False
0.10000000000000000555
True
0.3 0.1000000000000000055511151231257827021181583404541015625
2.67 0 2 2
Un float es un double binario IEEE 754. 0.1 no tiene representación binaria exacta, así que el valor guardado es apenas mayor que 0.1, y los errores de 0.1 y 0.2 se suman. No es un bug de Python: JavaScript, Java y C# imprimen lo mismo. Dos líneas de esa salida confunden a mucha gente:
Decimal(0.1)no es 0.1. Si le pasas un float, Decimal recibe el valor binario que ya viene mal. Construye siempre los Decimal desde strings:Decimal("0.1").round(2.675, 2)da2.67, porque el valor guardado es 2.67499999…, yround(0.5)/round(2.5)dan0y2porque Python redondea las mitades al par más cercano (el llamado "redondeo bancario").
Cuándo usar cada uno:
| Situación | Usa |
|---|---|
| Dinero, facturas, impuestos, cualquier cosa que una persona sumará a mano | Decimal construido desde strings |
| Mediciones, física, gráficos, ML | float, y compara con math.isclose |
| Contar cosas enteras (artículos, centavos) | int (guarda 1999 centavos, no 19.99) |
Error común: [[0] * 3] * 3
Quieres una cuadrícula de 3×3 llena de ceros, y esto parece correcto:
grid = [[0] * 3] * 3
grid[0][0] = 9
print("trap :", grid)

grid = [[0] * 3 for _ in range(3)]
grid[0][0] = 9
print("fixed:", grid)
trap : [[9, 0, 0], [9, 0, 0], [9, 0, 0]]
fixed: [[9, 0, 0], [0, 0, 0], [0, 0, 0]]
Qué pasa en realidad: [[0] * 3] es una lista que contiene una lista interna. Multiplicar la lista exterior por 3 copia la referencia tres veces, así que las tres filas son el mismo objeto. El [0] * 3 interior no tiene problema porque repite referencias al 0 inmutable, y un 0 nunca se puede modificar en su lugar.
Solución: construye cada fila por separado con una comprensión de listas, como en la segunda mitad. La misma trampa aparece con [{}] * n y [[]] * n.
Copiar: asignación, copy y deepcopy
Hay tres niveles, y quien empieza suele necesitar el segundo cuando cree que necesita el primero.
import copy

orig = {"name": "app", "tags": ["a", "b"]}
sh = copy.copy(orig)       # shallow: new dict, same inner list
dp = copy.deepcopy(orig)   # deep: new dict, new inner list
sh["tags"].append("SH")
print("orig:", orig, "| deep:", dp)
orig: {'name': 'app', 'tags': ['a', 'b', 'SH']} | deep: {'name': 'app', 'tags': ['a', 'b']}
La copia superficial (shallow) creó un diccionario nuevo, pero su valor "tags" sigue siendo la lista original, así que agregarle un elemento cambió orig. La copia profunda (deep) recorrió toda la estructura y copió cada objeto mutable de adentro.
La inmutabilidad también es superficial. Una tupla no se puede reasignar, pero una lista dentro de ella sí puede cambiar:
t = (1, [2, 3])
t[1].append(4)
print(t)
t[0] = 99
(1, [2, 3, 4])
TypeError: 'tuple' object does not support item assignment
Los strings se comportan como las tuplas: s[0] = "z" lanza TypeError: 'str' object does not support item assignment. Usa s = "z" + s[1:] o s.replace(...); ambos construyen un string nuevo.
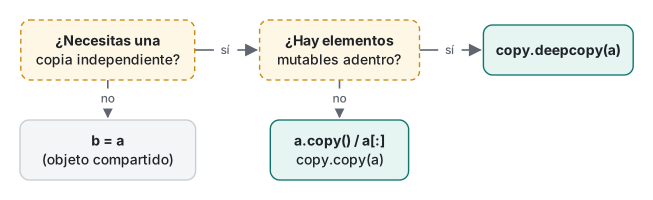
deepcopy no es gratis. Con un diccionario de configuración de 1,000 registros de usuario (cada uno con una pequeña lista de etiquetas), copy.copy tardó 0.25 µs y copy.deepcopy tardó 5.4 ms, unas 20,000 veces más (Python 3.9, mejor de 5). Haz la copia profunda una vez, en un borde del programa, no dentro de un bucle.
is vs ==, y la caché de enteros pequeños
== pregunta "¿los valores son iguales?". is pregunta "¿son el mismo objeto?". Muchas veces coinciden por casualidad:
a = 256; b = int("256")
c = 257; d = int("257")
print(a is b, c is d, c == d)
print(None is None)
True False True
True
CPython guarda un único objeto compartido para cada entero entre -5 y 256, así que cualquier 256 es el mismo objeto. El 257 no está en caché, así que int("257") construyó un objeto nuevo. El resultado también depende de cómo se compila el código. Escrito línea por línea en el intérprete interactivo:
>>> a = 257
>>> b = 257
>>> a is b
False
Pero dentro de un mismo archivo .py, x = 257; y = 257; print(x is y) imprimió True, porque el compilador guardó la constante una sola vez para todo el módulo. Mismo código, distinta respuesta. Justo por eso no debes depender de esto, y Python 3.8+ te lo advierte al compilar tu archivo:
~/demo/islit.py:5: SyntaxWarning: "is" with a literal. Did you mean "=="?
  print(n is 1000)
Regla: usa == para valores, e is solo para singletons; en la práctica, x is None (y x is not None).
Valores de verdad y f-strings
Todo objeto tiene un valor de verdad. La regla es "lo vacío o cero es falso, todo lo demás es verdadero":
for v in (0, 0.0, "", "0", [], [0], None, {}, " "):
    print(repr(v), bool(v))
0 False
0.0 False
'' False
'0' True
[] False
[0] True
None False
{} False
' ' True
"0" y " " son verdaderos: son strings no vacíos. Ten cuidado con esto al leer datos de un formulario o celdas de un CSV. if count: también trata el 0 como "falta el dato"; cuando 0 es un valor válido, escribe if count is not None:.
Los f-strings (Python 3.6+) son la forma moderna de formatear la salida, y {n=} (3.8+) es un regalo para depurar:
name, n = "lecture", 3
print(f"{name!r} {n:03d} {3.14159:.2f} {1234567:,} {n=}")
'lecture' 003 3.14 1,234,567 n=3
Cómo leer tus primeros tracebacks
Dos errores que todo principiante encuentra en la primera semana. Primero, sumar un número a un string:
age = 30
print("Age: " + age)
Python 3.9:
Traceback (most recent call last):
  File "~/demo/age.py", line 2, in <module>
    print("Age: " + age)
TypeError: can only concatenate str (not "int") to str
Python 3.11 agrega marcas que señalan la expresión que falló:
    print("Age: " + age)
          ~~~~~~~~^~~~~
TypeError: can only concatenate str (not "int") to str
Lee un traceback desde abajo: la última línea es el tipo de error y el mensaje; la línea de arriba es dónde ocurrió. Corrígelo con f"Age: {age}" o "Age: " + str(age). A diferencia de JavaScript, Python nunca convierte en silencio entre str e int.
Segundo, la indentación mezclada:
def total(prices):
    s = 0
    for p in prices:
        s += p
      return s          # 6 spaces: matches neither 4 nor 8
  File "~/demo/indent.py", line 5
    return s
            ^
IndentationError: unindent does not match any outer indentation level
No hay encabezado "Traceback": este error se lanza al compilar el archivo, antes de que se ejecute cualquier línea. Olvidar indentar el cuerpo de una función da IndentationError: expected an indented block en 3.9, que 3.11 mejora a expected an indented block after function definition on line 1. Configura tu editor para insertar 4 espacios al presionar Tab y toda esta familia de errores desaparece.
Una medición: list vs tuple
sys.getsizeof reporta el tamaño del contenedor en sí (no de los elementos a los que apunta):
import sys
print(sys.getsizeof([]), sys.getsizeof(()))
for n in (1, 10, 1000):
    data = list(range(n))
    print(n, sys.getsizeof(data), sys.getsizeof(tuple(data)))
| Elementos | list (bytes) | tuple (bytes) |
|---|---|---|
| 0 | 56 | 40 |
| 1 | 64 | 48 |
| 10 | 136 | 120 |
| 1,000 | 8,056 | 8,040 |
Cada casilla es un puntero de 8 bytes, así que la diferencia es un encabezado fijo de 16 bytes, no un porcentaje. Una lista construida con append es más grande, porque reserva espacio de más para que los siguientes append sean baratos: agregando 20 elementos uno por uno, el tamaño pasó por 56 → 88 → 120 → 184 → 248 bytes, en escalones.
Lo interesante está en el tiempo de construcción (timeit, 1,000,000 construcciones, mejor de 5, Python 3.9; las dos últimas filas se midieron como x = 5; …, así que incluyen una asignación):
| Expresión | Tiempo por construcción |
|---|---|
[1, 2, 3, 4, 5] |
36 ns |
(1, 2, 3, 4, 5) |
4.3 ns |
[1, 2, 3, 4, x] |
42 ns |
(1, 2, 3, 4, x) |
39 ns |
La diferencia de 8× no significa "las tuplas son rápidas". dis muestra que la tupla de puras constantes se pliega en una sola constante al compilar (LOAD_CONST ((1, 2, 3, 4, 5))), mientras que la lista hay que construirla cada vez (BUILD_LIST + LIST_EXTEND). En cuanto un elemento es una variable, ambas se construyen en tiempo de ejecución y los tiempos se acercan. Elige entre tuple y list por significado (un registro fijo frente a una colección que crece), no por estos nanosegundos.

El costo de Decimal que mencionamos antes, medido: sumar 100,000 precios (generados con random.Random(42)) tardó 0.28 ms con floats y 3.5 ms con Decimal (mejor de 5; una segunda ejecución dio 4.5 ms). El total con float imprimió 5051429.01000001; el total con Decimal, 5051429.01. Para un carrito de compras eso no es nada; para una simulación numérica, quédate con float.
Límites honestos y notas de versión
- Cada fragmento se ejecutó en Python 3.9.6 y Python 3.11.4. Los tiempos son solo de 3.9, en una Mac con Apple Silicon (M1 Pro); en otras computadoras los números absolutos van a ser distintos.
- El rango de enteros pequeños (-5 a 256) y el plegado de constantes son detalles de implementación de CPython, no reglas del lenguaje. PyPy y versiones futuras de CPython pueden comportarse distinto, otra razón más para no depender de
iscon números. - Los tamaños de
sys.getsizeofson de CPython 3.9 de 64 bits; cambian un poco entre versiones. - Las marcas de traceback de 3.11 (
~~~^~~~) vienen de la PEP 657. Python 3.12 y 3.13 mejoran todavía más los mensajes (por ejemplo, sugerencias "Did you mean …?" en más lugares); esas versiones no las ejecutamos aquí.
Siguiente
El próximo curso trata de funciones: argumentos, la trampa del argumento por defecto mutable (el mismo aliasing que acabas de ver, escondido en un def), ámbito y closures.
- Siguiente: Curso de Python 2/6: funciones, ámbito y argumentos por defecto
- Más adelante en la serie: iteradores y generadores (en inglés), decoradores y context managers (en inglés), hilos, procesos, asyncio y el GIL (en inglés), profiling y optimización (en inglés)
- El mismo tema en otros lenguajes: Curso de Java 1: tipos, strings e igualdad, Curso de VB.NET 1: Option Strict y tipos
Preguntas frecuentes
¿Por qué en Python al modificar una lista también cambia otra variable?
Porque b = a no copia nada. Le da un segundo nombre al mismo objeto lista, así que a.append() y b.append() modifican un único objeto. Usa a.copy() (o copy.deepcopy si la lista contiene listas o diccionarios) cuando necesites una lista independiente.
¿Por qué [[0] * 3] * 3 cambia todas las filas cuando modifico una sola celda?
El * 3 exterior repite tres veces una referencia a la misma lista interna. Asignar grid[0][0] = 9 imprimió [[9, 0, 0], [9, 0, 0], [9, 0, 0]]. Construye las filas con una comprensión de listas: [[0] * 3 for _ in range(3)].
¿Cuándo usar is y cuándo == para comparar en Python?
Usa == para valores y deja is para identidad, en la práctica para None (x is None). 256 is int('256') dio True pero 257 is int('257') dio False en Python 3.9 y 3.11, porque solo los enteros pequeños están en caché. Python incluso avisa: SyntaxWarning: "is" with a literal.