Streams, lambdas y Optional en Java (JDK 26)
Evaluación perezosa con peek, el crash de toMap por clave duplicada, for vs stream vs parallelStream (10 veces más lento con 1,000 elementos) y Optional.
Serie: curso de Java 4/6 (intermedio). Para quien ya lee una lambda sin problema, pero no tiene claro cuándo se ejecuta de verdad un stream, por qué revienta un collector o si parallelStream() va a ayudar. Al terminar vas a poder predecir en qué orden se ejecuta un pipeline, corregir las cuatro excepciones de streams con las que tropiezan los principiantes y elegir entre un bucle, un stream y un stream paralelo con mediciones en la mano.
Hoy los streams aparecen en cualquier code review de Java, ya sea en el pull request de tu primer trabajo, en un proyecto freelance heredado o en la entrega de un bootcamp, y casi todos los comentarios sobre ellos caen en unos pocos grupos: "esto se ejecuta dos veces", "esto revienta con claves duplicadas", "¿por qué esto es paralelo?", "no llames a get() sobre un Optional". Este artículo recorre cada uno con código que ejecutamos y la salida exacta. Nada de esto es un resumen del Javadoc; donde la documentación y nuestra ejecución ponen el énfasis en lugares distintos, mostramos la ejecución.
Entorno: OpenJDK 26 (Temurin build 26+35), Mac con Apple Silicon (M1 Pro, 8 núcleos; el common pool de fork-join reportó parallelism 7). Las demos cortas se ejecutaron con java File.java, y el benchmark con javac y luego java -Xms2g -Xmx2g. Los datos aleatorios usan new Random(7).
Lambdas, referencias a métodos e interfaces funcionales
Una lambda es una instancia de una interface funcional: una interface con exactamente un método abstracto. El JDK trae las formas más comunes en java.util.function, y una referencia a método es una forma más corta de escribir una lambda que solo llama a un método.
Function<String, Integer> len = String::length;            // T -> R
Predicate<String> empty = String::isEmpty;                  // T -> boolean
Supplier<List<String>> mk = ArrayList::new;                 // () -> T
BiFunction<String, String, Boolean> eq = String::equalsIgnoreCase;
UnaryOperator<String> up = s -> s.toUpperCase();            // T -> T
System.out.println(len.apply("tokyo") + " " + empty.negate().test("") + " "
    + mk.get() + " " + eq.apply("Java", "JAVA") + " " + up.andThen(s -> s + "!").apply("hi"));
5 false [] true HI!
String::length toma el receptor como argumento; String::equalsIgnoreCase toma el receptor como el primero de dos; ArrayList::new es un constructor. Los métodos default como negate() y andThen() te dejan combinarlas sin escribir lambdas nuevas.
El primer error de compilación que la gente encuentra con lambdas tiene que ver con las variables locales:
List<Integer> prices = List.of(980, 3200, 600);
int total = 0;
prices.forEach(p -> total += p);
Eff.java:7: error: local variables referenced from a lambda expression must be final or effectively final
        prices.forEach(p -> total += p);
                            ^
1 error
Una lambda solo puede leer una variable local si esa variable nunca cambia después de asignarse. La solución no es el truco del array de un elemento ni un AtomicInteger; es dejar que el stream calcule el valor: int total = prices.stream().mapToInt(Integer::intValue).sum(); (imprime 4780). Si vienes de C#, esto es más estricto que los closures de C#, que capturan variables por referencia; mira nuestro artículo sobre lambdas en C# (en inglés) para comparar.
Evaluación perezosa, hecha visible con peek
Un pipeline de stream no hace nada hasta que una operación terminal (findFirst, collect, count, forEach…) pide un resultado. peek te deja verlo en acción:
Stream<String> s = Stream.of("fig", "kiwi", "apple", "banana")
    .peek(x -> System.out.println("  peek   " + x))
    .filter(x -> x.length() > 3)
    .map(x -> { System.out.println("  map    " + x); return x.toUpperCase(); });
System.out.println("pipeline built, nothing printed yet");
Optional<String> first = s.findFirst();
System.out.println("findFirst -> " + first.get());

System.out.println("-- sorted() is a barrier:");
Stream.of("kiwi", "apple", "fig")
    .peek(x -> System.out.println("  before sort " + x))
    .sorted()
    .peek(x -> System.out.println("  after sort  " + x))
    .findFirst();
pipeline built, nothing printed yet
  peek   fig
  peek   kiwi
  map    kiwi
findFirst -> KIWI
-- sorted() is a barrier:
  before sort kiwi
  before sort apple
  before sort fig
  after sort  apple
En esa salida hay tres hechos. No se imprimió nada mientras se construía el pipeline. Los elementos pasaron de uno en uno, de arriba hacia abajo: fig pasó por peek y se descartó, luego kiwi recorrió todo el camino; no fue "primero peek a todo, luego filter a todo". Y findFirst cortó en seco (short-circuit): apple y banana nunca se leyeron. El segundo pipeline muestra la excepción: sorted() necesita ver todos los elementos antes de poder emitir el primero, así que es una barrera.
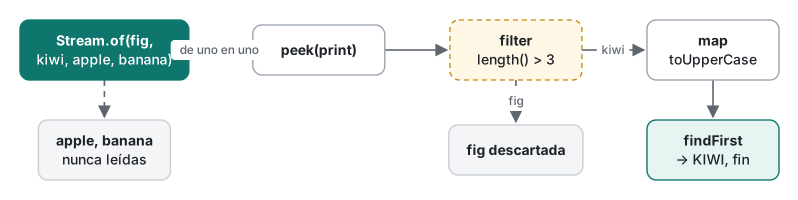
La consecuencia práctica: nunca pongas dentro de peek o map efectos secundarios de los que dependas. Si se ejecutan, y cuántas veces, depende de la operación terminal. count() tiene permiso para saltarse el pipeline cuando puede obtener el tamaño desde la fuente, y en JDK 26 lo hace:
List<String> l = List.of("a", "b", "c");
long n = l.stream().peek(x -> System.out.println("peek " + x)).count();
System.out.println("count=" + n);
long m = l.stream().peek(x -> System.out.println("peek " + x)).filter(x -> !x.isEmpty()).count();
System.out.println("count after filter=" + m);
count=3
peek a
peek b
peek c
count after filter=3
El primer peek nunca se ejecutó. Agregar un filter hizo que el tamaño fuera desconocido, así que el segundo pipeline sí se ejecutó.
Collectors: groupingBy, counting, joining y toMap
record Order(String city, String item, int yen) {}

List<Order> orders = List.of(
    new Order("Osaka", "ramen", 980), new Order("Tokyo", "sushi", 3200),
    new Order("Osaka", "takoyaki", 600), new Order("Fukuoka", "ramen", 850),
    new Order("Tokyo", "ramen", 1100));

System.out.println(orders.stream()
    .collect(Collectors.groupingBy(Order::city, Collectors.counting())));
System.out.println(orders.stream()
    .collect(Collectors.groupingBy(Order::city, TreeMap::new, Collectors.counting())));
System.out.println(orders.stream()
    .collect(Collectors.groupingBy(Order::city, TreeMap::new, Collectors.summingInt(Order::yen))));
System.out.println(orders.stream().map(Order::item).distinct().sorted()
    .collect(Collectors.joining(", ", "[", "]")));
System.out.println("max price per item " + orders.stream()
    .collect(Collectors.toMap(Order::item, Order::yen, Integer::max, TreeMap::new)));
{Tokyo=2, Fukuoka=1, Osaka=2}
{Fukuoka=1, Osaka=2, Tokyo=2}
{Fukuoka=850, Osaka=1580, Tokyo=4300}
[ramen, sushi, takoyaki]
max price per item {ramen=1100, sushi=3200, takoyaki=600}
Mira la primera línea: groupingBy devuelve un HashMap, así que las ciudades salen sin un orden concreto. Si el orden de salida importa (reportes, tests que comparan strings), pasa TreeMap::new como fábrica del mapa, como en la segunda línea.
Error común: toMap con claves duplicadas
Map<String, Integer> priceByItem = orders.stream()
    .collect(Collectors.toMap(Order::item, Order::yen));   // "ramen" appears 3 times
Lo que pasa en realidad:
Exception in thread "main" java.lang.IllegalStateException: Duplicate key ramen (attempted merging values 980 and 850)
    at java.base/java.util.stream.Collectors.duplicateKeyException(Collectors.java:137)
    at java.base/java.util.stream.Collectors.lambda$uniqKeysMapAccumulator$0(Collectors.java:184)
    at java.base/java.util.stream.ReduceOps$3ReducingSink.accept(ReduceOps.java:169)
    at java.base/java.util.stream.AbstractList$RandomAccessSpliterator.forEachRemaining(AbstractList.java:722)
    …
    at java.base/java.util.stream.ReferencePipeline.collect(ReferencePipeline.java:723)
    at Collect.main(Collect.java:34)
El toMap de dos argumentos asume que las claves son únicas. Es el típico bug de "funciona en el test, falla en producción": los datos de prueba tenían un solo ramen. Al menos el mensaje nombra la clave y los dos valores. Solución: decide qué significa un duplicado. Quédate con el máximo o con el último usando una función de merge (Integer::max, (a, b) -> b), o guárdalos todos con groupingBy.
Error común: usar un stream dos veces
Un Stream es un pipeline de un solo uso, no una colección.
Stream<String> names = Stream.of("ana", "bo", "chie");
System.out.println(names.count());
System.out.println(names.filter(n -> n.length() > 2).count());
3
Exception in thread "main" java.lang.IllegalStateException: stream has already been operated upon or closed
    at java.base/java.util.stream.AbstractPipeline.<init>(AbstractPipeline.java:201)
    …
    at java.base/java.util.stream.ReferencePipeline.filter(ReferencePipeline.java:184)
    at Twice.main(Twice.java:7)
Falla en filter, la primera llamada sobre el stream ya consumido. La causa habitual es un método que devuelve Stream<T> y alguien que usa ese resultado dos veces. Solución: conserva la fuente (List<String> names) y llama a names.stream() cada vez, o pasa un Supplier<Stream<String>> si la fuente es costosa de describir. Las dos versiones imprimen 3 y 2.
for vs stream vs parallelStream, medido
Mismo arnés que en el curso 3: ejecuciones de calentamiento sin medir, luego la mediana de 11 ejecuciones medidas, con los resultados sumados en un campo para que el JIT no pueda descartar el trabajo. La herramienta adecuada sería JMH; no se usa porque en esta serie no se puede instalar nada. La tarea: sumar los cuadrados de los valores pares.
cores=8 commonPool parallelism=7
== A: sum of squares of even values, int[10,000,000]
for loop                       median   27.1625 ms  (min 26.6018, max 27.8053)
IntStream                      median   33.0102 ms  (min 32.3225, max 34.3361)
IntStream.parallel()           median    8.9625 ms  (min 7.4494, max 10.0775)
== B: same work, List<Integer> of 1,000 elements, 1,000 calls per sample
for loop                       median    0.6654 ms  (min 0.6511, max 0.6747)
stream()                       median    0.7942 ms  (min 0.7686, max 2.4748)
parallelStream()               median    6.5678 ms  (min 4.3373, max 22.6658)
== C: LinkedList<Integer> of 1,000,000
for loop                       median    4.5086 ms  (min 4.4550, max 4.7740)
stream()                       median    7.5466 ms  (min 7.5023, max 7.8438)
parallelStream()               median    4.6535 ms  (min 3.8963, max 7.4222)
== D: Stream.iterate(...).limit(2,000,000)
for loop                       median    0.6605 ms  (min 0.6594, max 0.8373)
iterate+limit                  median   16.1651 ms  (min 13.1412, max 18.0171)
iterate+limit parallel         median   24.7791 ms  (min 14.7319, max 35.6399)
LongStream.range parallel      median    0.7683 ms  (min 0.3322, max 2.5199)
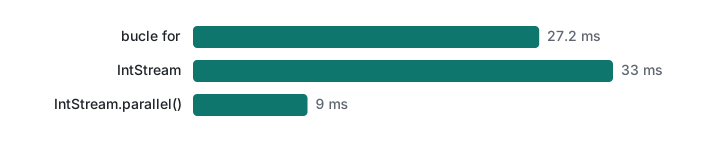
A, un array grande de primitivos: el stream paralelo fue 3 veces más rápido que el bucle. Un array se parte en mitades iguales gratis, no hay boxing, y 10 millones de elementos es trabajo suficiente para pagar 7 hilos trabajadores. El IntStream secuencial fue alrededor de un 20% más lento que el bucle.
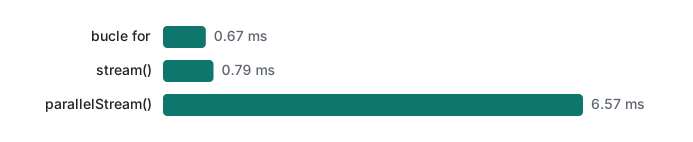
B, el caso en que paralelo es más lento: con una lista de 1,000 elementos, parallelStream() fue unas 10 veces más lento que el bucle. Cada llamada parte la lista, reparte los trozos al pool de fork-join, espera y junta; con 1,000 elementos ese overhead es mayor que el trabajo. Esa es la forma de la mayoría del código que atiende peticiones: muchas colecciones pequeñas, no una gigante.
C y D, las sorpresas: suele decirse que LinkedList se paraleliza mal, pero aquí el stream paralelo simplemente empató con el bucle; no perdió. La verdadera trampa es Stream.iterate(...).limit(n): cada elemento depende del anterior y limit debe conservar el orden, así que la versión paralela fue más lenta que la secuencial (24.8 ms contra 16.2 ms), y ambas fueron más de 20 veces más lentas que un bucle simple. LongStream.range expresa los mismos números de forma divisible y fue rápido. En tres ejecuciones, los números paralelos fueron los que más se movieron (A: 5.3–9.0 ms, B: 6.6–17.9 ms, D: 15.9–24.8 ms); las conclusiones no.
Optional: buenos y malos usos
Optional es un tipo de retorno para decir "puede que no haya resultado". No es un reemplazo general de null.
record User(String id, String email) {}
static final Map<String, User> DB = Map.of("u1", new User("u1", "a@example.com"), "u2", new User("u2", null));
static Optional<User> find(String id) { return Optional.ofNullable(DB.get(id)); }
static String slowDefault() { System.out.println("  (slowDefault called)"); return "none"; }

System.out.println(find("u1").map(User::email).orElse("none"));
System.out.println(find("u2").map(User::email).orElse("none"));   // map turns null into empty
System.out.println(find("u9").map(User::email).orElse("none"));
System.out.println("orElse:");
System.out.println(find("u1").map(User::email).orElse(slowDefault()));
System.out.println("orElseGet:");
System.out.println(find("u1").map(User::email).orElseGet(Opt::slowDefault));
a@example.com
none
none
orElse:
  (slowDefault called)
a@example.com
orElseGet:
a@example.com
Buen uso: devolver Optional desde una búsqueda, encadenar map y decidir una sola vez al final. Fíjate en que map también absorbe un null devuelto por la función (u2 no tiene correo). La trampa es orElse(x): x es un argumento normal, así que se evalúa incluso cuando hay un valor. Si el valor por defecto es una consulta a la base de datos o crea un objeto, usa orElseGet.
Los malos usos, con lo que hace cada uno:
try { find("u9").get().email(); }
catch (NoSuchElementException e) { System.out.println("get() on empty -> " + e.getMessage()); }
try { Optional.of(DB.get("u9")); }
catch (NullPointerException e) { System.out.println("Optional.of(null) -> NPE"); }
Optional<User> maybe = null;
try { maybe.isPresent(); }
catch (NullPointerException e) { System.out.println("null Optional -> " + e.getMessage()); }
get() on empty -> No value present
Optional.of(null) -> NPE
null Optional -> Cannot invoke "java.util.Optional.isPresent()" because "maybe" is null
get() sin comprobar es solo una NullPointerException con otro nombre; si estás seguro de que hay valor, orElseThrow() lo dice de forma explícita. Optional.of es para valores que no pueden ser null; en otro caso usa ofNullable. La última línea es una variable Optional que a su vez es null, lo cual le quita todo el sentido. Evita también Optional como campo o parámetro de método (no es Serializable y agrega una asignación), y nunca envuelvas una colección: devuelve una lista vacía. Un detalle: el mensaje útil de NPE nombra la variable "maybe" solo cuando la clase se compiló con -g; con el lanzador de código fuente (java Opt.java) obtuvimos "<local1>".
Excepciones checked dentro de lambdas
Function.apply no declara throws, así que una lambda que llama a un método que lanza una excepción checked no compila:
List<String> texts = files.stream()
    .map(p -> Files.readString(p))
    .toList();
Checked.java:8: error: unreported exception IOException; must be caught or declared to be thrown
            .map(p -> Files.readString(p))
                                      ^
1 error
La solución estándar es envolver la excepción checked en una unchecked dentro de un pequeño helper, y desenvolverla donde puedas manejarla:
static String read(Path p) {
    try { return Files.readString(p); }
    catch (IOException e) { throw new UncheckedIOException(e); }
}
…
try {
    List<String> texts = List.of(Path.of("a.txt"), Path.of("missing.txt")).stream()
        .map(Checked2::read)
        .toList();
} catch (UncheckedIOException e) {
    System.out.println("caught: " + e.getCause());
}
caught: java.nio.file.NoSuchFileException: missing.txt
UncheckedIOException existe justo para este caso. Eso sí, sé honesto contigo mismo con el resultado: la primera falla detiene todo el pipeline. Si necesitas "leer lo que se pueda y reportar el resto", un for simple con try/catch por archivo es más claro que cualquier truco con streams.
Stream.toList() vs collect(Collectors.toList())
List<Integer> a = Stream.of(3, 1, 2).collect(Collectors.toList());
a.add(4);
System.out.println("collect(toList()) " + a + " " + a.getClass().getName());
List<Integer> u = Stream.of(3, 1, 2).collect(Collectors.toUnmodifiableList());
System.out.println("toUnmodifiableList " + u.getClass().getName());
System.out.println("toList with null " + Stream.of(1, null, 3).toList());
try { Stream.of(1, null, 3).collect(Collectors.toUnmodifiableList()); }
catch (NullPointerException e) { System.out.println("toUnmodifiableList with null -> " + e); }
List<Integer> b = Stream.of(3, 1, 2).toList();
System.out.println("Stream.toList()   " + b + " " + b.getClass().getName());
b.add(4);
collect(toList()) [3, 1, 2, 4] java.util.ArrayList
toUnmodifiableList java.util.ImmutableCollections$ListN
toList with null [1, null, 3]
toUnmodifiableList with null -> java.lang.NullPointerException
Stream.toList()   [3, 1, 2] java.util.ImmutableCollections$ListN
Exception in thread "main" java.lang.UnsupportedOperationException
    at java.base/java.util.ImmutableCollections.uoe(ImmutableCollections.java:145)
    at java.base/java.util.ImmutableCollections$AbstractImmutableCollection.add(ImmutableCollections.java:150)
    at ToList.main(ToList.java:17)
Cambiar .collect(Collectors.toList()) por el más corto .toList() es una sugerencia popular del IDE, y cambia el comportamiento: el código que después llama a add sobre el resultado ahora lanza una excepción. Stream.toList() es no modificable pero admite null; toUnmodifiableList() es no modificable y rechaza null. Collectors.toList() dio un ArrayList en JDK 26, pero el Javadoc no promete nada sobre si se puede modificar, así que escribe Collectors.toCollection(ArrayList::new) cuando necesites modificar la lista.
Gatherers (Java 24): comprobados en 26
Antes de Java 24, las operaciones intermedias personalizadas (ventanas, totales acumulados, "quedarse solo con los valores que suben") obligaban a salir del stream o a escribir un Spliterator. La JEP 485 hizo definitivos Stream.gather y java.util.stream.Gatherers en Java 24. Compila y se ejecuta en 26:
List<Integer> temps = List.of(21, 23, 22, 26, 25, 27, 30);
System.out.println(temps.stream().gather(Gatherers.windowFixed(3)).toList());
System.out.println(temps.stream().gather(Gatherers.windowSliding(3))
    .map(w -> w.stream().mapToInt(Integer::intValue).average().orElse(0))
    .map(a -> String.format("%.1f", a)).toList());
System.out.println(temps.stream().gather(Gatherers.scan(() -> 0, Integer::sum)).toList());
// a custom gatherer: keep only values that rose compared with the previous one
Gatherer<Integer, int[], Integer> rising = Gatherer.ofSequential(
    () -> new int[]{Integer.MIN_VALUE},
    (state, x, down) -> { boolean up = x > state[0]; state[0] = x; return !up || down.push(x); });
System.out.println(temps.stream().gather(rising).toList());
[[21, 23, 22], [26, 25, 27], [30]]
[22.0, 23.7, 24.3, 26.0, 27.3]
[21, 44, 66, 92, 117, 144, 174]
[21, 23, 26, 27, 30]
Compilar el mismo archivo con javac --release 23 falla con error: Gatherers is a preview API and is disabled by default. (fue preview en 22 y 23); con --release 24 compila. El integrador del gatherer personalizado devuelve false para detener el stream antes de tiempo; devolvemos !up || down.push(x) para que saltarse un elemento nunca lo detenga.
Tabla de decisión
| Situación | Usa | Por qué (según las ejecuciones de arriba) |
|---|---|---|
| filter/map/collect simple, priorizando legibilidad | stream() secuencial |
alrededor de 20% más lento que el bucle en A y B |
| Bucle crítico sobre un array de primitivos | bucle for o IntStream |
sin boxing; bucle 27 ms contra stream 33 ms |
| Array grande, trabajo de CPU independiente, 1M+ elementos | parallel() |
9.0 ms contra 27.2 ms con 8 núcleos |
| Colecciones pequeñas, código por petición | nunca parallelStream() |
10x más lento con 1,000 elementos |
| Secuencia generada | IntStream.range, no Stream.iterate().limit() |
0.77 ms contra 16–25 ms |
| Las claves pueden repetirse | toMap(k, v, merge) o groupingBy |
el toMap de dos argumentos lanza IllegalStateException |
| Necesitas el resultado dos veces | conserva la fuente y vuelve a llamar a .stream() |
un stream lanza excepción en el segundo uso |
| "Sin resultado" en una búsqueda | devuelve Optional, termina con orElseGet |
orElse evalúa su argumento de todos modos |
| La lista resultante se va a modificar | collect(toCollection(ArrayList::new)) |
Stream.toList() no es modificable |
| Ventanas, totales acumulados | gather(...) (Java 24+) |
se queda dentro del pipeline |
| E/S con manejo de errores por elemento | for simple + try/catch |
las excepciones checked no cruzan lambdas |
Límites honestos y notas de versión
- No es JMH. Calentamiento más medianas, tres ejecuciones completas. Los resultados paralelos fueron los que más variaron (una muestra de B llegó a 22.7 ms). Toma como resultado las proporciones, no los milisegundos. En una máquina con 2 núcleos, A ganaría mucho menos.
- El common pool de fork-join lo comparten todos los streams paralelos de la JVM. Un stream paralelo en un servidor web compite con otras peticiones; nuestra medición con un solo programa no lo muestra.
- Versiones comprobadas en JDK 26 con
--release:Stream.toList()es de Java 16 (--release 15falla concannot find symbol). Los gatherers son definitivos en Java 24 (error de preview en 23). Las lambdas y los streams son de Java 8,Files.readStringde Java 11 y los records de Java 16; esos solo los ejecutamos en 26. - No cubrimos
Collectors.teeing(Java 12), los collectors de primitivos en profundidad ni el comportamiento en paralelo de los gatherers personalizados. - Las mismas ideas en otros lenguajes: LINQ en C# (en inglés) tiene la misma ejecución diferida, y los generadores de Python son perezosos de la misma manera, sacando un elemento a la vez.
Ejecútalo tú mismo
Guárdalo como StreamBench.java y luego ejecuta javac StreamBench.java && java -Xms2g -Xmx2g StreamBench:
import java.util.*;
import java.util.function.LongSupplier;
import java.util.stream.*;

public class StreamBench {
    static long sink;

    static double measure(String name, int warmup, int runs, LongSupplier task) {
        for (int i = 0; i < warmup; i++) sink += task.getAsLong();
        double[] t = new double[runs];
        for (int i = 0; i < runs; i++) {
            long s = System.nanoTime();
            sink += task.getAsLong();
            t[i] = (System.nanoTime() - s) / 1e6;
        }
        Arrays.sort(t);
        System.out.printf("%-30s median %9.4f ms  (min %.4f, max %.4f)%n", name, t[runs / 2], t[0], t[runs - 1]);
        return t[runs / 2];
    }

    public static void main(String[] args) {
        System.out.println("cores=" + Runtime.getRuntime().availableProcessors()
            + " commonPool parallelism=" + java.util.concurrent.ForkJoinPool.commonPool().getParallelism());
        Random rnd = new Random(7);
        int[] big = new int[10_000_000];
        for (int i = 0; i < big.length; i++) big[i] = rnd.nextInt(1000);

        System.out.println("== A: sum of squares of even values, int[10,000,000]");
        measure("for loop", 20, 11, () -> { long s = 0; for (int v : big) if ((v & 1) == 0) s += (long) v * v; return s; });
        measure("IntStream", 20, 11, () -> Arrays.stream(big).filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum());
        measure("IntStream.parallel()", 20, 11, () -> Arrays.stream(big).parallel().filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum());

        System.out.println("== B: same work, List<Integer> of 1,000 elements, 1,000 calls per sample");
        List<Integer> small = new ArrayList<>();
        for (int i = 0; i < 1_000; i++) small.add(rnd.nextInt(1000));
        measure("for loop", 20, 11, () -> { long t = 0; for (int r = 0; r < 1000; r++) { long s = 0; for (int v : small) if ((v & 1) == 0) s += (long) v * v; t += s; } return t; });
        measure("stream()", 20, 11, () -> { long t = 0; for (int r = 0; r < 1000; r++) t += small.stream().filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum(); return t; });
        measure("parallelStream()", 20, 11, () -> { long t = 0; for (int r = 0; r < 1000; r++) t += small.parallelStream().filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum(); return t; });

        System.out.println("== C: LinkedList<Integer> of 1,000,000");
        List<Integer> linked = new LinkedList<>();
        for (int i = 0; i < 1_000_000; i++) linked.add(rnd.nextInt(1000));
        measure("for loop", 20, 11, () -> { long s = 0; for (int v : linked) if ((v & 1) == 0) s += (long) v * v; return s; });
        measure("stream()", 20, 11, () -> linked.stream().filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum());
        measure("parallelStream()", 20, 11, () -> linked.parallelStream().filter(v -> (v & 1) == 0).mapToLong(v -> (long) v * v).sum());

        System.out.println("== D: Stream.iterate(...).limit(2,000,000)");
        measure("for loop", 20, 11, () -> { long s = 0; for (int i = 0; i < 2_000_000; i++) s += (long) i * i; return s; });
        measure("iterate+limit", 20, 11, () -> Stream.iterate(0, i -> i + 1).limit(2_000_000).mapToLong(i -> (long) i * i).sum());
        measure("iterate+limit parallel", 20, 11, () -> Stream.iterate(0, i -> i + 1).limit(2_000_000).parallel().mapToLong(i -> (long) i * i).sum());
        measure("LongStream.range parallel", 20, 11, () -> LongStream.range(0, 2_000_000).parallel().map(i -> i * i).sum());
        System.out.println("sink=" + (sink != 0));
    }
}
Anterior: Curso 3: rendimiento de colecciones · Siguiente: Curso 5: virtual threads y concurrencia
Preguntas frecuentes
¿parallelStream es más rápido que un for en Java?
Solo cuando hay suficiente trabajo por llamada. Sumar cuadrados sobre un int[10,000,000] tardó 27.2 ms con un bucle for y 9.0 ms con IntStream.parallel() en una M1 Pro de 8 núcleos. El mismo trabajo sobre una lista de 1,000 elementos tardó 0.67 ms por cada 1,000 llamadas con un bucle y 6.57 ms con parallelStream, unas 10 veces más lento.
¿Por qué Collectors.toMap lanza IllegalStateException: Duplicate key?
toMap con dos argumentos asume que cada clave es única. Cuando un segundo elemento cae en una clave existente, lanza la excepción, y el mensaje muestra la clave y ambos valores, por ejemplo 'Duplicate key ramen (attempted merging values 980 and 850)'. Pasa un tercer argumento, una función de merge como Integer::max, o usa groupingBy.
¿Qué diferencia hay entre Stream.toList() y collect(Collectors.toList())?
Stream.toList() (Java 16) devuelve una lista no modificable; llamar a add sobre ella lanza UnsupportedOperationException. collect(Collectors.toList()) devolvió un java.util.ArrayList en JDK 26, que sí puedes modificar, aunque el Javadoc no promete ese tipo. Stream.toList() acepta elementos null; Collectors.toUnmodifiableList() no.