JIT, GC y memoria en Java (JDK 26), medidos
JIT de 349 a 46 µs, -Xint 20× más lento, escape analysis, cuatro GC comparados con -Xlog:gc, un OOM de G1 a la mitad del heap y una fuga hallada con jcmd.
Serie: curso de Java 6/6 (avanzado). Para quien ya escribe Java correcto y ahora quiere saber qué hace la JVM con él: cuándo el código se vuelve rápido, adónde se va la memoria y por qué el mismo programa se comporta distinto con otro flag. Al terminar vas a poder leer la salida de -Xlog:gc, elegir un recolector con mediciones y no con folclore, encontrar una fuga con jcmd y detectar un benchmark que te está mintiendo.
Casi todos los reportes de "Java es lento" que llegan a un equipo, ya sea en una startup que escala su primer backend o en una consultora que mantiene sistemas de un banco, salen de uno de tres lugares: medir antes de que el JIT haya compilado algo, un recolector elegido por costumbre o una memoria que solo crece. Este curso desarma cada uno con programas pequeños, y cada número de abajo sale de una ejecución en la máquina que describimos a continuación. Donde los resultados nos sorprendieron (un heap que se agotó a la mitad de su tamaño, un attach que falló mientras una fuga agonizaba) conservamos la salida cruda.
Entorno: OpenJDK 26 (Temurin 26+35), Mac con Apple Silicon (M1 Pro, 8 núcleos, 16 GB), macOS. Heap por defecto en esta máquina: 4 GB máximo, G1. La mayoría de los tiempos son la mediana de 3 ejecuciones; las de calentamiento del JIT muestran cada lote por separado, porque el calentamiento es justamente lo que queremos ver.
El calentamiento del JIT, medido: los primeros lotes contra el estado estable
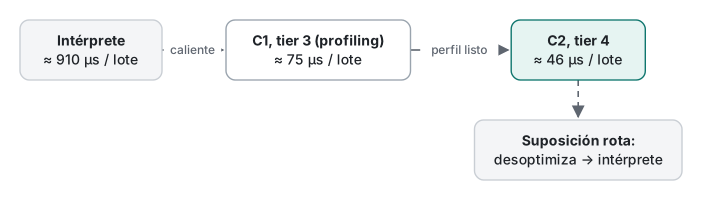
HotSpot empieza cada método en el intérprete de bytecode, cuenta llamadas e iteraciones de bucles, y compila los métodos calientes por niveles (tiers): primero C1 con profiling (tier 3), luego C2 usando ese perfil (tier 4). Para verlo, medimos el mismo lote pequeño 2,000 veces:
/** Time the same small batch 2,000 times and watch the JIT kick in. */
public class Warmup {
    static int collatzSteps(long n) {                // pure CPU, no allocation
        int steps = 0;
        while (n != 1) { n = (n & 1) == 0 ? n >>> 1 : 3 * n + 1; steps++; }
        return steps;
    }
    static long batch() {                            // 1,000 calls per batch
        long total = 0;
        for (long n = 1; n <= 1_000; n++) total += collatzSteps(n);
        return total;
    }
    public static void main(String[] args) {
        int[] show = {1, 2, 3, 5, 10, 20, 50, 100, 200, 500, 1000, 2000};
        long check = 0; int k = 0;
        long start = System.nanoTime();
        for (int b = 1; b <= 2000; b++) {
            long t0 = System.nanoTime();
            check += batch();
            long us = (System.nanoTime() - t0) / 1_000;
            if (k < show.length && b == show[k]) { System.out.printf("batch %4d: %,6d us%n", b, us); k++; }
        }
        System.out.printf("total %,d ms, checksum %d%n", (System.nanoTime() - start) / 1_000_000, check);
    }
}
| Lote | Por defecto, ejecución 1 | Ejecución 2 | Ejecución 3 | -Xint |
Solo C1 (-XX:TieredStopAtLevel=1) |
|---|---|---|---|---|---|
| 1 | 334 µs | 349 µs | 373 µs | 919 µs | 258 µs |
| 2 | 215 µs | 227 µs | 209 µs | 900 µs | 109 µs |
| 5 | 82 µs | 81 µs | 79 µs | 908 µs | 142 µs |
| 50 | 75 µs | 74 µs | 76 µs | 926 µs | 95 µs |
| 200 | 47 µs | 49 µs | 47 µs | 1,011 µs | 76 µs |
| 2000 | 46 µs | 45 µs | 49 µs | 1,043 µs | 76 µs |
| total | 117 ms | 119 ms | 116 ms | 1,940 ms | 174 ms |
Se ven tres mesetas: el primer lote en unos 350 µs (parte interpretado, parte compilando), unos 75 µs desde el lote 5 y 46 µs desde alrededor del lote 200. El estado estable es 7.6× más rápido que el lote 1. -XX:+PrintCompilation muestra exactamente cuándo ocurrió cada paso (columnas: ms desde el inicio, id de compilación, % = on-stack replacement, tier):
20    8       3       Warmup::collatzSteps (38 bytes)
20    9 %     4       Warmup::collatzSteps @ 2 (38 bytes)
36  116       4       Warmup::collatzSteps (38 bytes)
37    8       3       Warmup::collatzSteps (38 bytes)   made not entrant: not used
...
44  127 %     4       Warmup::batch @ 4 (29 bytes)
45  128       4       Warmup::batch (29 bytes)
collatzSteps llegó a C2 (tier 4) a los 36 ms, y la versión de C1 se descartó ("made not entrant"). La segunda bajada, alrededor de los lotes 100–200, coincide con el momento en que el llamador batch() se compiló en tier 4 a los 45 ms, lo que permite a C2 hacer inlining de collatzSteps dentro del bucle. La columna Solo C1 muestra lo que aporta C2: C1 se estabilizó en 76 µs, C2 en 46 µs.
-Xint contra el modo por defecto: cuánto vale el JIT
-Xint apaga el JIT. Entonces cada lote cuesta unos 900 µs, y la ejecución completa tardó 1,940 ms en lugar de 117 ms: 16.6× más lento en total, unas 20× en estado estable (910 µs contra 46 µs). El intérprete nunca mejora, y por eso su columna es plana. -Xint sirve para una sola cosa: si un bug desaparece con -Xint, sospecha de un problema relacionado con el JIT (o de una data race que el compilador hizo visible). Nunca lo uses para que los tiempos sean "justos".
Escape analysis, en pocas palabras
C2 revisa si un objeto puede verse fuera del método que lo creó. Si no, puede saltarse la asignación y mantener los campos en registros ("scalar replacement"). Un record que nunca sale del bucle:
record Point(double x, double y) {}

static double sumDistances(int n) {
    double s = 0;
    for (int i = 0; i < n; i++) {
        Point p = new Point(i, i + 1);            // never stored, never returned
        s += Math.sqrt(p.x() * p.x() + p.y() * p.y());
    }
    return s;
}
Contamos los bytes asignados por el thread con com.sun.management.ThreadMXBean.getThreadAllocatedBytes para 50 millones de iteraciones por ronda:
== default (EA on)
round 1:   57 ms, allocated      7 MB
round 3:   50 ms, allocated      0 MB
round 5:   49 ms, allocated      0 MB
== -XX:-DoEscapeAnalysis
round 1:  326 ms, allocated  1,525 MB
round 3:   80 ms, allocated  1,525 MB
round 5:  117 ms, allocated  1,525 MB
1,525 MB son exactamente 50 millones × 32 bytes, un Point por iteración. Con escape analysis activado, el estado estable no asignó nada. La lección práctica no es "apágalo"; es que los objetos pequeños y de vida corta dentro de bucles calientes muchas veces salen gratis, así que no hagas inlining manual de records por velocidad sin medir. Escape analysis se rinde cuando el objeto se guarda en un campo, se pasa a un método al que no se le hace inlining, o el método es demasiado grande para el inlining.
Cuatro recolectores de basura con el mismo programa
Un programa que asigna mucho: 20 millones de byte[] de 16 a 495 bytes (con Random(42) como semilla), de los que 1 de cada 8 se guarda en un anillo de 200,000 posiciones, para que haya un conjunto de trabajo vivo de unos 50 MB.
Random rnd = new Random(42);
byte[][] live = new byte[200_000][];          // the long-lived working set
for (int i = 0; i < 20_000_000; i++) {
    byte[] b = new byte[16 + rnd.nextInt(480)];
    b[0] = (byte) i;
    if ((i & 7) == 0) live[rnd.nextInt(live.length)] = b;   // 1 in 8 survives a while
    checksum += b[0];
}
Se ejecuta con java -XX:+Use<X>GC -Xmx1g -Xlog:gc:file=gc.log Churn. Líneas reales, recortadas:
G1        [0.874s][info][gc] GC(23) Pause Young (Normal) (G1 Evacuation Pause) 675M->207M(862M) 7.355ms
Serial    [1.218s][info][gc] GC(122) Pause Young (Allocation Failure) 606M->449M(622M) 17.816ms
Parallel  [0.779s][info][gc] GC(32) Pause Young (Allocation Failure) 341M->104M(342M) 5.028ms
ZGC       [0.275s][info][gc] GC(3) Minor Collection (Allocation Rate) 432M(42%)->226M(22%) 0.047s
La línea de ZGC es la trampa: 0.047 s es la duración de todo el ciclo concurrente mientras el programa seguía corriendo, no una pausa. El -Xlog:gc simple no imprime las pausas de ZGC; agrega gc+phases:
[0.375s][info][gc,phases] GC(5) Y: Pause Mark Start (Major) 0.009ms
[0.386s][info][gc,phases] GC(5) Y: Concurrent Mark 10.114ms
[0.386s][info][gc,phases] GC(5) Y: Pause Mark End 0.008ms
[0.387s][info][gc,phases] GC(5) Y: Pause Relocate Start 0.006ms
Sumando cada línea "Pause" (un script de Python sobre los logs, 3 ejecuciones de cada uno):
| Recolector | Tiempo total (mediana) | Pausas | Pausa total | Pausa máxima | Tiempo de CPU de usuario |
|---|---|---|---|---|---|
| G1 (por defecto) | 990 ms | 26 | 107 ms | 10.8 ms | 1.09 s |
| Serial | 1,283 ms | 125 | 591 ms | 20.7 ms | 1.18 s |
| Parallel | 844 ms | 35 | 151 ms | 9.2 ms | 1.36 s |
| ZGC | 939 ms | ~60 | 0.4 ms | 0.02 ms | 1.69 s |
El tiempo de CPU de usuario sale de ejecuciones aparte del mismo programa con /usr/bin/time -p y sin logging.
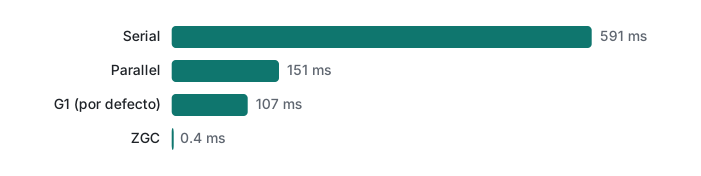
Cómo leerlo: Parallel terminó primero porque lanza los 8 núcleos a cada pausa y no hace nada de forma concurrente. ZGC casi nunca detuvo la aplicación, pero quemó 55% más CPU que G1 haciendo su trabajo en otros threads, algo que pagas en un servidor ocupado. Serial usó un solo thread de GC y, con su generación joven pequeña por defecto, recolectó 125 veces. G1 queda en el medio en todas las columnas, y por eso es el predeterminado. La dispersión entre ejecuciones de G1 fue grande (835–1,087 ms), así que aquí las diferencias por debajo de ~15% son ruido.
Tamaño del heap, OutOfMemoryError y una sorpresa de G1
Llena el heap con bloques de 1 MB bajo -Xmx64m:
List<byte[]> keep = new ArrayList<>();
while (true) {
    keep.add(new byte[1 << 20]);
    if (keep.size() % 16 == 0) System.out.println("holding " + keep.size() + " MB");
}
max heap = 64 MB
holding 16 MB
Exception in thread "main" java.lang.OutOfMemoryError: Java heap space
    at Oom.main(Oom.java:10)
Nunca imprimió "holding 32 MB". Un heap de 64 MB se agotó tras 31 arrays de 1 MB. El log lo explica: Pause Young (Normal) (G1 Humongous Allocation). Con este heap, G1 eligió regiones de 1 MB (-XX:+PrintFlagsFinal muestra G1HeapRegionSize = 1048576). Cualquier objeto de media región o más es humongous y recibe regiones completas solo para él, y new byte[1048576] es 1 MB de datos más una cabecera de 16 bytes, así que necesita dos regiones. Contamos cuántos arrays cupieron antes del error:
| Tamaño del array | G1 | Serial |
|---|---|---|
| 1,048,576 bytes (1 MB) | 31 (31.0 MB) | 59 (59.0 MB) |
| 1,048,560 bytes (1 MB − 16) | 62 (62.0 MB) | 60 (60.0 MB) |
| 524,288 bytes | 62 (31.0 MB) | 120 (60.0 MB) |
| 262,144 bytes | 189 (47.3 MB) | 242 (60.5 MB) |
Dieciséis bytes menos duplicaron lo que G1 podía guardar. Los buffers de exactamente una potencia de dos que son grandes en relación con el tamaño de región son el peor caso. Soluciones: un heap más grande (el tamaño de región crece con él), -XX:G1HeapRegionSize=, o buffers un poco más pequeños.
Dos salidas reales más que vale la pena conocer. -XX:+ExitOnOutOfMemoryError imprime Terminating due to java.lang.OutOfMemoryError: Java heap space y termina con código de salida 3, que un supervisor puede reiniciar, en lugar de dejar un proceso medio muerto. Y cuando el heap está tan lleno que ni siquiera el handler de errores puede asignar memoria, solo obtienes esto, sin stack trace:
Exception: java.lang.OutOfMemoryError thrown from the UncaughtExceptionHandler in thread "main"
Error común: una fuga de memoria con un mapa static
El error: un HashMap static usado como caché, con una clave nueva en cada petición.
static final Map<String, Session> CACHE = new HashMap<>();          // the leak
...
cache.put("req-" + req, new Session("user" + (req % 100), new byte[1024]));
Lo que pasa en realidad con -Xmx256m:
requests=   50,000  entries=   50,001  heapUsed=  63 MB
requests=  100,000  entries=  100,001  heapUsed= 120 MB
requests=  150,000  entries=  150,001  heapUsed= 180 MB
requests=  200,000  entries=  200,001  heapUsed= 253 MB

Exception: java.lang.OutOfMemoryError thrown from the UncaughtExceptionHandler in thread "main"
Mientras corría, jstat y jcmd, que vienen con el JDK, lo mostraron desde afuera:
$ jcmd -l
69893 Leak
$ jstat -gcutil <pid> 3000
  S0     S1     E      O      M     CCS    YGC     YGCT     FGC    FGCT  ...
     - 100.00   0.00  91.67  73.19  20.54      8     0.009     0     0.000
     - 100.00   0.00  98.34  73.26  20.54     37     0.037     0     0.000
     -      -  33.33  67.30  73.84  20.54     44     0.054     1     0.024
     - 100.00  12.50  99.99  73.84  20.54     55     0.086     1     0.024
$ jcmd <pid> GC.class_histogram
 num     #instances         #bytes  class name (module)
   1:        227556       79768448  [B (java.base@26)
   2:        155023        3720552  java.lang.String (java.base@26)
   3:         75104        2403328  java.util.HashMap$Node (java.base@26)
   4:         72451        1738824  Leak$Session
La columna O (generación vieja, % de ocupación) vuelve a subir a 99.99 después de un full GC (FGC = 1): son datos vivos, no basura. En el histograma, las cuentas de Leak$Session y HashMap$Node se mueven juntas, lo que apunta directo al mapa. jcmd <pid> GC.heap_info agregó 86 old (86M), 1 humongous (1M). Una trampa más: en una ejecución anterior, más rápida, jcmd falló con AttachNotSupportedException: ... state is not ready to participate in attach handshake! porque la JVM estaba atascada en full GCs seguidos. Conéctate temprano, o arranca con -XX:+HeapDumpOnOutOfMemoryError.
La solución: ponle un límite a la caché. Un LinkedHashMap ordenado por acceso es un LRU de 5 líneas:
static final Map<String, Session> LRU = new LinkedHashMap<>(16, 0.75f, true) {
    @Override protected boolean removeEldestEntry(Map.Entry<String, Session> e) {
        return size() > 10_000;
    }
};
Mismo programa, mismo heap, 80 segundos: 600,000 peticiones, entries= 10,000 en todas las líneas y el heap entre 17 y 53 MB. (No es thread-safe; para cachés compartidas, envuélvelo o usa una librería de caché de verdad.)
Arranque: java File.java contra una clase compilada
java Hello.java compila el código fuente en memoria en cada arranque. Medianas de 20 arranques de cada uno, medidas desde un script de Python:
| Comando | Mediana |
|---|---|
java Hello.java (arranque desde el fuente) |
291 ms |
java -Xshare:off -cp cls Hello |
64 ms |
java -cp hello.jar Hello |
43 ms |
java -cp cls Hello |
39 ms |
java -XX:AOTCache=hello.aot -cp hello.jar Hello |
35 ms |
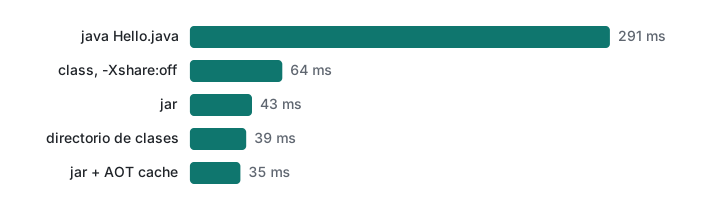
Arrancar desde el fuente cuesta unos 250 ms de compilación cada vez: está bien para scripts y clases, pero no para una herramienta de línea de comandos que se llama dentro de un bucle. -Xshare:off desactiva el archivo de class data sharing que trae el JDK y suma unos 25 ms. Nuestro primer intento de caché AOT falló con errores reales:
$ java -XX:AOTCacheOutput=hello.aot -cp cls Hello
Error occurred during CDS dumping
Cannot have non-empty directory in paths
La caché AOT solo acepta JARs en el class path. Después de empaquetar un JAR con la herramienta jar del JDK, -XX:AOTCacheOutput escribió una caché de 10 MB y el arranque bajó de 43 a 35 ms. Antes de eso, como el primer paso había fallado, -XX:AOTCache=hello.aot apuntaba a un archivo que no existía: la JVM imprimió [error][aot] Unable to map shared spaces, ejecutó el programa de todos modos sin la caché y terminó con código 0, algo que un script de build no notaría.
Advertencias honestas sobre benchmarks (sin JMH)
Cada número de arriba se midió con System.nanoTime() en bucles simples, no con JMH, que este entorno no incluía. Funciona solo porque los efectos son grandes. Lo que puede salir mal al medir a mano:
- Sin calentamiento: el lote 1 fue 7.6× más lento que el estado estable. Descarta siempre las primeras rondas, y muéstralas si el calentamiento le importa a tus usuarios.
- Código muerto: si un resultado no se usa, C2 puede borrar el trabajo. Cada programa de aquí imprime un checksum.
- El inlining cambia lo que mides: la segunda aceleración vino de compilar al llamador. Un micro-benchmark mide tu método en un contexto de inlining concreto.
- Ruido: el tiempo total de G1 varió entre 835 y 1,087 ms en ejecuciones idénticas. Repite, reporta medianas y desconfía de diferencias menores a ~15%.
- Máquina: una M1 Pro tiene 6 núcleos de rendimiento y 2 de eficiencia; el planificador decide cuál te toca.
Para cualquier diferencia menor a unas 2×, usa JMH.
Tabla de decisión y notas de versión
| Objetivo | Haz esto | Evidencia de arriba |
|---|---|---|
| Micro-mediciones justas | calienta, imprime un checksum, repite, toma la mediana | 349 → 46 µs |
| CLI de vida corta | JAR compilado, considera una caché AOT | 291 contra 35 ms |
| Proceso batch de throughput | Parallel GC | menor tiempo total, 844 ms |
| Servicio sensible a la latencia | ZGC, presupuesta la CPU extra | pausa máxima 0.02 ms, +55% CPU |
| No estás seguro | G1 (por defecto) | en el medio en todas las columnas |
| Buffers grandes en un heap pequeño | evita tamaños exactos de potencia de dos ≥ media región | 31 contra 62 arrays |
| Sospecha de fuga | jstat -gcutil, luego jcmd GC.class_histogram |
O de vuelta en 99.99% tras un full GC |
- Comprobado solo en JDK 26. ZGC es generacional por defecto desde JDK 23 (las líneas
Y:/O:de arriba); el flag de un solo paso-XX:AOTCacheOutputse agregó en JDK 25 y la caché AOT en sí en JDK 24 (JEP 483). No ejecutamos JDKs anteriores para confirmarlo. - El arranque desde un archivo fuente (
java Hello.java) existe desde JDK 11; los programas fuente de varios archivos, desde JDK 22. Aquí solo usamos la forma de un archivo. - La herramienta de línea de comandos
jfrno estaba en esta imagen del JDK;jcmdyjstatsí.
Este es el último curso de Java. El curso 5 cubrió el lado de los threads del mismo runtime.
Anterior: Curso 5: virtual threads y concurrencia · Volver al inicio: Curso 1: tipos, strings e igualdad
Relacionados: curso de Python 6: profiling y optimización · VB.NET 6: VB.NET en .NET 10 e interoperabilidad con C# (en inglés)
Preguntas frecuentes
¿Cuánto tarda el calentamiento del JIT en Java?
En nuestra prueba, un lote de 1,000 llamadas tardó 349 µs la primera vez, unos 75 µs desde el lote 5 (compilado con C1) y 46 µs desde alrededor del lote 200 (compilado con C2), todo en menos de 0.1 s. El mismo lote tardó unos 910 µs con -Xint, que desactiva el JIT. Los benchmarks cortos que no calientan miden sobre todo el intérprete y el compilador.
¿Qué recolector de basura (GC) conviene usar en JDK 26?
Quédate con G1, el predeterminado, salvo que tengas un motivo medido. En una prueba con muchas asignaciones y -Xmx1g, Parallel tuvo el menor tiempo total (844 ms) y ZGC las pausas más cortas (0.4 ms en total, 0.02 ms como máximo), pero usó alrededor de 55% más CPU que G1. Serial pausó 591 ms en total a lo largo de 125 recolecciones.
¿Por qué mi programa Java se quedó sin memoria a la mitad de -Xmx?
Con G1 y un heap pequeño, los objetos de media región o más son 'humongous' y ocupan regiones completas. Con -Xmx64m el tamaño de región es 1 MB, así que un byte[1048576] más su cabecera de 16 bytes necesita dos regiones: solo caben 31 de esos arrays. Con arrays 16 bytes más pequeños caben 62. Serial GC acomodó 59 de los arrays de 1 MB.