Rendimiento de colecciones en Java, medido en JDK 26
ArrayList vs LinkedList, HashMap vs TreeMap y Stack medidos en JDK 26: get(i) tardó 455 ms contra 0.08 ms. Más boxing y ConcurrentModificationException.
Serie: curso de Java 3/6 (intermedio). Para quien ya escribe clases en Java y quiere elegir implementaciones de List, Set, Map y Deque con evidencia y no por costumbre. Al terminar vas a poder predecir qué colección se vuelve lenta, evitar las dos excepciones con las que las colecciones reciben a los principiantes y medir tu propio código sin ninguna librería de benchmarking.
Si programas en Java para un backend, una app Android o una entrevista técnica en una startup, eliges una colección varias veces al día, y casi siempre ArrayList y HashMap son la respuesta correcta. Este artículo es para las otras veces: cuando una lista se usa como cola, cuando alguien elige un TreeMap "porque ordenado queda bonito", o cuando un bucle borra elementos y revienta. Cada número de abajo se midió en nuestra máquina y cada error se copió de una ejecución real.
Entorno: OpenJDK 26 (Temurin build 26+35), Mac con Apple Silicon (M1 Pro, 8 núcleos), macOS. Los programas se ejecutaron con java -Xms3g -Xmx3g para que el redimensionamiento del heap no aparezca en los tiempos. Los datos aleatorios usan new Random(42).
Cómo medimos sin JMH
La herramienta correcta para micro-benchmarks en Java es JMH. No la usamos, porque esta serie solo ejecuta lo que viene con el JDK y no se puede instalar nada. En su lugar, cada caso pasa por un pequeño helper: ejecuta la tarea algunas veces sin medir para que el compilador JIT la compile (calentamiento o warm-up), luego mide varias ejecuciones y reporta la mediana.
static long sink; // results are added here so the JIT cannot delete the work

static double measure(String name, int warmup, int runs, LongSupplier task) {
    for (int i = 0; i < warmup; i++) sink += task.getAsLong();
    double[] t = new double[runs];
    for (int i = 0; i < runs; i++) {
        long s = System.nanoTime();
        sink += task.getAsLong();
        t[i] = (System.nanoTime() - s) / 1e6;
    }
    Arrays.sort(t);
    System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n",
                      name, t[runs / 2], t[0], t[runs - 1]);
    return t[runs / 2];
}
Esto alcanza para ver diferencias de 2x o más. No alcanza para zanjar una discusión sobre un 10%: no hay un fork por benchmark, no hay análisis de código muerto y las pausas del GC caen donde caen. Ejecutamos el benchmark cuatro veces; las salidas de abajo son de una ejecución, y donde las ejecuciones no coincidieron damos el rango. El archivo completo está al final del artículo.
ArrayList vs LinkedList: get(i), insertar al inicio y recorrer
Las dos implementan List, así que parecen intercambiables. No lo son. ArrayList es un array redimensionable; LinkedList es una cadena de objetos nodo, cada uno con punteros prev y next.
== get(i) x 10,000 random indexes, size 100,000
ArrayList.get                      median     0.082 ms  (min 0.058, max 0.355)
LinkedList.get                     median   454.775 ms  (min 451.945, max 463.801)
== add(0, x) x 50,000 into an empty list
ArrayList.add(0,x)                 median   117.930 ms  (min 116.612, max 122.530)
LinkedList.addFirst                median     0.483 ms  (min 0.397, max 0.761)
ArrayDeque.addFirst                median     0.633 ms  (min 0.571, max 0.691)
== for-each over 1,000,000 elements
ArrayList iterate                  median     0.968 ms  (min 0.964, max 0.977)
LinkedList iterate                 median     1.923 ms  (min 1.909, max 1.937)
Lee los tres bloques por separado:
- get(i):
LinkedList.get(i)camina desde el extremo más cercano, hasta 50,000 saltos en una lista de 100,000 elementos. Diez mil lecturas aleatorias tardaron 455 ms contra 0.08 ms. Un buclefor (int i = 0; i < list.size(); i++) list.get(i)sobre unaLinkedListes cuadrático, y es la forma más común en que esta clase le hace daño a la gente. - insertar al inicio: aquí
LinkedListgana por un factor de unas 240 veces, porqueArrayList.add(0, x)desplaza todos los elementos existentes. PeroArrayDequehace el mismo trabajo en el mismo tiempo, con menos memoria por elemento. - recorrer: incluso la lectura secuencial, el caso en que las listas enlazadas deberían ir bien, fue dos veces más lenta. Cada nodo es un objeto aparte, así que la CPU sigue punteros en lugar de leer memoria contigua.
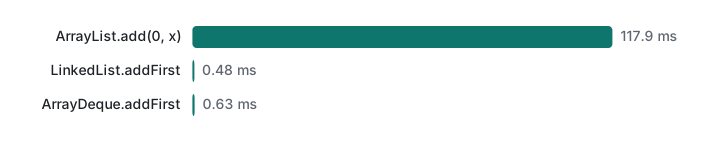
La regla práctica: si necesitas el inicio, necesitas un Deque, y el Deque por defecto es ArrayDeque. No hemos encontrado un caso en código de aplicación donde LinkedList fuera la mejor opción. Si quieres ver por qué las estructuras enlazadas se comportan así, nuestro recorrido por la lista enlazada (en inglés) construye una a mano.
Búsquedas en HashMap vs TreeMap, y ArrayDeque vs Stack
== 1,000,000 lookups, 100,000 String keys
HashMap.get                        median     9.623 ms  (min 9.493, max 10.595)
TreeMap.get                        median   259.214 ms  (min 238.363, max 322.357)
== push+pop 1,000,000 (stack use)
Stack push/pop                     median     4.674 ms  (min 4.252, max 5.679)
ArrayDeque push/pop                median     6.911 ms  (min 6.600, max 144.144)
TreeMap fue 27 veces más lento aquí (en nuestras cuatro ejecuciones la mediana de HashMap fue de 8.9 a 17.2 ms y la de TreeMap de 259 a 380 ms). Se suman dos razones. Un árbol rojo-negro con 100,000 claves tiene unos 17 niveles, así que cada búsqueda hace unas 17 comparaciones en lugar de un hash y, normalmente, un solo equals. Y nuestras claves tienen la forma "user-12345": cada compareTo recorre primero el prefijo común "user-". Los IDs, URLs y rutas de archivo reales comparten prefijos todo el tiempo. TreeMap se gana su costo cuando necesitas firstKey(), headMap(), ceilingKey() o recorrer en orden; si solo necesitas búsquedas, es el mapa equivocado. (El árbol en sí lo explicamos en nuestro artículo sobre el árbol binario de búsqueda (en inglés).)
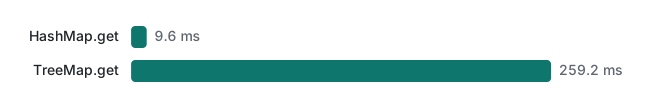
El resultado de Stack nos sorprendió. El consejo habitual es "Stack es synchronized, así que es lento". En JDK 26 un lock sin contención es barato, y Stack no fue más lento en ninguna de las cuatro ejecuciones (medianas de 4.7 a 7.0 ms contra 5.3 a 11.3 ms para ArrayDeque, con ruido del GC en ambos). Así que la razón para evitar Stack es su API, no la velocidad:
Stack<String> st = new Stack<>();
ArrayDeque<String> dq = new ArrayDeque<>();
for (String s : List.of("a", "b", "c")) { st.push(s); dq.push(s); }
System.out.println("Stack      " + st + "  peek=" + st.peek());
System.out.println("ArrayDeque " + dq + "  peek=" + dq.peek());
Stack      [a, b, c]  peek=c
ArrayDeque [c, b, a]  peek=c
Los dos devuelven c en peek(), pero Stack se recorre y se imprime de abajo hacia arriba, porque por debajo es un Vector. Además deja que cualquiera haga st.get(0) o st.add(x) y rompa la disciplina de pila. ArrayDeque se recorre en el orden de pop y solo expone operaciones de deque. Un límite: ArrayDeque rechaza elementos null con una NullPointerException.
El costo del boxing y la capacidad inicial
Una List<Integer> guarda referencias a objetos Integer, no números. Sumando diez millones de valores:
== sum of 10,000,000 ints
int[] sum                          median     3.281 ms  (min 3.205, max 3.306)
List<Integer> sum (0..999)         median     6.814 ms  (min 6.670, max 6.951)
List<Integer> sum (distinct)       median     6.764 ms  (min 6.663, max 6.869)
La lista con boxing fue unas dos veces más lenta. Probamos dos versiones: valores 0..999 (que salen de la caché de Integer, así que la lista solo tiene 1,000 objetos distintos) y valores 0..9,999,999 (diez millones de objetos separados). El tiempo fue el mismo, porque ambos se asignan en orden y quedan cerca en memoria. En un servidor que corre durante mucho tiempo, donde los objetos se crean en momentos distintos, se dispersan y la diferencia suele crecer. El costo mayor es la memoria: en una JVM de 64 bits con punteros comprimidos, cada posición de la lista es una referencia de 4 bytes más un objeto Integer de 16 bytes, contra 4 bytes en un int[].
La capacidad inicial es la otra mejora barata. Un ArrayList nuevo empieza vacío, reserva 10 posiciones en el primer add y luego crece un 50% cada vez que se llena, copiando el array anterior. Medimos los bytes asignados por el hilo actual con ThreadMXBean.getThreadAllocatedBytes (parte del JDK, sin instalar nada):
grow steps to reach 1000000: 29
allocated, default capacity : 14,586,416 bytes
allocated, new ArrayList<>(N): 4,000,040 bytes
median time, default  : 2.505 ms
median time, presized : 2.205 ms
Llenar 1,000,000 de elementos sin capacidad inicial asignó 3.6 veces más memoria (todos los arrays intermedios abandonados) y tardó un 12% más. El número de memoria es exacto y repetible; la diferencia de tiempo es pequeña. Cuando conoces el tamaño, como al convertir una colección en otra, pásalo. Para un HashMap, Java 19 agregó HashMap.newHashMap(n), que tiene en cuenta el factor de carga de 0.75; new HashMap<>(n) te da un mapa que se redimensiona antes de llegar a n entradas.
Error común: ConcurrentModificationException
Es la primera excepción de colecciones con la que se topa casi todo el mundo. Borra los números pares mientras recorres:
import java.util.*;

public class Cme {
    public static void main(String[] args) {
        List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
        for (Integer n : nums) {
            if (n % 2 == 0) nums.remove(n);   // remove(Object) while iterating
        }
        System.out.println(nums);
    }
}
Lo que pasa en realidad (java Cme.java):
Exception in thread "main" java.util.ConcurrentModificationException
    at java.base/java.util.ArrayList$Itr.checkForComodification(ArrayList.java:1104)
    at java.base/java.util.ArrayList$Itr.next(ArrayList.java:1058)
    at Cme.main(Cme.java:6)
El for-each se compila a un Iterator. ArrayList cuenta los cambios estructurales en un campo llamado modCount, y el iterador lo compara en cada next(). La línea 6 es la del for, no la del remove: el borrado funcionó, y fue el siguiente paso del bucle el que lo notó. Ojo: aquí "concurrent" no tiene nada que ver con hilos.
Peor aún, la comprobación no siempre salta. Borra el penúltimo elemento y el bucle termina antes de volver a llamar a next():
List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4));
for (Integer n : nums) {
    if (n == 3) nums.remove(n);
}
System.out.println(nums);
[1, 2, 4]
Sin excepción, y funcionó de pura suerte. Un código así pasa un test con un conjunto de datos y falla en producción con otro. Por eso mismo el Javadoc llama a esta comprobación "best-effort".
Solución: di lo que quieres decir.
List<Integer> a = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
a.removeIf(n -> n % 2 == 0);
System.out.println("removeIf      " + a);

List<Integer> b = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
for (Iterator<Integer> it = b.iterator(); it.hasNext(); )
    if (it.next() % 2 == 0) it.remove();
System.out.println("it.remove()   " + b);
removeIf      [1, 3, 5]
it.remove()   [1, 3, 5]
Prefiere removeIf: en ArrayList compacta el array una sola vez, mientras que llamar repetidamente a it.remove() desplaza la cola en cada llamada. Usa el iterador explícito cuando la decisión necesita más que un predicado, por ejemplo registrar en el log cada elemento borrado.
Error común: List.of es de solo lectura
List.of, Set.of y Map.of (Java 9+) devuelven colecciones inmutables. Es útil, pero nada en el tipo lo indica: son List<String> comunes y corrientes.
List<String> a = Arrays.asList("x", "y");
a.set(0, "X");                       // fine: fixed-size, not read-only
System.out.println(a);
List<String> fixed = List.of("x", "y");
try { a.add("z"); } catch (UnsupportedOperationException e) { System.out.println("Arrays.asList add -> " + e); }
try { fixed.contains(null); } catch (NullPointerException e) { System.out.println("List.of contains(null) -> " + e); }
fixed.add("z");
[X, y]
Arrays.asList add -> java.lang.UnsupportedOperationException
List.of contains(null) -> java.lang.NullPointerException
Exception in thread "main" java.lang.UnsupportedOperationException
    at java.base/java.util.ImmutableCollections.uoe(ImmutableCollections.java:145)
    at java.base/java.util.ImmutableCollections$AbstractImmutableCollection.add(ImmutableCollections.java:150)
    at Immutable.main(Immutable.java:11)
Detrás de una misma interface se esconden tres contratos distintos. Arrays.asList tiene tamaño fijo pero te deja hacer set. List.of rechaza cualquier cambio, y además rechaza null, incluso en contains(null). El compilador no puede detectar nada de esto; te enteras en tiempo de ejecución. La solución es copiar cuando piensas modificar: new ArrayList<>(List.of(...)), que es lo que hacen los ejemplos de arriba.
Colecciones secuenciadas (Java 21): getFirst, getLast, reversed
Antes de Java 21, "el último elemento" era list.get(list.size() - 1) en una lista, deque.peekLast() en un deque y un bucle en un LinkedHashSet. Java 21 agregó las interfaces SequencedCollection, SequencedSet y SequencedMap, con un mismo vocabulario para todas:
List<String> list = new ArrayList<>(List.of("mon", "tue", "wed"));
System.out.println(list.getFirst() + " " + list.getLast() + " " + list.reversed());
LinkedHashMap<String, Integer> lhm = new LinkedHashMap<>();
lhm.put("x", 1); lhm.put("y", 2); lhm.putFirst("w", 0);
System.out.println(lhm + " first=" + lhm.firstEntry() + " reversed=" + lhm.reversed());
LinkedHashSet<String> set = new LinkedHashSet<>(List.of("b", "c"));
set.addFirst("a");
System.out.println(set + " last=" + set.getLast());
List<String> rev = list.reversed();
rev.add("thu");          // writes through: adds at the FRONT of the original
System.out.println("original after rev.add: " + list);
mon wed [wed, tue, mon]
{w=0, x=1, y=2} first=w=0 reversed={y=2, x=1, w=0}
[a, b, c] last=c
original after rev.add: [thu, mon, tue, wed]
Dos detalles importan. reversed() devuelve una vista, no una copia: agregar al final de la vista puso "thu" al inicio de la original. Y getFirst() sobre una lista vacía lanza NoSuchElementException, a diferencia de peekFirst() en un deque, que devuelve null. Confirmamos la versión: compilar el mismo código con javac --release 20 falla con error: cannot find symbol ... method getFirst(), y con --release 21 compila.
Tabla de decisión
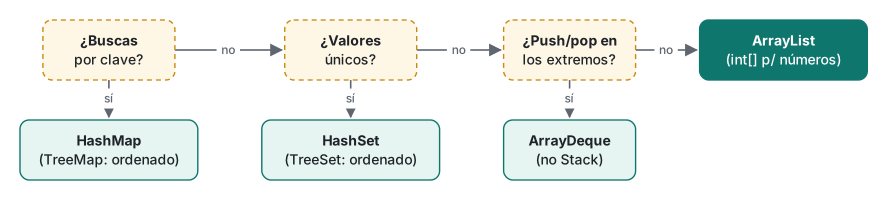
| Necesitas | Usa | Evita | Por qué (según los números de arriba) |
|---|---|---|---|
| Una lista que lees por índice | ArrayList |
LinkedList |
get(i): 0.08 ms contra 455 ms para 10,000 lecturas |
| Una cola, una pila o ambos extremos | ArrayDeque |
Stack, ArrayList.add(0, x) |
insertar al inicio: 0.63 ms contra 118 ms; Stack filtra métodos de Vector |
| Solo búsqueda por clave | HashMap |
TreeMap |
9.6 ms contra 259 ms para 1M de búsquedas |
| Claves ordenadas, rangos, clave más cercana | TreeMap |
ordenar un HashMap cada vez |
ceilingKey, headMap, firstKey |
| Conservar el orden de inserción | LinkedHashMap / LinkedHashSet |
HashMap y cruzar los dedos |
el orden de HashMap no está especificado |
| Millones de números | int[], long[] |
List<Integer> |
la suma fue 2x más lenta; ~5x la memoria |
| Un tamaño que conoces | new ArrayList<>(n), HashMap.newHashMap(n) |
capacidad por defecto | 3.6x menos asignación con 1M de elementos |
| Borrar mientras recorres | removeIf, iterator.remove() |
list.remove() en un for-each |
ConcurrentModificationException, o suerte silenciosa |
| Una lista constante | List.of |
pasarla a código que llama a add |
UnsupportedOperationException en tiempo de ejecución |
Límites honestos y notas de versión
- No es JMH. Nuestro arnés tiene calentamiento y medianas, pero no JVMs en fork, ni blackhole, ni barras de error estadísticas. Toma como reales las diferencias de 2x o más, y todo lo que esté por debajo de ~20% como "más o menos igual". Las pausas del GC causaron los valores máximos (una ejecución de
ArrayDequellegó a 144 ms). - Una sola máquina. Apple Silicon (M1 Pro), OpenJDK 26, G1 GC (el predeterminado). Los tamaños de caché son distintos en servidores x86; las proporciones suelen mantenerse, los números absolutos no.
- Versiones comprobadas:
List.ofnecesita Java 9 (--release 8falla concannot find symbol ... method of(String,String);--release 9compila). Las colecciones secuenciadas necesitan Java 21 (comprobado con--release 20y21).HashMap.newHashMapes de Java 19; solo lo ejecutamos en 26. Todo lo demás se ejecutó solo en 26. - No medimos colecciones concurrentes (
ConcurrentHashMap,CopyOnWriteArrayList). Les corresponde el curso 5 sobre virtual threads y concurrencia. - Si vienes de C#, vas a reconocer casi todos estos compromisos en las colecciones genéricas de C# (en inglés); lo propio de Java es el boxing y que
Stack extends Vector.
Ejecútalo tú mismo
Guárdalo como CollBench.java y ejecuta java -Xms3g -Xmx3g CollBench.java (necesita unos 3 GB de heap y tarda alrededor de un minuto):
import java.util.*;
import java.util.function.*;

public class CollBench {
    static long sink;

    static double measure(String name, int warmup, int runs, LongSupplier task) {
        for (int i = 0; i < warmup; i++) sink += task.getAsLong();
        double[] t = new double[runs];
        for (int i = 0; i < runs; i++) {
            long s = System.nanoTime();
            sink += task.getAsLong();
            t[i] = (System.nanoTime() - s) / 1e6;
        }
        Arrays.sort(t);
        System.out.printf("%-34s median %9.3f ms  (min %.3f, max %.3f)%n", name, t[runs / 2], t[0], t[runs - 1]);
        return t[runs / 2];
    }

    public static void main(String[] args) {
        final int N = 100_000;
        Random rnd = new Random(42);
        int[] idx = new int[10_000];
        for (int i = 0; i < idx.length; i++) idx[i] = rnd.nextInt(N);

        List<Integer> al = new ArrayList<>(), ll = new LinkedList<>();
        for (int i = 0; i < N; i++) { al.add(i); ll.add(i); }
        System.out.println("== get(i) x 10,000 random indexes, size 100,000");
        measure("ArrayList.get", 5, 7, () -> { long s = 0; for (int i : idx) s += al.get(i); return s; });
        measure("LinkedList.get", 2, 5, () -> { long s = 0; for (int i : idx) s += ll.get(i); return s; });

        System.out.println("== add(0, x) x 50,000 into an empty list");
        measure("ArrayList.add(0,x)", 3, 5, () -> { List<Integer> l = new ArrayList<>(); for (int i = 0; i < 50_000; i++) l.add(0, i); return l.size(); });
        measure("LinkedList.addFirst", 3, 5, () -> { LinkedList<Integer> l = new LinkedList<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });
        measure("ArrayDeque.addFirst", 3, 5, () -> { ArrayDeque<Integer> l = new ArrayDeque<>(); for (int i = 0; i < 50_000; i++) l.addFirst(i); return l.size(); });

        System.out.println("== for-each over 1,000,000 elements");
        List<Integer> al2 = new ArrayList<>(), ll2 = new LinkedList<>();
        for (int i = 0; i < 1_000_000; i++) { al2.add(i % 1000); ll2.add(i % 1000); }
        measure("ArrayList iterate", 10, 9, () -> { long s = 0; for (int v : al2) s += v; return s; });
        measure("LinkedList iterate", 10, 9, () -> { long s = 0; for (int v : ll2) s += v; return s; });

        System.out.println("== 1,000,000 lookups, 100,000 String keys");
        Map<String, Integer> hm = new HashMap<>(), tm = new TreeMap<>();
        String[] keys = new String[N];
        for (int i = 0; i < N; i++) { keys[i] = "user-" + i; hm.put(keys[i], i); tm.put(keys[i], i); }
        String[] q = new String[1_000_000];
        for (int i = 0; i < q.length; i++) q[i] = keys[rnd.nextInt(N)];
        measure("HashMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += hm.get(k); return s; });
        measure("TreeMap.get", 5, 7, () -> { long s = 0; for (String k : q) s += tm.get(k); return s; });

        System.out.println("== push+pop 1,000,000 (stack use)");
        measure("Stack push/pop", 5, 7, () -> { Stack<Integer> st = new Stack<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });
        measure("ArrayDeque push/pop", 5, 7, () -> { ArrayDeque<Integer> st = new ArrayDeque<>(); for (int i = 0; i < 1_000_000; i++) st.push(i & 1023); long s = 0; while (!st.isEmpty()) s += st.pop(); return s; });

        System.out.println("== sum of 10,000,000 ints");
        int M = 10_000_000;
        int[] arr = new int[M];
        List<Integer> boxed = new ArrayList<>(M);
        for (int i = 0; i < M; i++) { arr[i] = i % 1000; boxed.add(i % 1000); }
        measure("int[] sum", 10, 9, () -> { long s = 0; for (int v : arr) s += v; return s; });
        measure("List<Integer> sum (0..999)", 10, 9, () -> { long s = 0; for (int v : boxed) s += v; return s; });
        List<Integer> boxedBig = new ArrayList<>(M);
        for (int i = 0; i < M; i++) boxedBig.add(i);
        measure("List<Integer> sum (distinct)", 10, 9, () -> { long s = 0; for (int v : boxedBig) s += v; return s; });
        System.out.println("sink=" + (sink != 0));
    }
}
(Los números de capacidad salieron de un programa aparte de 40 líneas que usa com.sun.management.ThreadMXBean; la idea de medición es la misma.)
Anterior: Curso 2: clases, records e interfaces · Siguiente: Curso 4: streams, lambdas y Optional
Preguntas frecuentes
¿LinkedList es más rápido que ArrayList en algún caso?
Solo para insertar o quitar en los extremos. Agregar 50,000 elementos al inicio tardó 117.9 ms con ArrayList.add(0, x) y 0.48 ms con LinkedList.addFirst, pero ArrayDeque.addFirst hizo lo mismo en 0.63 ms. Para get(i) aleatorio, LinkedList fue miles de veces más lento (454.8 ms contra 0.08 ms para 10,000 lecturas), y recorrerla fue unas dos veces más lento.
¿Por qué me sale ConcurrentModificationException al borrar de una lista dentro de un for-each?
El for-each usa un Iterator, y el iterador de ArrayList revisa un contador de modificaciones en cada next(). Llamar a list.remove() dentro del bucle cambia el contador, así que el siguiente next() lanza la excepción. Usa list.removeIf(predicado) o llama a iterator.remove() sobre un Iterator explícito.
¿Uso Stack o ArrayDeque para una pila en Java?
ArrayDeque. En nuestra prueba Stack no fue más lento con 1,000,000 de pares push/pop (unos 5 ms cada uno), así que la velocidad no es el motivo. Stack extiende Vector, por lo que expone get(i) y add(), y se imprime y recorre de abajo hacia arriba, mientras que ArrayDeque se recorre en el orden de pop.