Virtual threads en Java (JDK 26): límites medidos
100,000 tareas dormidas en virtual threads vs threads de plataforma (JDK 26): el límite de 4,096 threads, por qué la CPU no gana y el pinning tras JEP 491.
Serie: curso de Java 5/6 (avanzado). Para quien ya conoce ExecutorService y ha escuchado que los virtual threads "hacen que todo escale". Al terminar vas a poder predecir cuándo ayudan los virtual threads y cuándo no, reconocer los dos errores de compilación y el bug silencioso con los que todos tropiezan primero, y corregir una race condition de tres maneras.
Si mantienes un servicio en Java que pasa la mayor parte del tiempo esperando llamadas HTTP o a la base de datos, como el backend de pagos de una fintech o la API de un e-commerce que heredaste como freelancer, los virtual threads son el mayor cambio en la concurrencia de Java en dos décadas. Si tu código está ocupado calculando, no cambian nada, y nuestras mediciones muestran los dos casos. También revisamos qué queda del "pinning" en JDK 26, porque la mayoría de los artículos sobre el tema se escribieron para JDK 21 y ya están desactualizados.
Entorno: OpenJDK 26 (Temurin 26+35), Mac con Apple Silicon (M1 Pro, 8 núcleos, 16 GB), macOS. La memoria es el pico de resident set size que reporta /usr/bin/time -l; cada número es la mediana de 3 ejecuciones salvo que se indique lo contrario. Los tiempos totales incluyen el arranque de la JVM y el calentamiento del JIT, lo cual aquí está bien porque los efectos que medimos son de 10× o más.
10,000 y 100,000 tareas dormidas: dónde se detienen los threads de plataforma
La prueba es la clásica: lanzar N tareas que duermen un segundo cada una y esperar a que terminen todas. Dormir representa una llamada de red lenta. El mismo archivo ejecuta tres executors.
import java.time.Duration;
import java.util.concurrent.*;

/** Start N tasks that each sleep 1 s. Usage: java SleepTasks.java <virtual|platform|pool200> <N> */
public class SleepTasks {
    public static void main(String[] args) throws Exception {
        String mode = args[0];
        int n = Integer.parseInt(args[1]);
        ExecutorService ex = switch (mode) {
            case "virtual"  -> Executors.newVirtualThreadPerTaskExecutor();
            case "platform" -> Executors.newThreadPerTaskExecutor(Thread.ofPlatform().factory());
            case "pool200"  -> Executors.newFixedThreadPool(200);
            default -> throw new IllegalArgumentException(mode);
        };
        long t0 = System.nanoTime();
        try (ex) {                                    // close() waits for all tasks
            for (int i = 0; i < n; i++) {
                ex.submit(() -> { Thread.sleep(Duration.ofSeconds(1)); return null; });
            }
        }
        long ms = (System.nanoTime() - t0) / 1_000_000;
        Runtime rt = Runtime.getRuntime();
        long usedMb = (rt.totalMemory() - rt.freeMemory()) >> 20;
        System.out.printf("%-8s n=%,d  wall=%,d ms  heapUsed=%d MB%n", mode, n, ms, usedMb);
    }
}
| Executor | Tareas | Tiempo total | Pico de RSS |
|---|---|---|---|
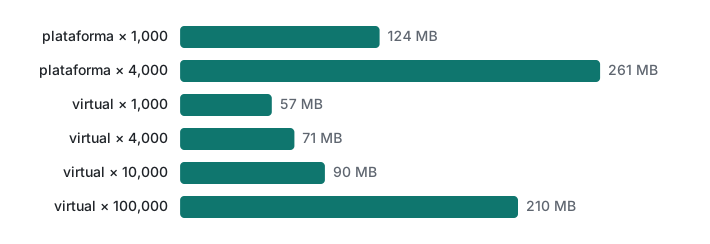
| un thread de plataforma por tarea | 1,000 | 1,078 ms | 124 MB |
| un thread de plataforma por tarea | 4,000 | 1,304 ms | 261 MB |
| un thread de plataforma por tarea | 10,000 | se cayó | – |
| un virtual thread por tarea | 1,000 | 1,024 ms | 57 MB |
| un virtual thread por tarea | 4,000 | 1,040 ms | 71 MB |
| un virtual thread por tarea | 10,000 | 1,068 ms | 90 MB |
| un virtual thread por tarea | 100,000 | 1,791 ms | 210 MB |
| pool fijo de 200 | 10,000 | 50,375 ms (1 ejecución) | 73 MB |
Resaltan tres cosas. Primero, 100,000 virtual threads usaron menos memoria que 4,000 threads de plataforma. Segundo, un pool fijo de 200 es la forma antigua de limitar la memoria, y se paga en tiempo: 10,000 tareas de un segundo en tandas de 200 son 50 rondas, y 50,375 ms es exactamente eso. No ejecutamos el pool con 100,000; la misma aritmética da unos 500 segundos. Tercero, los threads de plataforma no se volvieron lentos con 10,000. Se murieron:
[0.453s][warning][os,thread] Failed to start thread "Unknown thread" - pthread_create failed (EAGAIN) for attributes: stacksize: 2048k, guardsize: 16k, detached.
[0.453s][warning][os,thread] Failed to start the native thread for java.lang.Thread "Thread-4067"
Exception in thread "main" java.lang.OutOfMemoryError: unable to create native thread: possibly out of memory or process/resource limits reached
    at java.base/java.lang.Thread.start0(Native Method)
    at java.base/java.lang.Thread.start(Thread.java:1486)
    ...
    at SleepTasks.main(SleepTasks.java:18)
Dice OutOfMemoryError, pero el heap estaba lejísimos de llenarse. La pista es el thread 4,067: sysctl kern.num_taskthreads en esta Mac imprime 4096, el límite de threads por proceso en macOS. Súmale los threads propios de la JVM (GC, JIT, manejo de señales) y chocas con él justo por encima de 4,000 threads de usuario. En Linux el límite viene de ulimit -u, /proc/sys/kernel/threads-max y la configuración de cgroups del contenedor, así que el número cambia, pero el mensaje es el mismo. Cuando veas "unable to create native thread", revisa la cantidad de threads, no -Xmx.
Cómo se bloquea un virtual thread sin bloquear un núcleo
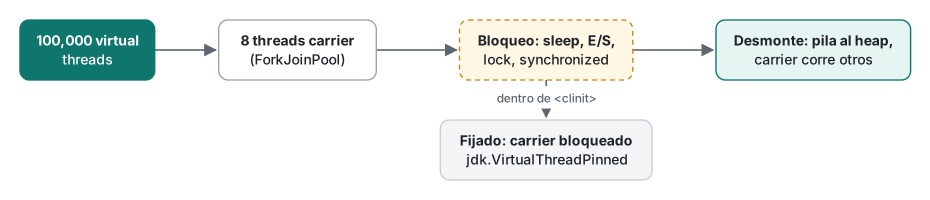
Un virtual thread es un objeto Java que planifica el JDK, no el sistema operativo. El JDK los ejecuta sobre un pequeño ForkJoinPool de threads carrier (portadores), por defecto uno por núcleo. Cuando un virtual thread llama a un método bloqueante que el JDK ya adaptó (sleep, E/S de sockets, ReentrantLock, BlockingQueue y, desde JDK 24, también los monitores), se desmonta: sus frames de pila se copian al heap y el carrier toma otro virtual thread. Por eso el uso del heap creció con la cantidad de tareas en la tabla de arriba (unos 122 MB de heap con 100,000 tareas) mientras el RSS se mantuvo pequeño.
Un caso limitado por CPU donde los virtual threads no ayudan
Si las tareas nunca se bloquean, no hay nada de qué desmontarse. 64 tareas que ejecutan cada una 200 millones de pasos de xorshift:
static long work(long seed) {                 // pure CPU: xorshift loop
    long x = seed;
    for (int i = 0; i < 200_000_000; i++) { x ^= x << 13; x ^= x >>> 7; x ^= x << 17; }
    return x;
}
// run(...) submits 64 tasks to the executor and sums the results;
// work(1) is called once first so the JIT has compiled it
| Executor (64 tareas) | Ronda 1 | Ronda 2 | Ronda 3 | Mediana |
|---|---|---|---|---|
| un solo thread | 25,362 ms | 25,622 ms | 25,024 ms | 25,362 ms |
| pool fijo de 8 | 4,385 ms | 4,530 ms | 4,332 ms | 4,385 ms |
| un virtual thread por tarea | 4,741 ms | 4,191 ms | 4,695 ms | 4,695 ms |
| un thread de plataforma por tarea | 3,992 ms | 4,161 ms | 3,920 ms | 3,992 ms |
Las tres versiones paralelas son unas 5.8× más rápidas que un solo thread, que es lo que pueden dar 8 núcleos (6 de rendimiento + 2 de eficiencia en la M1 Pro). Los virtual threads no son más rápidos, y la dispersión entre ejecuciones (4,191–4,741 ms) es mayor que cualquier diferencia entre executors. Para este tipo de trabajo usa un pool fijo o un stream paralelo dimensionado según los núcleos; además así evitas que las tareas pesadas en CPU dejen sin carriers a los virtual threads que hacen E/S.
Pinning en JDK 26: qué arregló la JEP 491 y qué queda
En JDK 21, un virtual thread que se bloqueaba dentro de synchronized quedaba fijado (pinned): no podía desmontarse, así que retenía su carrier durante toda la espera. La JEP 491 de JDK 24 eliminó eso para los monitores. Comprobamos qué hace JDK 26 con un solo carrier (-Djdk.virtualThreadScheduler.parallelism=1), de modo que cualquier pinning serializaría todo:
// Case 1: 100 tasks, each sleeps 100 ms while holding its own monitor
try (var ex = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int i = 0; i < 100; i++) {
        Object lock = new Object();
        ex.submit(() -> { synchronized (lock) { sleep(100); } });
    }
}
// Case 2: one task blocks 1 s inside a static initializer, 100 others sleep 10 ms
static class Slow { static { sleep(1000); } static void touch() {} }
$ java -Djdk.virtualThreadScheduler.parallelism=1 -cp out Pinning
synchronized + sleep : 115 ms
bystanders while <clinit> blocks: 960 ms
El caso 1 tardó 115 ms, no los 10 s que costaría el pinning (100 × 100 ms en un solo carrier). Los monitores ya no fijan. El caso 2 muestra lo que todavía fija: mientras un virtual thread duerme dentro de un inicializador de clase, los 100 que estaban al lado y solo necesitaban 10 ms cada uno esperaron 960 ms, porque el único carrier estaba atascado. Con los 8 carriers por defecto, esas mismas tareas terminaron en 11 ms, y por eso este tipo de pinning se esconde en producción hasta que el pool se satura.
La tarea pedía rastrear esto con -Djdk.tracePinnedThreads=full. En JDK 26 ese flag no hace nada: el programa imprimió las mismas dos líneas y ningún stack trace, y el string tracePinnedThreads no aparece en ninguna parte de la biblioteca de clases de JDK 26 (lo buscamos en lib/modules). Se eliminó junto con la JEP 491. Su reemplazo es el evento de JFR jdk.VirtualThreadPinned. Nuestra imagen del JDK no trae la herramienta de línea de comandos jfr, así que leímos la grabación con la API jdk.jfr.consumer en un programa de 10 líneas:
$ java -Djdk.virtualThreadScheduler.parallelism=1 -XX:StartFlightRecording=filename=pin.jfr,settings=profile -cp out Pinning
$ java Dump.java pin.jfr
jdk.VirtualThreadPinned {
  duration = 1.01 s
  blockingOperation = "LockSupport.park"
  pinnedReason = "VM call to Pinning$Slow.<clinit> on stack"
  carrierThread = "ForkJoinPool-1-worker-1" (javaThreadId = 33)
  eventThread = "" (javaThreadId = 134, virtual)
  ...
La grabación tenía exactamente un evento de pinning: el del inicializador de clase. Los 100 sleeps dentro de synchronized no produjeron ninguno. El campo pinnedReason nombra la causa, lo cual es más útil que el viejo volcado de stack trace.
Errores comunes: dos errores de compilación y un bug silencioso
El primer programa con virtual threads de casi todo el mundo se ve así:
int count = 0;
try (var ex = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int i = 0; i < 1_000; i++) {
        ex.submit(() -> { Thread.sleep(10); });   // mistake 1
        ex.submit(() -> count++);                  // mistake 2
    }
}
Mistakes.java:8: error: unreported exception InterruptedException; must be caught or declared to be thrown
                ex.submit(() -> { Thread.sleep(10); });   // mistake 1
                                              ^
Mistakes.java:9: error: local variables referenced from a lambda expression must be final or effectively final
                ex.submit(() -> count++);                  // mistake 2
                                ^
2 errors
Error 1 → qué pasa → solución. Una lambda de bloque que no devuelve nada coincide con submit(Runnable), y Runnable.run() no puede lanzar excepciones checked. Agrega return null; para que la lambda se vuelva un Callable, que sí puede lanzarlas. Por eso la lambda de SleepTasks de arriba termina con return null.
Error 2 → qué pasa → solución. Las lambdas capturan valores, no variables. El compilador te detiene, y es bueno, porque el parche obvio (un campo static int) compila y está mal. Lo vemos en la siguiente sección.
El silencioso. submit() guarda la excepción de una tarea en su Future. Si nunca llamas a get(), la excepción desaparece:
main finished, no stack trace above?
Exception in thread "" java.lang.IllegalStateException: boom2
    at Swallow.lambda$main$1(Swallow.java:9)
La primera tarea lanzó boom a través de submit() y no imprimió nada. La segunda, iniciada con Thread.ofVirtual().start(...), llegó al handler por defecto. Fíjate en el nombre de thread vacío "": los virtual threads no tienen nombre por defecto, así que ponles uno (Thread.ofVirtual().name("fetch-", 0)) si quieres logs legibles.
Una race condition, medida, y tres soluciones
1,000 virtual threads incrementan cada uno un contador compartido 10,000 veces. La respuesta correcta es 10,000,000.
static int plain;
static volatile int vol;
static final AtomicInteger atomic = new AtomicInteger();
static final LongAdder adder = new LongAdder();
static final ReentrantLock lock = new ReentrantLock();
static int locked;

run("int ++",        () -> plain++,           () -> plain);
run("volatile ++",   () -> vol++,             () -> vol);
run("AtomicInteger", atomic::incrementAndGet, atomic::get);
run("LongAdder",     adder::increment,        adder::sum);
run("ReentrantLock", () -> { lock.lock(); try { locked++; } finally { lock.unlock(); } }, () -> locked);
int ++         total=  7,627,061     16 ms
volatile ++    total=  1,282,858    342 ms
AtomicInteger  total= 10,000,000    667 ms
LongAdder      total= 10,000,000     25 ms
ReentrantLock  total= 10,000,000    341 ms
En tres ejecuciones, el int simple perdió entre 2.1 y 2.9 millones de actualizaciones. volatile perdió todavía más (terminó entre 1.3 y 2.6 millones): hace visible cada lectura y escritura, pero vol++ sigue siendo leer, sumar y escribir, y con cada escritura yendo a memoria los threads chocan más seguido. Las tres soluciones fueron exactas siempre. Los tiempos incluyen el calentamiento del JIT de cada lambda, así que léelos como un ranking y no como un benchmark: AtomicInteger estuvo entre 458 y 667 ms, ReentrantLock entre 341 y 371 ms, y LongAdder entre 21 y 26 ms porque reparte la cuenta en celdas y solo las suma en sum(). Para un contador muy usado que se lee poco, LongAdder es la herramienta correcta; cuando tienes que actualizar dos campos juntos, usa un lock.
Structured concurrency y scoped values en JDK 26
StructuredTaskScope trata un grupo de subtareas como una sola unidad: si una falla, las demás se cancelan, y el scope no puede terminar mientras una hija siga corriendo. En JDK 26 sigue siendo una API en preview:
$ javac Structured.java
Structured.java:2: error: StructuredTaskScope is a preview API and is disabled by default.
import java.util.concurrent.StructuredTaskScope;
                           ^
  (use --enable-preview to enable preview APIs)
try (var scope = StructuredTaskScope.open()) {        // default: all must succeed
    var user  = scope.fork(() -> fetch("user", 100, failUser));
    var order = scope.fork(() -> fetch("order", 2_000, false));
    scope.join();                                     // throws if any subtask failed
    System.out.println("  " + user.get() + " " + order.get());
}
$ javac --release 26 --enable-preview -Xlint:preview Structured.java
Structured.java:20: warning: [preview] StructuredTaskScope is a preview API and may be removed in a future release.
$ java --enable-preview Structured
  user@req-42 order@req-42
failUser=false -> 2,013 ms
  order cancelled after being interrupted
  caught FailedException: java.lang.IllegalStateException: user failed
failUser=true -> 108 ms
Cuando user falló a los 100 ms, la llamada order de 2 segundos se interrumpió y toda la petición respondió en 108 ms en lugar de esperar 2 s por un resultado que nadie iba a usar. req-42 viene de un ScopedValue asociado alrededor de la llamada, y las subtareas creadas con fork lo heredaron. ScopedValue en sí compiló sin ningún flag en 26; con javac --release 24 se rechaza como API en preview, y con --release 25 compila, así que pasó a ser definitiva en JDK 25. Como la API de scope está en preview, los nombres de sus métodos han cambiado entre versiones (la versión de JDK 21 usaba new StructuredTaskScope.ShutdownOnFailure()); el código escrito para 26 podría no compilar en 27.
Tabla de decisión
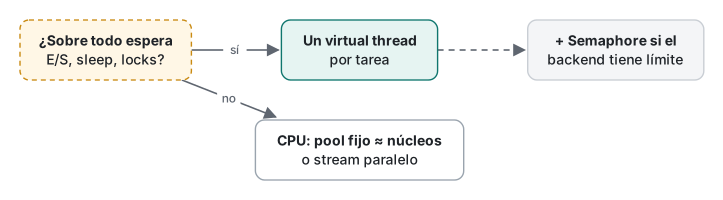
| Situación | Usa | Por qué |
|---|---|---|
| Miles de tareas esperando HTTP/BD | newVirtualThreadPerTaskExecutor() |
100,000 sleeps en 1.8 s, 210 MB |
| El backend solo admite N conexiones | virtual threads + Semaphore(N) |
no uses un pool como limitador de tasa |
| Cómputo limitado por CPU | pool fijo ≈ núcleos, o stream paralelo | los virtual threads no aceleraron nada |
| Contador compartido que se lee poco | LongAdder |
exacto y 21–26 ms contra 341+ ms |
| Varios campos que se actualizan juntos | ReentrantLock o synchronized |
los monitores ya no fijan desde JDK 24 |
| Fan-out que debe fallar rápido | StructuredTaskScope (preview en 26) |
108 ms en lugar de 2 s cuando falla |
| Contexto por petición | ScopedValue (definitivo desde 25) |
lo heredan las subtareas creadas con fork |
Objeto costoso por thread en ThreadLocal |
replantéalo con virtual threads | una copia por tarea, no por thread del pool |
Límites honestos y notas de versión
- Los virtual threads pasaron a ser definitivos en Java 21:
javac --release 20todavía rechazanewVirtualThreadPerTaskExecutor()como API en preview, y--release 21la acepta. Todo lo demás aquí se ejecutó solo en 26. - El cambio de pinning de JDK 24 se observó solo en 26; la cifra de "10 s en JDK 21" es lo que costaría el pinning por aritmética, no una ejecución.
- El techo de 4,096 threads es una configuración de macOS. Un servidor Linux fallará con otro número, y un contenedor puede fallar antes.
- El RSS incluye toda la JVM. La cifra de heap de
Runtimees una foto tomada después de que terminaron las tareas, no un pico. - Sin JMH. La prueba de CPU calentó
work()una vez; los tiempos de la race condition no tuvieron calentamiento, así que solo el ranking tiene sentido.
El próximo curso abre la propia JVM: calentamiento del JIT, recolectores de basura y fugas de memoria, medidos de la misma forma.
Anterior: Curso 4: streams, lambdas y Optional · Siguiente: Curso 6: JIT, GC y memoria
Relacionados: curso de Python 5: threads, procesos, asyncio y el GIL · VB.NET 5: Async/Await (en inglés)
Preguntas frecuentes
¿Los virtual threads hacen más rápido el código Java que usa mucha CPU?
No. 64 tareas limitadas por CPU tardaron 4,385 ms en un pool fijo de 8 threads y 4,695 ms con un virtual thread por tarea (mediana de 3 rondas, M1 Pro de 8 núcleos). Los virtual threads ayudan cuando las tareas esperan; para cómputo puro, el límite es la cantidad de núcleos.
¿synchronized sigue fijando (pinning) los virtual threads en JDK 26?
No en el bloqueo normal. Desde JDK 24 (JEP 491) un virtual thread que duerme dentro de synchronized se desmonta: 100 tareas que dormían 100 ms cada una dentro de su propio monitor terminaron en unos 115 ms con un solo carrier. Bloquearse dentro de un inicializador de clase todavía fija el carrier, y JFR lo registró como jdk.VirtualThreadPinned. La antigua propiedad -Djdk.tracePinnedThreads ya no existe en JDK 26.
¿La structured concurrency ya es definitiva en Java 26?
No. StructuredTaskScope sigue siendo una API en preview en JDK 26 y javac la rechaza sin --enable-preview. ScopedValue, en cambio, compila sin flags desde JDK 25; con --release 24 javac todavía la reporta como API en preview.