PHP 8.5: OPcache, JIT y profiling, todo medido
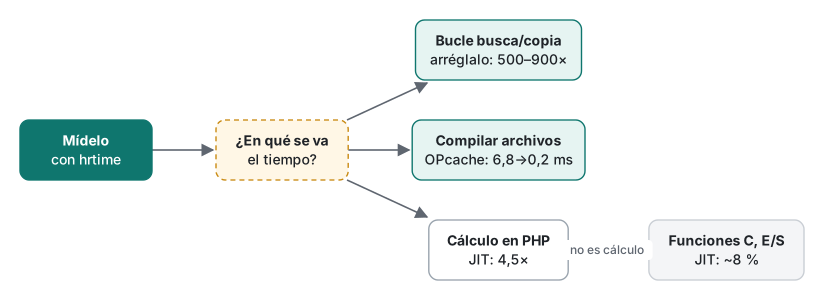
OPcache frenó la CLI pero aceleró 35× las peticiones al servidor; el JIT dio 4.5× en cálculo y 8 % con strings. Y una concatenación 900× más lenta.
Serie: curso de PHP 6/6 (avanzado). Esta clase es para quien ya tiene código PHP que funciona y ahora quiere saber en qué se va el tiempo y la memoria: el freelancer cuyo cliente se queja de que "el panel tarda", el desarrollador de una startup al que le toca optimizar el job nocturno que importa un CSV gigante, o quien se prepara para una entrevista técnica y quiere hablar de OPcache con datos y no con mitos. Al terminar vas a poder activar OPcache y el JIT donde ayudan (y saber dónde no), medir con hrtime sin instalar un profiler, leer los opcodes que PHP ejecuta de verdad y detectar el puñado de patrones en bucles que cuestan 100× más de lo que deberían.
Si una página o un proceso batch en PHP está "lento" y la primera sugerencia que escuchas es "activa el JIT", esta clase es para ti. En nuestras mediciones el JIT dio 4.5× en aritmética pura y un 8 % en trabajo web típico, mientras que reescribir una sola línea que armaba un string dio casi 900×. Cada número de abajo se midió en la máquina descrita a continuación; cuando una medición nos engañó (un benchmark que corrió sin OPcache porque el archivo era demasiado nuevo), la dejamos.
Entorno: PHP 8.5.6 CLI (NTS) con Zend OPcache, Mac con Apple Silicon (M1 Pro), macOS, memory_limit=128M. No hay xdebug, SPX, xhprof ni Blackfire instalados, y esta clase no instala nada: todos los tiempos usan hrtime(). Las medianas se dan con el número de ejecuciones. Las rutas en la salida se acortaron a ~/demo/.
Profiling sin extensiones: hrtime y comprobar qué estás midiendo
hrtime(true) devuelve un contador monotónico de nanosegundos como entero. A diferencia de microtime(true), nunca salta cuando se ajusta el reloj del sistema y no tiene redondeo de float. Este helper ejecutó todos los benchmarks dentro del proceso en esta clase:
<?php
// one warm-up call, then the median of 5 rounds
function bench(string $name, callable $fn, int $rounds = 5): void {
    $fn();                                            // warm-up round, discarded
    $t = [];
    for ($r = 0; $r < $rounds; $r++) { $s = hrtime(true); $res = $fn(); $t[] = (hrtime(true) - $s) / 1e6; }
    sort($t);
    printf("%-34s %8.2f ms   (%s)\n", $name, $t[intdiv($rounds, 2)], is_scalar($res) ? $res : count($res));
}
También imprime el resultado: si dos variantes devuelven valores distintos, estás comparando trabajos distintos. Un profiler de verdad (el profiler de xdebug, SPX, Blackfire) te muestra qué función es lenta sin que tengas que adivinar. Aquí no hay ninguno instalado, así que el método es: mide una petición completa y luego acota con hrtime alrededor de los sospechosos, como en una búsqueda binaria.
PHP también trae una forma de ver lo que realmente ejecuta. opcache.opt_debug_level vuelca los opcodes antes (0x10000) y después (0x20000) del optimizador:
function f(array $a): int {
    $n = 0;
    for ($i = 0; $i < count($a); $i++) $n += strlen("hello") * 2;
    return $n;
}
$ php -d opcache.enable_cli=1 -d opcache.opt_debug_level=0x20000 ops.php
f:
     ; (after optimizer)
0004 CV1($n) = ADD CV1($n) int(10)
0005 PRE_INC CV2($i)
0006 T4 = COUNT CV0($a)
0007 T3 = IS_SMALLER CV2($i) T4
0008 JMPNZ T3 0004
strlen("hello") * 2 ya se había convertido en la constante int(10) en el volcado anterior al optimizador: el compilador la pliega (constant folding). Un benchmark de "qué tan rápido es strlen" escrito así mide una suma. Y count() no es una llamada a función, sino un único opcode COUNT, lo que importa en la sección siguiente.
OPcache en la CLI vs en un servidor
OPcache guarda los opcodes compilados en memoria compartida para que la siguiente petición se salte el parseo y la compilación. En la CLI está apagado por defecto (opcache.enable_cli => Off), y es a propósito. Generamos un archivo de 437 KB con 2000 clases pequeñas y medimos 20 procesos php nuevos (después de una ejecución descartada) por configuración:
empty script                 median   56.1 ms
opcache.enable_cli=0         median   64.7 ms   last line: M1999-05998 loaded 2000 classes in 7.78 ms
opcache.enable_cli=1         median   75.7 ms   last line: M1999-05998 loaded 2000 classes in 17.49 ms
enable_cli=1 + file_cache    median   58.3 ms   last line: M1999-05998 loaded 2000 classes in 1.74 ms
Las otras dos series de 20 ejecuciones dieron 63.9/75.3/58.2 y 64.3/74.5/58.2 ms. Con enable_cli=1 la CLI se volvió más lenta: cada proceso ejecuta el optimizador, llena una caché y termina, así que nunca se reutiliza nada. opcache.file_cache=<dir> con opcache.file_cache_only=1 escribe el código compilado en disco, y los procesos siguientes cargaron las 2000 clases en 1.74 ms en lugar de 7.78 ms. Fíjate en el piso de 56 ms: arrancar este build de PHP, con 67 extensiones cargadas, cuesta más que todo nuestro script.
Un servidor es el caso opuesto. El servidor integrado es un único proceso de larga vida, y opcache.enable se aplica a él. 300 peticiones secuenciales con ext/curl, descartando la primera:
| Servidor integrado | Mediana | p95 | Tiempo de carga dentro del script |
|---|---|---|---|
opcache.enable=0 |
6.79 ms (6.95 en una 2.ª ejecución) | 7.43 ms | 6.31 ms |
opcache.enable=1 |
0.18 ms (0.20) | 0.26 ms | 0.01 ms |
opcache_get_status() después: hits=1198 misses=3 cached_scripts=3. Unas 35× por petición, casi todo tiempo de compilación. PHP-FPM y el mod_php de Apache se comportan como la segunda fila, y por eso OPcache simplemente debe estar encendido en producción.
El JIT: un benchmark limitado por CPU
Desde PHP 8.0, OPcache incluye un compilador JIT que convierte los opcodes más usados en código máquina. En 8.5 está apagado por defecto (opcache.jit => disable, opcache.jit_buffer_size => 64M). La prueba es un Mandelbrot de 600×600 con un máximo de 200 iteraciones por píxel: aritmética de punto flotante pura en bucles de PHP.
<?php
// mandel.php — CPU-bound: 600x600 Mandelbrot, 200 iterations max. Prints a checksum.
declare(strict_types=1);
function mandel(int $w, int $h, int $maxIter): int {
    $inside = 0;
    for ($y = 0; $y < $h; $y++) {
        $ci = 2.0 * $y / $h - 1.0;
        for ($x = 0; $x < $w; $x++) {
            $cr = 3.0 * $x / $w - 2.0;
            $zr = 0.0; $zi = 0.0; $i = 0;
            while ($i < $maxIter && $zr * $zr + $zi * $zi < 4.0) {
                $t = $zr * $zr - $zi * $zi + $cr;
                $zi = 2.0 * $zr * $zi + $ci;
                $zr = $t;
                $i++;
            }
            if ($i === $maxIter) $inside++;
        }
    }
    return $inside;
}
$t = hrtime(true);
$r = mandel(600, 600, 200);
printf("mandel %d  %.1f ms\n", $r, (hrtime(true) - $t) / 1e6);
Cinco procesos nuevos por configuración, cronómetro dentro del script; todas las ejecuciones imprimieron el mismo checksum 91677:
| Flags | Mediana | Mín–máx |
|---|---|---|
opcache.enable_cli=0 |
524.7 ms | 524.4–525.5 |
enable_cli=1, jit=disable |
334.4 ms | 333.6–338.7 |
jit=tracing, jit_buffer_size=0 |
333.2 ms | 332.8–333.8 |
jit=tracing, buffer 64M |
75.0 ms | 74.6–76.4 |
jit=function, buffer 64M |
74.1 ms | 73.9–74.9 |
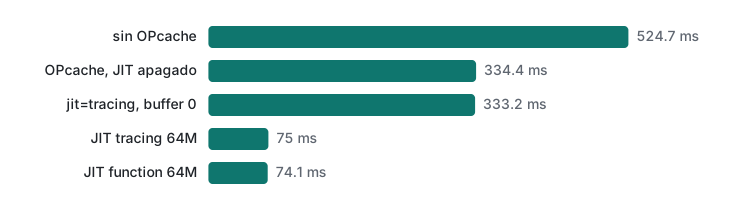
Tres hallazgos. OPcache solo ya hizo el bucle 1.6× más rápido, porque su optimizador infiere tipos y usa opcodes especializados. El JIT sumó otras 4.5×. Y jit=tracing con un buffer de cero no hizo nada, en silencio. opcache_get_status(false)['jit'] te dice la verdad:
-d opcache.jit=tracing                              → opcache_get_status: false
-d opcache.enable_cli=1 -d opcache.jit=tracing      → jit enabled=true on=true kind=5 buffer=67108848
... -d opcache.jit_buffer_size=0                    → jit enabled=false on=false kind=5 buffer=0
-d opcache.enable_cli=1 -d opcache.jit=bogus
PHP Warning:  Invalid "opcache.jit" setting. Should be "disable", "on", "off", "tracing", "function" or 4-digit number in Unknown on line 0
Sin enable_cli=1, la configuración del JIT no tiene ningún efecto en la CLI, y solo un typo produce un warning. El JIT tracing y el function empataron con esta única función caliente; tracing suele ganar cuando las rutas calientes atraviesan varias funciones.
El JIT con trabajo de strings y arrays
La mayor parte del tiempo de PHP se va en armar arrays, llamar a json_encode, ordenar y usar funciones de strings, y todo eso corre como código C dentro de PHP, con o sin JIT:
<?php
// strwork.php — "web-ish" work: build rows, json_encode, explode, str_replace, sort.
declare(strict_types=1);
mt_srand(42);
$t = hrtime(true);
$total = 0;
for ($round = 0; $round < 40; $round++) {
    $rows = [];
    for ($i = 0; $i < 5000; $i++) {
        $rows[] = ['id' => $i, 'name' => 'user_' . mt_rand(1, 99999), 'tags' => 'a,b,c,' . ($i % 7)];
    }
    $json = json_encode($rows);
    $back = json_decode($json, true);
    usort($back, fn($a, $b) => strcmp($a['name'], $b['name']));
    foreach ($back as $r) {
        $total += count(explode(',', $r['tags'])) + strlen(str_replace('user_', 'u:', $r['name']));
    }
}
printf("strwork %d  %.1f ms\n", $total, (hrtime(true) - $t) / 1e6);
| Flags | Mediana de 5 | Mín–máx |
|---|---|---|
| sin OPcache | 261.5 ms | 254.1–267.6 |
| OPcache, JIT apagado | 261.2 ms | 260.2–267.5 |
| JIT tracing | 240.2 ms | 234.9–245.0 |
| JIT function | 244.7 ms | 241.0–258.0 |
Cerca de un 8 %, y los rangos mín–máx casi se tocan. Una página típica que consulta una base de datos y renderiza una plantilla va a ver menos, porque esperar E/S no se acelera en absoluto. Vale la pena activar el JIT para procesamiento de imágenes, cálculo matemático o parsers escritos en PHP; para una app CRUD, OPcache es la ganancia y el JIT es ruido.
Memoria: arrays vs generadores con 1 millón de elementos
memory_get_peak_usage() después de sumar un millón de enteros, cada modo en un proceso nuevo, medido respecto del uso antes del bucle:
function numbers(int $n): Generator { for ($i = 0; $i < $n; $i++) yield $i; }
// 'array': $a = range(0, $n - 1); foreach ($a as $v) $sum += $v;
// 'gen':   foreach (numbers($n) as $v) $sum += $v;
| 1,000,000 de elementos | Aumento del pico | Tiempo |
|---|---|---|
array de ints con range() |
16.0 MB | 7 ms |
generador (yield) |
0.0 MB | 22 ms |
claves string ["k$i" => $i] |
76.0 MB | 66 ms |
strings ["row-$i", …] |
54.2 MB | 45 ms |
filas [['id' => $i, 'v' => …], …] |
Fatal con 128M; 374.6 MB con 1G | 185 ms |
Un array empaquetado de enteros cuesta 16 bytes por elemento; un generador guarda un solo valor a la vez pero aquí fue 3× más lento, porque cada yield reanuda una función. Las claves string agregan una tabla hash y un string por clave. El caso de una fila por array es lo que construye una consulta de "traer todas las filas", y con el límite por defecto murió:
PHP Fatal error: Allowed memory size of 134217728 bytes exhausted (tried to allocate 20480 bytes) in ~/demo/mem.php on line 13
Los generadores son la herramienta para procesar entradas grandes como flujo (un CSV, un cursor sobre PDOStatement::fetch()), donde convierten "sin memoria" en "memoria constante". Para arrays pequeños que ya entran en memoria, un array es más rápido.
Patrones lentos comunes, medidos
slow.php ejecutó cada patrón con el helper bench(), mediana de 5 después de un calentamiento, primero sin OPcache (el valor por defecto de la CLI) y luego con OPcache y el JIT tracing:
| Patrón | Sin OPcache | OPcache + JIT |
|---|---|---|
for con count($data) en la condición, 1M |
7.55 ms | 1.13 ms |
count() sacado a una variable |
6.54 ms | 1.02 ms |
foreach |
5.24 ms | 1.89 ms |
$s .= $piece, 200k piezas |
8.96 ms | 8.33 ms |
$s = $s . $piece, 200k piezas |
7961 ms | 7619 ms |
$s = $piece . $s, 20k piezas |
66.70 ms | 95.60 ms |
implode() de un array, 200k |
9.85 ms | 9.96 ms |
in_array 10k agujas en 10k strings |
232.51 ms | 224.93 ms |
array_flip una vez + isset 10k veces |
0.37 ms | 0.26 ms |
in_array, una sola búsqueda |
0.04 ms | 0.04 ms |
array_flip + isset, una sola búsqueda |
0.08 ms | 0.09 ms |
$all = array_merge($all, $chunk), 2k × 50 |
227.13 ms | 224.18 ms |
array_push($all, ...$chunk) |
1.06 ms | 1.10 ms |
juntar los chunks, un solo array_merge(...$parts) |
0.46 ms | 0.46 ms |
count() en la condición del bucle es el consejo de rendimiento más repetido y el menos importante aquí: 1 ms en un millón de iteraciones, porque count() es un opcode O(1) (el volcado de arriba). Sácalo a una variable por legibilidad si quieres. Con el JIT, foreach fue el más lento de los tres, un recordatorio de que el folclore de PHP 5 no sobrevive a una medición.
La concatenación de strings es donde está la trampa de verdad.
Error típico: $s = $s . $x en un bucle
El error: escribir la forma larga de agregar al final, a menudo cuando la línea también hace otra cosa, como $html = $html . render($row);.
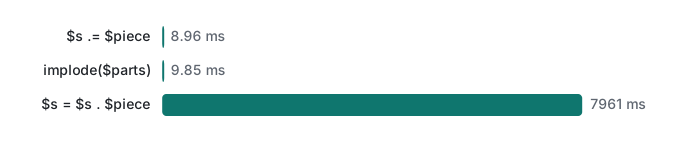
Lo que pasa en realidad: cada iteración crea un string nuevo y copia todo lo construido hasta ese momento. 200,000 piezas tardaron 7961 ms en lugar de 8.96 ms, casi 900×, y crece con el cuadrado del tamaño:
n= 25000  s=s.x     91.6 ms   s.=x  1.00 ms
n= 50000  s=s.x    296.6 ms   s.=x  2.06 ms
n=100000  s=s.x   1141.0 ms   s.=x  4.10 ms
Duplicar n lo hizo 3.2–3.8× más lento; .= creció de forma lineal, porque PHP puede extender el string en su lugar cuando tiene la única referencia. Anteponer ($s = $piece . $s) también es cuadrático. El JIT no ayudó (7619 ms).
La solución: .=, o juntar las piezas en un array y llamar a implode() una vez. Ambas tardaron unos 9 ms.
in_array vs isset sobre un array invertido. in_array recorre el array, así que 10,000 búsquedas en 10,000 elementos son 100 millones de comparaciones en el peor caso: 232 ms. Invertirlo una vez convierte los valores en claves de una tabla hash, y cada isset es una sola búsqueda hash: 0.37 ms, 628× más rápido. Pero para una única búsqueda, invertir cuesta más de lo que ahorra (0.08 contra 0.04 ms). Invierte cuando vas a buscar muchas veces en el mismo array.
array_merge en un bucle copia el array creciente cada vez, con la misma forma cuadrática: 227 ms contra 0.46 ms si juntas los chunks y fusionas una sola vez.
Microbenchmarks que engañan (uno nos engañó a nosotros)
Para mostrar el calentamiento del JIT escribimos un archivo pequeño que llama seis veces a mandel(150, 150, 200), lo creamos y lo ejecutamos de inmediato con opcache.jit=tracing:
call 1: 33.38 ms
call 2: 32.96 ms
...
call 6: 33.82 ms
Idéntico a tener el JIT apagado. El buffer del JIT había crecido apenas 1 KB. La causa era opcache.file_update_protection => 2: OPcache se niega a cachear un archivo modificado en los últimos 2 segundos (para no cachear un archivo escrito a medias), y sin caché no hay JIT. Dos segundos después, el mismo comando:
call 1: 5.16 ms
call 2: 4.72 ms
call 6: 4.70 ms
Un script de benchmark generado y ejecutado al instante, o editado y vuelto a ejecutar dentro de los 2 segundos, mide PHP sin OPcache. Otras trampas de esta clase:
- Los valores por defecto de la CLI no son producción. Sin OPcache el bucle con
count()tardó 7.55 ms; con OPcache, 1.13 ms. Mide con la misma configuración de OPcache que tu servidor. - Constant folding.
strlen("hello")dentro de un bucle se compila a10. Alimenta los benchmarks con valores que el compilador no pueda conocer. - Demasiado pequeño para importar. 0.04 contra 0.08 ms para una búsqueda es real pero irrelevante; el caso de 232 contra 0.37 ms es el que importa.
- El arranque del proceso domina. El script vacío tardó 56 ms; una optimización de 5 ms en una herramienta de CLI es invisible al lado de eso.
- Ruido.
strworkvarió entre 254 y 268 ms en ejecuciones idénticas; las diferencias de menos de un 5 % necesitan muchas más ejecuciones.
Tabla de decisión
| Situación | Haz esto | Evidencia |
|---|---|---|
| Cualquier servidor web (FPM, mod_php, LiteSpeed) | opcache.enable=1 |
6.79 → 0.18 ms por petición |
| Scripts de CLI de una sola ejecución, cron | deja enable_cli=0, o agrega opcache.file_cache |
64.7 vs 75.7 vs 58.3 ms |
| Aritmética pura en bucles de PHP | opcache.jit=tracing (buffer > 0) |
334 → 75 ms |
| JSON, strings, arrays, base de datos | sáltate el JIT, corrige los algoritmos | 261 → 240 ms |
| Armar strings | .= o implode |
8.96 ms vs 7961 ms |
| Muchas pruebas de pertenencia | array_flip una vez, luego isset |
232 → 0.37 ms |
| Entradas grandes | generadores | 0 MB vs un error fatal |
| ¿Está encendido el JIT? | revisa opcache_get_status()['jit']['on'] |
el buffer 0 lo desactivó en silencio |
Límites honestos y notas de versión
- Medido solo en PHP 8.5.6, en una única máquina con Apple Silicon. Las ganancias del JIT en servidores Linux x86-64 van a ser distintas. No ejecutamos versiones anteriores. Según los changelogs de PHP: el JIT se agregó en 8.0; en 8.4 los valores por defecto cambiaron a
opcache.jit=disableconjit_buffer_size=64M(antes erajit=tracingcon un buffer de 0, que también significaba apagado). - No usamos ninguna extensión de profiling. xdebug, SPX, xhprof y Blackfire mostrarían el costo por función;
hrtimesolo puede medir lo que envuelves. En un hosting compartido muchas veces tampoco puedes instalarlas, y por eso vale la pena conocer este método. - La prueba de servidor usó el servidor integrado de PHP, de un solo hilo, con peticiones secuenciales, no carga concurrente. Muestra el costo de compilación que elimina OPcache, no el throughput.
memory_get_peak_usage()solo cuenta el allocator propio de PHP. La memoria que toman las bibliotecas (argon2 en la clase 5, bibliotecas de imágenes, el motor de SQLite) no aparece ahí.
Ejercicio
1. Esta función devuelve los IDs de los usuarios activos. Con 30,000 usuarios y 10,000 direcciones activas tardó 1213 ms en nuestra prueba. Sin cambiar su salida, hazla rápida, y explica cómo demostrarías que el resultado es el mismo.
function activeIds(array $users, array $activeEmails): array {
    $out = [];
    foreach ($users as $u) {
        if (in_array($u['email'], $activeEmails, true)) $out = array_merge($out, [$u['id']]);
    }
    return $out;
}
Respuestas
Hay dos patrones cuadráticos: in_array dentro del bucle, y array_merge, que copia $out en cada coincidencia.
function activeIds(array $users, array $activeEmails): array {
    $active = array_flip($activeEmails);      // once: values become keys
    $out = [];
    foreach ($users as $u) {
        if (isset($active[$u['email']])) $out[] = $u['id'];
    }
    return $out;
}
Una diferencia que hay que revisar: in_array(..., true) compara de forma estricta, mientras que las claves de array convierten strings numéricos como "123" en enteros. Con direcciones de email eso no puede pasar. Para demostrar la igualdad, ejecuta ambas versiones sobre la misma entrada con semilla fija (mt_srand(42)) y compara con ===. Nuestra ejecución: slow 1212.8 ms, fast 2.49 ms, 4625 ids, identical: true, unas 490× más rápido.
Esta es la última clase de PHP. La clase 5 cubrió el lado de seguridad del mismo código.
Lo que sigue
- Anterior: curso de PHP 5/6: XSS, CSRF y sesiones
- Volver al inicio: curso de PHP 1/6: tipos, strings y arrays
- Relacionados: Python 6: profiling y optimización · Java 6: JIT, GC y memoria · por qué las prepared statements cambiaron los tipos numéricos de nuestro JSON (en inglés)
Preguntas frecuentes
¿Activar OPcache en la CLI de PHP hace más rápidos los scripts?
No para scripts que se ejecutan una sola vez. Con opcache.enable_cli=1, nuestro script que carga 2000 clases tardó 74.5–75.7 ms por ejecución en lugar de 63.9–64.7 ms (tres series de 20 ejecuciones), porque la caché se construye y se tira en cada proceso. Agregar opcache.file_cache lo bajó a 58.2 ms. En el servidor integrado, que es un único proceso de larga vida, OPcache bajó una petición de 6.79 ms a 0.18 ms.
¿Cuánto más rápido es PHP 8.5 con el JIT?
Depende del trabajo. Un Mandelbrot limitado por CPU pasó de 334.4 ms (OPcache, JIT apagado) a 75.0 ms con opcache.jit=tracing, unas 4.5×. Una carga de json_encode, usort, explode y str_replace pasó de 261.2 ms a 240.2 ms, cerca de un 8 %, porque el tiempo se gasta dentro de funciones escritas en C.
¿$s = $s . $x es más lento que $s .= $x en PHP?
Sí, muchísimo dentro de un bucle. Armar un string de 2.3 MB a partir de 200,000 piezas tardó 8.96 ms con .= y 7961 ms con $s = $s . $x en PHP 8.5, porque la segunda forma copia el string completo cada vez. El JIT no lo arregló.