Caracteres, code points y bytes UTF-8 vistos con xxd
Por qué len('año') da 3 pero el archivo pesa 4 bytes: code points y bytes UTF-8 en xxd, len de Python frente a strlen de PHP y mediciones reales de tamaño.
Serie: curso de texto y codificación 1/6 (principiante). Para quien ya vio "año" en una página o "caracteres raros" al abrir un CSV, y quiere entender qué es realmente un carácter. Al terminar vas a poder leer bytes UTF-8 en un volcado hexadecimal, predecir cuántos bytes ocupa un texto y saber qué "longitud" devuelve cada función.
Este curso es para quien trabaja con texto de usuarios en español: nombres con ñ, direcciones con tildes, comentarios que empiezan con "¿" o "¡". Tres sorpresas se repiten: len("año") da 3 pero la base de datos dice 4 bytes, un sistema viejo en Windows-1252 guarda la ñ en un byte y el nuevo en dos, y strtoupper deja la ñ en minúscula. Las tres vienen de un solo hecho: un carácter, un code point y un byte son tres cosas distintas, y cada herramienta cuenta una diferente. Todas las salidas de abajo se obtuvieron ejecutando el código en una Mac con Apple Silicon (M1 Pro) con Python 3.9.6, PHP 8.5.6 y el xxd que trae macOS.
Carácter, code point y byte son tres cosas distintas
Antes de tocar código, pongámosle nombre a las tres capas.
- Un carácter es lo que ve una persona:
ñ,é,¿,👍. (En la lección 5 verás que hasta esto es difuso: 👨👩👧 parece un solo carácter pero son cinco code points.) - Un code point (punto de código) es el número que Unicode le asigna a un carácter. Se escribe
U+más hexadecimal:ñes U+00F1,¿es U+00BF,€es U+20AC,👍es U+1F44D. Van de U+0000 a U+10FFFF. - Un byte es lo que realmente guarda un archivo, una conexión o una columna de base de datos. Una codificación es la regla que convierte code points en bytes. UTF-8 es una de esas reglas; Latin-1 (ISO-8859-1), Windows-1252 y UTF-16 son otras.
Un str de Python es una secuencia de code points; en el disco o en la red hay bytes. Pasar de str a bytes es codificar (encode) y de bytes a str es decodificar (decode). Casi todos los errores de codificación, incluidos los "ñ" de la lección 2, son un decode hecho con la regla equivocada.
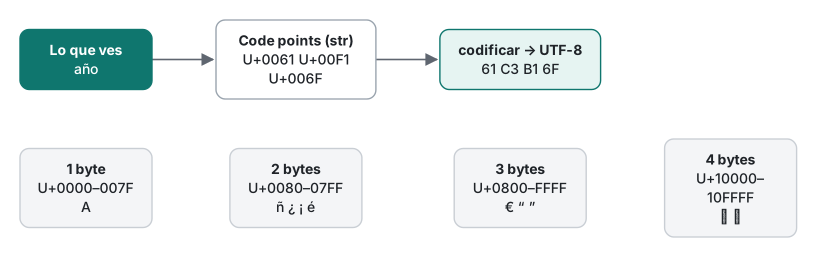
Tus primeros cinco minutos: mira los bytes con xxd
xxd muestra los bytes crudos de lo que le pases por una tubería. printf '%s' evita el salto de línea que agregaría echo:
for s in A ñ ¿ € 👍; do printf '%s' "$s" | xxd; done
00000000: 41                                       A
00000000: c3b1                                     ..
00000000: c2bf                                     ..
00000000: e282 ac                                  ...
00000000: f09f 918d                                ....
A es un byte, 0x41, el mismo valor que tiene en ASCII desde los años sesenta. ñ y ¿ ocupan dos bytes cada uno, € tres y el emoji cuatro. Los puntos de la derecha son xxd diciendo que esos bytes no son ASCII imprimible.
Lo mismo desde Python, que puede mostrar code points y bytes lado a lado:
import unicodedata
for s in ["hola", "año", "¿Qué?", "¡Olé!", "canción", "Ñandú", "€20", "👍"]:
    b = s.encode("utf-8")
    print(f"{s!r:10} len={len(s):2}  bytes={len(b):2}  {b.hex(' ')}")
for ch in "Añ¿¡é€👍":
    print(f"{ch} U+{ord(ch):04X} {unicodedata.name(ch)} -> {ch.encode().hex(' ')}")
'hola'     len= 4  bytes= 4  68 6f 6c 61
'año'      len= 3  bytes= 4  61 c3 b1 6f
'¿Qué?'    len= 5  bytes= 7  c2 bf 51 75 c3 a9 3f
'¡Olé!'    len= 5  bytes= 7  c2 a1 4f 6c c3 a9 21
'canción'  len= 7  bytes= 8  63 61 6e 63 69 c3 b3 6e
'Ñandú'    len= 5  bytes= 7  c3 91 61 6e 64 c3 ba
'€20'      len= 3  bytes= 5  e2 82 ac 32 30
'👍'        len= 1  bytes= 4  f0 9f 91 8d
A U+0041 LATIN CAPITAL LETTER A -> 41
ñ U+00F1 LATIN SMALL LETTER N WITH TILDE -> c3 b1
¿ U+00BF INVERTED QUESTION MARK -> c2 bf
¡ U+00A1 INVERTED EXCLAMATION MARK -> c2 a1
é U+00E9 LATIN SMALL LETTER E WITH ACUTE -> c3 a9
€ U+20AC EURO SIGN -> e2 82 ac
👍 U+1F44D THUMBS UP SIGN -> f0 9f 91 8d
Fíjate en dos patrones. Todas las letras del español fuera de ASCII (á é í ó ú ü ñ, sus mayúsculas, ¿ y ¡) están entre U+0080 y U+00FF y ocupan dos bytes que empiezan con c2 o c3. Ese c3 es justo el byte que se convierte en la famosa à cuando alguien lee UTF-8 como Windows-1252; lo verás en la lección 2.
Cómo reparte UTF-8 los bits, de 1 a 4 bytes
UTF-8 usa los bits altos del primer byte para decir cuánto mide la secuencia y marca cada byte siguiente con 10:
| Rango de code points | Bytes | Patrón de bits | Ejemplos |
|---|---|---|---|
| U+0000–U+007F | 1 | 0xxxxxxx |
A 41, ? 3F |
| U+0080–U+07FF | 2 | 110xxxxx 10xxxxxx |
ñ C3 B1, ¿ C2 BF, ú C3 BA |
| U+0800–U+FFFF | 3 | 1110xxxx 10xxxxxx 10xxxxxx |
€ E2 82 AC, “ E2 80 9C |
| U+10000–U+10FFFF | 4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
👍 F0 9F 91 8D |
Desarmemos la ñ. Su code point U+00F1 es 11110001 en binario, ocho bits, demasiados para los siete de un byte. Entonces va al patrón de 2 bytes, rellenado a 11 bits como 00011 110001:
ñ U+00F1 = 11110001 utf-8: 11000011 10110001 (C3 B1)
Eso es todo el formato. Para comprobarlo, aquí tienes un decodificador de 10 líneas que solo usa la tabla:
import sys

def decode_one(b):
    x = b[0]
    if x < 0x80: return x, 1
    if x >> 5 == 0b110:  return ((x & 0x1F) << 6) | (b[1] & 0x3F), 2
    if x >> 4 == 0b1110: return ((x & 0x0F) << 12) | ((b[1] & 0x3F) << 6) | (b[2] & 0x3F), 3
    if x >> 3 == 0b11110:
        return ((x & 0x07) << 18) | ((b[1] & 0x3F) << 12) | ((b[2] & 0x3F) << 6) | (b[3] & 0x3F), 4
    raise ValueError(f"not a lead byte: {x:#04x}")

data, i, out = sys.argv[1].encode(), 0, []
while i < len(data):
    cp, n = decode_one(data[i:]); out.append(f"U+{cp:04X}"); i += n
print(out)
$ python3 dec.py "año ¿¡"
['U+0061', 'U+00F1', 'U+006F', 'U+0020', 'U+00BF', 'U+00A1']
Gracias a la marca 10xxxxxx, desde cualquier byte puedes encontrar el inicio de su carácter retrocediendo sobre los bytes de continuación. Eso se llama autosincronización: un byte dañado arruina un carácter, no el resto del archivo.
¿Qué "longitud"? len() de Python frente a strlen y mb_strlen de PHP
En Python 3, len() sobre un str cuenta code points; sobre bytes, cuenta bytes. Los strings de PHP son bytes, así que strlen cuenta bytes y las funciones mb_ cuentan code points:
<?php
foreach (["año", "¿Qué?", "canción", "Ñandú"] as $s) {
    printf("%s strlen=%d mb_strlen=%d\n", $s, strlen($s), mb_strlen($s));
}
echo strtoupper("año ñandú"), " | ", mb_strtoupper("año ñandú"), "\n";
año strlen=4 mb_strlen=3
¿Qué? strlen=7 mb_strlen=5
canción strlen=8 mb_strlen=7
Ñandú strlen=7 mb_strlen=5
AñO ñANDú | AÑO ÑANDÚ
La última línea es una trampa clásica en formularios en español: strtoupper solo conoce ASCII y deja la ñ y la ú en minúscula. mb_strtoupper las convierte bien.
Hasta la terminal tiene dos respuestas. wc -c cuenta bytes; wc -m cuenta caracteres según tu locale:
$ printf 'año\n' > es.txt
$ wc -c es.txt            →  5 es.txt
$ wc -m es.txt            →  4 es.txt   (LANG=C.UTF-8)
$ LANG=C wc -m es.txt     →  5 es.txt
El mismo archivo, dos "cantidades de caracteres". La regla para toda la serie:
| Necesitas… | Python | PHP | Terminal |
|---|---|---|---|
| bytes para guardar, enviar o límites de columna | len(s.encode("utf-8")) |
strlen($s) |
wc -c |
| code points | len(s) |
mb_strlen($s) |
wc -m (locale UTF-8) |
| lo que el usuario llama "caracteres" | ver la lección 5 | grapheme_strlen($s) |
— |
Error común: cortar bytes en medio de un carácter
Error. Recortas un nombre a "10 caracteres" con una función de bytes, o lees un buffer de red en bloques de tamaño fijo y decodificas cada bloque por separado.
Lo que pasa en realidad. El corte cae dentro de una secuencia multibyte. substr("año", 0, 2) en PHP devuelve los bytes 61 c3: una a y media ñ, que el navegador muestra como a�. Python falla en voz alta, y con errors="replace" falla en silencio:
b = "año".encode()[:2]
try:
    b.decode()
except UnicodeDecodeError as e:
    print(repr(b), e, "| replace:", repr(b.decode("utf-8", "replace")))
b'a\xc3' 'utf-8' codec can't decode byte 0xc3 in position 1: unexpected end of data | replace: 'a�'
Solución. Corta con funciones que entienden code points (s[:10] en Python, mb_substr en PHP; mb_substr("año", 0, 2) devolvió añ). Si lees bytes por bloques, usa un decodificador incremental que guarde el carácter a medias para el bloque siguiente; la lección 6 muestra ese bug y su arreglo con cortes reales. Si programas en C, el curso de strings y structs en C (en inglés) cubre el lado del terminador NUL.
ASCII es un subconjunto de UTF-8, y por qué ganó UTF-8
Cada byte ASCII significa lo mismo en UTF-8, y ningún byte de un carácter multibyte es menor que 0x80. Así que un archivo solo ASCII ya es UTF-8 válido, y además es idéntico en casi todas las codificaciones antiguas:
t = "Hello, World 123"
print(t.encode("ascii") == t.encode("utf-8"))                     # True
print(t.encode("ascii") == t.encode("latin-1") == t.encode("cp1252"))  # True
print(t.encode("utf-16-le")[:8].hex(" "))                          # 48 00 65 00 6c 00 6c 00
UTF-16 no es compatible con ASCII: cada letra lleva un byte 00 al lado, que las funciones de C leen como "fin del string". De ahí salen las razones por las que UTF-8 es hoy el estándar de la web, Linux, Git y JSON:
- Las herramientas viejas pensadas para ASCII siguen funcionando. Ningún
00ni/(2F) aparece dentro de un carácter no ASCII."año 👍"en UTF-8 no tiene ningún00; en UTF-16 sí. - No hay orden de bytes. UTF-16 necesita un BOM o una etiqueta para distinguir
FF FEdeFE FF("Hi".encode("utf-16")diob'\xff\xfeH\x00i\x00'). - Autosincronización, como vimos arriba.
- El orden de bytes es el orden de code points. Ordenar 10,000 strings aleatorios (seed 42) por sus bytes UTF-8 dio exactamente el mismo orden que ordenar los
str.
¿Y el tamaño? Medí una oración corta por idioma y una página real de este sitio en cada idioma:
| Texto | Code points | UTF-8 | UTF-16 | Antigua |
|---|---|---|---|---|
Oración en español con ñ ¿ ¡ |
91 | 104 | 182 | 91 (cp1252) |
Oración en inglés con ’ “ ” é ï |
95 | 103 | 190 | 95 (cp1252) |
| Oración en japonés | 59 | 153 | 118 | 106 (cp932) |
| Oración en coreano | 64 | 146 | 128 | 105 (cp949) |
Para el español, UTF-8 cuesta muy poco: unos 14% más bytes que Windows-1252 en esta oración, porque solo las letras acentuadas, la ñ y los signos de apertura ocupan dos bytes. A cambio, puedes guardar €, comillas tipográficas, emoji y cualquier idioma en el mismo archivo.

Una página de curso de este sitio en español ocupó 33,032 bytes en UTF-8 y 65,468 en UTF-16; solo el 0.8% de sus caracteres no era ASCII. Incluso la versión en japonés fue más pequeña en UTF-8 (39,229 frente a 54,842 bytes), porque el HTML es ASCII. Según las encuestas de W3Techs, más del 98% de los sitios web usan UTF-8 (es su cifra; no la medimos aquí).
Límites honestos y notas de versión
unicodedatade Python 3.9.6 usa Unicode 13.0; con emoji muy recientesunicodedata.namepuede lanzarValueError: no such name. Los bytes UTF-8 no dependen de la versión de Unicode.- PHP 8.5.6 con mbstring;
mb_internal_encoding()devolvióUTF-8. Si unphp.iniantiguo fija otra codificación interna, los resultados cambian. wc -mdepende del locale (LANG). Usamos elwcde macOS; elwcde GNU no se ejecutó aquí.- UTF-8, tal como lo define el RFC 3629 (2003), termina en 4 bytes y U+10FFFF. Los textos viejos que describen formas de 5 y 6 bytes hoy son inválidos.
- La tabla de tamaños son cuatro oraciones y cuatro páginas, no un corpus. Tómala como ilustración de la tendencia.
Ejercicios
- Sin ejecutar nada, predice
len(s)ylen(s.encode("utf-8"))para"¿Año?". ¿Cuántos bytes ocupa en Windows-1252? - Un log muestra los bytes
E2 82 AC. Decodifícalos a mano con la tabla de bits. Luego haz lo mismo conF0 9F 8E 89. - Una columna admite "50 bytes". ¿Cuántas veces cabe
"ñ"en UTF-8? ¿Y en Windows-1252?
Respuestas
- len 5 y 7 bytes en UTF-8 (
c2 bf 41 c3 b1 6f 3f:¿yñocupan 2 cada una). En Windows-1252 son 5 bytes, uno por carácter. E2es1110 0010, así que son 3 bytes:0010+000010+101100= U+20AC,€.F0 9F 8E 89son 4 bytes y dan U+1F389,🎉.- 25 veces en UTF-8 (2 bytes cada una) y 50 en Windows-1252 (1 byte cada una).
Siguiente
Los bytes son fáciles cuando los puedes ver. El problema empieza cuando un programa escribe bytes con una codificación y otro los lee con otra.
- Siguiente: Curso de texto y codificación 2/6: mojibake, cómo se produce y cómo se arregla
- Más adelante en la serie: normalización Unicode, NFC/NFD y nombres de archivo, CSV, BOM y Excel, longitud de strings, emoji y grafemas en 8 lenguajes, detección de codificación y rendimiento
- Relacionado: tipos y mutabilidad en Python, tipos, strings y arrays en PHP, tuberías y herramientas de texto en la terminal y la hoja de ruta para aprender programación
Preguntas frecuentes
¿Por qué Python dice que len('año') es 3 si el archivo ocupa 4 bytes?
len() cuenta code points, y 'año' tiene tres. El archivo guarda UTF-8, donde la ñ (U+00F1) ocupa dos bytes, C3 B1, así que el total es 4 bytes. len(s.encode('utf-8')) devuelve la cantidad de bytes.
¿La ñ ocupa uno o dos bytes?
Depende de la codificación. En Latin-1 y Windows-1252 es un solo byte, F1. En UTF-8 son dos, C3 B1. Por eso un texto en español crece un poco al pasar a UTF-8: una oración de 91 code points pasó de 91 bytes en cp1252 a 104 en UTF-8.
¿strtoupper() de PHP no funciona con la ñ?
strtoupper solo conoce ASCII. En PHP 8.5 strtoupper('año ñandú') devolvió 'AñO ñANDú', mientras que mb_strtoupper devolvió 'AÑO ÑANDÚ'. Usa las funciones mb_ cuando trabajes con caracteres y no con bytes.