Normalización Unicode: NFC, NFD, la ñ y los zip de Mac
Por qué "año" == "año" puede dar False: NFC, NFD, NFKC y NFKD medidos en Python y PHP, qué guarda APFS de verdad, zip de Mac sin bandera UTF-8 y git.
Serie: curso de texto y codificación 3/6 (intermedio). Para quien ya sabe que el texto son bytes (clases 1 y 2) y ahora se topa con errores donde dos cadenas se ven idénticas pero no lo son. Vas a conocer las cuatro formas de normalización de Unicode, ver qué guarda macOS de verdad en los nombres de archivo y corregir los errores de comparación, zip y git que vienen detrás.
Si un cliente llamado "Peña" no aparece en el buscador aunque está en la base de datos, si find . -name 'año*' no encuentra nada mientras ls muestra año.txt, o si el zip que te mandó un colega desde su Mac se descomprime como an╠âo.txt, esta clase trata de tu problema. La causa es la misma en los tres casos: Unicode permite guardar el mismo texto visible con distintos puntos de código, y casi todo el código compara puntos de código. Todo lo de abajo se ejecutó en una Mac y cada salida está copiada de la terminal; el comportamiento de Windows se describe a partir de la documentación y lleva la etiqueta "no se ejecutó aquí".
Clase anterior: Mojibake: decodificar, codificar y reparar. El mapa completo: la ruta de aprendizaje de programación.
Entorno: macOS 26.6.2 sobre APFS, Mac con Apple Silicon (M1 Pro), Python 3.9.6 (unicodedata 13.0.0), PHP 8.5.6 con intl (ICU 78.3), jsc de JavaScriptCore, Swift 6.4.2, Info-ZIP Zip 3.0 tal como lo trae Apple, ditto, git 2.54.0 (Apple Git-157), sqlite3 3.51.0. Las rutas se acortaron a ~/demo.
Una "ñ", dos cadenas
Un punto de código es el número que Unicode asigna a cada carácter, escrito como U+00F1. Un carácter combinante es un punto de código que se pega al anterior, como U+0303 COMBINING TILDE. Unicode permite escribir "ñ" de las dos maneras. Este script imprime ambas formas con sus puntos de código y sus bytes UTF-8:
# cps.py - puntos de código y bytes UTF-8 de las formas NFC y NFD
import unicodedata as ud, sys
for s in sys.argv[1:]:
    for f in ("NFC", "NFD"):
        t = ud.normalize(f, s)
        print(f, s, " ".join(f"U+{ord(c):04X}" for c in t), t.encode().hex(" "))
~/demo % python3 cps.py ñ é
NFC ñ U+00F1 c3 b1
NFD ñ U+006E U+0303 6e cc 83
NFC é U+00E9 c3 a9
NFD é U+0065 U+0301 65 cc 81
NFC (forma de normalización C, "compuesta") usa el carácter precompuesto cuando existe. NFD ("descompuesta") lo separa en letra base más marcas combinantes. Las dos son Unicode válido y se ven igual. Ahora mira cómo falla el código de todos los días:
>>> a = "año"; b = "año"
>>> a == b, len(a), len(b)
(False, 3, 4)
>>> "ñ" in b
False
>>> b[:2]               # el corte deja la tilde afuera
'an'
Pasa lo mismo en JavaScript (jsc) y en PHP (con Normalizer de intl); después de normalizar, la comparación da true:
~/demo % jsc n.js            # a === b, longitudes, luego normalize("NFC")
false 4 5
true
~/demo % php norm.php        # $nfd === $nfc, luego Normalizer::normalize
bool(false)
bool(true)
Las cuatro formas: NFC, NFD, NFKC y NFKD
Hay dos formas más. La K significa "compatibilidad": NFKC y NFKD también reemplazan caracteres que Unicode considera variantes de formato, como letras de ancho completo, ligaduras y números en círculo. Eso sirve para buscar y es destructivo para guardar. Esta es la salida real:
| Entrada | NFC (long.) | NFD (long.) | NFKC (long.) | Qué cambió |
|---|---|---|---|---|
año |
año (3) | año (4) | año (3) | NFD separa la ñ |
café |
café (4) | café (5) | café (4) | NFD separa la é |
naïve |
naïve (5) | naïve (6) | naïve (5) | NFD separa la ï |
fi (ligadura) |
fi (1) | fi (1) | fi (2) | NFKC expande la ligadura |
ABC123 (ancho completo) |
igual (6) | igual (6) | ABC123 (6) | NFKC lo vuelve ASCII |
①㈱ |
igual (2) | igual (2) | 1(株) (4) | NFKC pierde el círculo |
한글 |
한글 (2) | 한글 (6) | 한글 (2) | NFD separa sílabas coreanas |
Tres cosas sorprenden:
- NFC no "pasa a ASCII". Nunca toca letras de ancho completo, ligaduras ni números en círculo. Solo lo hacen las formas K.
- NFKC tiene pérdida.
①se vuelve1yfise vuelvefi, y no hay vuelta atrás. No apliques NFKC a texto que vas a mostrar o guardar tal como lo escribió el usuario. - Quitar acentos es un uso legítimo de NFD. Para un slug o una búsqueda sin acentos, descompón y descarta las marcas combinantes:
import unicodedata as ud
def sin_acentos(s):
    return "".join(c for c in ud.normalize("NFD", s) if not ud.combining(c))
'Peña' -> 'Pena'
'Bogotá' -> 'Bogota'
'¿Qué tal?' -> '¿Que tal?'
'pingüino' -> 'pinguino'
Fíjate en que "¿" y "¡" no son marcas combinantes y se quedan. Y recuerda que "Peña" y "Pena" son palabras distintas en español: úsalo solo para claves de búsqueda, nunca para el dato que muestras.
En PHP, strlen cuenta bytes, así que la normalización cambia el número:
~/demo % php norm.php
año strlen=4 NFD strlen=5 mb_strlen=4 NFKC=año
Qué hace APFS de verdad con nombres NFC y NFD
El viejo sistema de archivos HFS+ convertía los nombres a una forma descompuesta, y por eso muchos artículos todavía dicen "macOS guarda en NFD". Así que medimos APFS en macOS 26.6. Primero un archivo creado con nombre NFC, después una búsqueda y un segundo intento de creación con el nombre NFD:
# apfs.py - ¿qué hace APFS con nombres NFC y NFD?
import os, unicodedata as ud
os.makedirs("t", exist_ok=True)
for word in ["año", "café", "한글", "ガギ"]:
    nfc, nfd = ud.normalize("NFC", word), ud.normalize("NFD", word)
    open(os.path.join("t", nfc + ".txt"), "w").write("nfc")
    print(word, "exists via NFD name:", os.path.exists(os.path.join("t", nfd + ".txt")))
    try:
        with open(os.path.join("t", nfd + ".txt"), "x") as f:
            f.write("nfd")
    except FileExistsError as e:
        print("  FileExistsError:", e.strerror)
for name in sorted(os.listdir("t")):
    print(repr(name), name.encode().hex(" "))
año exists via NFD name: True
  FileExistsError: File exists
...
'año.txt' 61 c3 b1 6f 2e 74 78 74
APFS aquí no distingue la normalización (cualquiera de las dos formas encuentra el archivo y no puedes tener ambos) y la conserva (el listado devuelve los bytes con los que lo creaste). Cuando creamos los archivos con nombres NFD, listdir devolvió bytes NFD (61 6e cc 83 6f para año).
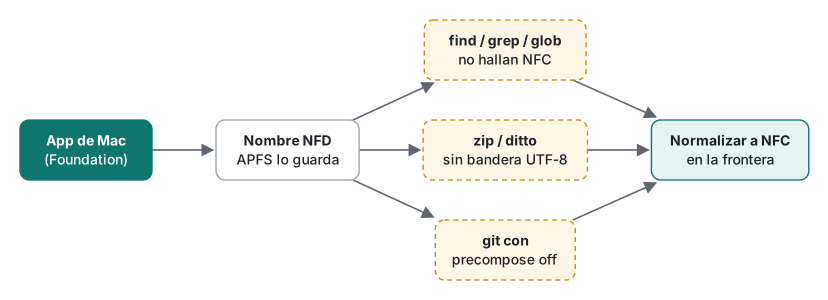
¿Quién crea nombres NFD en una Mac moderna? Se lo pedimos a Foundation, el framework que usan Finder y la mayoría de las apps de Mac, con un programa de Swift:
FileManager.default.createFile(atPath: "es/\(w).txt", contents: Data("x".utf8))
Peña.txt 50 65 6e cc 83 61 2e 74 78 74 9
año.txt 61 6e cc 83 6f 2e 74 78 74 8
Foundation pasó NFD al sistema de archivos y APFS lo guardó. Abrir el archivo por su nombre NFC funciona (cat imprimió el contenido), pero todo lo que compara cadenas por su cuenta falla:
~/demo % find d -name 'año*'                  # escrito en NFC: sin salida
~/demo % ls d | grep año; echo $?
1
~/demo % python3 -c 'import glob; print(glob.glob("d/añ*"))'
[]
Un glob de zsh 5.9 sí encontró el archivo y el mismo patrón en bash devolvió 0 resultados, así que el error parece aleatorio: el mismo comando funciona en una shell y en otra no. El iconv de macOS trae la codificación UTF-8-MAC, que pasa de NFD a NFC: ls d | iconv -f UTF-8-MAC -t UTF-8 | grep año sí lo encuentra.
Los zip hechos en Mac
Un zip guarda cada nombre como bytes más una bandera: el bit 11 de propósito general dice "estos bytes son UTF-8". Sin él, la especificación ZIP indica leerlos como la página de códigos 437 de IBM. Comprimimos la carpeta creada con Foundation usando las dos herramientas de macOS y revisamos cada entrada:
# zipinfo.py (núcleo) - nombres crudos y la bandera UTF-8 (bit 11)
for i in zipfile.ZipFile(path).infolist():
    utf8 = bool(i.flag_bits & 0x800)
    raw = i.filename.encode("utf-8" if utf8 else "cp437")
    print(int(utf8), "NFC" if ud.is_normalized("NFC", raw.decode()) else "NFD", repr(i.filename))
== zip -r zip_es.zip es
  flag800=0 NFD extra=['0x5455', '0x7875'] python_sees='es/año.txt'
  flag800=0 NFD extra=['0x5455', '0x7875'] python_sees='es/Peña.txt'
== ditto -c -k --sequesterRsrc es ditto_es.zip
  flag800=0 NFD extra=['0x5855'] python_sees='año.txt'
Ninguna activó la bandera y las dos conservaron los bytes NFD. Python, siguiendo la especificación, los leyó como CP437. ditto --sequesterRsrc además agregó una entrada __MACOSX/._año.txt por cada archivo. En Windows (no se ejecutó aquí), las herramientas que no ven la bandera suelen usar la página de códigos OEM del sistema, CP850 en un Windows en español; leer los bytes NFC de año.txt como CP850 da a├▒o.txt, y leer los NFD como Windows-1252 da año.txt. Incluso cuando el lector adivina bien que es UTF-8, el nombre sigue en NFD y, según la fuente, la tilde puede verse separada de la n.
La solución es generar archivos con nombres NFC y la bandera activada. El zipfile de Python activa el bit 11 solo para nombres que no son ASCII:
# safezip.py - comprime una carpeta con nombres NFC y la bandera UTF-8
import os, sys, zipfile, unicodedata as ud
src, dst = sys.argv[1], sys.argv[2]
with zipfile.ZipFile(dst, "w", zipfile.ZIP_DEFLATED) as z:
    for root, dirs, files in os.walk(src):
        for f in sorted(files):
            if f == ".DS_Store":
                continue
            path = os.path.join(root, f)
            z.write(path, ud.normalize("NFC", os.path.relpath(path, src)))
== safe_es.zip
  flag800=1 NFC extra=[] python_sees='Peña.txt'
  flag800=1 NFC extra=[] python_sees='año.txt'
Cuando recibas un zip de Mac, repara los nombres al leer: vuelve a codificar como CP437 para recuperar los bytes, decodifícalos como UTF-8 y normaliza a NFC ('es/an╠âo.txt' -> es/año.txt en nuestra ejecución).
Git y core.precomposeunicode
Git en macOS tiene un ajuste justo para esto. En nuestra prueba, git init dejó core.precomposeunicode=true, y con él git registró en NFC un nombre de archivo que estaba en NFD. Con el ajuste en false, el índice recibió los bytes NFD. Lo interesante vino al clonar ese repositorio NFD con la configuración por defecto:
~/demo/c_nfd % git -c core.quotepath=false status --short
?? 한글.txt
El archivo NFD que ya está versionado aparece como un archivo NFC sin seguimiento al lado de sí mismo, y un git add -A && git commit sin pensar les deja dos nombres a tus compañeros que usan Linux. Se arregla con un commit de cambio de nombre, una sola vez:
~/demo/c_nfd % git -c core.precomposeunicode=false rm -q --cached -- "$(git -c core.precomposeunicode=false ls-files -z | tr -d '\0')"
~/demo/c_nfd % git add -A && git -c core.quotepath=false status --short
R  한글.txt -> 한글.txt
Después del commit, el índice tiene bytes NFC y status queda limpio.
Error común: comparar sin normalizar
El error. Los nombres de clientes llegan desde un formulario web (NFC), desde el teclado de un iPhone (normalmente NFC) y desde un CSV armado con nombres de archivo de una Mac (NFD). Van a una columna con restricción UNIQUE.
Lo que pasa en realidad. Guardamos las formas NFD en sqlite3 y buscamos con las NFC:
café: rows=0
한글: rows=0
ガギ: rows=0
año: rows=0
inserted NFC café as a second, 'unique' row: 2
No encuentra nada, y la columna "única" quedó con dos cafés.
La solución. Normaliza una sola vez, en la frontera donde el texto entra a tu sistema (formulario, nombres de archivo, importación de CSV, cuerpo de una API), y guarda NFC. Para coincidencias flexibles usa una columna aparte con la clave de búsqueda:
import unicodedata as ud
def store(s):      return ud.normalize("NFC", s)
def search_key(s): return ud.normalize("NFKC", s).casefold()
print(search_key("CAFÉ") == search_key("café"))   # True
Muestra siempre el texto NFC que escribió el usuario; NFKC más casefold() es solo para comparar.
Cuánto cuesta normalizar
¿Conviene llamar a normalize con cada cadena? Medimos 200,000 nombres aleatorios de 12 caracteres (semilla 42, el mejor de 5, Mac con Apple Silicon (M1 Pro), Python 3.9.6):
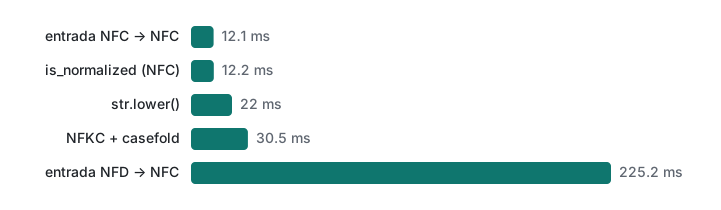
Normalizar texto que ya está en NFC costó lo mismo que str.lower(), porque CPython hace primero una verificación rápida y devuelve la cadena sin cambios. El trabajo real solo aparece con entradas NFD, y aun así fue de unos 1.1 µs por nombre. Normalizar en la frontera es barato; lo caro es saltárselo.
Qué forma usar: tabla de decisión
| Situación | Forma | Por qué |
|---|---|---|
| Guardar texto del usuario, claves de BD, nombres de archivo que creas | NFC | Es la más corta y la que producen casi todos los sistemas y teclados |
| Comparar dos cadenas | NFC en ambos lados | Mismo texto, mismos bytes |
| Búsqueda, IDs de inicio de sesión, duplicados | NFKC + casefold() en una clave aparte |
Iguala ancho completo, ligaduras y mayúsculas |
| Quitar acentos (año → ano) | NFD y descartar las marcas | Los acentos quedan como puntos de código aparte |
| Mostrar o devolver lo que escribió el usuario | NFC, nunca NFKC | NFKC pierde ①, ㈱, fi |
| Zip para usuarios de Windows | Nombres NFC + bandera UTF-8 | Las herramientas de Mac probadas no hacen ninguna de las dos cosas |
Límites honestos y notas de versión
- El
unicodedatade Python 3.9 usa Unicode 13.0.0; intl de PHP aquí reportó ICU 78.3 y Unicode 17.0. Por política de Unicode, los resultados NFC/NFD de caracteres existentes no cambian entre versiones, pero los caracteres nuevos solo se normalizan bien con datos nuevos. unicodedata.is_normalizedllegó en Python 3.8;str.casefolden 3.3.- El comportamiento de APFS se midió solo en macOS 26.6.2, en el volumen del sistema. Apple cambió el manejo de la normalización en las primeras versiones de APFS, y otros volúmenes (memorias USB en exFAT, carpetas compartidas por SMB) pueden comportarse distinto. No se comprobó.
- Windows, el soporte de zip del Explorador y NTFS no se ejecutaron. La descripción sigue la especificación ZIP y reportes comunes.
Ejercicios
- Un CSV de clientes se ve bien, pero
"Peña" in nombresdaFalse. Escribe una línea que encuentre qué entradas no están en NFC. - Quieres aceptar IDs escritos como
TAROotaro, pero mostrar el ID tal como se registró. ¿Qué valor guardas y qué valor pones en el índice único?
Respuestas
[n for n in nombres if not unicodedata.is_normalized("NFC", n)](Python 3.8+). En nuestra prueba con["Peña", "José"]devolvió['Peña']. Después corrige el origen conunicodedata.normalize("NFC", n).- Guarda
normalize("NFC", escrito)para mostrar, y ponnormalize("NFKC", escrito).casefold()en otra columna con el índiceUNIQUE. Las dos entradas dan la clavetaro.
Anterior: Clase 2: mojibake, decodificar y codificar. Siguiente: Clase 4: codificación de CSV, el BOM y Excel, donde las mismas cadenas se encuentran con una hoja de cálculo. Relacionados: URLs con caracteres no ASCII en .htaccess (en inglés), tipos y cadenas en Python, cadenas en PHP.
Preguntas frecuentes
¿Por qué "año" == "año" devuelve False?
Una cadena guarda la ñ como un solo punto de código (U+00F1, NFC) y la otra como n seguida de una tilde combinante (U+006E U+0303, NFD). Se ven iguales, pero tienen distintos puntos de código, longitud y bytes. Normaliza ambos lados a NFC con unicodedata.normalize('NFC', s) antes de comparar o guardar.
¿macOS guarda los nombres de archivo en NFD?
En APFS (medido en macOS 26.6) el sistema de archivos conserva la forma que recibe y encuentra el archivo con cualquiera de las dos. Pero los programas que usan Foundation, como una llamada a FileManager en Swift, escribieron nombres NFD en nuestra prueba. Herramientas que comparan cadenas, como find -name, los globs de bash y glob de Python, no los encuentran si escribes la forma NFC.
¿Por qué se rompen en Windows los nombres de un zip hecho en Mac?
Tanto el comando zip como ditto en macOS 26.6 guardaron los bytes UTF-8 sin activar la bandera UTF-8 (bit 11), así que los lectores recurren a una página de códigos antigua (Python usó CP437 y mostró an╠âo.txt). Crea el zip con una herramienta que normalice a NFC y active la bandera, como zipfile de Python.