CSV y codificación: UTF-8, BOM, Windows-1252 y Excel
El mismo CSV en UTF-8, UTF-8 con BOM y Windows-1252, con sus bytes. Lo leemos con Python, PHP y sqlite3, medimos el BOM y explicamos el clásico Peña.
Serie: curso de texto y codificación 4/6 (intermedio). Para quien exporta o importa archivos CSV y recibe quejas de "caracteres raros" desde contabilidad, un cliente o una hoja de cálculo. Vas a escribir las mismas filas en varias codificaciones, mirar los bytes, leerlas con tres herramientas y elegir la codificación con una tabla según quién abre el archivo.
Si un cliente te mandó una captura de Excel con Peña, Bogotá y ¿Qué tal?, si tu script de importación falla con KeyError: 'name' aunque el encabezado dice name, o si la exportación nocturna se cae por el emoji de un usuario, esta clase es para ti. Un CSV no tiene dónde declarar su codificación, así que cada programa adivina, y cada adivinanza deja huellas en los bytes. Generamos con Python los bytes exactos de cada variante, los leemos con el csv de Python, fgetcsv de PHP y .import de sqlite3, y medimos qué hace el BOM. Excel y Windows no están disponibles aquí: su comportamiento se describe según la documentación de Microsoft y lleva la etiqueta "no se ejecutó aquí".
Clase anterior: normalización Unicode, NFC y NFD. El mapa completo: la ruta de aprendizaje de programación.
Entorno: macOS 26.6.2, Mac con Apple Silicon (M1 Pro), Python 3.9.6 (csv, codecs), PHP 8.5.6 (mbstring), sqlite3 3.51.0, iconv y file de macOS, xxd. Las rutas se acortaron a ~/demo.
Tres archivos con las mismas filas
El BOM (byte order mark, marca de orden de bytes) es el carácter U+FEFF puesto al principio del archivo. En UTF-8 son los tres bytes EF BB BF. UTF-8 no tiene un orden de bytes que marcar, así que aquí solo funciona como firma: "este archivo es UTF-8". Windows-1252 (cp1252) es la página de códigos de un byte del Windows en español, inglés y otros idiomas de Europa occidental: cada carácter ocupa un byte. El codec utf-8-sig de Python escribe el BOM y también lo salta al leer.
# write_csv.py - las mismas filas en tres codificaciones
import csv, sys
ROWS = {
    "en": [["name", "city", "note"], ["Zoë", "São Paulo", "it’s café"]],
    "ja": [["name", "city", "note"], ["髙橋", "東京", "①~③"]],
    "ko": [["name", "city", "note"], ["김똠", "서울", "한글"]],
    "es": [["name", "city", "note"], ["Peña", "Bogotá", "¿Qué tal?"]],
}
LEGACY = {"en": "cp1252", "ja": "cp932", "ko": "cp949", "es": "cp1252"}
lang = sys.argv[1]
for enc in ("utf-8", "utf-8-sig", LEGACY[lang]):
    with open(f"{lang}_{enc}.csv", "w", encoding=enc, newline="") as f:
        csv.writer(f).writerows(ROWS[lang])
newline="" importa: el módulo csv escribe él mismo los finales de línea \r\n (los 0d 0a de abajo) y, sin eso, Python los traduciría otra vez. Estas son las filas en español en cada codificación:
~/demo % xxd es_utf-8.csv
00000000: 6e61 6d65 2c63 6974 792c 6e6f 7465 0d0a  name,city,note..
00000010: 5065 c3b1 612c 426f 676f 74c3 a12c c2bf  Pe..a,Bogot..,..
00000020: 5175 c3a9 2074 616c 3f0d 0a              Qu.. tal?..
~/demo % xxd es_utf-8-sig.csv | head -1
00000000: efbb bf6e 616d 652c 6369 7479 2c6e 6f74  ...name,city,not
~/demo % xxd es_cp1252.csv
00000000: 6e61 6d65 2c63 6974 792c 6e6f 7465 0d0a  name,city,note..
00000010: 5065 f161 2c42 6f67 6f74 e12c bf51 75e9  Pe.a,Bogot.,.Qu.
00000020: 2074 616c 3f0d 0a                         tal?..
La ñ es c3 b1 en UTF-8 y el byte único f1 en cp1252; ¿ es c2 bf contra bf. Tamaños: 43, 46 y 39 bytes. El comando file adivina, y sus respuestas no coinciden con lo que tú llamarías "la misma codificación":
~/demo % file -I es_cp1252.csv en_cp1252.csv
es_cp1252.csv: text/plain; charset=iso-8859-1
en_cp1252.csv: text/plain; charset=unknown-8bit
El archivo en español solo tiene ñ, á, ¿ y é, que son iguales en ISO-8859-1 (latin-1) y en cp1252, así que file dice ISO-8859-1. El archivo en inglés tiene el apóstrofo tipográfico ’, que en cp1252 es el byte 92, un código de control en latin-1, y file se rinde. El problema de adivinar es el tema de la clase 6.
Latin-1 no es Windows-1252
Esa diferencia no es un detalle. Leer cp1252 como latin-1 no da error, simplemente cambia caracteres:
b = "Precio: 10 €; “oferta”".encode("cp1252")
print(b.hex(" "))
print(repr(b.decode("latin-1")))
print(b.decode("cp1252"))
50 72 65 63 69 6f 3a 20 31 30 20 80 3b 20 93 6f 66 65 72 74 61 94
'Precio: 10 \x80; \x93oferta\x94'
Precio: 10 €; “oferta”
El euro y las comillas tipográficas se convirtieron en caracteres de control invisibles. Si un archivo viene de Windows, léelo como cp1252, nunca como latin-1.
Leerlo de vuelta: Python, PHP y sqlite3
El csv de Python con el codec equivocado
# read_csv.py - lee un CSV con una codificación dada y muestra los encabezados
import csv, sys
path, enc = sys.argv[1], sys.argv[2]
with open(path, encoding=enc, newline="") as f:
    rows = list(csv.DictReader(f))
print(enc, list(rows[0].keys()))
print("row['name'] =", rows[0].get("name"))
~/demo % python3 read_csv.py es_cp1252.csv utf-8
Traceback (most recent call last):
  ...
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xf1 in position 18: invalid continuation byte
El byte 18 es la f1 de Peña. En UTF-8, f1 debe iniciar una secuencia de cuatro bytes, y la a (61) no puede continuarla. Que un decodificador estricto falle con ruido es buena noticia: no entró ni un dato incorrecto.
El efecto secundario del BOM, medido
Ahora el archivo con BOM leído como utf-8 normal:
~/demo % python3 read_csv.py es_utf-8-sig.csv utf-8
utf-8 ['name', 'city', 'note']
row['name'] = None
~/demo % python3 read_csv.py es_utf-8-sig.csv utf-8-sig
utf-8-sig ['name', 'city', 'note']
row['name'] = Peña
~/demo % python3 read_csv.py es_utf-8.csv utf-8-sig
utf-8-sig ['name', 'city', 'note']
row['name'] = Peña
El primer encabezado quedó como name. En casi todas las terminales se ve como name, así que el error se esconde: row.get("name") da None y row["name"] da KeyError. Lo importante es la última línea: utf-8-sig también lee archivos sin BOM, así que es el valor seguro por defecto para leer.
El fgetcsv de PHP tampoco quita el BOM:
<?php
// read.php - fgetcsv y el BOM
$f = fopen($argv[1], 'r');
$head = fgetcsv($f, null, ',', '"', '');
$row  = fgetcsv($f, null, ',', '"', '');
$rec  = array_combine($head, $row);
var_dump($head[0], strlen($head[0]), isset($rec['name']));
echo bin2hex($head[0]), "\n";
~/demo % php read.php es_utf-8-sig.csv
string(7) "name"
int(7)
bool(false)
efbbbf6e616d65
Un encabezado de cuatro letras que mide siete bytes es la firma del BOM. Fíjate en el quinto argumento '': si lo omites, PHP 8.5 muestra Deprecated: fgetcsv(): the $escape parameter must be provided as its default value will change. Un lector pequeño que quita el BOM y convierte una codificación antigua conocida:
<?php
// read2.php - quita el BOM y convierte codificaciones antiguas a UTF-8
function open_csv(string $path, string $from = 'UTF-8') {
    $data = file_get_contents($path);
    if (str_starts_with($data, "\xEF\xBB\xBF")) {
        $data = substr($data, 3);
    } elseif ($from !== 'UTF-8') {
        $data = mb_convert_encoding($data, 'UTF-8', $from);
    }
    $f = fopen('php://memory', 'r+');
    fwrite($f, $data);
    rewind($f);
    return $f;
}
$f = open_csv($argv[1], $argv[2] ?? 'UTF-8');
while (($r = fgetcsv($f, null, ',', '"', '')) !== false) {
    echo implode(' | ', $r), "\n";
}
~/demo % php read2.php es_cp1252.csv Windows-1252
name | city | note
Peña | Bogotá | ¿Qué tal?
.import de sqlite3
sqlite3 3.51.0 manejó el BOM por su cuenta y guardó los bytes antiguos sin quejarse:
~/demo % sqlite3 :memory: ".import --csv ko_utf-8-sig.csv t" "select name, hex(name), length(name) from t;"
김똠|EAB980EB98A0|2
~/demo % sqlite3 :memory: ".import --csv ko_cp949.csv t" "select name, hex(name), length(name) from t;"
��c|B1E88C63|3
(Usamos el archivo coreano porque muestra bien el problema.) La segunda tabla guarda en una columna TEXT bytes que no son UTF-8 válido, con un length equivocado. sqlite3 no convierte: pasa el archivo por iconv -f WINDOWS-1252 -t UTF-8 antes de importarlo.
Qué hace Excel (descrito, no se ejecutó aquí)
Según la documentación y los artículos de soporte de Microsoft, Excel para Windows abre un .csv con doble clic usando la página de códigos "ANSI" del sistema, salvo que el archivo empiece con un BOM de UTF-8. En un Windows en español esa página es cp1252. Al guardar, ofrece "CSV UTF-8 (delimitado por comas)", que escribe el BOM, y "Datos > Desde el texto/CSV" permite elegir la codificación a mano. Además, en configuraciones regionales donde la coma es el separador decimal (como en España, Argentina o Colombia), Excel espera ; como separador de lista; ese es otro motivo por el que un CSV "se ve todo en una columna". Con Python, csv.writer(f, delimiter=";") escribe 'producto;precio\r\nCafé;3,50\r\n'.
No podemos ejecutar Excel aquí, pero sí reproducir exactamente lo que muestra un lector así decodificando nuestros bytes UTF-8 como cp1252:
es cp1252 -> Peña,Bogotá,¿Qué tal?
   BOM bytes as cp1252 -> ''
Ahí están los "caracteres raros": los dos bytes UTF-8 de la ñ mostrados como ñ, y los de ¿ como ¿. Y  es el aspecto de un BOM cuando el programa no lo conoce.
Caracteres que no se pueden codificar
Las páginas de códigos antiguas son pequeñas: cp1252 define solo 251 de sus 256 valores de byte. Basta un emoji en un nombre de usuario para romper una exportación:
# emoji_es.py
import csv
with open("out.csv", "w", encoding="cp1252", newline="") as f:
    csv.writer(f).writerows([["id", "nickname"], ["1", "Peña 👍"]])
~/demo % python3 emoji_es.py
Traceback (most recent call last):
  ...
UnicodeEncodeError: 'charmap' codec can't encode character '\U0001f44d' in position 7: character maps to <undefined>
~/demo % wc -c out.csv
      13 out.csv
La posición 7 se cuenta dentro del texto de la fila 1,Peña 👍, no del archivo. Lo peor está en el archivo: out.csv ya tenía los 13 bytes del encabezado id,nickname\r\n cuando saltó la excepción, así que un cron deja atrás un CSV truncado que parece válido. La ł polaca falla igual ('ł'), así que cp1252 ni siquiera alcanza para toda Europa.
PHP hace lo contrario y reemplaza en silencio:
~/demo % php write.php Windows-1252 'Peña 👍' | xxd
00000000: 6964 2c6e 6963 6b6e 616d 650d 0a31 2c22  id,nickname..1,"
00000010: 5065 f161 203f 220d 0a                   Pe.a ?"..
El emoji se volvió 3f, un signo de pregunta, sin aviso. Python puede hacer lo mismo con errors="replace" (Peña ?) o con errors="xmlcharrefreplace" (Peña 👍). Decide a propósito: fallar es lo correcto para datos de facturación; reemplazar puede estar bien para un nombre visible.
Error común: "pongamos BOM en todo"
El error. Después de una queja por Excel, el equipo agrega BOM a todos los CSV, incluidos los que leen sus propios servicios.
Lo que pasa en realidad. Cada consumidor que lee con utf-8 normal recibe name (Python) o un name de 7 bytes (PHP), y la primera columna desaparece en silencio de las búsquedas. Las herramientas de la shell también lo ven: cut -d, -f1 es_utf-8-sig.csv | head -1 | xxd imprimió efbb bf6e 616d 65, y cat a.csv a.csv | xxd mostró 0aef bbbf 6e61 6d65, un BOM perdido en medio de los datos.
La solución. Decide por consumidor, no por archivo. Escribe con BOM solo los archivos que una persona abre en Excel, y lee todo CSV que recibas con utf-8-sig, con una única página de códigos antigua conocida como respaldo:
# read_any.py - acepta UTF-8 (con o sin BOM) o una página de códigos antigua conocida
import csv, io
def read_rows(path, legacy):
    data = open(path, "rb").read()
    try:
        text, used = data.decode("utf-8-sig"), "utf-8-sig"
    except UnicodeDecodeError:
        text, used = data.decode(legacy), legacy      # estricto: sigue fallando con ruido
    return used, list(csv.DictReader(io.StringIO(text, newline="")))
es_cp1252.csv     cp1252    {'name': 'Peña', 'city': 'Bogotá', 'note': '¿Qué tal?'}
en_utf-8.csv      utf-8-sig {'name': 'Zoë', 'city': 'São Paulo', 'note': 'it’s café'}
Agregar o quitar un BOM en la shell es una operación de bytes: { printf '\xEF\xBB\xBF'; cat in.csv; } > out.csv lo agrega y tail -c +4 lo quita; las dos salidas fueron idénticas byte a byte a las de Python (cmp no imprimió nada). El iconv de macOS no tiene destino UTF-8-BOM (iconv_open(UTF-8-BOM, UTF-8): Invalid argument).
Tamaño: ¿UTF-8 ocupa más?
Una objeción común a UTF-8 es el tamaño. Escribimos un CSV de 10,000 filas (id, name, city, note) con palabras de muestra de cada idioma, semilla 42, y contamos bytes:
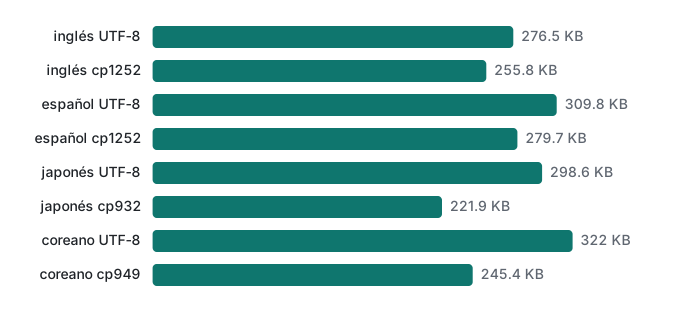
En español, UTF-8 fue apenas un 11% más grande que cp1252, y en inglés un 8%, porque casi todo es ASCII. En japonés y coreano la diferencia fue del 35% y el 31%, porque kana, kanji y hangul ocupan 3 bytes en UTF-8 y 2 en cp932 o cp949. El BOM suma exactamente 3 bytes. Con gzip (nivel 9, mtime=0) la diferencia casi desapareció: en español, 36,327 contra 35,901 bytes, un 1.2%. Mucho más barato que un solo ticket de soporte.
Qué codificación escribir: tabla de decisión
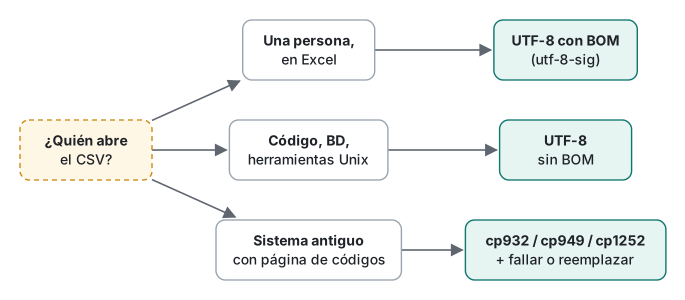
| Quién abre el archivo | Escribe | Notas |
|---|---|---|
| Una persona, con doble clic en Excel para Windows | UTF-8 con BOM (utf-8-sig) |
Comportamiento de Excel según documentación, no se ejecutó aquí; considera ; como separador |
| Tu propio código, una importación a BD, una API | UTF-8 sin BOM | Lee con utf-8-sig de todos modos |
Herramientas de Unix (cut, sort, awk, cat) |
UTF-8 sin BOM | El BOM se pega al primer campo |
| Un sistema antiguo que documenta una página de códigos | Exactamente esa (cp1252, no latin-1) |
Decide entre fallar o reemplazar |
| Público desconocido o mixto | UTF-8 con BOM, más una nota de cómo importarlo | Y guarda el original en UTF-8 |
Límites honestos y notas de versión
- Excel, Windows y Google Sheets no se ejecutaron. El comportamiento de Excel viene de la documentación y los artículos de soporte de Microsoft; las versiones nuevas de Microsoft 365 pueden cambiar cómo se abren los CSV, y el separador depende de la configuración regional de cada equipo.
utf-8-sigexiste desde Python 2.5.str_starts_withrequiere PHP 8.0+; el argumento de fin de línea defputcsv, PHP 8.1+. La advertencia de$escapese observó en PHP 8.5.6.- El manejo del BOM en sqlite3 se comprobó solo en la versión 3.51.0.
- La prueba de tamaño usa palabras cortas elegidas por nosotros; datos reales con más ASCII (números, correos, IDs) achican aún más la diferencia.
Ejercicios
- Un proveedor manda
clientes.csv. Conencoding="utf-8"Python lanzaKeyError: 'id'aunqueprint(reader.fieldnames)muestra['id', ...]. ¿Cuál es la causa y el arreglo de una palabra? - Tu exportación debe ser cp1252 para un sistema contable antiguo y hay un cliente llamado
Łukasz. Nombra dos comportamientos aceptables y el argumento de Python para cada uno.
Respuestas
- El archivo tiene un BOM de UTF-8, así que el primer nombre de campo es
'id'. Lo ves conrepr(reader.fieldnames[0]). Arreglo:encoding="utf-8-sig". - Fallar y avisar, con el valor por defecto
errors="strict"(atrapaUnicodeEncodeError, escribe en un archivo temporal y renómbralo solo si todo salió bien, para no dejar un archivo a medias). O reemplazar y registrar, conerrors="replace"(?), anotando qué filas cambiaron. Descartar la fila en silencio no es aceptable.
Anterior: Clase 3: normalización Unicode, NFC y NFD. Siguiente: Clase 5: longitud de cadenas, emoji y grafemas. Relacionados: pipes y herramientas de texto en la shell, fundamentos de SQL, encabezados HTTP y charset (en inglés).
Preguntas frecuentes
¿Por qué Excel muestra Peña en lugar de Peña?
El archivo está en UTF-8 sin BOM y el programa lo leyó como Windows-1252: los dos bytes de la ñ (C3 B1) se muestran como dos caracteres, Ã y ±. Según la documentación de Microsoft (no se ejecutó aquí), Excel para Windows reconoce UTF-8 cuando el archivo empieza con el BOM. Escribe con encoding='utf-8-sig' los archivos que alguien abrirá en Excel.
¿Por qué la primera columna de mi CSV se llama \ufeffname?
El archivo empieza con un BOM de UTF-8 (bytes EF BB BF) y lo leíste como utf-8 normal, así que el BOM quedó pegado al primer encabezado. En nuestra prueba, DictReader de Python devolvió '\ufeffname' y row['name'] fue None; fgetcsv de PHP devolvió un 'name' de 7 bytes. Lee con encoding='utf-8-sig' en Python o quita los tres bytes en PHP.
¿Latin-1 y Windows-1252 son lo mismo?
No. Coinciden en ñ, á, é, ¿ y ¡, pero Windows-1252 usa los bytes 0x80 a 0x9F para €, comillas tipográficas y otros signos. Leer un archivo Windows-1252 como latin-1 no da error: el € se convierte en el carácter de control \x80 sin avisar. Usa cp1252 cuando el archivo viene de Windows.